Query Cache
Query Cache は、Apache Doris のパイプライン実行エンジンで集約の中間結果をタブレット単位でキャッシュし、繰り返し実行する集約クエリを高速化する仕組みです。
使用前の確認事項
Query Cache を使用する前に、次の点を確認してください。
- クエリの対象が 内部 OLAP テーブル である(Hive/JDBC/Iceberg/Hudi/Paimon などの外部テーブルではない)
- クエリが 集約クエリ である(
GROUP BYまたは集約関数を含む) - クエリプランが
AggregationNode → OlapScanNodeのパターンに一致する - クエリに
JOIN、SORT、UNION、WINDOWノードが含まれない - クエリが
now()、rand()、uuid()などの非決定的関数に依存しない -
enable_query_cache = trueが設定されている
一文での定義
Query Cache は、パイプライン実行エンジンで集約結果をタブレット単位でキャッシュします。後続のクエリの実行コンテキストが同じ場合はキャッシュ済みデータを直接返し、スキャンと計算の繰り返しを避けます。
Query Cache が必要な理由
分析処理では、基になるデータが変わらない間に同じ集約クエリを繰り返し実行することがよくあります。次に例を示します。
SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-01' GROUP BY region;
SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-01' GROUP BY region;
実行のたびに同じタブレットを再スキャンして結果を再計算するため、CPU と I/O が無駄になります。Query Cache は集約の中間結果をキャッシュし、ヒット時にその結果を直接返すことで、レイテンシーを大幅に削減します。
- この機能は 内部 OLAP テーブルに対する集約クエリ にのみ適用されます。単純なスキャン、JOIN、ソートなどの操作では Query Cache を使用しません。
- 外部テーブルはサポートされません(Hive、JDBC、Iceberg、Hudi、Paimon など)。
仕組み
サポートされるクエリパターン
実行プランのツリーが次のいずれかのパターンに一致するフラグメントだけが、キャッシュの対象になります。
AggregationNode → OlapScanNode:スキャンの直上にある単一段階の集約。AggregationNode → AggregationNode → OlapScanNode:スキャンの上にある二段階の集約。
集約ノードとスキャンノードの間には、FilterNode や ProjectNode などの中間ノードを配置できます。ただし、キャッシュ対象のサブツリーに JoinNode、SortNode、UnionNode、WindowNode、ExchangeNode が含まれていては なりません。
キャッシュキーの三つの構成要素
| 構成要素 | 説明 |
|---|---|
| SQL ダイジェスト | 正規化された実行プランのツリー(集約関数、グループ化式、パーティション以外のフィルター述語、投影列、結果に影響するセッション変数)から計算した SHA-256 ハッシュです。意味的に等価なクエリは同じダイジェストになります。 |
| タブレット ID リスト | 現在のパイプラインインスタンスに割り当てられたタブレット ID をソートしたリストです。 |
| タブレット範囲 | パーティション述語から導出される、各タブレットの有効なスキャン範囲です(パーティションとフィルターの動作を参照)。 |
キャッシュが無効になる条件
| トリガーとなる条件 | 説明 |
|---|---|
| データの変更 | INSERT、DELETE、UPDATE、またはコンパクションによってタブレットのバージョン番号が増加します。後続のクエリではバージョンを比較し、一致しなければキャッシュミスになります。増分マージを有効にしている場合は、差分だけをスキャンして古いバージョンのエントリを再利用できることがあります。 |
| スキーマの変更 | ALTER TABLE によってテーブル構造が変わると、実行プランとダイジェストが変わります。 |
| LRU による追い出し | キャッシュのメモリ使用量が上限を超えると、LRU-K(K=2)に従ってエントリが追い出されます。新しいエントリを登録するには、少なくとも二度アクセスする必要があります。 |
| 期限切れエントリの削除 | 24 時間を超えて古くなったエントリは、定期的なクリーンアップタスクによって自動的に削除されます。 |
| 強制更新 | query_cache_force_refresh = true を設定すると、キャッシュを無視してクエリを再実行します。 |
実行フロー
初回実行(キャッシュミス):
- スキャンオペレーターが通常どおりタブレットからデータを読み取ります。
- 集約オペレーターが結果を計算します。
- 結果を後続の処理に送り、キャッシュへの書き込みに備えて蓄積します。
- 実行完了後、蓄積した結果がエントリ単位のサイズまたは行数の上限を超えていなければ、結果をキャッシュに書き込みます。
後続の実行(キャッシュヒット):
- スキャンオペレーターがキャッシュヒットを検出し、スキャン範囲をスキップします。タブレットからデータは読み取られません。
- 集約オペレーターには入力がなく、出力も生成しません。
- キャッシュソースオペレーターがキャッシュ済みのデータブロックを直接提供します。
- 列の順序がキャッシュ済みエントリと異なる場合(たとえば
SELECT a, bとSELECT b, aが同じダイジェストになる場合)、列は自動的に並べ替えられます。
パーティションとフィルターの動作
Query Cache のヒット率を高めるには、パーティション述語とフィルター式がどう相互作用するかを理解することが重要です。
単一列の RANGE パーティション述語
単一列の RANGE パーティショニングを使用するテーブルでは、パーティション述語が特別に処理されます。
- パーティション述語はダイジェストから 抽出 されます。システムは述語の範囲と各パーティションの実際の範囲境界との共通部分を計算し、タブレット範囲の文字列としてキャッシュキーに追加します。
- パーティションのフィルター範囲だけが異なる二つのクエリは、共通するタブレットの キャッシュを共有 できます。
例:テーブル orders は dt 列で日単位にパーティショニングされています。
-- Query A
SELECT region, SUM(revenue) FROM orders
WHERE dt >= '2024-01-01' AND dt < '2024-01-03' GROUP BY region;

-- Query B
SELECT region, SUM(revenue) FROM orders
WHERE dt >= '2024-01-02' AND dt < '2024-01-04' GROUP BY region;
- クエリ A はパーティション
2024-01-01と2024-01-02をスキャンします。 - クエリ B はパーティション
2024-01-02と2024-01-03をスキャンします。 - パーティション
2024-01-02のタブレットダイジェストと範囲は同じなので、クエリ B は2024-01-02に対するクエリ A のキャッシュを再利用し、2024-01-03のパーティションだけを再計算します。
複数列の RANGE/LIST/非パーティションテーブル
複数列の RANGE パーティショニング、LIST パーティショニング、または パーティショニングなし のテーブルでは、パーティション述語を抽出できず、ダイジェストに直接含まれます。パーティション述語にわずかな違いがあるだけでもダイジェストが異なり、キャッシュミスになります。
パーティション以外のフィルター式
パーティション以外のフィルター式(WHERE status = 'active' など)は、正規化された実行プランのダイジェストに含まれます。二つのクエリがキャッシュを共有できるのは、正規化されたフィルター式が意味的に同一の場合だけです。
| クエリ 1 | クエリ 2 | キャッシュを共有するか |
|---|---|---|
WHERE status = 'active' | WHERE status = 'active' | はい(同じダイジェスト) |
WHERE status = 'active' | WHERE status = 'inactive' | いいえ(ダイジェストが異なる) |
WHERE status = 'active' AND region = 'ASIA' | WHERE region = 'ASIA' AND status = 'active' | はい(正規化後は順序に依存しない) |
セッション変数
クエリ結果に影響するセッション変数(time_zone、sql_mode、sql_select_limit など)はダイジェストに含まれます。二つのクエリの間でこれらの変数を変更すると、キャッシュキーが異なり、キャッシュミスになります。
Query Cache が無効になる条件
| 条件 | 理由 |
|---|---|
| フラグメントがランタイムフィルターの適用先である | プラン作成時にはランタイムフィルターの値が不明なため、キャッシュすると誤った結果になります。 |
非決定的な式(rand()、now()、uuid()、UDF など)を含む | 同じ入力でも実行ごとに結果が変わります。 |
| キャッシュ対象のサブツリーに JOIN、SORT、UNION、または WINDOW ノードが含まれる | 「集約とスキャン」のパターンだけがサポートされます。 |
スキャンノードが OlapScanNode ではない(外部テーブルのスキャンなど) | キャッシュはタブレット ID とバージョンに依存しますが、外部テーブルにはそれらがありません。 |
Query Cache が外部テーブルをサポートしない理由
Query Cache は、内部 OLAP テーブルに固有の次の三つの特性に依存します。
- タブレット単位のデータ構成:キャッシュキーには、タブレット ID と各タブレットのスキャン範囲が含まれます。外部テーブルは HDFS、S3、JDBC などの外部システムに保存され、タブレットという概念がありません。
- バージョンに基づく無効化:内部タブレットには単調増加するバージョン番号があり、キャッシュはこれを使ってデータが古くなったことを検出します。外部テーブルは、このバージョン管理の仕組みを Doris に公開しません。
- OlapScanNode の要件:実行プランの正規化ロジックは、集約キャッシュポイントの下にある有効なスキャンノードとして
OlapScanNodeだけを認識します。
外部テーブルの結果をキャッシュする必要がある場合は、代わりに SQL Cache を使用してください。
増分マージ(実験的機能)
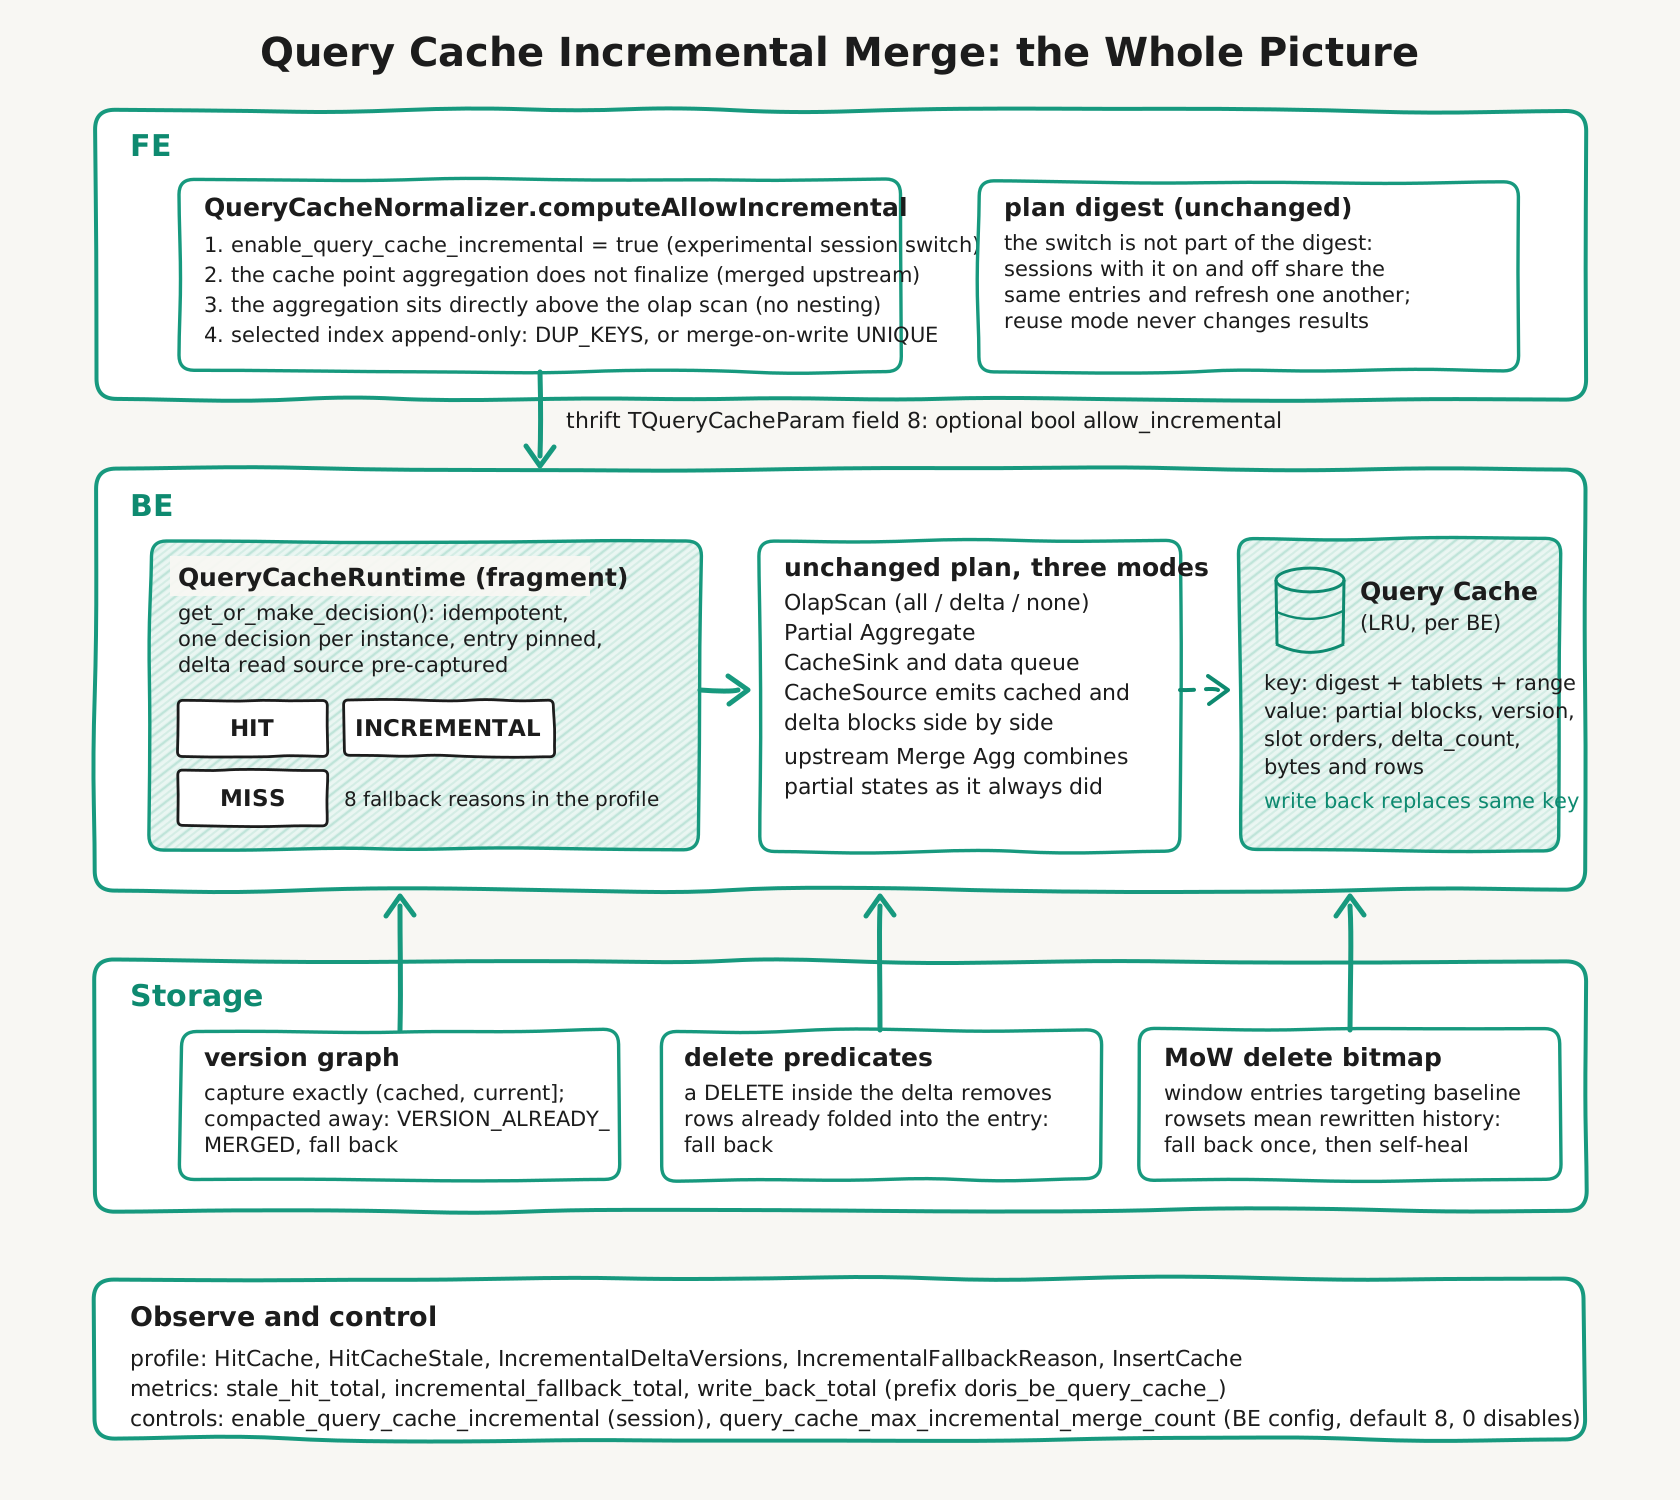
デフォルトでは、バージョンが古くなったキャッシュエントリ(たとえば、一時間ごとにデータがロードされるテーブルの現在のパーティションに対応するエントリ)は破棄され、インスタンス全体がフルスキャンによって再計算されます。増分マージを有効にすると、BE は古いエントリを再利用します。(cached_version, current_version] にある差分の rowset だけをスキャンし、その部分集約状態をキャッシュ済みの部分ブロックと ともに 出力します(上流のマージ集約が両者を結合します)。その後、マージしたエントリを新しいバージョンで書き戻します。一時間ごとにロードする場合、更新の多いパーティションのスキャンコストは「毎時、パーティション全体をスキャンする」から「一時間分の新しいデータをスキャンする」に減ります。
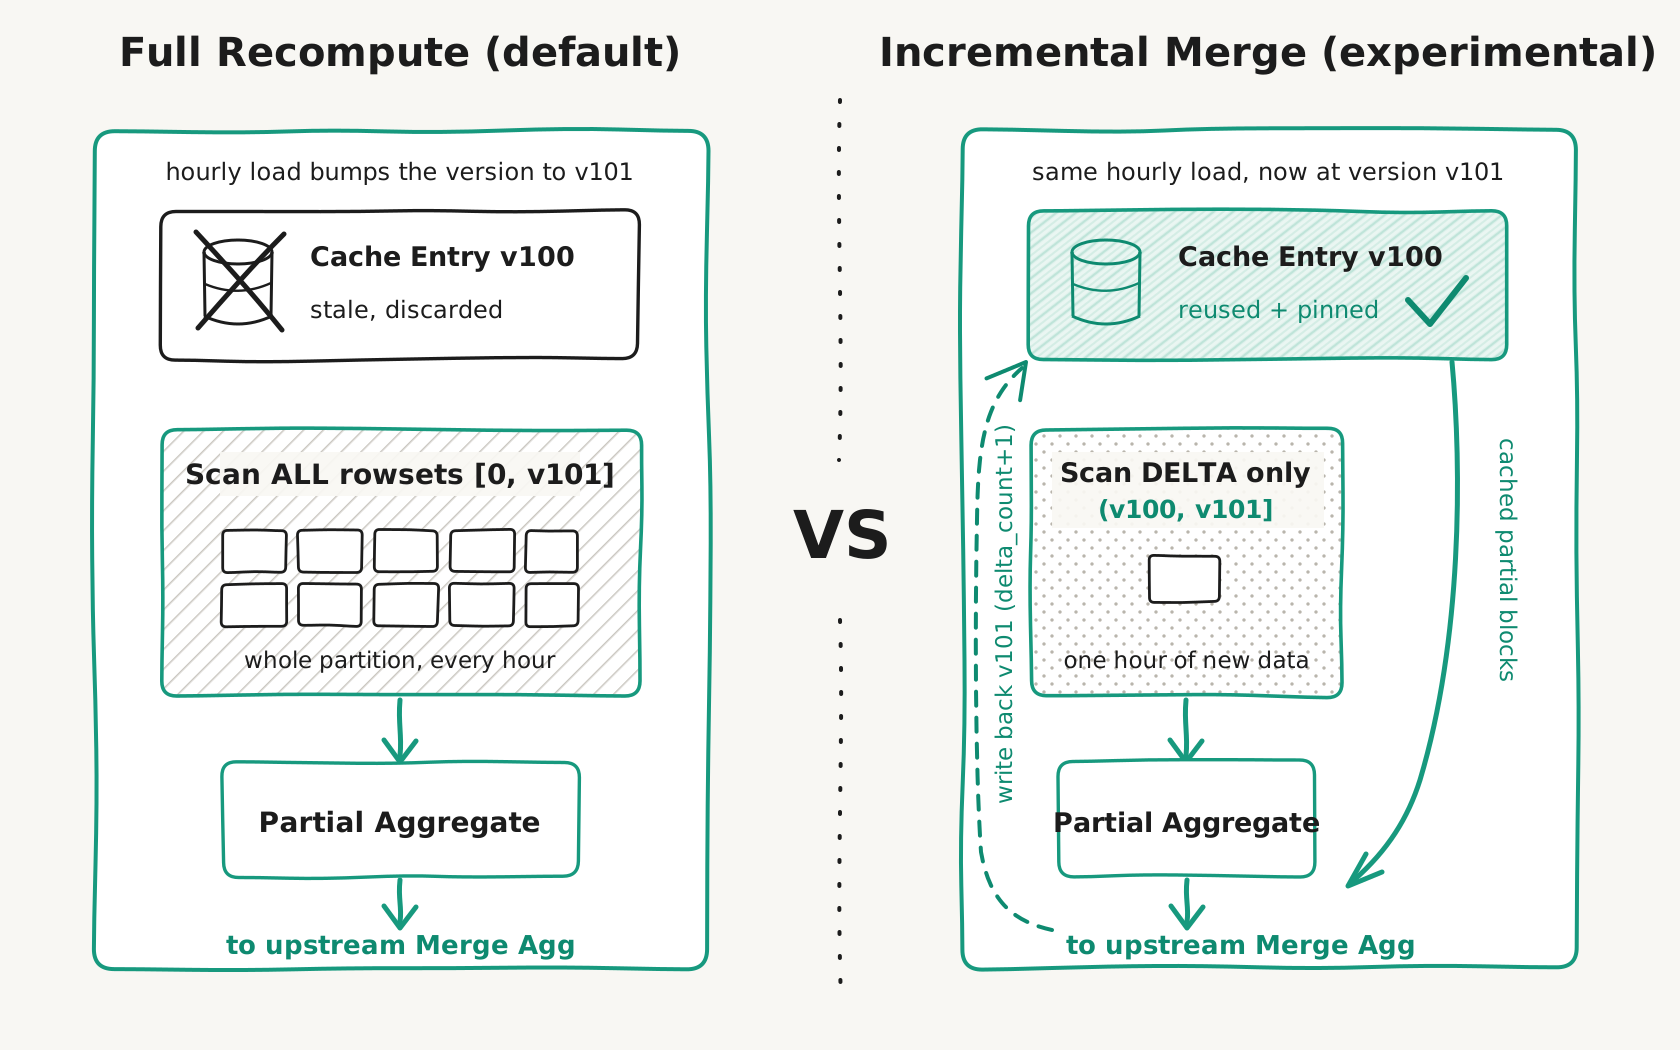
SET enable_query_cache = true;
SET enable_query_cache_incremental = true;  -- shown as experimental_enable_query_cache_incremental in SHOW VARIABLES
前提条件
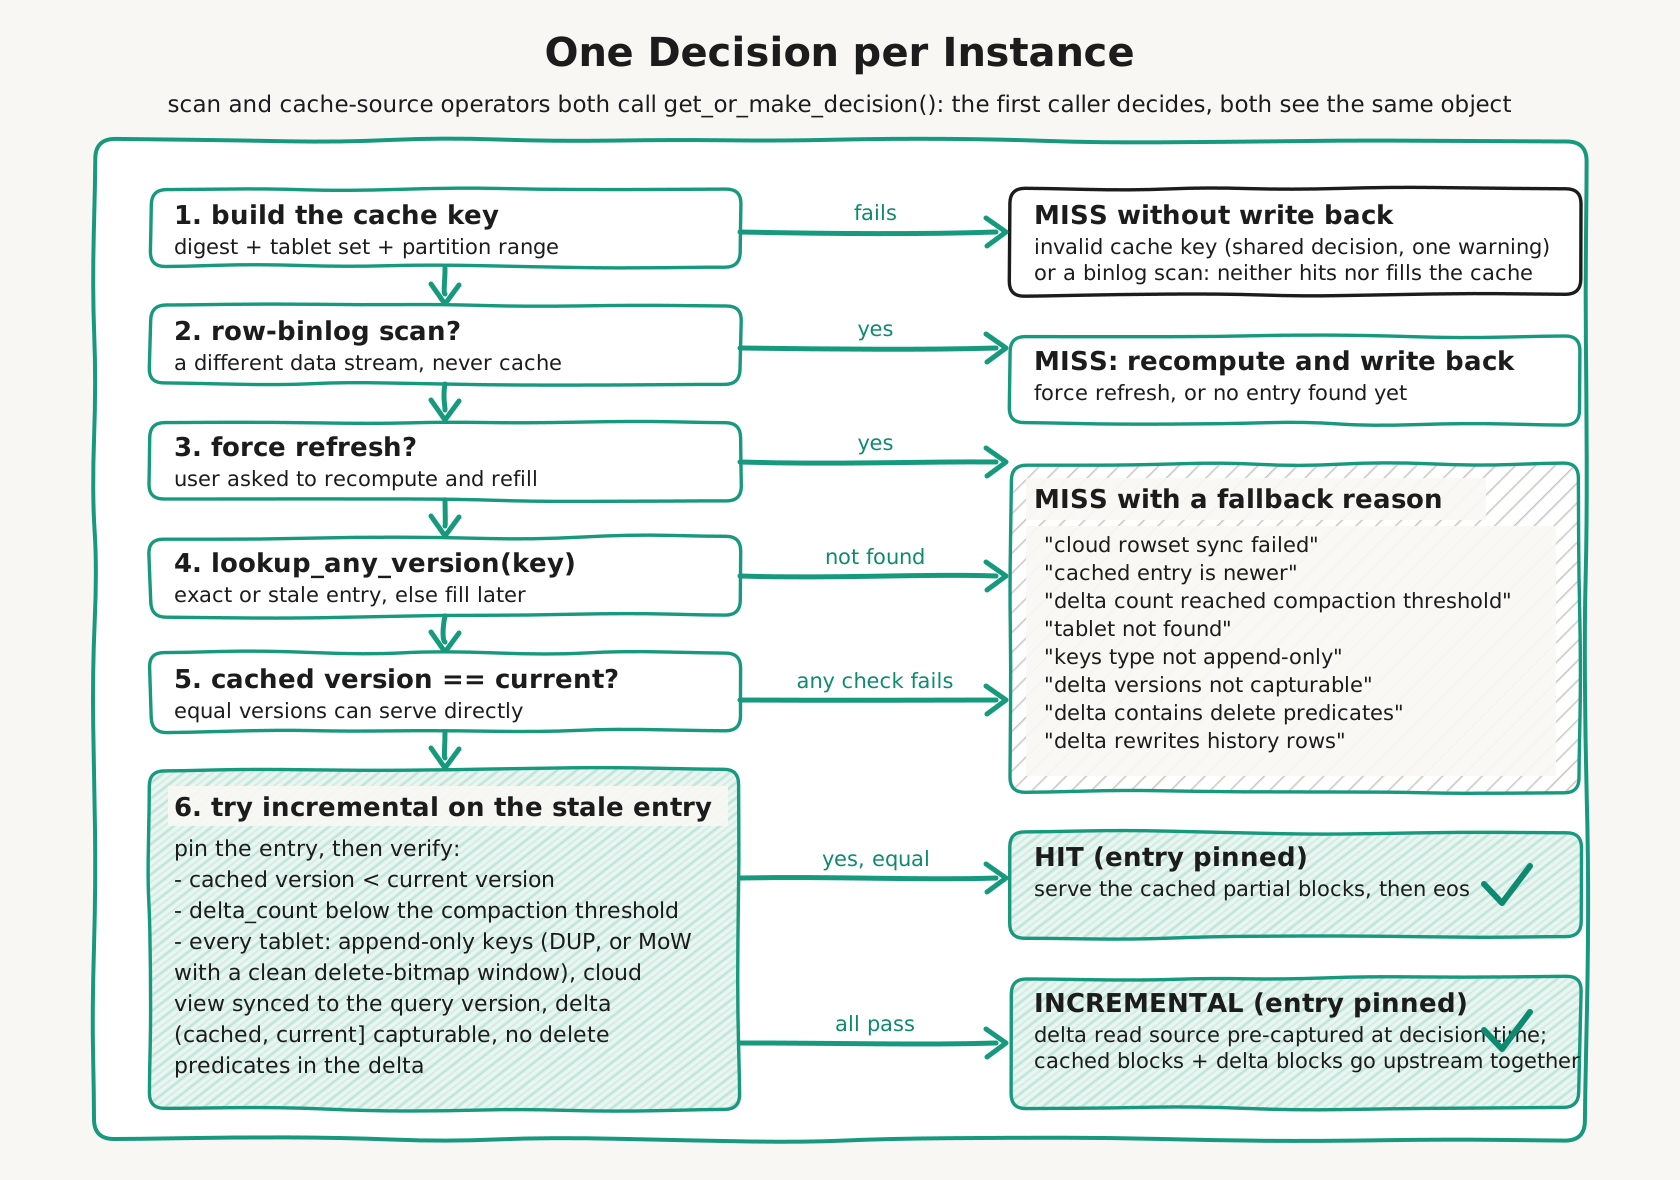
増分マージが有効になるのは、次の条件を すべて 満たす場合だけです。それ以外の場合は通知なしにクエリ全体の再計算にフォールバックするため、結果の正しさは常に保たれます。
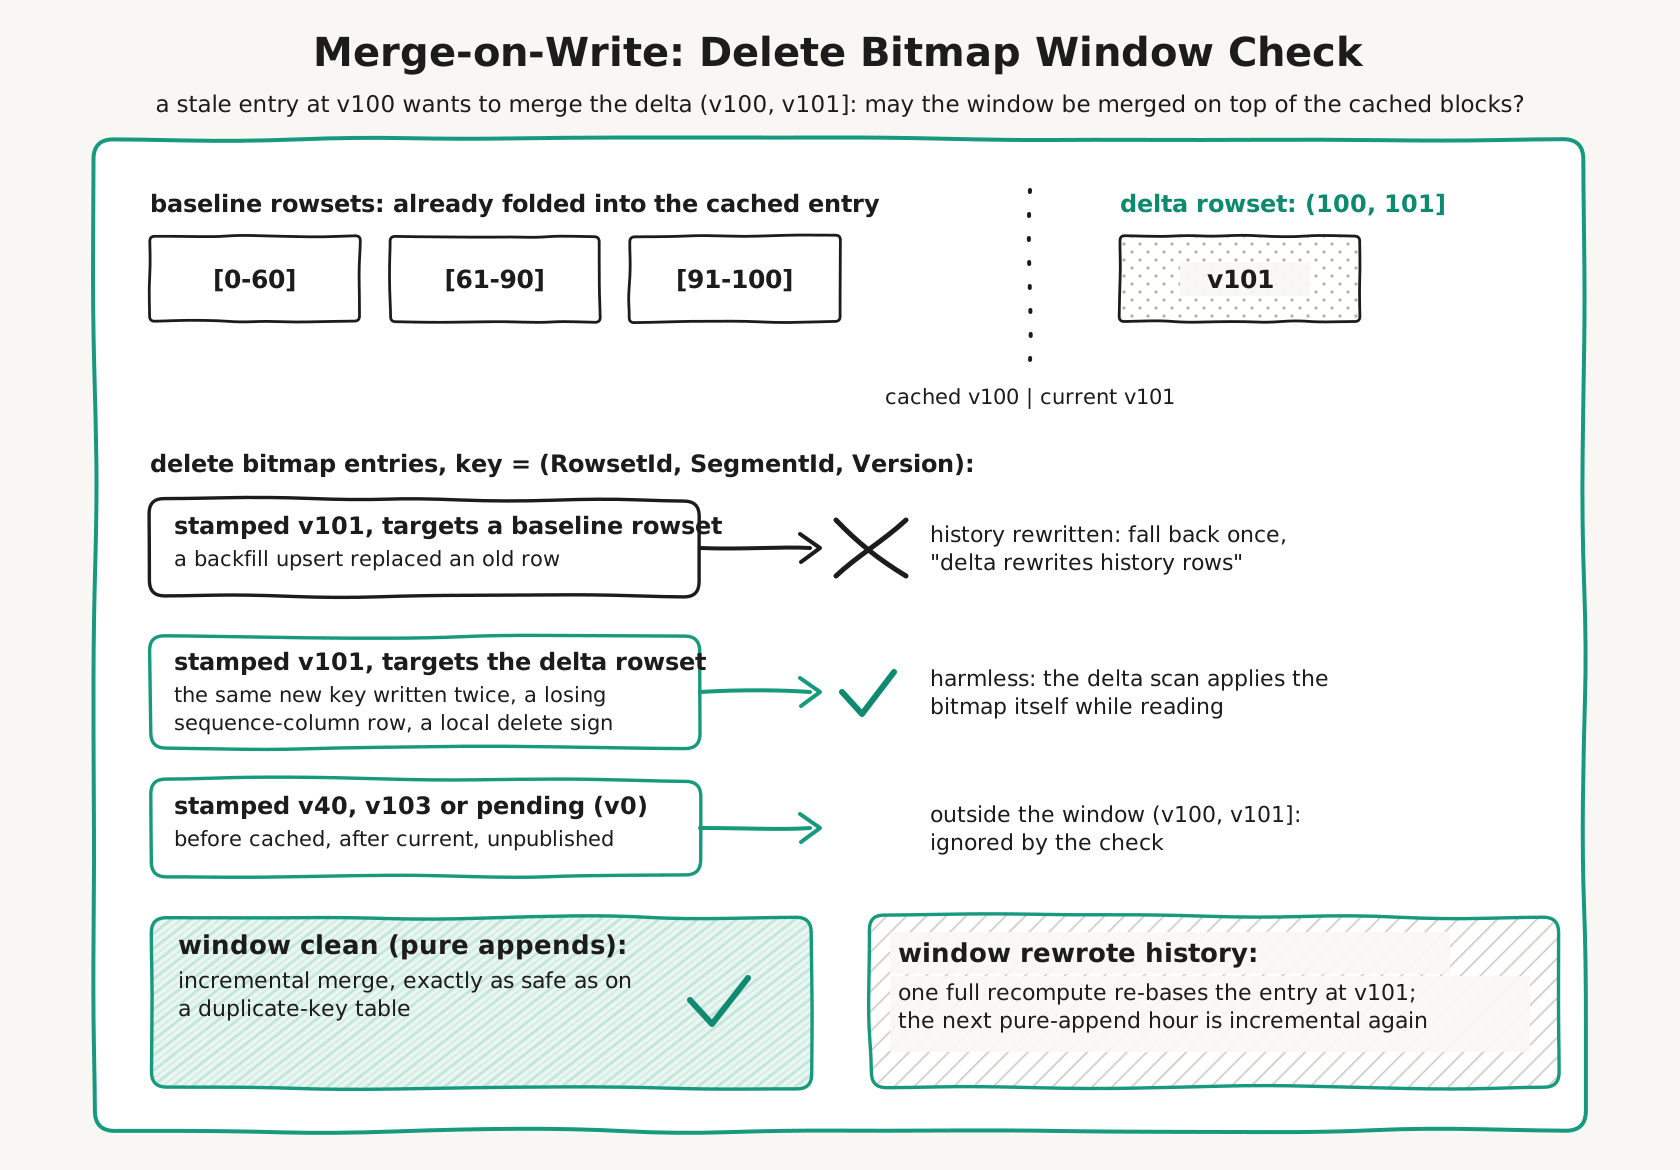
- スキャン対象のインデックス(ベーステーブルまたは選択されたロールアップ)が 追記専用 であること。具体的には、DUP_KEYS モデル、または差分のバージョン範囲で既存のキーが書き換えられていない merge-on-write UNIQUE_KEYS テーブルが該当します。merge-on-write テーブルでは、BE がタブレットごとに
(cached_version, current_version]の delete bitmap を確認します。新しいキーだけを追加した範囲(主キーテーブルへの一般的な「毎時ロード」のパターン)は増分マージされます。一方、古いキーに影響する upsert、部分更新、または削除マークがある場合は、一度の全体再計算にフォールバックします。これによってエントリの基準が更新されるため、次に純粋な追記ロードが行われたときには再び増分処理が可能になります。merge-on-read の UNIQUE テーブルは読み取り時に重複を解決し、AGG テーブルはストレージ層で行をマージするため、「キャッシュ済みスナップショット + 差分 = 新しいスナップショット」は成り立ちません。同じ理由で、集約マテリアライズドビューも対象外です。 - キャッシュポイントが スキャンの直上にある finalize されていない集約 であること(一般的な二段階集約の形。たとえば、分散列以外の列に対する
GROUP BY)。一段階集約と入れ子になった集約キャッシュポイントは対象外です。 - タブレットのビューを、クエリ対象のバージョンに同期できること。コンピュートとストレージが結合したモードでは、この条件はそのまま満たされます。コンピュートとストレージが分離した(クラウド)モードでは、タブレットごとの判定に先立ってローカルビュー(rowset、および merge-on-write テーブルでは delete bitmap)をクエリ対象のバージョンまで同期します。通常、ビューがすでに新しければ何も行わず、そうでなければスキャン時に必要な同期を前倒しするだけなので、追加コストはほぼありません。同期に失敗した場合、または短い即時失敗用の時間枠(BE 設定の
query_cache_decision_sync_timeout_ms。遅いメタサービスが判定用の受け入れスレッドを占有し続けないようにするためのもの)を超えた場合は、一度の全体再計算にフォールバックします。 - 差分のバージョン経路をまだ取得できること(コンパクションで統合されていないこと)、かつ DELETE 述語を含まないこと。差分内での削除は、キャッシュ済みブロックにすでに反映された行を論理的に削除するため、マージでは取り消せません。
merge-on-write テーブルでの delete bitmap の範囲チェックは、次のとおりです。
コンピュートとストレージが分離した(クラウド)クラスターでは、二つのセッション変数によって、バージョンの厳密さと速度を調整できます。query_freshness_tolerance_ms はスキャンがクエリ対象より前のウォームアップ済みバージョンで停止することを許可し、enable_prefer_cached_rowset はウォームアップ済みの rowset レイアウトに従うことを許可します。どちらの設定でも、たどる経路がクエリ対象のバージョンを超えることもあります(そのバージョンをまたぐウォームアップ済みのコンパクション rowset が経路をさらに先へ進めるためです)。したがって、どちらかの設定で実行するクエリは、バージョンが厳密に一致しないビューを読み取る可能性があり、増分マージを使用しません。差分の取得は常にクエリ対象の正確なバージョンを対象とするため、この設定の意図に反するからです。増分マージとは別に、BE はクラウド環境でそのようなクエリによる Query Cache への書き戻しもスキップします。そのため、内容とバージョン表示が一致しないエントリが作成されることはありません。ただし、通常の実行で作成された、正確なバージョンの HIT エントリは引き続き利用できます。増分マージからの除外自体は、すべてのデプロイモードに適用されます(モードに依存しないよう意図された条件です)。ローカルストレージではこれらの設定は効力を持たないため、クラウド専用の速度とのトレードオフを選んだクエリが増分最適化を利用できなくなるだけで、いずれの場合も結果の正しさは保たれます。
マージ済みエントリのコンパクション
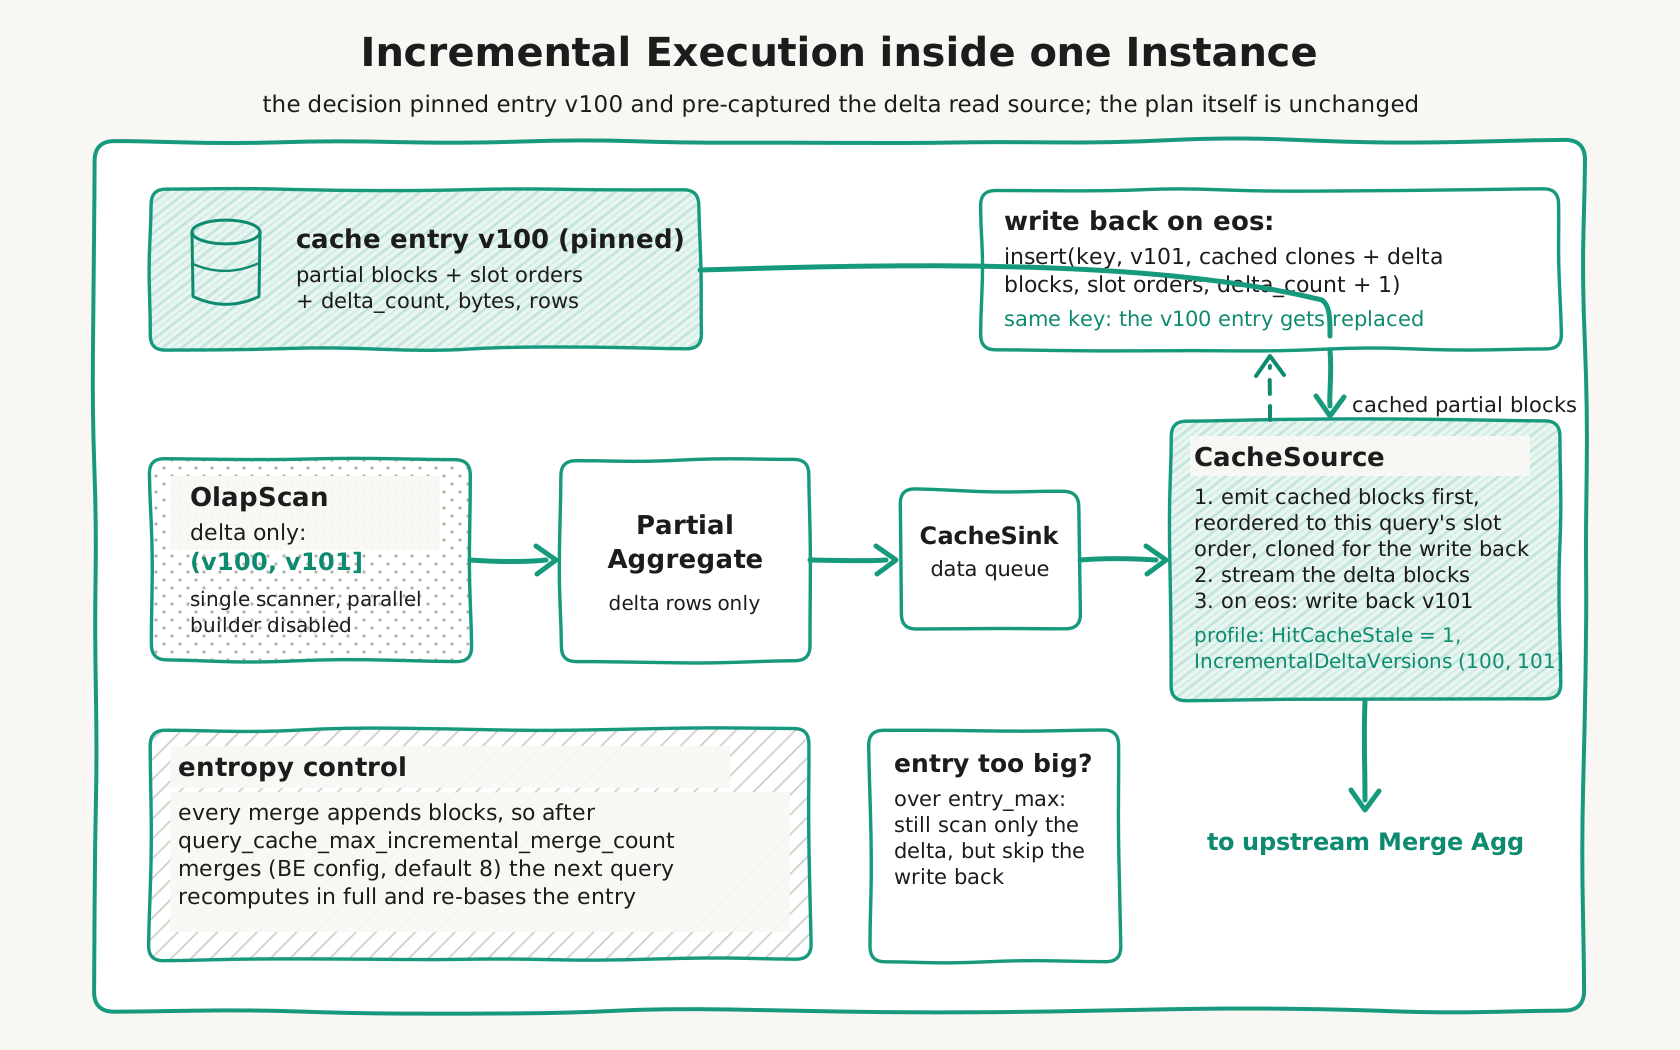
増分マージのたびに差分ブロックがエントリに追加されるため、時間とともにエントリの断片化が進みます。一つのエントリで query_cache_max_incremental_merge_count 回のマージが蓄積されると(BE 設定、デフォルトは 8、実行時に変更可能)、次のクエリはフルスキャンによってエントリを再計算し、自然にコンパクションします。
一つのインスタンス内のデータフローを、書き戻しと二つのエントロピー制御を含めて示します。
観測方法
- CACHE_SOURCE オペレーターのクエリプロファイルでは、
HitCacheStale = 1は増分マージを示し、IncrementalDeltaVersionsは差分範囲(たとえば(100, 114514])を示します。古いエントリを再利用できなかった場合、IncrementalFallbackReasonに理由(delta versions not capturable、delta contains delete predicates、delta rewrites history rows、keys type not append-only、cloud rowset sync failed、cloud rowset sync timed outなど)が表示されます。 - BE メトリクスには、
doris_be_query_cache_stale_hit_total、doris_be_query_cache_incremental_fallback_total、doris_be_query_cache_write_back_total、doris_be_query_cache_decision_sync_time_msがあります。最後のメトリクスが増加するのはコンピュートとストレージが分離したモードだけで、差分の取得前に、増分処理の判定のためにタブレットのビューをクエリ対象のバージョンまで同期するのに費やした累積経過時間を表します。
BE が HIT、INCREMENTAL、MISS のどれを選ぶか、および各フォールバック理由がどこで生じるかを示します。
FE による許可からストレージレベルの保護条件まで、全体をまとめて示します。
設定パラメータ
セッション変数(FE)
| パラメータ | 説明 | デフォルト |
|---|---|---|
enable_query_cache | Query Cache を有効または無効にするマスタースイッチです。 | false |
query_cache_force_refresh | true に設定すると、キャッシュ済みの結果を無視してクエリを再実行します。新しい結果は引き続きキャッシュに書き込まれます。 | false |
query_cache_entry_max_bytes | キャッシュエントリ一件の最大サイズ(バイト)です。この上限を超えるフラグメントの結果はキャッシュされません。 | 5242880(5 MB) |
query_cache_entry_max_rows | キャッシュエントリ一件の最大行数です。この上限を超えるフラグメントの結果はキャッシュされません。 | 500000 |
enable_query_cache_incremental | (実験的機能)キャッシュ済みバージョン以降の差分 rowset だけをスキャンし、キャッシュ済みの部分集約ブロックとマージすることで、BE が古いキャッシュエントリを再利用できるようにします。増分マージを参照してください。 | false |
BE 設定(be.conf)
| パラメータ | 説明 | デフォルト |
|---|---|---|
query_cache_size | 各 BE 上の Query Cache の総メモリ容量(MB)です。 | 512 |
query_cache_max_incremental_merge_count | 一つのキャッシュエントリに蓄積できる増分マージの最大回数です。この回数に達すると、コンパクションのために全体の再計算が強制されます。0 にすると、実行時に増分マージが無効になります。 | 8 |
query_cache_decision_sync_timeout_ms | (クラウドモードのみ)差分の取得前に、増分マージの判定のために各タブレットのビューをクエリ対象のバージョンまで同期する際の、即時失敗用の制限時間(ミリ秒)です。この時間内に同期が完了しない場合、クエリは一度の全体再計算にフォールバックします。<= 0 にすると、クラウドでの増分マージが無効になります(保留中の同期はすべてフォールバックします)。実行時に変更できます。 | 2000 |
query_cache_max_size_mb と query_cache_elasticity_size_mb は be.conf の設定項目で、従来の SQL Result Cache を制御します。この記事で説明するパイプラインレベルの Query Cache の設定では ありません。混同しないでください。
使用例
ステップ 1:Query Cache を有効にする
目的:Query Cache のマスタースイッチをオンにします。
SET enable_query_cache = true;
説明:この変数はセッション単位で適用されるため、接続ごとに有効にする必要があります。グローバルな FE 変数としてデフォルト値を設定することもできます。
ステップ 2:一般的な集約クエリを実行する
目的:キャッシュへの書き込みとキャッシュからの読み取りを発生させます。
-- First execution: cache miss, compute the result and write it to the cache
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt = '2024-01-15' AND status = 'completed'
GROUP BY region;

-- Second execution: cache hit, return the result directly from the cache
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt = '2024-01-15' AND status = 'completed'
GROUP BY region;
説明:二度目の実行では、SQL ダイジェスト、タブレット ID リスト、タブレット範囲が最初の実行と同じため、キャッシュにヒットします。
ステップ 3:プロファイルでヒットを確認する
目的:クエリが実際にキャッシュを使用しているか確認します。
クエリを実行した後、プロファイルの CacheSourceOperator セクションを確認します。
| プロファイルのフィールド | 意味 |
|---|---|
HitCache: true | クエリがキャッシュから結果を取得しました。 |
HitCache: false, InsertCache: true | キャッシュミスでしたが、結果は正常にキャッシュへ書き込まれました。 |
HitCache: false, InsertCache: false | キャッシュミスで、結果が大きすぎてキャッシュできませんでした。 |
CacheTabletId | キャッシュエントリが対象とするタブレットの ID です。 |
ステップ 4:キャッシュを強制更新する
目的:既存のキャッシュを無視して結果を再計算します(たとえば、キャッシュ済みデータが正しくないと疑われる場合)。
-- Force the next query to skip the cache and recompute the result
SET query_cache_force_refresh = true;

SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-15' GROUP BY region;

-- Reset
SET query_cache_force_refresh = false;
説明:強制更新後も、新しい結果はキャッシュに書き込まれます。
ユースケースの比較
| シナリオ | 適用可能 | 理由 |
|---|---|---|
| 同じ集約 SQL を繰り返し実行するダッシュボードや BI ツール | はい | ダイジェストとタブレットが完全に一致し、高いヒット率が得られます。 |
| T+1 レポート(データを毎日一回ロード) | はい | 同じ日に後続のクエリがキャッシュにヒットできます。 |
| 日付範囲が重複する集約クエリ | はい | 単一列の RANGE パーティショニングでは、タブレット単位でエントリを共有できます。 |
| 単純な SELECT スキャン、JOIN、ソート、ウィンドウ関数 | いいえ | 「集約とスキャン」のパターンだけがサポートされます。 |
| 外部テーブル(Hive、JDBC、Iceberg、Hudi、Paimon) | いいえ | タブレットやバージョンの仕組みがありません。代わりに SQL Cache を使用してください。 |
| 更新頻度の高いテーブル | いいえ | タブレットのバージョンが頻繁に変わり、ヒット率が低くなります。 |
now()、rand()、uuid()、または UDF を含むクエリ | いいえ | 非決定的な結果になるため、キャッシュは無効になります。 |
| ランタイムフィルターに依存するクエリ | いいえ | プラン作成時にはランタイムフィルターの値が不明です。 |
注意事項
- キャッシュは永続化されません:Query Cache は BE のメモリ上にあり、BE を再起動するとクリアされます。
- メモリ使用量:キャッシュ済みのデータブロックは BE のメモリを消費します。メモリ使用量を監視し、必要に応じて
query_cache_sizeを調整してください。 - LRU-K による登録:キャッシュが満杯の場合、新しいエントリが登録されるには少なくとも二度(K=2)アクセスする必要があります。これにより、使用頻度の低いクエリがキャッシュを占有するのを防ぎます。
トラブルシューティング
| 症状 | 考えられる原因 | 対処方法 |
|---|---|---|
HitCache: false が繰り返し表示される | enable_query_cache が有効になっていません。 | SET enable_query_cache = true を実行します。 |
HitCache: false, InsertCache: false | 単一エントリの結果が大きすぎて、query_cache_entry_max_bytes または _max_rows を超えています。 | 対応する上限を引き上げるか、フィルターを追加して結果のサイズを減らします。 |
プランに CacheSourceOperator がない | プランに JOIN/SORT/UNION/WINDOW が含まれるか、ランタイムフィルターの適用先になっています。 | SQL を「集約とスキャン」のパターンに合うように書き換えます。 |
| テーブルが外部テーブルである | Query Cache は外部テーブルをサポートしません。 | SQL Cache を使用します。 |
| データが変わっていないのにキャッシュミスになる | スキーマやセッション変数の変更、または query_cache_force_refresh = true が原因です。 | ALTER の履歴を確認し、セッション変数を比較して、query_cache_force_refresh をリセットします。 |
| キャッシュヒット率が非常に低い | タブレットが頻繁に更新またはコンパクションされています。 | 書き込み頻度を下げるか、更新頻度の低いテーブルに対してだけキャッシュを有効にします。 |
| BE のメモリ負荷が増える | query_cache_size の設定値が大きすぎます。 | query_cache_size を下げ、BE を再起動します。 |
FAQ
Q1:Query Cache と SQL Cache の違いは何ですか?
| 比較項目 | Query Cache | SQL Cache |
|---|---|---|
| キャッシュの粒度 | タブレット単位の集約中間結果。 | SQL ステートメント全体の最終結果。 |
| 適用できるクエリ | 内部 OLAP テーブルに対する集約クエリのみ。 | 外部テーブルに対するクエリを含む、あらゆるクエリ。 |
| 共有できる範囲 | 異なる SQL ステートメント間でも、タブレット単位でキャッシュエントリを共有できます。 | SQL テキストが完全に一致する場合だけヒットします。 |
| 無効化 | タブレットのバージョンが変わると直ちに無効になります。 | パーティションのバージョンまたは時間に基づきます。 |
Q2:有効にすると、すぐにキャッシュにヒットしますか?
いいえ。初回の実行では「キャッシュミスとキャッシュへの書き込み」が発生し、ヒットできるのは二度目以降です。また、LRU-K(K=2)では、新しいエントリが実際に登録されるまでに少なくとも二度のアクセスが必要です。
Q3:JOIN を含む集約をキャッシュできますか?
集約と JOIN の位置関係によります。集約が JOIN の直上にある場合(キャッシュ対象のサブツリーに JoinNode がある場合)は、ランタイムフィルターの有無にかかわらず、そのフラグメントはキャッシュされません。一方、先に集約してから JOIN するようクエリを書き換えれば(各テーブルのスキャンまで集約をプッシュダウンすれば)、各テーブルのタブレット単位の集約を個別にキャッシュできます。ただし、ここでも独立した制約が一つあります。JOIN はプローブ側のスキャンにランタイムフィルターをプッシュするため、その側のフラグメントはキャッシュできません。したがって、ランタイムフィルターが有効な場合にキャッシュされるのはビルド側だけです。JOIN 内のすべてのテーブルをキャッシュ可能にするには、さらに runtime_filter_mode=OFF を設定してください。代わりにマテリアライズドビューを使用することもできます。
Q4:BE の再起動後、キャッシュのウォームアップは必要ですか?
はい。Query Cache はメモリ内のキャッシュであり、再起動時にクリアされます。負荷の低い時間帯に主要な集約 SQL を実行してウォームアップできます。
Q5:実際にキャッシュにヒットしたかどうかは、どう確認できますか?
SQL を実行した後、プロファイルで HitCache フィールドを確認してください。このフィールドは CacheSourceOperator にあります。
まとめ
Query Cache は、集約の中間結果をタブレット単位でキャッシュする、Doris のパイプラインレベルの最適化機構です。主な特徴は次のとおりです。
- 内部 OLAP テーブルに対する 集約クエリだけ に適用されます。
- タブレットのバージョンに基づいて、キャッシュを自動的に無効化します。
- パーティション述語をダイジェストから適切に分離し、パーティション範囲が重複するクエリ間でキャッシュを共有できるようにします。
- エントリ単位のサイズと行数の上限によって、大きすぎる結果がキャッシュメモリを消費するのを防ぎます。
- LRU-K(K=2)の追い出しポリシーを使用して、キャッシュの有用性を維持します。
