Aggregate モデル
Doris の Aggregate Key モデルは、大規模なデータに対する集約クエリを効率よく処理するためのモデルです。データの取り込み時とバックグラウンドでのマージ時に事前集約を行うことで、重複する計算を減らし、集約結果のみを保存してストレージ容量を節約するとともに、クエリを高速化します。
適用シナリオ
Aggregate モデルは、次の二種類の業務シナリオに適しています。
- 明細データの集計: EC プラットフォームにおける月次売上実績、金融リスク管理における顧客の取引総額、広告のクリック数など、多次元の集計分析。
- 元の明細データに依存しないクエリ: ダッシュボード用レポートやユーザーの取引行動分析など。元の明細データはデータレイクに保持し、データウェアハウスには集約結果のみを保存します。
動作の仕組み
Aggregate モデルでは、データを取り込むたびに新しいバージョンが作成されます。バックグラウンドの Compaction でバージョンがマージされ、クエリ時には主キーに基づいてデータが再度集約されます。処理全体は次の三段階に分かれます。
- データ取り込み段階: データをバッチ単位で取り込みます。各バッチで一つのバージョンが生成され、同じ集約キーを持つ行が事前集約されます(合計や件数の集計など)。
- バックグラウンドのマージ段階(Compaction): 複数のバージョンファイルを定期的にマージし、冗長なデータを減らしてストレージを最適化します。
- クエリ段階: 正確なクエリ結果を得るため、集約キーに基づいてデータを最終的に集約します。
テーブル作成構文
AGGREGATE KEY キーワードで Aggregate モデルを指定し、Value 列の集約に使用する Key 列を宣言します。
CREATE TABLE IF NOT EXISTS example_tbl_agg
(
    user_id             LARGEINT    NOT NULL,
    load_date           DATE        NOT NULL,
    city                VARCHAR(20),
    last_visit_dt       DATETIME    REPLACE DEFAULT "1970-01-01 00:00:00",
    cost                BIGINT      SUM     DEFAULT "0",
    max_dwell           INT         MAX     DEFAULT "0"
)
AGGREGATE KEY(user_id, load_date, city)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
上の例では、ユーザー情報と訪問行動を記録するテーブルを定義し、user_id、load_date、city を集約用の Key 列に指定しています。データの取り込み時には、Key 列の値が同じ行が一行に集約され、Value 列は宣言された集約方法に従って集約されます。
サポートされる集約方法
集約テーブルの Value 列では、次の集約方法を使用できます。
| 集約方法 | 説明 |
|---|---|
| SUM | 複数行の Value を加算します。 |
| REPLACE | 後続のバッチの Value で、それまでの行の Value を置き換えます。 |
| MAX | 最大値を保持します。 |
| MIN | 最小値を保持します。 |
| REPLACE_IF_NOT_NULL | NULL でない値で置き換えます。REPLACE と異なり、null 値では置き換えません。 |
| HLL_UNION | HLL 型の列に使用し、HyperLogLog アルゴリズムで集約します。 |
| BITMAP_UNION | BITMAP 型の列に使用し、ビットマップの和集合を求めます。 |
上記の集約方法で業務要件を満たせない場合は、AGG_STATE 型を使用できます。
データの書き込みと集約の例
集約テーブルのデータは Key 列に基づいて集約され、書き込みが完了すると集約も完了します。
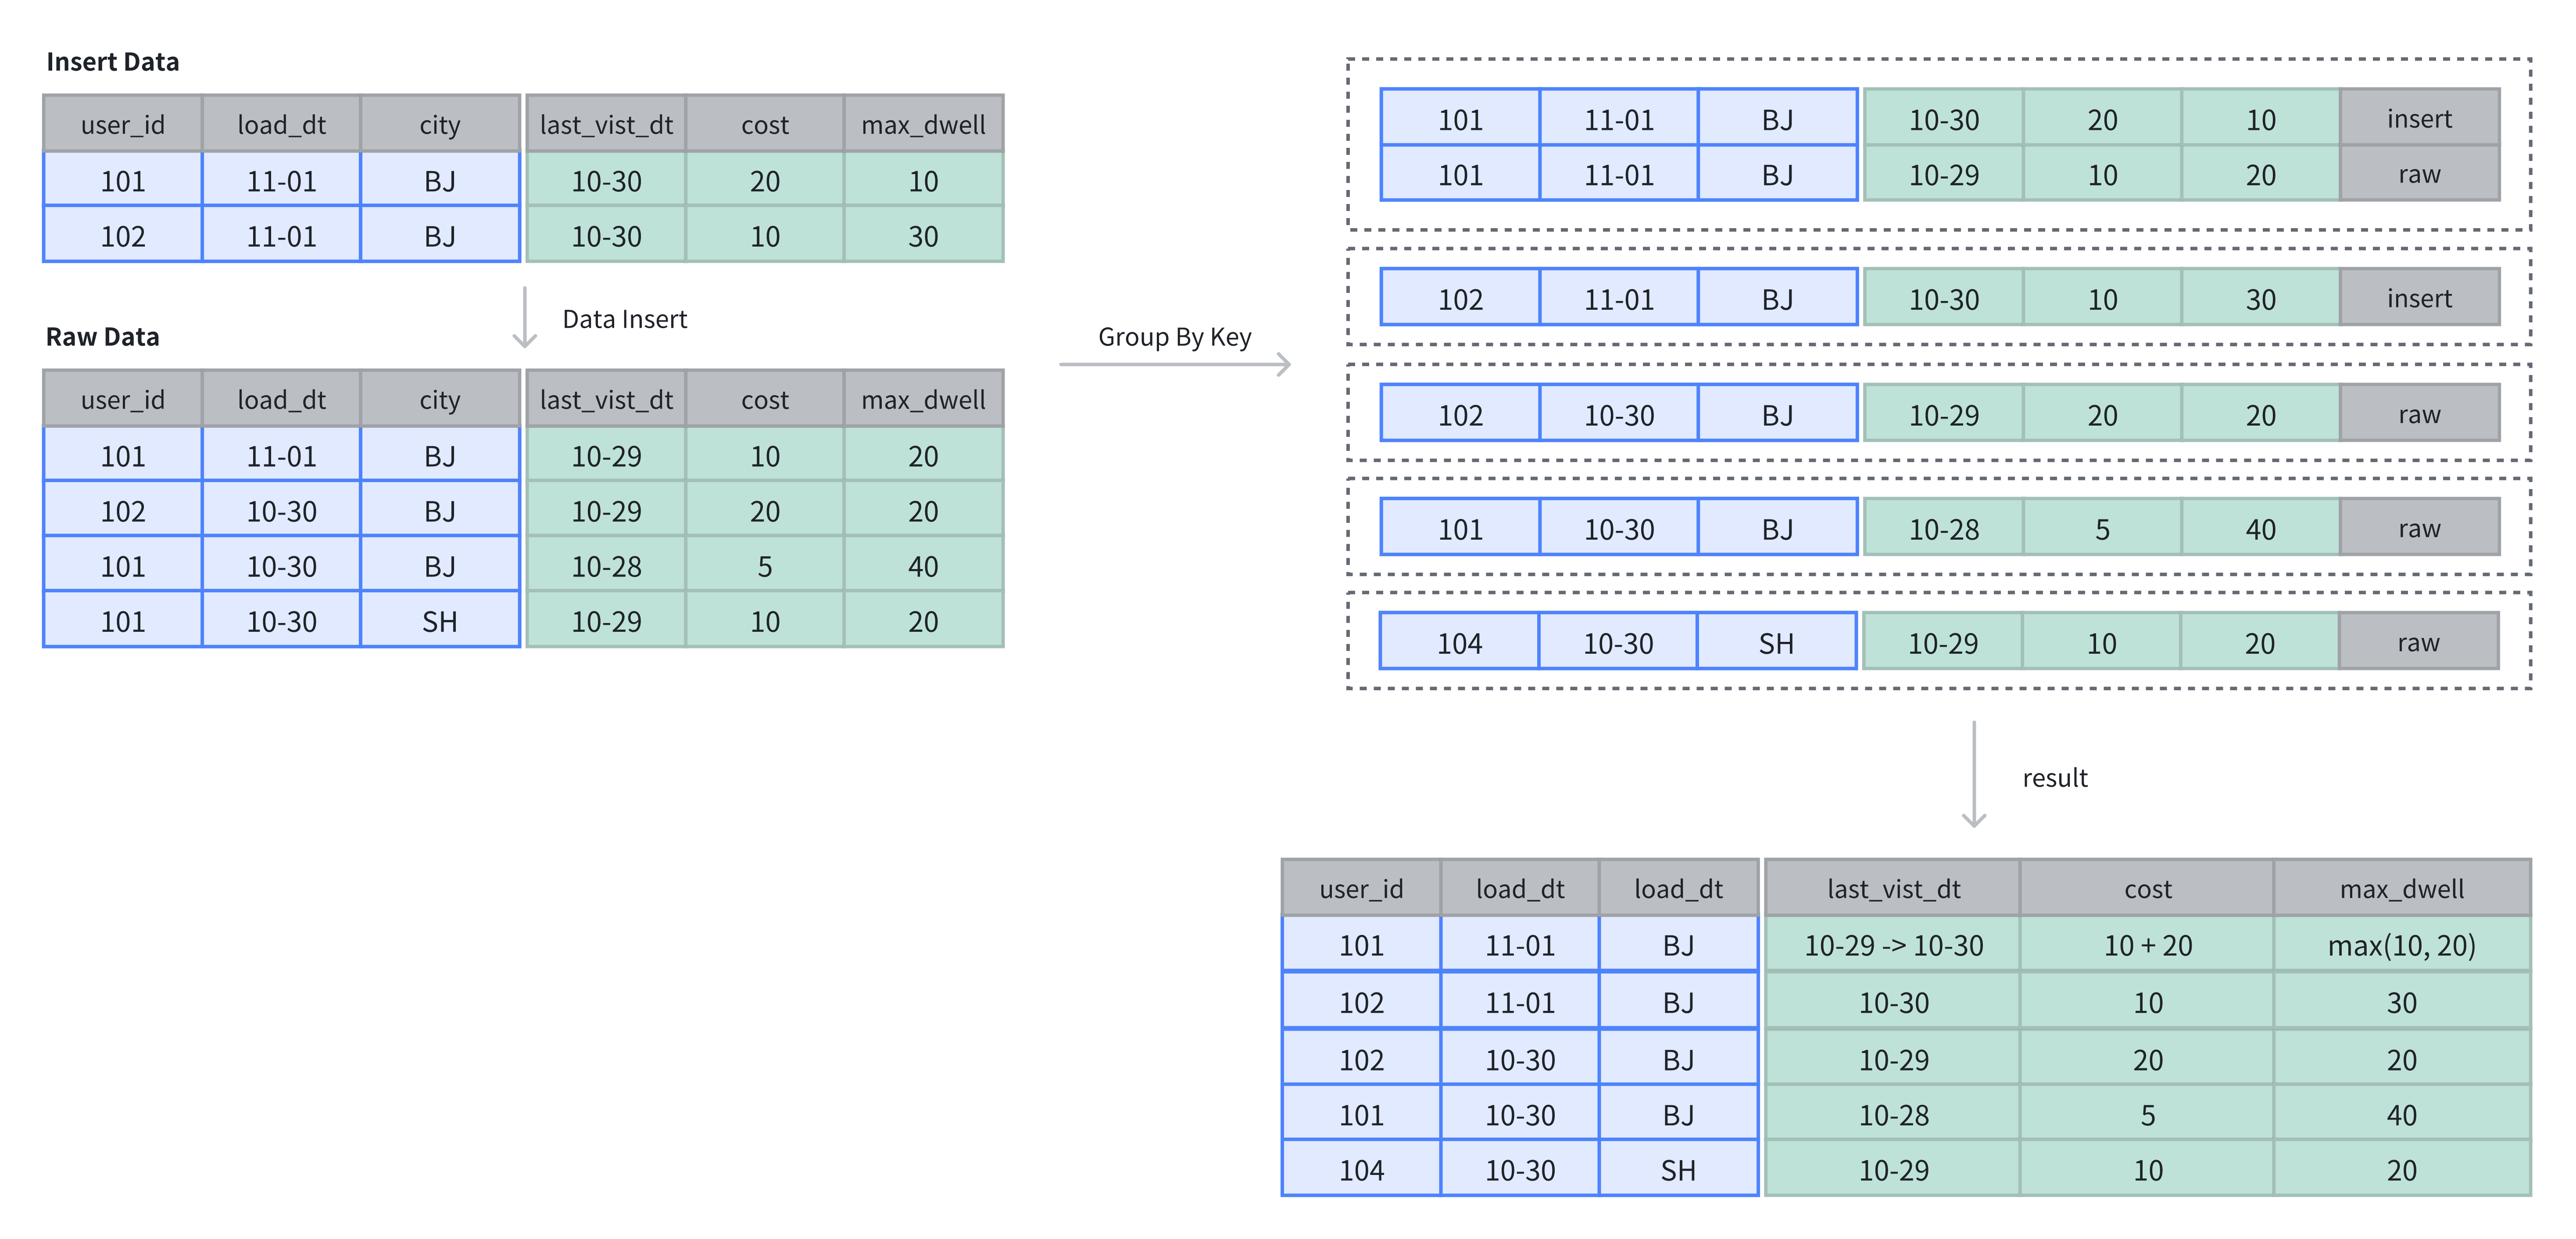
次の例では、テーブルに最初から 4 行のデータがあります。さらに 2 行を挿入すると、Key 列に基づいて Value 列が集約されます。
-- 4 rows raw data
INSERT INTO example_tbl_agg VALUES
(101, '2024-11-01', 'BJ', '2024-10-29', 10, 20),
(102, '2024-10-30', 'BJ', '2024-10-29', 20, 20),
(101, '2024-10-30', 'BJ', '2024-10-28',  5, 40),
(101, '2024-10-30', 'SH', '2024-10-29', 10, 20);

-- insert into 2 rows
INSERT INTO example_tbl_agg VALUES
(101, '2024-11-01', 'BJ', '2024-10-30', 20, 10),
(102, '2024-11-01', 'BJ', '2024-10-30', 10, 30);

-- check the rows of table
SELECT * FROM example_tbl_agg;
+---------+------------+------+---------------------+------+----------------+
| user_id | load_date  | city | last_visit_dt       | cost | max_dwell       |
+---------+------------+------+---------------------+------+----------------+
| 102     | 2024-10-30 | BJ   | 2024-10-29 00:00:00 |   20 |             20 |
| 102     | 2024-11-01 | BJ   | 2024-10-30 00:00:00 |   10 |             30 |
| 101     | 2024-10-30 | BJ   | 2024-10-28 00:00:00 |    5 |             40 |
| 101     | 2024-10-30 | SH   | 2024-10-29 00:00:00 |   10 |             20 |
| 101     | 2024-11-01 | BJ   | 2024-10-30 00:00:00 |   30 |             20 |
+---------+------------+------+---------------------+------+----------------+
AGG_STATE
AGG_STATE は実験的な機能です。開発環境およびテスト環境での使用を推奨します。
AGG_STATE は、組み込みの集約方法では要件を満たせない場合に適しています。使用する際は、次の制約に注意してください。
- Key 列には使用できません。
- テーブル作成時に集約関数のシグネチャを宣言する必要があります。
- 長さやデフォルト値を指定する必要はありません。実際のストレージ使用量は関数の実装に依存します。
テーブル作成例
set enable_agg_state = true;

CREATE TABLE aggstate
(
    k1   INT  NULL,
    v1   INT  SUM,
    v2   agg_state<group_concat(string)> generic
)
AGGREGATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 3;
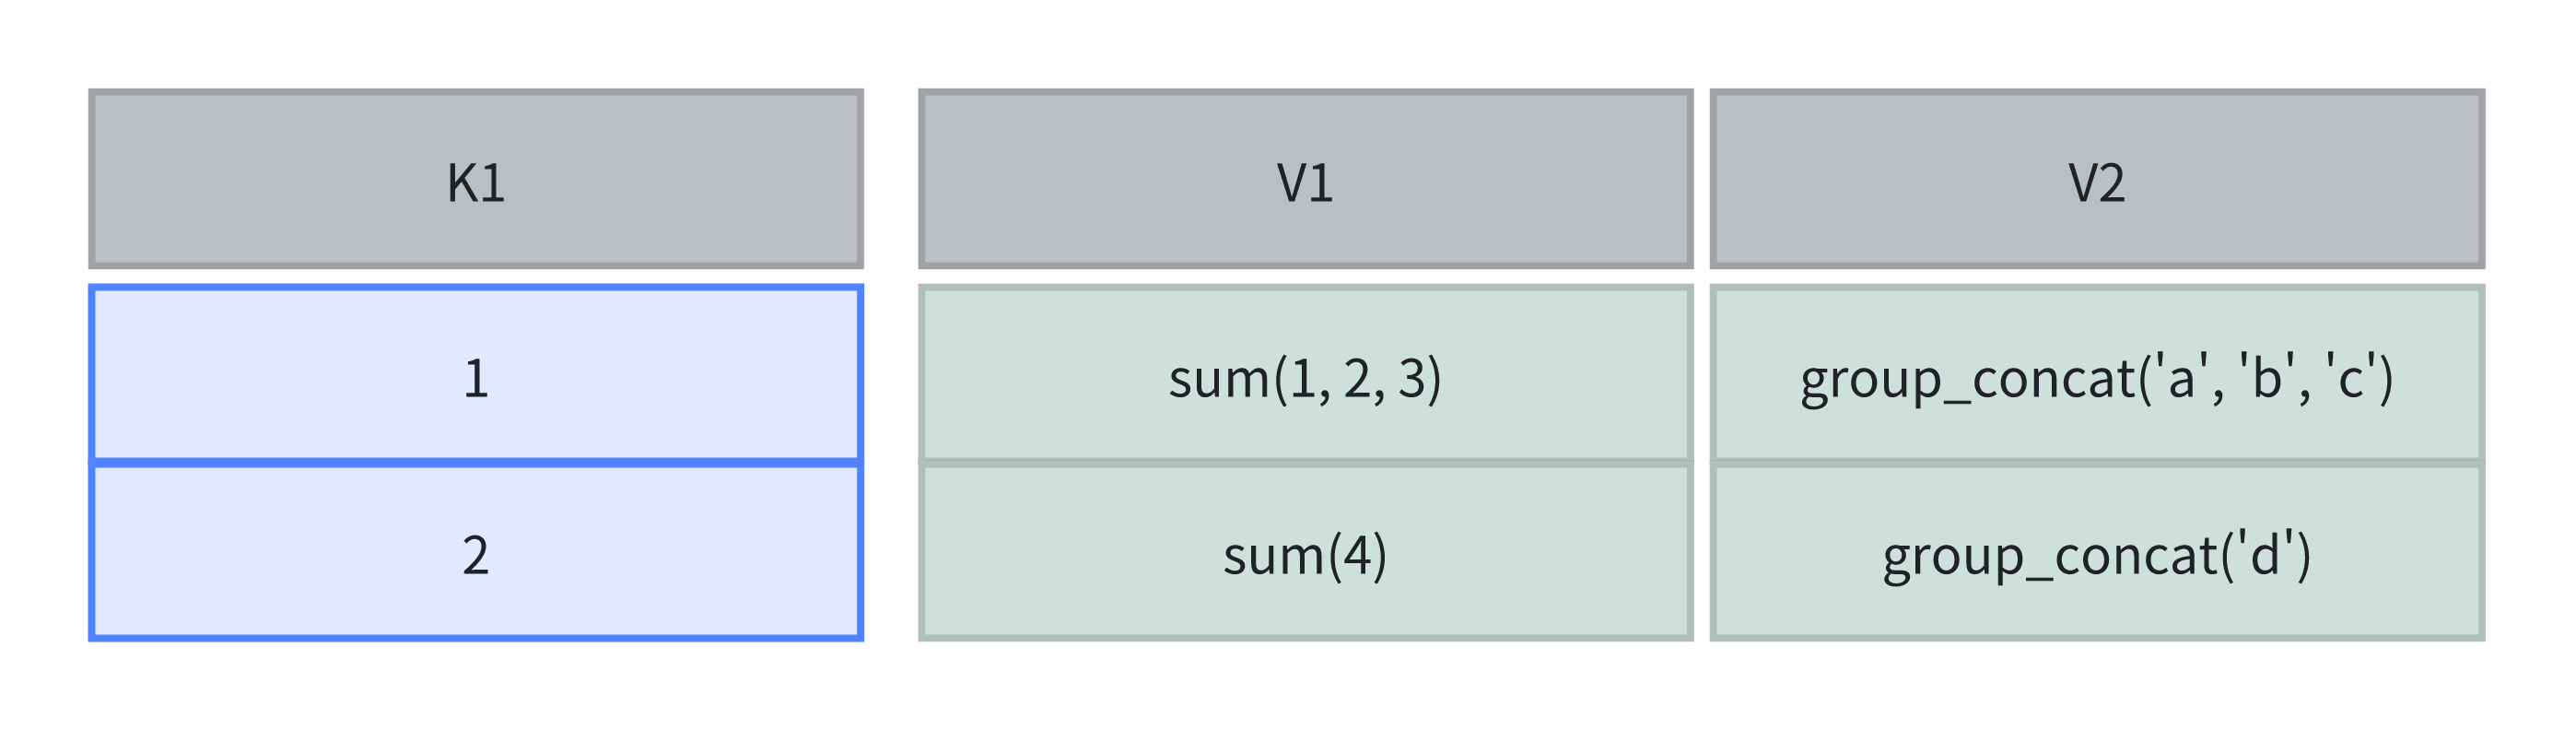
上の例では、agg_state でデータ型を宣言し、sum と group_concat を集約関数のシグネチャとして使用しています。agg_state は int、array、string と同様のデータ型であり、state、merge、union の三つの関数コンビネータと組み合わせてのみ使用できます。これは集約関数の中間結果(たとえば group_concat の中間状態)を表し、最終結果ではありません。
書き込み: state で中間結果を生成する
agg_state 型のデータは state 関数を使用して生成する必要があります。このテーブルでは、group_concat_state を使用します。
INSERT INTO aggstate VALUES (1, 1, group_concat_state('a'));
INSERT INTO aggstate VALUES (1, 2, group_concat_state('b'));
INSERT INTO aggstate VALUES (1, 3, group_concat_state('c'));
INSERT INTO aggstate VALUES (2, 4, group_concat_state('d'));
この時点でのテーブル内の計算を次の図に示します。
クエリ: merge で最終結果を返す
クエリ時には、merge 操作で複数の状態を統合し、最終的な集約結果を返すことができます。group_concat は順序に依存するため、結果は一定しません。
SELECT group_concat_merge(v2) FROM aggstate;
+------------------------+
| group_concat_merge(v2) |
+------------------------+
| d,c,b,a                |
+------------------------+
中間結果の保持: union 操作を使用する
最終的な集約結果が不要で、中間結果を保持したい場合は、union 操作を使用します。
INSERT INTO aggstate
SELECT 3, sum(v1), group_concat_union(v2) FROM aggstate;
この時点でのテーブル内の計算を次の図に示します。
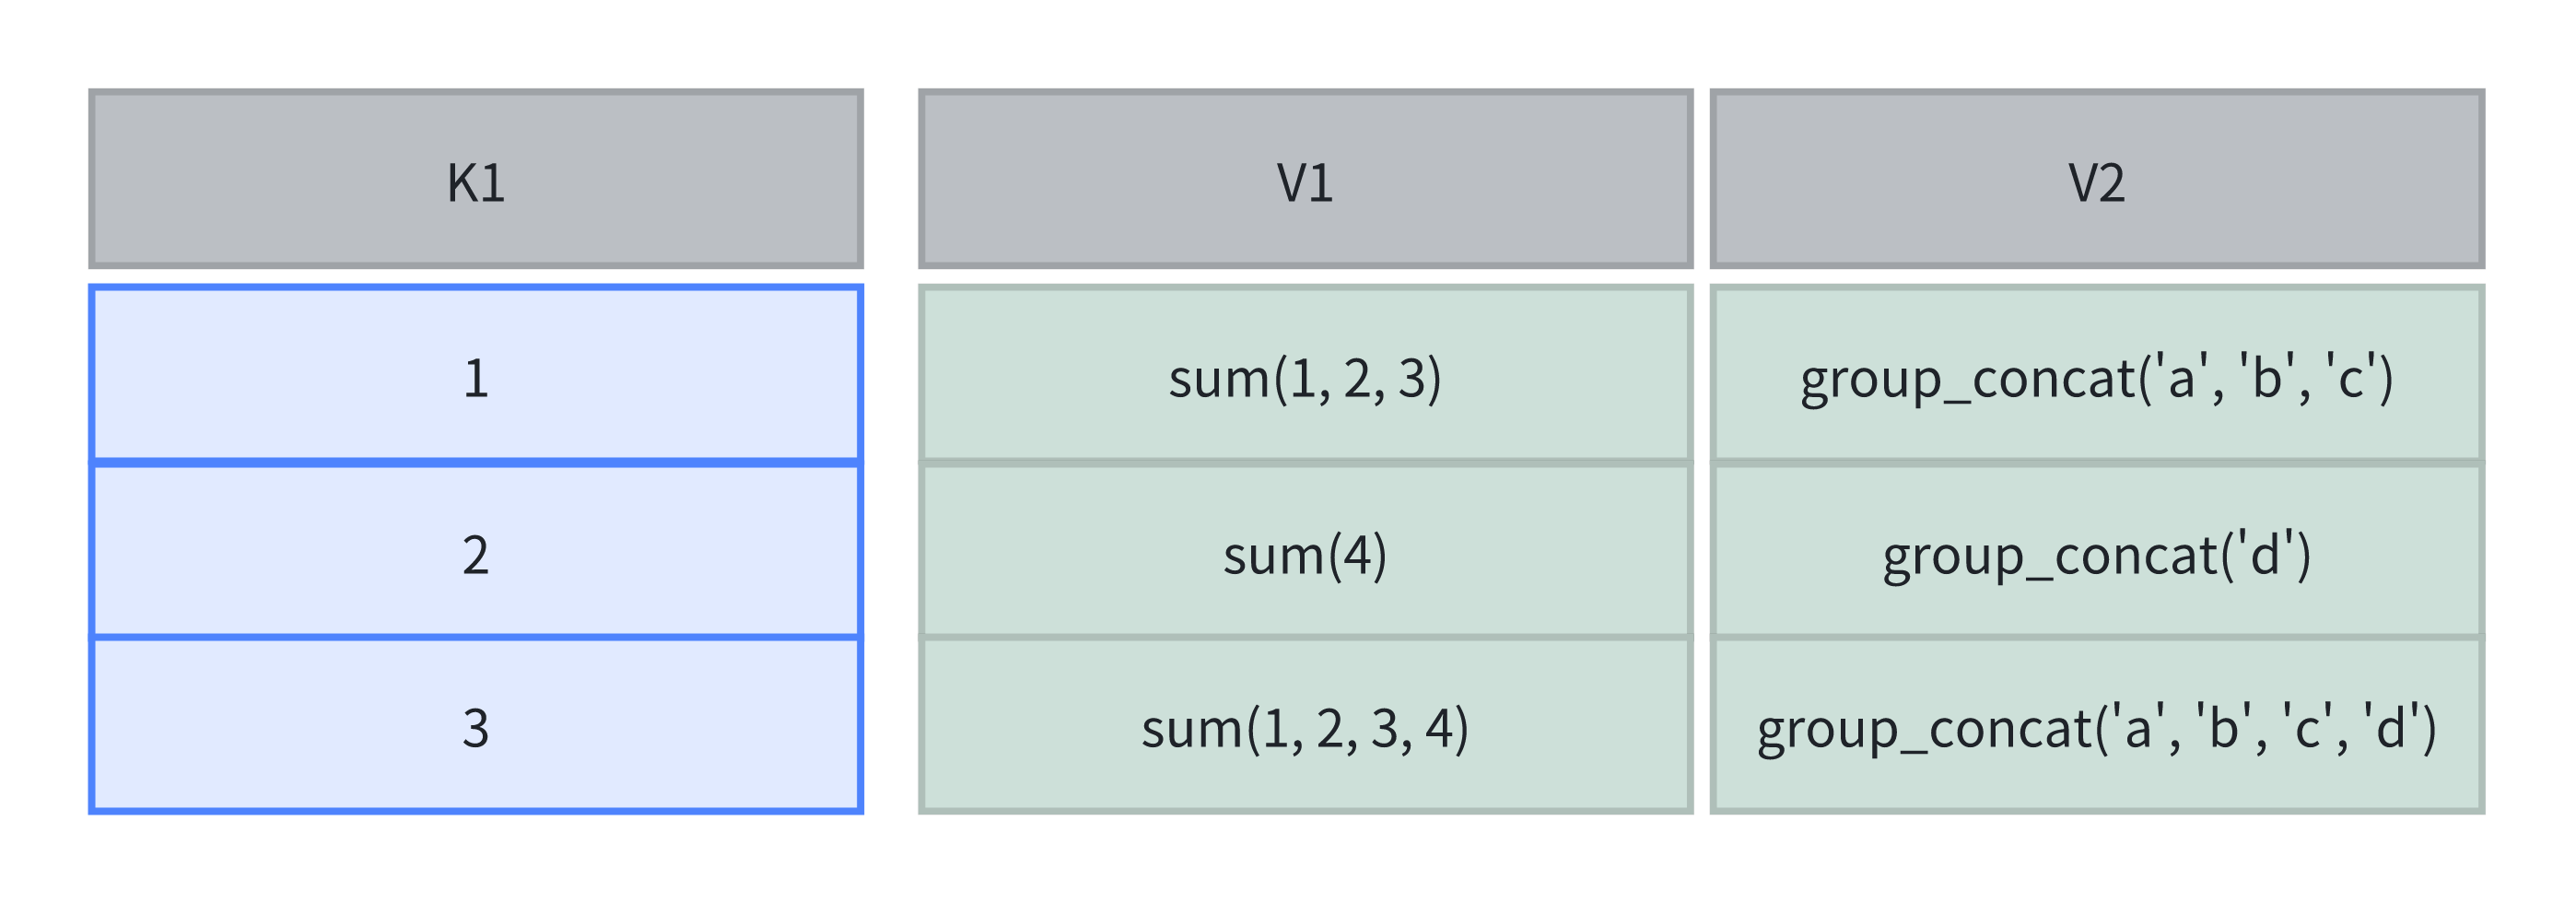
group_concat は順序に依存するため、結果は一定しません。クエリ結果は次のとおりです。
mysql> SELECT sum(v1), group_concat_merge(v2) FROM aggstate;
+---------+------------------------+
| sum(v1) | group_concat_merge(v2) |
+---------+------------------------+
|      20 | c,b,a,d,c,b,a,d        |
+---------+------------------------+

mysql> SELECT sum(v1), group_concat_merge(v2) FROM aggstate WHERE k1 != 2;
+---------+------------------------+
| sum(v1) | group_concat_merge(v2) |
+---------+------------------------+
|      16 | c,b,a,d,c,b,a          |
+---------+------------------------+