プレフィックスインデックスとソートキー
プレフィックスインデックスは、Apache Doris が標準で作成し、自動的に維持するスパースインデックスです。ソートキーの先頭 36 バイトに基づいてデータブロックを素早く特定でき、手動で作成する必要はありません。テーブルスキーマの設計時に適切なソートキーを選ぶと、WHERE 条件での等価検索や範囲検索を大幅に高速化できます。
仕組み
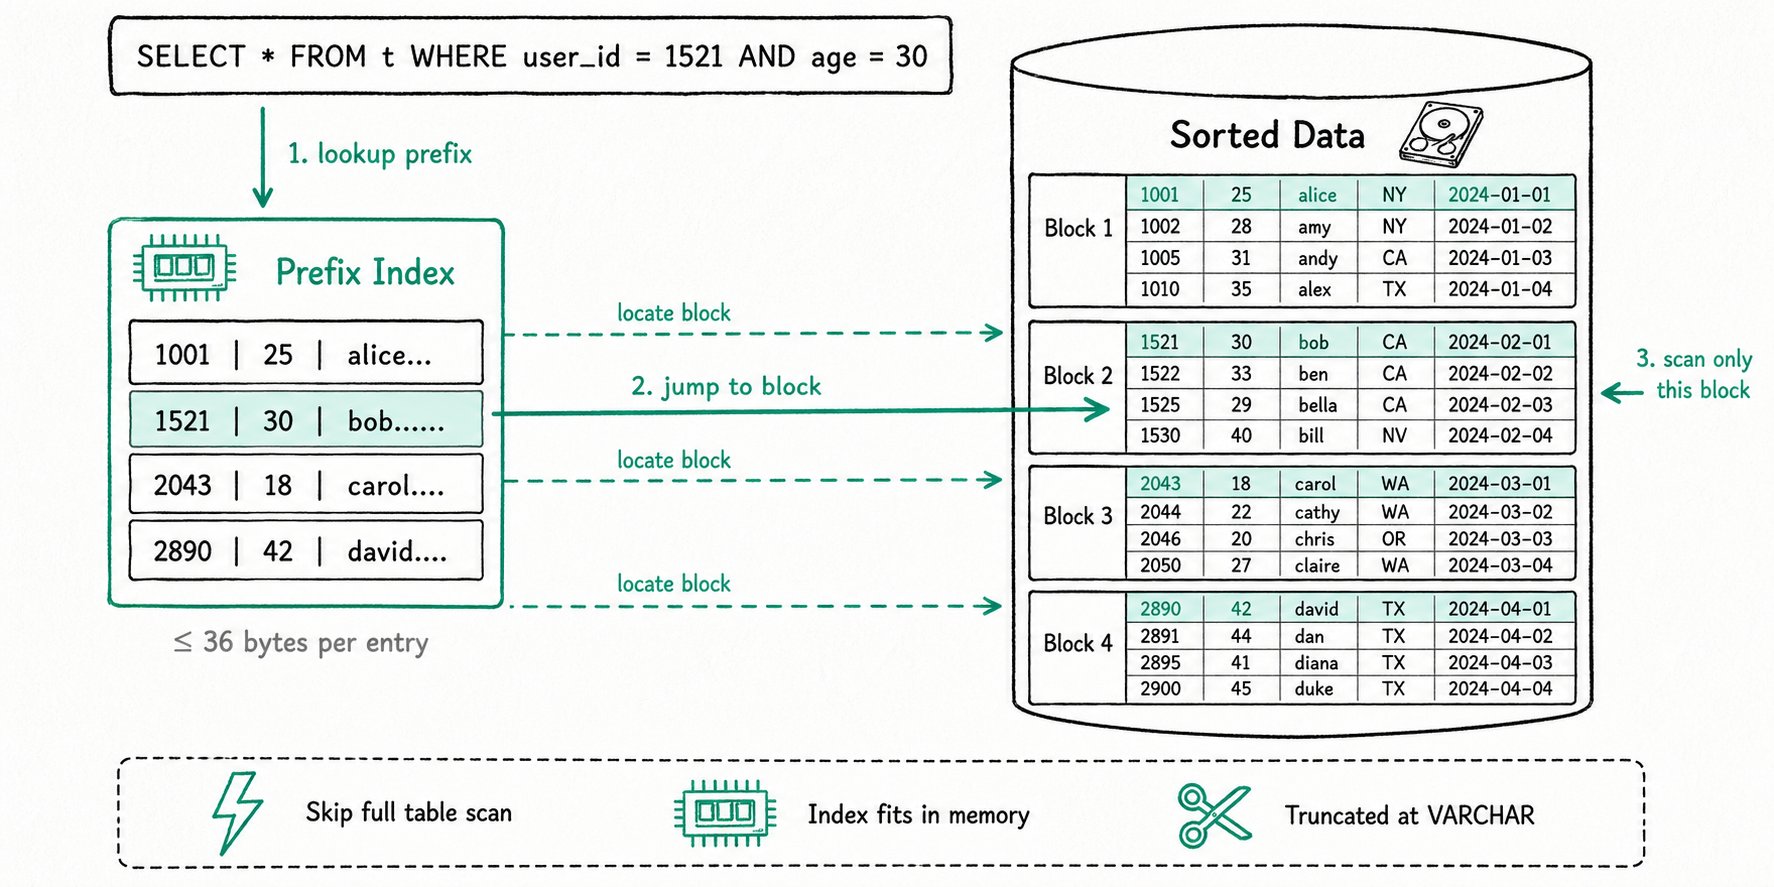
ソートキー
Apache Doris は、SSTable(Sorted String Table)に似た順序付きの構造でデータを保存します。指定した一つ以上のカラムを基準に、データをソートして保存できます。これらのカラムをソートキーと呼びます。
データモデルによって、ソートキーの定義元は異なります。
| データモデル | ソートキーの定義元 |
|---|---|
| Aggregate | CREATE TABLE 文の Aggregate Key |
| Unique | CREATE TABLE 文の Unique Key |
| Duplicate | CREATE TABLE 文の Duplicate Key |
クエリの WHERE 条件がソートカラムに一致すると、Doris はソートキーを使って該当するデータ範囲に素早く移動できます。これにより、テーブル全体のスキャンを避け、検索に必要な処理を減らしてクエリを高速化します。
プレフィックスインデックス
Apache Doris は、ソートキーに基づくプレフィックスインデックスも使用します。
- テーブル内の数行ごとに、一つの論理的なデータブロックを構成します。
- 各データブロックについて、プレフィックスインデックスには一つのエントリだけが保持されます。このエントリは、ブロックの先頭行にあるソートカラムを連結して得られるプレフィックスで、長さは最大 36 バイトです。
- プレフィックスインデックスは小さいため、全体をメモリにキャッシュできます。対象のデータブロックの先頭行番号を素早く特定でき、クエリの効率が大幅に向上します。
36 バイトでの切り詰め規則
プレフィックスインデックスは、行のソートカラムの先頭 36 バイトをインデックスの内容として使用します。ただし、VARCHAR カラムに達すると、そこで切り詰めます。
- ソートカラムを連結して
VARCHARカラムに達した場合、36 バイトに達しているかどうかにかかわらず、そのカラムの末尾で切り詰めます。 - 先頭カラムが
VARCHARの場合、その長さが 36 バイト未満でもカラムの末尾で切り詰め、後続のカラムはプレフィックスインデックスに追加しません。
適用シナリオ
プレフィックスインデックスは、主に次のクエリを対象とします。
- 等価検索:
col = value、col IN (...) - 範囲検索:
col > value、BETWEEN ... AND ...など
WHERE 条件がソートキーのプレフィックス、つまり先頭カラムから連続するカラムに一致すれば、プレフィックスインデックスによってクエリを高速化できます。
テーブルスキーマの設計に関する推奨事項
テーブルにはソートキーの定義が一つしかないため、一つのテーブルが持てるプレフィックスインデックスの組も一つだけです。テーブル作成時のソートキーの選択によって、プレフィックスインデックスによる高速化の効果が決まります。次の点を検討してください。
WHEREのフィルタ条件に最も頻繁に現れるカラムを Key カラムとして優先的に選びます。- クエリでより頻繁に使用するカラムを前に配置します。プレフィックスインデックスが有効なのは、左端のカラムから連続して条件に一致する場合だけです。
- **
VARCHARカラムをソートキーの先頭付近に配置する場合は注意してください。**切り詰めが発生し、後続のカラムがプレフィックスインデックスに含まれなくなる可能性があります。
頻繁に使うクエリ条件が、ソートキーを調整してもプレフィックスインデックスに一致しない場合は、後述のプレフィックスインデックスに一致しない場合の代替手段を参照してください。
使用例
例 1:切り詰めが発生しないプレフィックスインデックス
次のソートキーでは、プレフィックスインデックスは user_id (8 Bytes) + age (4 Bytes) + message (first 20 Bytes) となり、合計 32 バイトです。
| カラム名 | 型 |
|---|---|
| user_id | BIGINT |
| age | INT |
| message | VARCHAR(100) |
| max_dwell_time | DATETIME |
| min_dwell_time | DATETIME |
例 2:先頭カラムが VARCHAR で切り詰めが発生する場合
次のソートキーでは、プレフィックスインデックスは user_name (20 Bytes) のみです。合計が 36 バイトに達していなくても、先頭カラムが VARCHAR であるためそこで切り詰められ、後続のカラムはプレフィックスインデックスに追加されません。
| カラム名 | 型 |
|---|---|
| user_name | VARCHAR(20) |
| age | INT |
| message | VARCHAR(100) |
| max_dwell_time | DATETIME |
| min_dwell_time | DATETIME |
例 3:プレフィックスインデックスに一致するクエリと一致しないクエリ
例 1 のテーブルスキーマを前提とします。
-
プレフィックスインデックスに一致する場合(条件がソートキーの左端の二つのカラムを対象とするため、効率が高い):
SELECT * FROM table WHERE user_id = 1829239 AND age = 20; -
プレフィックスインデックスに一致しない場合(条件が
user_idを飛ばしているため、プレフィックスを使った位置の特定ができない):SELECT * FROM table WHERE age = 20;
したがって、テーブル作成時に適切なカラム順序を選ぶことで、クエリの効率を大きく改善できます。
インデックスの効果の確認
プレフィックスインデックスは、クエリを高速化できる場合に自動的に適用され、特別な構文は不要です。Query Profile の次のメトリクスで、高速化の効果を確認できます。
| メトリクス | 意味 |
|---|---|
RowsKeyRangeFiltered | プレフィックスインデックスによって除外された行数です。他の Rows* メトリクスと比較すると、インデックスのフィルタリング効果を評価できます。 |
プレフィックスインデックスに一致しない場合の代替手段
頻繁に使うクエリ条件がプレフィックスインデックスに一致しない場合(たとえば、よく使うフィルタカラムがソートキーのプレフィックスではない場合)は、次の二つの方法を検討してください。
- 転置インデックスを作成する:一つのテーブルに複数の転置インデックスを作成でき、さまざまなクエリ条件で使うカラムを柔軟に対象にできます。
- 単一テーブルのマテリアライズドビュー(Duplicate モデル)を使用する:カラム順序を変えた、強い整合性を持つ単一テーブルの同期マテリアライズドビューを作成すると、複数組のプレフィックスインデックスを間接的に実現できます。
よくある質問
Q1:プレフィックスインデックスを手動で作成する必要はありますか?
ありません。テーブル作成時に、Doris がソートキーの先頭 36 バイトをプレフィックスインデックスとして自動的に使用します。専用の DDL 構文はありません。
Q2:一つのテーブルにプレフィックスインデックスを複数組持たせることはできますか?
できません。ソートキーは一つだけなので、テーブルが持てるプレフィックスインデックスの組も一つだけです。複数組が必要な場合は、転置インデックスまたはマテリアライズドビューを使用してください。
Q3:プレフィックスインデックスが予想よりかなり短いのはなぜですか?
よくある原因は、ソートキーの先頭付近に VARCHAR カラムがあり、切り詰め規則が適用されていることです。固定長の型(BIGINT、INT、DATETIME、TIMESTAMP_NS など)をソートキーの先頭付近に配置してください。
Q4:プレフィックスインデックスで LIKE クエリやテキスト検索を高速化できますか?
できません。LIKE によるあいまい検索と全文検索には、それぞれ NGram BloomFilter インデックスと転置インデックスを使用してください。