HNSW
HNSW(Hierarchical Navigable Small World、Malkov と Yashunin、2016 年)は、本番環境で比較的少ないリソースでも高い再現率と低いレイテンシを実現できるため、オンラインの高性能ベクトル検索で事実上の標準となっています。Apache Doris はバージョン 4.0 から HNSW ベースの ANN(Approximate Nearest Neighbor、近似最近傍)インデックスをサポートしています。この記事では、アルゴリズムの原理に加え、パラメータと運用上の実践を踏まえて、Apache Doris の本番クラスターで HNSW インデックスを使用・調整する方法を説明します。
クイックナビゲーション
- HNSW を初めて学ぶ場合は、HNSW 以前と階層型 Navigable Small Worldから読み、アルゴリズムの発展を確認してください。
- すぐに試したい場合は、Apache Doris での HNSWでテーブル作成、インデックス構築、クエリの例を参照してください。
- 検索精度を確認したい場合は、再現率の最適化とベンチマークを参照してください。
- リソース消費を確認したい場合は、メモリ使用量と性能を参照してください。
HNSW 以前
HNSW アルゴリズムは、論文 Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs で提案されました。HNSW 以前にも近似 KNN 探索のアルゴリズムは多数ありましたが、それぞれに課題がありました。
近傍グラフ
近傍グラフアルゴリズムの基本的な流れは次のとおりです。
- グラフ内の入口点(ランダムに選んだ頂点、または特定の戦略で選んだ頂点)から開始し、グラフを反復的にたどります。
- 各ステップで、クエリベクトルと現在の基点ノードの全隣接ノードとの距離を計算し、最も近い隣接ノードを次の基点ノードに選びます。
- それまでに見つかった最良の近傍候補の集合を保持します。
- 停止条件を満たしたら(たとえば、一度の反復でより近いノードが見つからなかった場合)、候補集合の上位 K 件を最終結果として返します。
近傍グラフアルゴリズムは、本質的にはドロネーグラフの近似です。ドロネーグラフには、貪欲探索で必ず最近傍を見つけられるという重要な性質があります。
ただし、この種のアルゴリズムには明確な欠点が二つあります。
| 欠点 | 影響 |
|---|---|
| クエリの探索経路をたどる段階での反復回数が、データ量に対して多項式的に増加する | 大規模なデータではクエリのコストが急増する |
| 高品質な近傍グラフの構築は難しく、局所的なクラスタリングが起こりやすい | グラフ全体の接続性が不足し、一部のノードに到達しにくくなる |
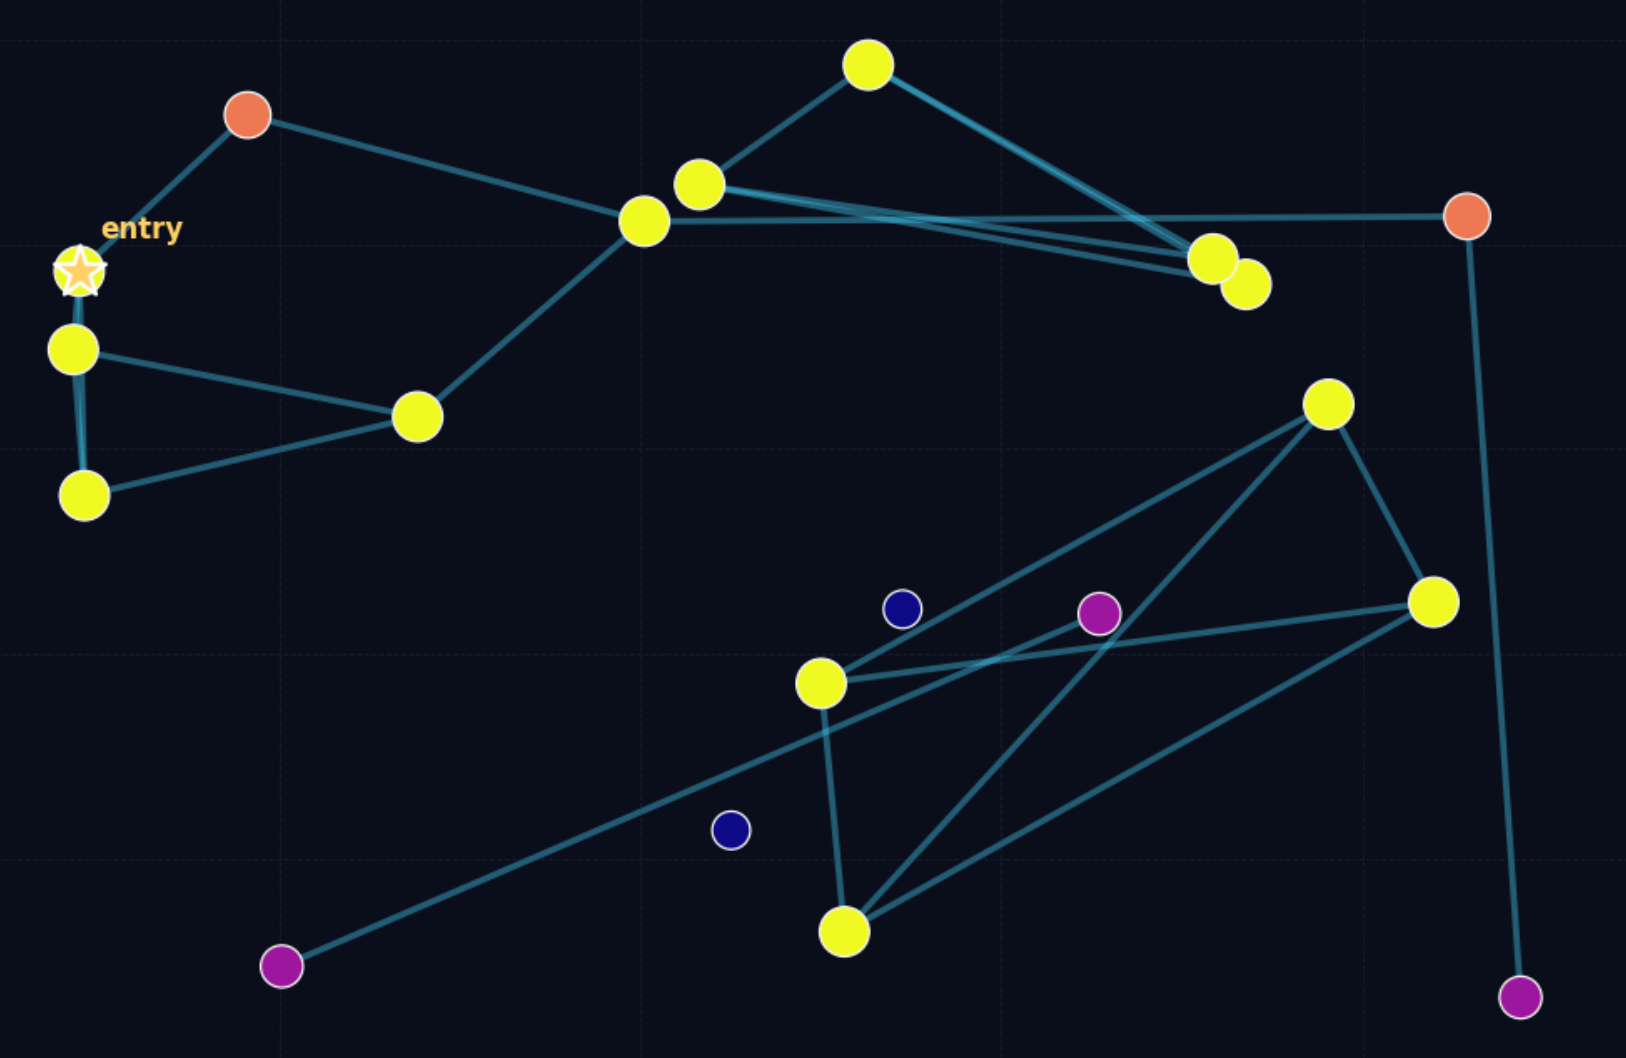
上の図は、品質の低い近傍グラフを示しています。点の色が濃いほど接続性が低くなります。近傍ノードをほとんど見つけられない点もあり、探索時にその点へ到達することが難しくなります。
探索可能なスモールワールド(Navigable Small World)
これらの問題を解決するため、次の二つの方法が考えられました。
- ハイブリッドアルゴリズム:隣接グラフの探索前に粗いランキングで適切な入口点を見つけ、その後に貪欲探索を行います。
- Navigable Small World 構造:良好な接続性を確保しつつ、ノードごとの最大隣接数に上限を設けて、探索の計算量を抑えます。
NSW(Navigable Small World)は、二番目の方法を採用します。
NSW モデルは、J. Kleinberg によって、社会における人々のつながりを調べる社会実験で初めて提案されました。これは、よく知られる六次の隔たりの考え方です。
特に K-NN グラフアルゴリズムでは、探索時の計算量が対数または多重対数となるスモールワールドネットワークを Navigable Small World Network と呼びます。実装は多数ありますが、ここでは扱いません。
NSW は当時、一部のデータセットで最高水準の探索性能を示しました。ただし、計算量が厳密には対数的でないため、低次元ベクトル空間などのテストセットでは性能が低下します。
階層型 Navigable Small World
NSW アルゴリズムの探索には、次の二つの段階があります。
| 段階 | 動作 |
|---|---|
| zoom-out | 次数の低い頂点を入口点としてランダムに選びます。探索中は、あるノードからその隣接ノードまでの平均距離が、そのノードからクエリベクトルまでの距離を上回るまで、次数の高いノードを優先します。 |
| zoom-in | 適切な次数の高いノードを見つけた後、最良の上位 N 件が見つかるまで貪欲探索を行います。 |
NSW の計算量は多重対数的です。距離計算の総回数は、おおむね「ホップ数 × 通過する頂点の平均次数」に比例します。平均ホップ数と平均次数はいずれもデータ規模に対して対数的に増えるため、全体の計算量は多重対数的になります。
HNSW は zoom-out の処理を高速化することで、クエリの時間計算量を対数的に抑えます。
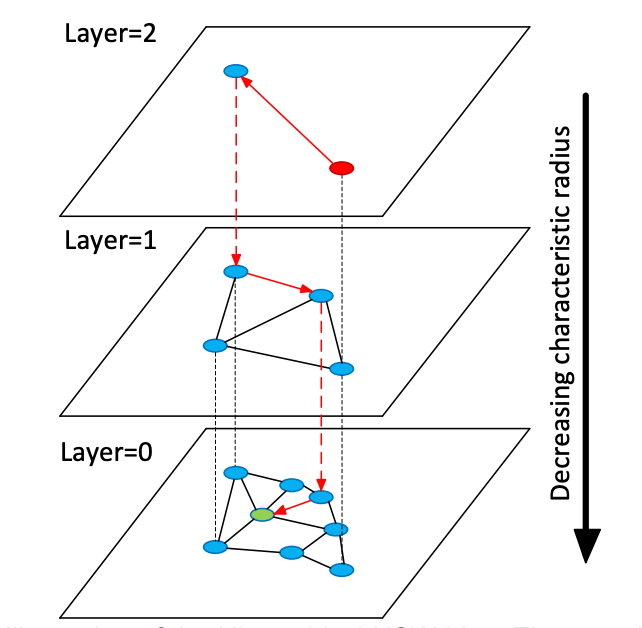
HNSW における「階層」とは、NSW グラフの頂点を辺の特徴的な半径に応じて層に分けることです。探索は次の手順で行います。
- 最上位層の入口点から探索を始めます。
- 現在の層で貪欲探索を行い、その層で最も近い点を見つけます。
- 一つ下の層に移動し、貪欲探索を繰り返します。
- 最下層に到達するまで続け、最終結果を得ます。
各層でノードあたりの接続数に上限を設けるため、全体として対数的な時間計算量が保たれます。
階層を構築する際、HNSW はノードを挿入するたびに幾何分布に従ってその層 l を決め、全体の層数が増えすぎないようにします。インデックス作成時のランダムな層の割り当て自体がデータをランダム化するため、取り込み前のシャッフルは不要です(NSW ではシャッフルしないとグラフの品質が低下するため必須です)。この仕組みにより、HNSW は真の増分更新にも対応します。
Apache Doris での HNSW
Doris はバージョン 4.0 から、HNSW アルゴリズムに基づく ANN インデックスの構築をサポートしています。
インデックスの構築
ANN インデックスを作成する方法は二つあります。
| 方法 | 構築のタイミング | 利点 | 欠点 |
|---|---|---|---|
| テーブル作成時に指定 | データ取り込み中、セグメントの作成時に同期的に構築 | 取り込み完了直後からクエリを高速化できる | 同期構築によって取り込みが遅くなり、コンパクションのたびにインデックスが再構築される |
CREATE/BUILD INDEX | データ取り込み後に非同期で構築 | 取り込み速度に影響せず、パラメータを調整しやすい | インデックスの構築中は ANN による高速化を利用できない |
方法 1:テーブル作成時にインデックスを指定
インデックスのパラメータが決まっており、頻繁な調整が不要な安定した運用に適しています。
CREATE TABLE sift_1M (
    id int NOT NULL,
    embedding array<float>  NOT NULL  COMMENT "",
    INDEX ann_index (embedding) USING ANN PROPERTIES(
        "index_type"="hnsw",
        "metric_type"="l2_distance",
        "dim"="128"
    )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
    "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
    "format" = "csv");
方法 2:CREATE / BUILD INDEX
柔軟な調整が必要で、取り込み性能を重視する場合に適しています。
手順 1:インデックスなしでテーブルを作成し、データを取り込みます。
CREATE TABLE sift_1M (
    id int NOT NULL,
    embedding array<float>  NOT NULL  COMMENT ""
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
    "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
    "format" = "csv");
手順 2:CREATE INDEX でインデックス定義を追加します。この時点では定義のみが存在し、既存データのインデックスはまだ構築されていません。
CREATE INDEX idx_test_ann ON sift_1M (`embedding`) USING ANN PROPERTIES (
    "index_type"="hnsw",
    "metric_type"="l2_distance",
    "dim"="128"
);

SHOW DATA ALL FROM sift_1M;
出力例:
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 1            | 1000000  | 170.001 MB     | 170.001 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
|           | Total     | 1            |          | 170.001 MB     | 170.001 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
2 rows in set (0.01 sec)
手順 3:BUILD INDEX で実際の構築を開始します。
BUILD INDEX idx_test_ann ON sift_1M;
BUILD INDEX は非同期で実行されます。SHOW BUILD INDEX でタスクの状態を確認できます。
SHOW BUILD INDEX WHERE TableName = "sift_1M";
出力例:
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| JobId         | TableName | PartitionName | AlterInvertedIndexes                                                                                                               | CreateTime              | FinishTime              | TransactionId | State    | Msg  | Progress |
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| 1763603913428 | sift_1M   | sift_1M       | [ADD INDEX idx_test_ann (`embedding`) USING ANN PROPERTIES("dim" = "128", "index_type" = "hnsw", "metric_type" = "l2_distance")],  | 2025-11-20 11:14:55.253 | 2025-11-20 11:15:10.622 | 126128        | FINISHED |      | NULL     |
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
インデックスの削除(DROP INDEX)
調整中に複数のパラメータの組み合わせを試す場合は、DROP INDEX を使用してインデックスを管理します。
ALTER TABLE sift_1M DROP INDEX idx_test_ann;
クエリの実行
ANN インデックスは、TopN 探索と範囲探索の両方を高速化できます。
ベクトル列の次元数が高い場合、クエリベクトルを表す文字列自体の解析にも追加のコストがかかります。本番環境、特に同時実行数が多い環境では、生の SQL を直接使ってベクトル検索を実行しないでください。代わりにプリペアドステートメントを使い、SQL を事前に解析してください。
Doris はベクトル検索用の Python ライブラリを公式に提供しています。このライブラリは、プリペアドステートメントに必要な操作をまとめ、クエリ結果を直接 pandas DataFrame に変換する処理も備えています。Doris を使った AI アプリケーションの開発に利用できます。
from doris_vector_search import DorisVectorClient, AuthOptions

auth = AuthOptions(
    host="localhost",
    query_port=9030,
    user="root",
    password="",
)

client = DorisVectorClient(database="demo", auth_options=auth)

tbl = client.open_table("sift_1M")

query = [0.1] * 128  # Example 128-dimensional vector

# SELECT id FROM sift_1M ORDER BY l2_distance_approximate(embedding, query) LIMIT 10;
result = tbl.search(query, metric_type="l2_distance").limit(10).select(["id"]).to_pandas()

print(result)
実行結果の例:
       id
0  123911
1   11743
2  108584
3  123739
4   73311
5  124746
6  620941
7  124493
8  177392
9  153178
再現率の最適化
ベクトル検索で最も重要な指標は再現率です。一定の再現率を満たして初めて、性能値に意味が生まれます。再現率に主に影響する要因は次のとおりです。
- HNSW のインデックス作成時のパラメータ(
max_degree、ef_construction)とクエリ時のパラメータ(ef_search) - インデックスのベクトル量子化
- セグメントのサイズと数
この節では 1 と 3 を説明します。ベクトル量子化については別の記事で扱います。
インデックスのハイパーパラメータ
HNSW インデックスは、ベクトルを階層グラフとして構成します。構築段階は主に次の三つのステップからなります。
- 複数層へのランダムな割り当て:各ベクトルをランダムに複数の層へ割り当てます。上位の層ほど疎で、高速な探索経路の決定に使われます。
ef_constructionによる隣接候補の探索:各層で、最大長がef_constructionの候補キューを使い、幅優先の局所探索を行います。値を大きくすると、より適切な隣接ノードを見つけてグラフの品質を高められますが、構築時間は長くなります。max_degreeによる接続数の制限:ノードごとの隣接ノード数をmax_degreeで制限し、グラフが密になりすぎるのを防ぎます。
クエリ段階は次の二つのステップからなります。
- 上位層での貪欲探索(粗い探索):入口点から上位層を上から下へ貪欲に探索し、対象領域へ素早く近づきます。
- 最下層での幅優先探索(詳細な探索):層 0 で、最大長が
ef_searchの候補キューを使い、近傍をより徹底的に探索します。
三つの主要パラメータの役割とトレードオフは次のとおりです。
| パラメータ | 役割 | デフォルト値 | 値を大きくした場合の影響 |
|---|---|---|---|
max_degree | グラフ内の各ノードに保存する双方向エッジの数 | 32 | 再現率とメモリ使用量が増加し、クエリ性能が低下する |
ef_construction | インデックス作成時の候補キューの最大長 | 40 | グラフの品質と再現率が向上し、構築時間が長くなる |
ef_search | クエリ時の候補キューの最大長 | 32 | 再現率が向上する一方、距離計算の回数、クエリのレイテンシ、CPU コストが増加する |
次の表は、SIFT_1M データセットで測定した結果です。
| max_degree | ef_construction | ef_search | recall@1 | recall@100 |
|---|---|---|---|---|
| 32 | 80 | 32 | 0.955 | 0.75335 |
| 32 | 80 | 64 | 0.98 | 0.88015 |
| 32 | 80 | 96 | 0.995 | 0.9328 |
| 32 | 120 | 32 | 0.96 | 0.7736 |
| 32 | 120 | 64 | 0.975 | 0.89865 |
| 32 | 120 | 96 | 0.99 | 0.94575 |
| 32 | 160 | 32 | 0.955 | 0.78745 |
| 32 | 160 | 64 | 0.98 | 0.9097 |
| 32 | 160 | 96 | 0.995 | 0.95485 |
| 48 | 80 | 32 | 0.985 | 0.85895 |
| 48 | 80 | 64 | 0.99 | 0.9453 |
| 48 | 80 | 96 | 1 | 0.97325 |
| 48 | 120 | 32 | 0.97 | 0.78335 |
| 48 | 120 | 64 | 1 | 0.9089 |
| 48 | 120 | 96 | 1 | 0.95325 |
| 48 | 160 | 32 | 0.975 | 0.79745 |
| 48 | 160 | 64 | 0.995 | 0.9192 |
| 48 | 160 | 96 | 0.995 | 0.9601 |
| 64 | 80 | 32 | 1 | 0.9026 |
| 64 | 80 | 64 | 1 | 0.97025 |
| 64 | 80 | 96 | 1 | 0.9862 |
| 64 | 120 | 32 | 0.985 | 0.8548 |
| 64 | 120 | 64 | 0.99 | 0.94755 |
| 64 | 120 | 96 | 0.995 | 0.97645 |
| 64 | 160 | 32 | 0.97 | 0.80585 |
| 64 | 160 | 64 | 0.99 | 0.91925 |
| 64 | 160 | 96 | 0.995 | 0.96165 |
表から、複数のパラメータの組み合わせで同程度の再現率に到達できることが分かります。たとえば recall@100 > 95% を目標とする場合、条件を満たす組み合わせには次のものがあります。
| max_degree | ef_construction | ef_search | recall@1 | recall@100 |
|---|---|---|---|---|
| 32 | 160 | 96 | 0.995 | 0.95485 |
| 48 | 80 | 96 | 1 | 0.97325 |
| 48 | 120 | 96 | 1 | 0.95325 |
| 48 | 160 | 96 | 0.995 | 0.9601 |
| 64 | 80 | 64 | 1 | 0.97025 |
| 64 | 80 | 96 | 1 | 0.9862 |
| 64 | 120 | 96 | 0.995 | 0.97645 |
| 64 | 160 | 96 | 0.995 | 0.96165 |
ハイパーパラメータを選ぶ実践的な方法:
- 複数のベクトル列(2~3 列)を持つ、インデックスなしのテーブル
table_multi_indexを作成します。 - Stream Load などの方法で、このテーブルにデータを取り込みます。
CREATE INDEXとBUILD INDEXを使い、列ごとに異なるパラメータの組み合わせで、すべてのベクトル列にインデックスを構築します。- 構築後に各列の再現率を個別に計算し、最も適したハイパーパラメータの組み合わせを選びます。
インデックスが対象とする行数
Doris の内部テーブルのデータは、次の階層で構成されます。
| 階層 | 意味 |
|---|---|
| Table | 最上位の概念 |
| Tablet | データ移行と再バランスの基本単位。テーブルデータはバケットキーに従って N 個の tablet に均等に分散される |
| Rowset | バージョン管理の基本単位。取り込みやコンパクションのたびに、tablet の下に新しい rowset が追加される |
| Segment | データを保存する実際のファイル |
転置インデックスと同様に、ベクトルインデックスもセグメント単位で動作します。セグメントサイズは、BE の設定 write_buffer_size と vertical_compaction_max_segment_size によって決まります。取り込みやコンパクション中に memtable が一定のサイズに達すると、セグメントファイルへフラッシュされ、そのセグメントに対してベクトルインデックスが構築されます(インデックス列ごとに一つ)。
HNSW の探索・構築の仕組み上、一定のインデックスパラメータで有効に扱えるデータの範囲には限りがあります。データ量がしきい値を超えると、必要な再現率を満たせなくなります。
次の表は、いくつかのハイパーパラメータについて、セグメントごとに扱える行数を示す経験的な値です。
| max_degree | ef_construction | ef_search | num_segment | recall@100 |
|---|---|---|---|---|
| 32 | 160 | 96 | 1M | 0.95485 |
| 48 | 80 | 96 | 1M | 0.97325 |
| 32 | 160 | 32 | 3M | 0.66983 |
| 128 | 512 | 128 | 3M | 0.9931 |
SHOW TABLETS FROM <table>を実行してテーブルのコンパクション状態を確認します。対応する URL をクリックすると、セグメント数を確認できます。
コンパクションが再現率に与える影響
コンパクションによってセグメントが大きくなると、元のインデックスのハイパーパラメータでは新しい大きなセグメントを十分に扱えなくなる場合があります。
ベストプラクティス:FULL COMPACTION を実行してから BUILD INDEX を実行します。完全にコンパクションされたセグメントにインデックスを構築すると、次の二つの利点があります。
- 安定した再現率
- インデックス構築による書き込み増幅の軽減
クエリ性能
インデックスファイルのコールドロード
Doris の ANN インデックスは、Meta のオープンソースの faiss を基に実装されています。HNSW インデックスでクエリを高速化するには、グラフ構造全体をメモリにロードしておく必要があります。
高い同時実行数でクエリを実行する前に、まずコールドクエリを一度実行し、対象セグメントのインデックスファイルをメモリに読み込んでください。読み込まれていない場合、クエリ性能が大幅に低下します。
メモリ使用量と性能
HNSW インデックス(量子化による圧縮なし)は、対象ベクトルの約 1.3 倍のメモリを使用します。
たとえば、128 次元で 1M 件のデータセットでは、HNSW FLAT インデックスに約 128 x 4 x 1,000,000 x 1.3 ~= 650 MB が必要です。
規模ごとのメモリ使用量の推定値は次のとおりです。
| dim | rows | 推定メモリ使用量 |
|---|---|---|
| 128 | 1M | 650 MB |
| 768 | 10M | 48 GB |
| 768 | 100M | 110 GB |
クエリ性能を確保するには、BE ノードに十分なメモリを割り当てる必要があります。不足すると、頻繁なインデックス I/O によってクエリ性能が大幅に低下します。
ベンチマーク
テスト環境:16C・64GB のマシン。テストフレームワーク:VectorDBBench。負荷生成クライアント:別の 16C マシン。
Doris の本番クラスターでは、FE と BE を別々に配置する構成が一般的です(16C・64GB のマシンが二台必要です)。次の表には、この構成に加えて、FE と BE を同じマシンに配置した場合のテスト結果も示します。
Performance768D1M
テストコマンド:
NUM_PER_BATCH=1000000 python3.11 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --search-concurrent --search-serial --num-concurrency 10,40,80 --stream-load-rows-per-batch 500000 --index-prop max_degree=128,ef_construction=512 --session-var hnsw_ef_search=128
テスト結果の比較:
| Doris(FE/BE を別々に配置) | Doris(FE/BE を同じマシンに配置) | |
|---|---|---|
| インデックス設定 | max_degree=128, ef_construction=512, hnsw_ef_search=128 | max_degree=128, ef_construction=512, hnsw_ef_search=156 |
| Recall@100 | 0.9931 | 0.9929 |
| 同時実行数(クライアント) | 10, 40, 80 | 10, 40, 80 |
| 結果 QPS | 163.1567 (10) 606.6832 (40) 859.3842 (80) | 162.3002 (10) 542.3488 (40) 607.7951 (80) |
| 平均レイテンシ(秒) | 0.06123 (10) 0.06579 (40) 0.09281 (80) | 0.06154 (10) 0.07351 (40) 0.13093 (80) |
| P95 レイテンシ(秒) | 0.06560 (10) 0.07747 (40) 0.12967 (80) | 0.06726 (10) 0.08789 (40) 0.18719 (80) |
| P99 レイテンシ(秒) | 0.06889 (10) 0.08618 (40) 0.14605 (80) | 0.06154 (10) 0.07351 (40) 0.13093 (80) |