Resource Group: BE 노드의 물리적 격리 및 리소스 그룹 관리
Resource Group은 스토리지와 컴퓨팅이 통합된 아키텍처에서 서로 다른 워크로드를 물리적으로 격리하는 메커니즘입니다. BE 노드에 태그를 지정하여 클러스터 노드를 여러 리소스 그룹으로 나누고, 테이블 복제본을 리소스 그룹에 분산합니다. 이를 통해 각 사용자나 업무 부문이 서로 영향을 주지 않으면서 전용 컴퓨팅 및 스토리지 리소스에 접근할 수 있습니다.
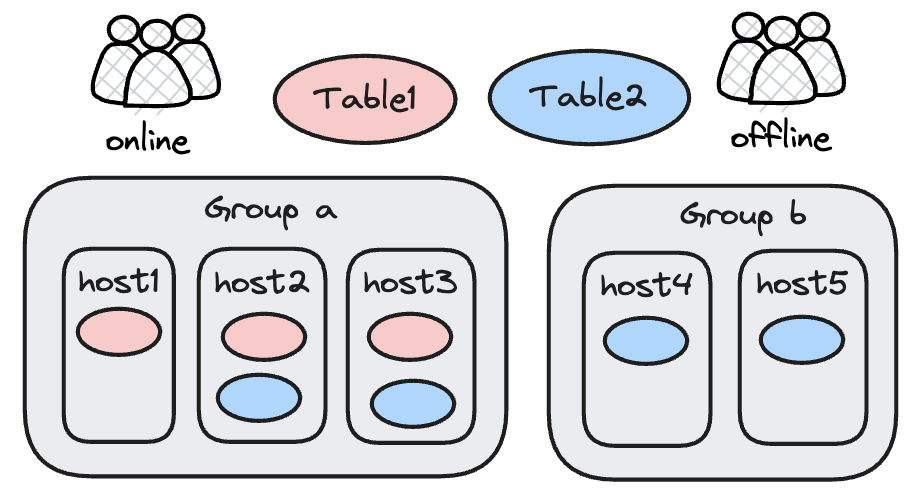
작동 방식
Resource Group의 본질은 테이블 복제본 배치 정책입니다. 핵심 메커니즘은 다음과 같습니다.
- 태그를 사용하여 BE 노드를 여러 그룹으로 나누고, 각 그룹을 태그 이름(예:
group_a,group_b)으로 식별합니다. - 테이블의 복제본을 서로 다른 리소스 그룹에 배치합니다. 예를 들어 table1의 복제본 3개는 모두 group_a에 배치하고, table2의 복제본 4개 중 2개는 group_a에, 나머지 2개는 group_b에 배치합니다.
- 쿼리 실행 시 사용자에게 바인딩된 리소스 그룹에 따라 접근 범위가 제한됩니다. 사용자는 해당 그룹에 속한 노드의 복제본과 컴퓨팅 리소스에만 접근할 수 있습니다.
장점과 제약 사항:
| 항목 | 설명 |
|---|---|
| 장애 격리 | 리소스 그룹마다 독립적인 BE를 사용합니다. 한 그룹의 BE에 장애가 발생해도 다른 그룹의 쿼리에는 영향을 주지 않습니다 |
| 데이터 적재 제약 사항 | 데이터를 적재하려면 여러 복제본에 쓰기가 성공해야 합니다. 남아 있는 복제본이 Quorum 요구 사항을 충족하지 못하면 데이터 적재는 여전히 실패합니다 |
| 스토리지 오버헤드 | 각 리소스 그룹에는 테이블 복제본이 하나 이상 필요합니다. 리소스 그룹이 많을수록 저장되는 복제본도 많아집니다 |
주요 사용 사례
| 시나리오 | 설명 |
|---|---|
| 읽기/쓰기 격리 | 클러스터를 온라인과 오프라인이라는 두 리소스 그룹으로 나눕니다. 온라인 그룹은 동시성이 높고 지연 시간이 짧은 쿼리를 처리하고, 오프라인 그룹은 ETL 작업을 처리합니다. 데이터는 3개의 복제본으로 저장하며, 온라인 그룹에 2개, 오프라인 그룹에 1개를 배치합니다 |
| 업무별 격리 | 여러 업무 부문이 서로 데이터를 공유하지 않습니다. 각 업무 부문에 독립적인 리소스 그룹을 할당합니다. 이는 여러 물리적 클러스터를 하나의 대규모 클러스터로 통합하여 일괄 관리하는 것과 같습니다 |
| 사용자별 격리 | 여러 사용자가 동일한 업무 테이블을 공유하되, 리소스 경합을 방지하기 위해 독립적인 리소스 그룹을 할당받습니다. 테이블 복제본을 여러 개 생성하여 각각 해당 리소스 그룹에 배치하고, 각 사용자를 자신의 리소스 그룹에 바인딩합니다 |
Resource Group 구성
사전 요구 사항
- 스토리지와 컴퓨팅이 통합된 모드로 배포되었으며 여러 BE 노드가 있는 Doris 클러스터.
ALTER SYSTEM권한(일반적으로 admin 사용자가 보유).
절차 개요
- BE 노드에 태그를 설정하여 리소스 그룹으로 나눕니다.
- 테이블을 생성하거나 변경할 때 리소스 그룹 간 복제본 분산 정책을 지정합니다.
- 사용자를 리소스 그룹에 바인딩하여 쿼리 범위를 제한합니다.
1단계: BE 노드에 태그 설정
현재 클러스터에 BE 노드 6개(host1부터 host6까지)가 있다고 가정합니다. 초기 상태에서는 모든 노드가 기본 리소스 그룹(Default)에 속합니다.
노드 6개를 리소스 그룹 3개로 나눕니다.
alter system modify backend "host1:9050" set ("tag.location" = "group_a");
alter system modify backend "host2:9050" set ("tag.location" = "group_a");
alter system modify backend "host3:9050" set ("tag.location" = "group_b");
alter system modify backend "host4:9050" set ("tag.location" = "group_b");
alter system modify backend "host5:9050" set ("tag.location" = "group_c");
alter system modify backend "host6:9050" set ("tag.location" = "group_c");
실행 후 host[1-2]는 group_a에, host[3-4]는 group_b에, host[5-6]는 group_c에 속합니다.
참고: BE는 하나의 리소스 그룹에만 속할 수 있습니다.
2단계: 리소스 그룹별 복제본 분산
리소스 그룹을 정의한 후에는 테이블을 생성할 때 replication_allocation 속성을 설정하여 각 리소스 그룹에 저장할 복제본 수를 지정합니다.
예시: UserTable의 복제본 3개를 서로 다른 리소스 그룹 3개에 배치합니다.
create table UserTable
(k1 int, k2 int)
distributed by hash(k1) buckets 1
properties(
    "replication_allocation"="tag.location.group_a:1, tag.location.group_b:1, tag.location.group_c:1"
)
실행 후 UserTable의 데이터는 3개의 복제본으로 group_a, group_b, group_c의 노드에 각각 저장됩니다.
현재 노드의 그룹 구성과 데이터 분산 상태는 다음과 같습니다.
┌────────────────────────────────────────────────────┐
│                                                    │
│         ┌──────────────────┐  ┌──────────────────┐ │
│         │ host1            │  │ host2            │ │
│         │  ┌─────────────┐ │  │                  │ │
│ group_a │  │   replica1  │ │  │                  │ │
│         │  └─────────────┘ │  │                  │ │
│         │                  │  │                  │ │
│         └──────────────────┘  └──────────────────┘ │
│                                                    │
├────────────────────────────────────────────────────┤
├────────────────────────────────────────────────────┤
│                                                    │
│         ┌──────────────────┐  ┌──────────────────┐ │
│         │ host3            │  │ host4            │ │
│         │                  │  │  ┌─────────────┐ │ │
│ group_b │                  │  │  │   replica2  │ │ │
│         │                  │  │  └─────────────┘ │ │
│         │                  │  │                  │ │
│         └──────────────────┘  └──────────────────┘ │
│                                                    │
├────────────────────────────────────────────────────┤
├────────────────────────────────────────────────────┤
│                                                    │
│         ┌──────────────────┐  ┌──────────────────┐ │
│         │ host5            │  │ host6            │ │
│         │                  │  │  ┌─────────────┐ │ │
│ group_c │                  │  │  │   replica3  │ │ │
│         │                  │  │  └─────────────┘ │ │
│         │                  │  │                  │ │
│         └──────────────────┘  └──────────────────┘ │
│                                                    │
└────────────────────────────────────────────────────┘
데이터베이스 수준에서 공통 복제본 정책 설정
데이터베이스에 테이블이 많으면 테이블마다 복제본 정책을 수정하기가 번거롭습니다. Doris는 데이터베이스 수준에서 공통 복제본 분산 정책을 설정할 수 있도록 지원합니다. 테이블 수준 설정은 데이터베이스 수준 설정보다 우선합니다.
예를 들어 db1에 테이블이 4개 있고, table1에는 전용 복제본 정책이 필요하며 나머지 테이블 3개는 데이터베이스의 기본 정책을 사용한다고 가정합니다.
db1을 생성할 때 기본 복제본 정책을 group_c:1, group_b:2로 지정합니다.
CREATE DATABASE db1 PROPERTIES (
    "replication_allocation" = "tag.location.group_c:1, tag.location.group_b:2"
)
table1을 생성하고 정책을 group_a:1, group_b:2로 재정의합니다.
CREATE TABLE table1
(k1 int, k2 int)
distributed by hash(k1) buckets 1
properties(
    "replication_allocation"="tag.location.group_a:1, tag.location.group_b:2"
)
table2, table3, table4의 CREATE TABLE 문에서는 replication_allocation을 지정할 필요가 없으며, db1의 정책을 자동으로 상속합니다.
데이터베이스의 복제본 분산 정책을 변경해도 기존 테이블에는 영향을 주지 않습니다.
3단계: 사용자를 리소스 그룹에 바인딩
set property 문을 사용하여 사용자가 지정된 리소스 그룹에 속한 노드에서만 쿼리를 실행하도록 제한합니다.
set property for 'user1' 'resource_tags.location' = 'group_a';
set property for 'user2' 'resource_tags.location' = 'group_b';
set property for 'user3' 'resource_tags.location' = 'group_a, group_b, group_c';
이렇게 설정하면 user1이 UserTable을 쿼리할 때 group_a에 속한 노드의 복제본에만 접근하고, group_a의 컴퓨팅 리소스만 사용합니다. user3은 어느 리소스 그룹의 복제본과 컴퓨팅 리소스든 사용할 수 있습니다.
버전별 차이:
| 버전 | 기본 동작 |
|---|---|
| 2.0.2 이하 | 사용자의 resource_tags.location이 비어 있으면 태그 제한을 받지 않으며 모든 리소스 그룹을 사용할 수 있습니다 |
| 2.0.3 이상 | 일반 사용자는 기본적으로 default 리소스 그룹만 사용할 수 있습니다. root 및 admin 사용자는 모든 리소스 그룹을 사용할 수 있습니다 |
resource_tags.location 속성을 수정한 후에는 사용자가 다시 연결해야 변경 사항이 적용됩니다.
데이터 적재 작업의 리소스 그룹 할당
데이터 적재 작업(INSERT, Broker Load, Routine Load, Stream Load 등)의 리소스 사용은 두 부분으로 나뉩니다.
| 리소스 유형 | 역할 | 리소스 그룹 제한 여부 |
|---|---|---|
| 컴퓨팅 리소스 | 데이터 소스 읽기, 데이터 변환 및 분산 | 예. Resource Group은 컴퓨팅 리소스의 사용 범위를 제한합니다 |
| 쓰기 리소스 | 데이터 인코딩, 압축 및 디스크 쓰기 | 아니요. 쓰기 리소스는 복제본이 있는 노드에 따라 결정되며 제한할 수 없습니다 |
쓰기 리소스는 데이터 복제본이 있는 노드에서 실행되어야 하지만, 컴퓨팅 리소스는 어느 노드에서든 선택할 수 있습니다. 따라서 Resource Group은 데이터 적재 작업 중 컴퓨팅 부분만 제한할 수 있습니다.