Arrow Flight SQL 기반 고속 데이터 전송 링크
이 문서에서 설명하는 Arrow Flight SQL 고속 데이터 전송 기능은 현재 실험적 기능입니다. 프로덕션 환경에서는 사용을 권장하지 않습니다. 사용 중 문제가 발생하면 메일링 리스트 또는 GitHub Issue를 통해 알려 주세요.
Doris 2.1부터 Arrow Flight SQL 프로토콜 기반의 고속 데이터 전송 링크가 구현되어, 여러 언어에서 SQL을 사용해 Doris의 대량 데이터를 고속으로 읽을 수 있습니다. MySQL Client 또는 JDBC/ODBC 드라이버를 사용하는 방식과 비교하면 일부 시나리오에서 성능이 수십 배에서 수백 배 향상됩니다. Arrow Flight SQL은 동일한 프로토콜을 따르는 데이터베이스와 원활하게 상호 작용할 수 있는 범용 JDBC 드라이버도 제공합니다.
적용 시나리오
- 분석을 위해 Doris에서 대규모 데이터를 일괄 내보내는 경우(MySQL/JDBC 프로토콜 대비 수십 배에서 수백 배의 성능 향상).
- 후속 데이터 분석에서 Apache Arrow 또는 Pandas와 같은 열 형식을 사용하며, 행 형식에서 열 형식으로 변환하는 오버헤드를 피해야 하는 경우.
- DBeaver와 같은 BI 도구에서 Arrow Flight SQL 프로토콜을 통해 Doris에 접근하는 경우.
- Spark 및 Flink와 같은 빅데이터 컴포넌트에서 Arrow 형식으로 Doris 데이터를 고속으로 읽는 경우.
구현 원리
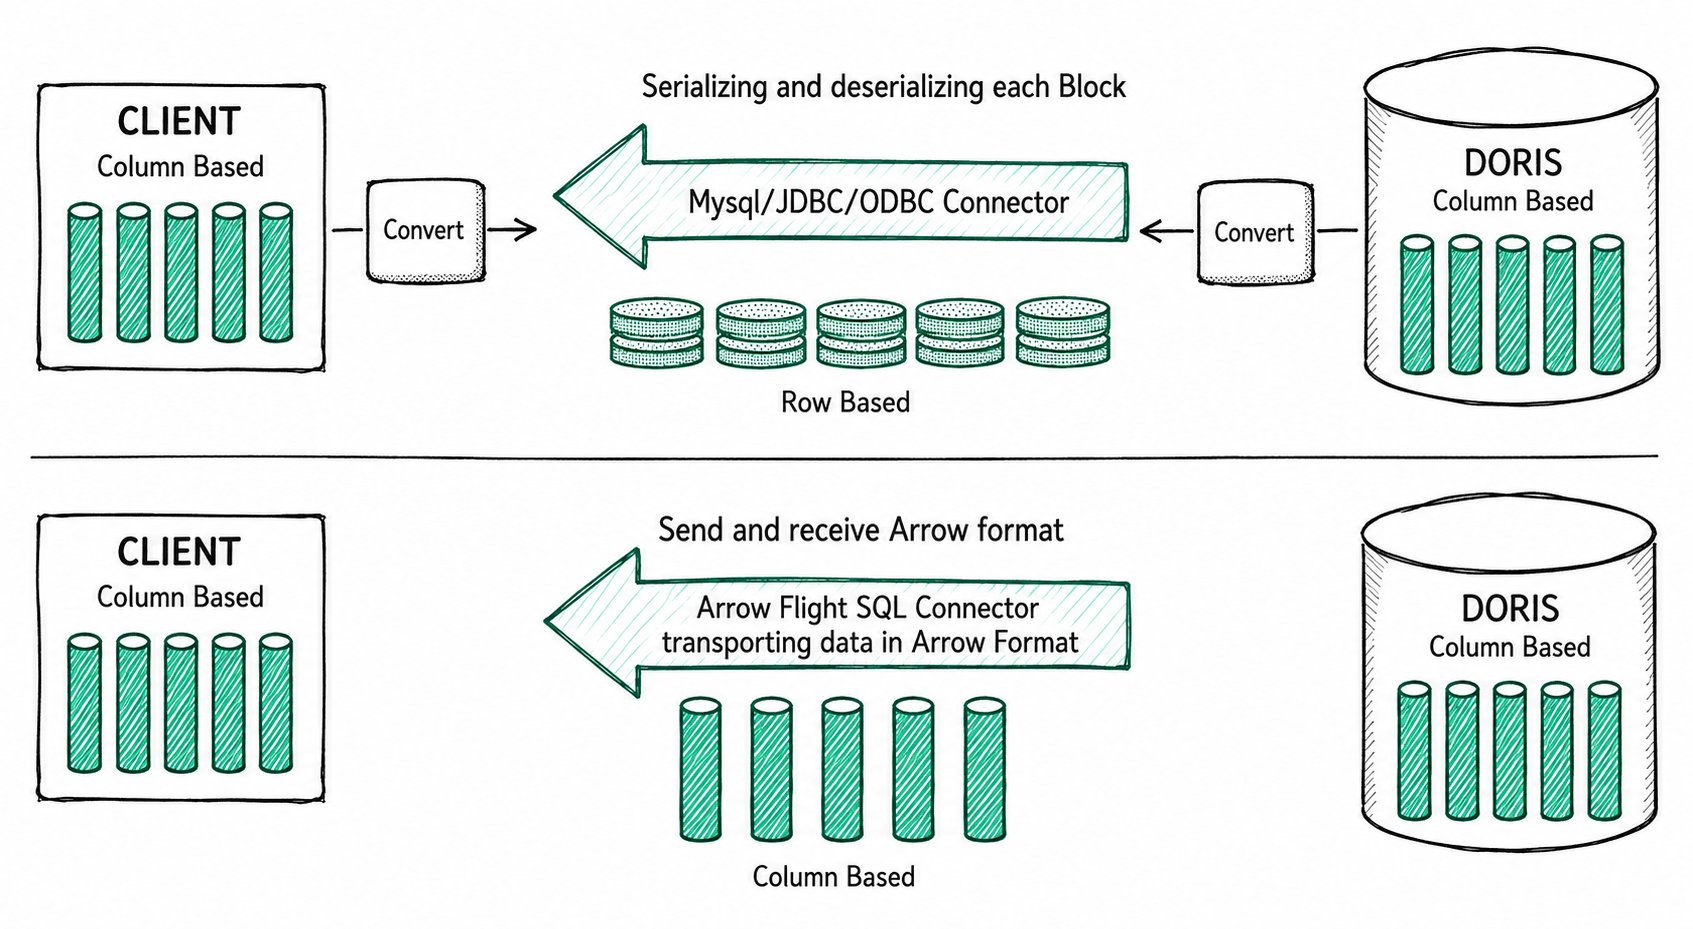
Doris에서 쿼리 결과는 열 형식의 Blocks로 구성됩니다. 2.1 이전 버전에서는 MySQL Client 또는 JDBC/ODBC 드라이버를 통해 쿼리 결과를 클라이언트로 전송할 때, 열 형식의 Blocks를 행 형식의 Bytes로 직렬화한 다음 클라이언트에서 다시 열 형식으로 역직렬화해야 했습니다.
Arrow Flight SQL 기반의 고속 데이터 전송 링크를 사용하면, 클라이언트도 Arrow 열 형식을 지원하는 경우 전체 전송 과정에서 직렬화와 역직렬화를 완전히 생략할 수 있어 이에 따른 시간과 성능 오버헤드를 없앨 수 있습니다.
추가 참고 자료:
- Apache Arrow 공식 설치 튜토리얼: Apache Arrow
- Doris의 Arrow Flight 프로토콜 구현 방식: Doris의 Arrow Flight SQL 프로토콜 지원
서버 측 설정
Arrow Flight SQL을 사용하기 전에 Doris FE와 BE에서 Arrow Flight SQL 서비스를 활성화해야 합니다.
arrow_flight_sql_port를fe/conf/fe.conf에서8070과 같은 사용 가능한 포트로 변경합니다.arrow_flight_sql_port를be/conf/be.conf에서8050과 같은 사용 가능한 포트로 변경합니다.- 클러스터를 다시 시작합니다.
arrow_flight_sql_port는 fe.conf와 be.conf에서 서로 다른 값으로 설정해야 합니다.
정상적으로 시작되었는지 확인하는 방법:
| 역할 | 로그 파일 | 키워드 |
|---|---|---|
| FE | fe/log/fe.log | Arrow Flight SQL service is started |
| BE | be/log/be.INFO | Arrow Flight Service bind to host |
4.1.5부터 적용되는 타입 매핑 및 리소스 해제
4.1.5 버전부터 Arrow 스키마는 중첩된 ARRAY / MAP / STRUCT 값에서 하위 필드의 논리 타입 메타데이터와 null 허용 여부를 보존합니다. DATETIME은 시간대가 없는 timestamp를 사용하고, TIMESTAMPTZ는 세션 시간대가 지정된 timestamp를 사용합니다(Z는 UTC로 정규화됩니다). 두 타입은 서로 다른 시간대 의미에 맞게 파싱해야 합니다. 지원 범위를 벗어나는 timestamp는 잘리거나 순환되지 않고 오류가 발생합니다.
읽기가 끝나기 전에 결과 스트림을 닫으면 해당 쿼리가 취소되고 리소스가 해제됩니다. 클라이언트는 Readers / Statements를 올바르게 닫아야 합니다. Coordinator를 유지해야 하는 외부 테이블 배치 스캔의 경우, FE 설정 arrow_flight_deferred_query_idle_timeout_second의 기본값은 3600초입니다. 제한 시간은 쿼리 실행 제한 시간보다 짧아지지 않으며, Coordinator를 해제해도 세션은 닫히지 않습니다.
4.1.5 버전부터 Arrow Flight 쿼리는 MySQL 프로토콜의 SQL 결과 캐시와 MySQL 포인트 쿼리의 short-circuit 경로를 명시적으로 우회합니다. 쿼리는 계속 정상적으로 실행됩니다.
Python 사용 방법
Python ADBC Driver를 사용해 Doris에 연결하면 데이터를 매우 빠르게 읽을 수 있습니다. 필요한 Python 버전은 >= 3.9입니다. 다음 예제에서는 DDL, DML, Session 변수 설정, Show 문 등 ADBC Driver를 사용한 일반적인 데이터베이스 작업을 설명합니다.
1. 의존성 설치
ADBC Driver는 PyPI에 배포되며 pip로 설치할 수 있습니다.
pip install adbc_driver_manager
pip install adbc_driver_flightsql
사용하려면 코드에서 다음 모듈을 가져옵니다.
import adbc_driver_manager
import adbc_driver_flightsql.dbapi as flight_sql

>>> print(adbc_driver_manager.__version__)
1.1.0
>>> print(adbc_driver_flightsql.__version__)
1.1.0
2. 연결 설정
Doris Arrow Flight SQL 서비스와 상호 작용하는 클라이언트를 생성하려면 FE 호스트, Arrow Flight 포트, 사용자 이름과 비밀번호를 제공해야 합니다.
FE와 BE의 Arrow Flight SQL 서비스가 각각 8070과 8050 포트에서 실행되고, 사용자 이름/비밀번호가 user/pass라고 가정합니다. 연결 과정은 다음과 같습니다.
conn = flight_sql.connect(uri="grpc://{FE_HOST}:{fe.conf:arrow_flight_sql_port}", db_kwargs={
            adbc_driver_manager.DatabaseOptions.USERNAME.value: "user",
            adbc_driver_manager.DatabaseOptions.PASSWORD.value: "pass",
        })
cursor = conn.cursor()
연결이 설정되면 반환된 Cursor를 사용해 SQL로 Doris와 상호 작용하면서 테이블 생성, 메타데이터 조회, 데이터 적재, 쿼리 등의 작업을 수행할 수 있습니다.
3. DDL 실행 및 메타데이터 조회
SQL을 cursor.execute() 함수에 전달하여 테이블 생성과 메타데이터 조회를 수행합니다.
cursor.execute("DROP DATABASE IF EXISTS arrow_flight_sql FORCE;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("create database arrow_flight_sql;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show databases;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("use arrow_flight_sql;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("""CREATE TABLE arrow_flight_sql_test
    (
         k0 INT,
         k1 DOUBLE,
         K2 varchar(32) NULL DEFAULT "" COMMENT "",
         k3 DECIMAL(27,9) DEFAULT "0",
         k4 BIGINT NULL DEFAULT '10',
         k5 DATE,
    )
    DISTRIBUTED BY HASH(k5) BUCKETS 5
    PROPERTIES("replication_num" = "1");""")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show create table arrow_flight_sql_test;")
print(cursor.fetchallarrow().to_pandas())
StatusResult가 0을 반환하면 쿼리가 성공적으로 실행된 것입니다(이 설계는 JDBC와의 호환성을 위한 것입니다).
  StatusResult
0            0

  StatusResult
0            0

                   Database
0         __internal_schema
1          arrow_flight_sql
..                      ...
507             udf_auth_db

[508 rows x 1 columns]

  StatusResult
0            0

  StatusResult
0            0
                   Table                                       Create Table
0  arrow_flight_sql_test  CREATE TABLE `arrow_flight_sql_test` (\n  `k0`...
4. 데이터 적재
INSERT INTO를 실행하여 생성한 테이블에 소량의 테스트 데이터를 적재합니다.
cursor.execute("""INSERT INTO arrow_flight_sql_test VALUES
        ('0', 0.1, "ID", 0.0001, 9999999999, '2023-10-21'),
        ('1', 0.20, "ID_1", 1.00000001, 0, '2023-10-21'),
        ('2', 3.4, "ID_1", 3.1, 123456, '2023-10-22'),
        ('3', 4, "ID", 4, 4, '2023-10-22'),
        ('4', 122345.54321, "ID", 122345.54321, 5, '2023-10-22');""")
print(cursor.fetchallarrow().to_pandas())
다음 출력은 데이터 적재가 성공했음을 나타냅니다.
  StatusResult
0            0
Doris에 대량의 데이터를 적재하려면 pydoris를 사용해 Stream Load를 실행하는 것이 좋습니다.
5. 쿼리 실행
방금 데이터를 적재한 테이블에 대해 집계, 정렬, Session 변수 설정 작업을 포함한 쿼리를 실행합니다.
cursor.execute("select * from arrow_flight_sql_test order by k0;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("set exec_mem_limit=2000;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show variables like \"%exec_mem_limit%\";")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("select k5, sum(k1), count(1), avg(k3) from arrow_flight_sql_test group by k5;")
print(cursor.fetch_df())
출력:
   k0            k1    K2                k3          k4          k5
0   0       0.10000    ID       0.000100000  9999999999  2023-10-21
1   1       0.20000  ID_1       1.000000010           0  2023-10-21
2   2       3.40000  ID_1       3.100000000      123456  2023-10-22
3   3       4.00000    ID       4.000000000           4  2023-10-22
4   4  122345.54321    ID  122345.543210000           5  2023-10-22

[5 rows x 6 columns]

  StatusResult
0            0

    Variable_name Value Default_Value Changed
0  exec_mem_limit  2000    2147483648       1

           k5  Nullable(Float64)_1  Int64_2 Nullable(Decimal(38, 9))_3
0  2023-10-22         122352.94321        3            40784.214403333
1  2023-10-21              0.30000        2                0.500050005

[2 rows x 5 columns]
데이터를 열 형식으로 유지하려면 다음 두 가지 방법 중 하나로 쿼리 결과를 가져옵니다.
cursor.fetchallarrow(): Arrow 형식으로 반환cursor.fetch_df(): Pandas DataFrame을 직접 반환
cursor.fetchall()은 사용하지 마세요. 이 메서드는 열 형식 데이터를 다시 행 형식으로 변환하므로 본질적으로 mysql-client를 사용하는 것과 같습니다. 클라이언트 측에서 열 형식을 행 형식으로 변환하는 추가 작업 때문에 mysql-client보다 성능이 느려질 수도 있습니다.
6. 전체 예제
# Doris Arrow Flight SQL Test

# step 1, library is released on PyPI and can be easily installed.
# pip install adbc_driver_manager
# pip install adbc_driver_flightsql
import adbc_driver_manager
import adbc_driver_flightsql.dbapi as flight_sql

# step 2, create a client that interacts with the Doris Arrow Flight SQL service.
# Modify arrow_flight_sql_port in fe/conf/fe.conf to an available port, such as 8070.
# Modify arrow_flight_sql_port in be/conf/be.conf to an available port, such as 8050.
conn = flight_sql.connect(uri="grpc://{FE_HOST}:{fe.conf:arrow_flight_sql_port}", db_kwargs={
            adbc_driver_manager.DatabaseOptions.USERNAME.value: "root",
            adbc_driver_manager.DatabaseOptions.PASSWORD.value: "",
        })
cursor = conn.cursor()

# interacting with Doris via SQL using Cursor
def execute(sql):
    print("\n### execute query: ###\n " + sql)
    cursor.execute(sql)
    print("### result: ###")
    print(cursor.fetchallarrow().to_pandas())

# step3, execute DDL statements, create database/table, show stmt.
execute("DROP DATABASE IF EXISTS arrow_flight_sql FORCE;")
execute("show databases;")
execute("create database arrow_flight_sql;")
execute("show databases;")
execute("use arrow_flight_sql;")
execute("""CREATE TABLE arrow_flight_sql_test
    (
         k0 INT,
         k1 DOUBLE,
         K2 varchar(32) NULL DEFAULT "" COMMENT "",
         k3 DECIMAL(27,9) DEFAULT "0",
         k4 BIGINT NULL DEFAULT '10',
         k5 DATE,
    )
    DISTRIBUTED BY HASH(k5) BUCKETS 5
    PROPERTIES("replication_num" = "1");""")
execute("show create table arrow_flight_sql_test;")


# step4, insert into
execute("""INSERT INTO arrow_flight_sql_test VALUES
        ('0', 0.1, "ID", 0.0001, 9999999999, '2023-10-21'),
        ('1', 0.20, "ID_1", 1.00000001, 0, '2023-10-21'),
        ('2', 3.4, "ID_1", 3.1, 123456, '2023-10-22'),
        ('3', 4, "ID", 4, 4, '2023-10-22'),
        ('4', 122345.54321, "ID", 122345.54321, 5, '2023-10-22');""")


# step5, execute queries, aggregation, sort, set session variable
execute("select * from arrow_flight_sql_test order by k0;")
execute("set exec_mem_limit=2000;")
execute("show variables like \"%exec_mem_limit%\";")
execute("select k5, sum(k1), count(1), avg(k3) from arrow_flight_sql_test group by k5;")

# step6, close cursor
cursor.close()
Java 사용 방법
Java 측에서는 세 가지 연결 방식을 사용할 수 있습니다. 각 방식의 특징과 선택 기준은 다음과 같습니다.
| 연결 방식 | URL 형식 | 반환 형식 | 권장 시나리오 |
|---|---|---|---|
JDBC (jdbc:arrow-flight-sql) | jdbc:arrow-flight-sql://... | JDBC ResultSet(행 형식) | 후속 분석에서 행 형식을 사용하거나 BI 도구 또는 기존 JDBC 코드와의 호환성이 필요한 경우 |
| Flight ADBC Driver | grpc://... | Arrow(열 형식) | 후속 분석에서 Arrow / 열 형식을 사용하며 최적의 성능이 중요한 경우 |
| Flight JDBC Driver(ADBC 래퍼) | jdbc:arrow-flight-sql://... | Arrow(열 형식) | Flight ADBC Driver와 동일하지만 프로젝트에서 jdbc:arrow-flight-sql URL 형식을 계속 사용해야 하는 경우 |
JDBC/Java Arrow Flight SQL 예제의 데모를 참고하여 연결 방식별 성능을 테스트할 수 있습니다. 예상 결과는 Java용 Arrow Flight SQL 데모 추가에 설명되어 있습니다. Java Arrow Flight SQL 연결 방식과 기존 jdbc:mysql의 성능 비교는 GitHub Issue 25514(6.2절)를 참고하세요.
추가 권장 사항:
- JDBC
ResultSet을 파싱하든 Arrow 데이터를 파싱하든, 파싱 시간은 데이터 자체를 읽는 시간보다 깁니다. Arrow Flight SQL의 성능 향상이jdbc:mysql://에 비해 크지 않다면 먼저 데이터 파싱 단계에 시간이 너무 오래 걸리는지 확인하세요. - 모든 연결 방식에서 JDK 17이 JDK 1.8보다 데이터를 더 빠르게 읽습니다.
- 데이터양이 매우 많을 때 Arrow Flight SQL은
jdbc:mysql://보다 메모리를 적게 사용합니다. 메모리가 제한된 환경에서는 Arrow Flight SQL을 먼저 시도하세요. - 위의 세 가지 방식 외에도 네이티브
FlightClient를 사용해 Arrow Flight Server에 직접 연결할 수 있습니다. 이 방식은 더 유연하며 여러 Endpoint에서 병렬로 읽는 기능을 지원합니다. Flight ADBC Driver 자체도FlightClient를 기반으로 연결을 생성하며,FlightClient를 직접 사용하는 것보다 간단합니다.
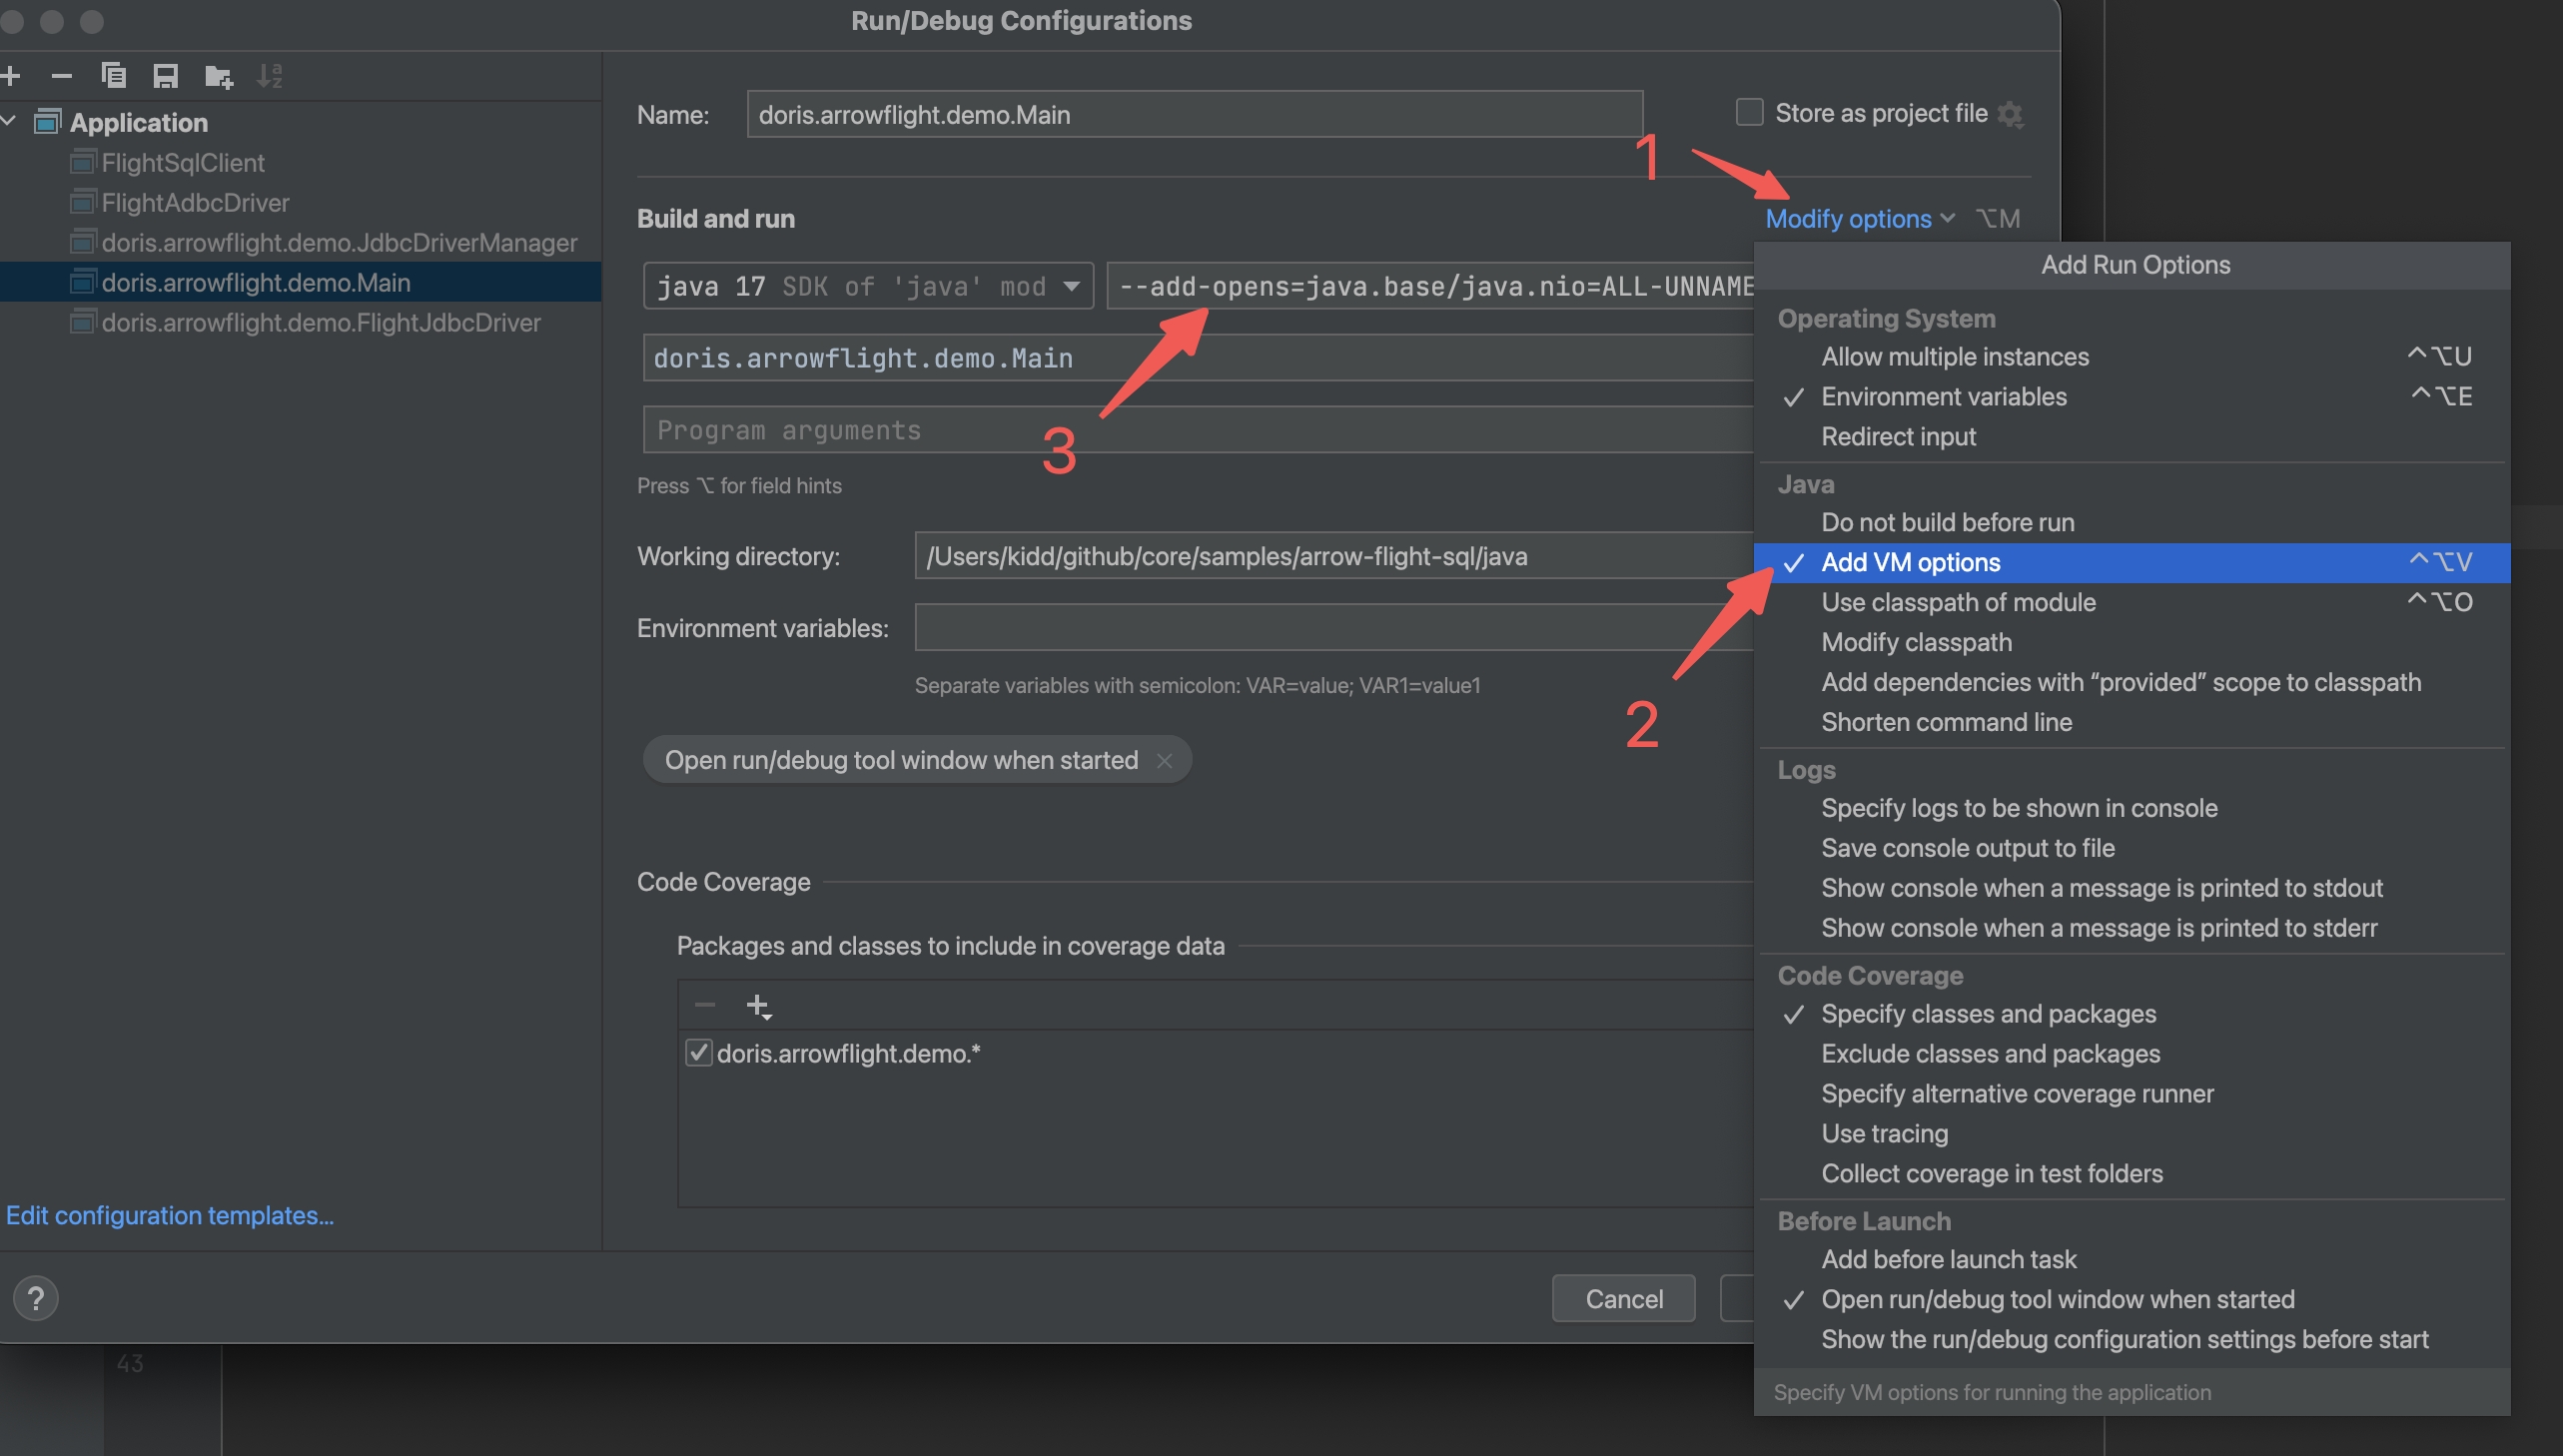
Java 9 이상을 사용할 때는 일부 JDK 내부 요소에 접근할 수 있도록 Java 명령에 --add-opens=java.base/java.nio=ALL-UNNAMED를 추가해야 합니다. 그렇지 않으면 다음 오류 중 하나가 발생합니다.
module java.base does not "opens java.nio" to unnamed modulemodule java.base does not "opens java.nio" to org.apache.arrow.memory.corejava.lang.NoClassDefFoundError: Could not initialize class org.apache.arrow.memory.util.MemoryUtil (Internal; Prepare)
다음 두 가지 방법으로 추가할 수 있습니다.
# Option 1: Add via command-line argument directly
$ java --add-opens=java.base/java.nio=ALL-UNNAMED -jar ...

# Option 2: Add via environment variable
$ env _JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" java -jar ...
IntelliJ IDEA에서 디버깅할 때는 Build and run 항목에 이 인수를 추가합니다. 이 항목은 Run/Debug Configurations에 있습니다. 아래 그림을 참고하세요.
방법 1: jdbc:arrow-flight-sql
Arrow Flight SQL 프로토콜용 오픈 소스 JDBC 드라이버는 표준 JDBC API와 호환됩니다. 대부분의 BI 도구에서 JDBC를 통해 Doris에 접근할 수 있으며, Apache Arrow 데이터의 고속 전송을 지원합니다. 사용 방법은 MySQL JDBC 드라이버와 비슷합니다. 연결 URL의 jdbc:mysql 프로토콜을 jdbc:arrow-flight-sql 프로토콜로 바꾸기만 하면 됩니다. 쿼리 결과는 여전히 JDBC ResultSet 데이터 구조로 반환됩니다.
POM 의존성:
<properties>
    <arrow.version>17.0.0</arrow.version>
</properties>
<dependencies>
    <dependency>
        <groupId>org.apache.arrow</groupId>
        <artifactId>flight-sql-jdbc-core</artifactId>
        <version>${arrow.version}</version>
    </dependency>
</dependencies>
연결 코드 예제:
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.Statement;

Class.forName("org.apache.arrow.driver.jdbc.ArrowFlightJdbcDriver");
String DB_URL = "jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}?useServerPrepStmts=false"
        + "&cachePrepStmts=true&useSSL=false&useEncryption=false";
String USER = "root";
String PASS = "";

Connection conn = DriverManager.getConnection(DB_URL, USER, PASS);
Statement stmt = conn.createStatement();
ResultSet resultSet = stmt.executeQuery("select * from information_schema.tables;");
while (resultSet.next()) {
    System.out.println(resultSet.toString());
}

resultSet.close();
stmt.close();
conn.close();
방법 2: Flight ADBC Driver / Flight JDBC Driver
Java에서는 JDBC를 사용하는 것 외에도 Driver를 생성하여 Doris에서 직접 데이터를 읽고 Arrow 형식으로 반환할 수 있습니다. 다음 예제에서는 ADBC Driver와 JDBC Driver(ADBC 래퍼)를 사용해 Doris Arrow Flight Server에 연결하는 방법을 보여 줍니다.
POM 의존성:
<properties>
    <adbc.version>0.15.0</adbc.version>
</properties>

<dependencies>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-jdbc</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-core</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-manager</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-sql</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-flight-sql</artifactId>
        <version>${adbc.version}</version>
    </dependency>
</dependencies>
Flight ADBC Driver
연결 코드 예제:
// 1. new driver
final BufferAllocator allocator = new RootAllocator();
FlightSqlDriver driver = new FlightSqlDriver(allocator);
Map<String, Object> parameters = new HashMap<>();
AdbcDriver.PARAM_URI.set(parameters, Location.forGrpcInsecure("{FE_HOST}", {fe.conf:arrow_flight_sql_port}).getUri().toString());
AdbcDriver.PARAM_USERNAME.set(parameters, "root");
AdbcDriver.PARAM_PASSWORD.set(parameters, "");
AdbcDatabase adbcDatabase = driver.open(parameters);

// 2. new connection
AdbcConnection connection = adbcDatabase.connect();
AdbcStatement stmt = connection.createStatement();

// 3. execute query
stmt.setSqlQuery("select * from information_schema.tables;");
QueryResult queryResult = stmt.executeQuery();
ArrowReader reader = queryResult.getReader();

// 4. load result
List<String> result = new ArrayList<>();
while (reader.loadNextBatch()) {
    VectorSchemaRoot root = reader.getVectorSchemaRoot();
    String tsvString = root.contentToTSVString();
    result.add(tsvString);
}
System.out.printf("batchs %d\n", result.size());

// 5. close
reader.close();
queryResult.close();
stmt.close();
connection.close();
Flight JDBC Driver(ADBC 래퍼)
연결 코드 예제:
final Map<String, Object> parameters = new HashMap<>();
AdbcDriver.PARAM_URI.set(
        parameters,"jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}?useServerPrepStmts=false&cachePrepStmts=true&useSSL=false&useEncryption=false");
AdbcDriver.PARAM_USERNAME.set(parameters, "root");
AdbcDriver.PARAM_PASSWORD.set(parameters, "");
try (
        BufferAllocator allocator = new RootAllocator();
        AdbcDatabase db = new JdbcDriver(allocator).open(parameters);
        AdbcConnection connection = db.connect();
        AdbcStatement stmt = connection.createStatement()
) {
    stmt.setSqlQuery("select * from information_schema.tables;");
    AdbcStatement.QueryResult queryResult = stmt.executeQuery();
    ArrowReader reader = queryResult.getReader();
    List<String> result = new ArrayList<>();
    while (reader.loadNextBatch()) {
        VectorSchemaRoot root = reader.getVectorSchemaRoot();
        String tsvString = root.contentToTSVString();
        result.add(tsvString);
    }
    long etime = System.currentTimeMillis();
    System.out.printf("batchs %d\n", result.size());

    reader.close();
    queryResult.close();
    stmt.close();
}  catch (Exception e) {
    e.printStackTrace();
}
타입 매핑
4.1.4 버전부터 Arrow Flight SQL이 반환하는 DATETIME / DATETIMEV2 값은 시간대 정보가 없는 Arrow timestamp이며, TIMESTAMPTZ는 여전히 시간대 정보가 있는 timestamp로 반환됩니다.
4.1.4 이전에는 DATETIME에 시간대 정보가 있는 것으로 표시되었기 때문에, 클라이언트가 로컬 시간대로 파싱할 때 시간대 오프셋이 추가로 적용되었습니다. 업그레이드 후에는 DATETIME 열을 시간대가 없는 로컬 시각 값으로 파싱하세요.
같은 버전에서 다음 타입 메타데이터도 수정되었습니다.
GetTables메타데이터 엔드포인트에서DATEV2의 Arrow 타입이Date(MILLISECOND)에서Date(DAY)로 수정되었습니다.ARRAY/MAP/STRUCT메타데이터가 이제 임시 타입 대신 실제 하위 필드 타입을 보고합니다.
서드파티 컴포넌트와 통합
BI 도구(DBeaver 등)
Doris v2.1.8부터 DBeaver와 같은 BI 도구에서 arrow-flight-sql 프로토콜을 사용해 Doris에 연결할 수 있습니다. 설정 방법은 다음 자료를 참고하세요.
Spark 및 Flink
Arrow Flight는 공식적으로 Spark와 Flink를 지원할 계획이 없습니다(GitHub Issue 참고). 하지만 24.0.0 버전부터 다음 커넥터에서 Arrow Flight SQL을 통한 Doris 접근을 지원하며, 읽기 성능이 몇 배 향상될 것으로 예상됩니다.
커뮤니티에서는 이전에 Spark-Flight-Connector를 참고하여 Spark에서 FlightClient를 통해 Doris에 연결하는 테스트를 진행했습니다. 그 결과는 다음과 같습니다.
- Arrow와 Doris Block 간 변환은 CSV와 Doris Block 간 변환보다 10배 빠릅니다.
- Arrow는 Map 및 Array와 같은 복합 타입을 더 잘 지원합니다.
- Arrow 데이터는 압축률이 높아 전송 시 네트워크 오버헤드가 줄어듭니다.
하지만 Doris Arrow Flight에는 아직 여러 노드에서 병렬로 읽는 기능이 구현되지 않았습니다. 쿼리 결과는 여전히 단일 BE 노드로 집계된 후 반환됩니다. 단순한 대량 데이터 내보내기에서는 Tablet 단위의 병렬 읽기를 지원하는 Doris Spark Connector보다 성능이 좋지 않을 수 있습니다.
Spark에서 Arrow Flight SQL을 사용해 Doris에 연결하려면 다음 오픈 소스 프로젝트를 참고하여 직접 구현할 수 있습니다.
고급 설정
여러 BE에서 병렬로 결과 반환
기본적으로 Doris는 모든 BE 노드의 쿼리 결과를 단일 BE 노드로 집계합니다. 프로토콜별 동작은 다음과 같습니다.
- MySQL/JDBC 쿼리: FE가 결과를 집계하는 BE 노드에 쿼리 결과를 요청합니다.
- Arrow Flight SQL 쿼리: FE가 해당 BE 노드의 IP/포트를 Endpoint에 담아 ADBC Client에 반환합니다. 그런 다음 ADBC Client가 이 Endpoint에 데이터를 요청합니다.
시나리오 1: 단순 SELECT 데이터 읽기(Join/Sort/윈도 함수 없음)
쿼리가 Join, Sort, 윈도 함수처럼 데이터 셔플을 유발하는 연산자 없이 Doris에서 데이터를 가져오는 단순 SELECT라면, Tablet 단위로 쿼리를 분할할 수 있습니다. Doris Spark/Flink Connector는 다음 두 단계를 통해 이 방식으로 병렬 읽기를 구현합니다.
-
EXPLAIN SQL을 실행합니다. FE가 반환하는 쿼리 계획의 ScanOperator에는 전체 Tablet ID 목록이 포함되어 있습니다. -
이 Tablet ID 목록을 기준으로 원래 SQL을 여러 SQL 문으로 분할하여 각 SQL 문이 일부 Tablet만 읽도록 합니다. 예를 들면 다음과 같습니다.
SELECT * FROM t1 TABLET(10001,10002) limit 1000;분할한 SQL 문은 병렬로 실행할 수 있습니다. 자세한 내용은 SELECT 테이블 샘플링 지원을 참고하세요.
시나리오 2: 가장 바깥쪽에서 집계하는 쿼리
select k1, sum(k2) from xxx group by k1 형식의 쿼리는 Doris v3.0.4부터 다음 설정을 사용하여 각 BE 노드가 결과를 독립적으로 반환하도록 할 수 있습니다.
set enable_parallel_result_sink=true;
ADBC Client는 FE가 반환한 Endpoint 목록을 받은 후 여러 BE 노드에서 병렬로 결과를 가져옵니다. 구현 세부 사항은 병렬 결과 sink 지원을 참고하세요.
집계 결과가 작을 때 여러 BE에서 결과를 반환하면 RPC 부하가 증가합니다.
이론적으로 가장 바깥쪽에서 정렬하는 쿼리를 제외한 모든 쿼리는 BE 노드별 병렬 결과 반환을 지원할 수 있습니다. 이 기능은 아직 구현되지 않았습니다.
여러 BE가 동일한 외부 접속 IP를 공유하는 구성
FE 노드에는 클러스터 외부에서 접근할 수 있지만, 모든 BE 노드에는 클러스터 내부에서만 접근할 수 있는 배포 구성이 있습니다.
- MySQL Client 또는 JDBC로 Doris에 연결하여 쿼리를 실행하면 결과가 FE를 통해 반환되므로 정상적으로 동작합니다.
- Arrow Flight SQL로 Doris에 연결하면 ADBC Client가 쿼리 결과를 가져오기 위해 BE 노드에 직접 연결해야 하므로 쿼리 실행에 실패합니다.
프로덕션 환경에서는 BE 노드를 클러스터 외부에 노출하기가 대체로 어렵습니다. 모든 BE 노드 앞에 Nginx와 같은 리버스 프록시를 추가하면, Nginx에 연결하는 외부 클라이언트가 임의의 BE 노드로 라우팅됩니다. 하지만 기본적으로 Arrow Flight SQL 쿼리 결과는 임의로 선택된 특정 BE 노드에 저장됩니다. 이 노드가 Nginx가 라우팅한 BE 노드와 다르면 BE 내부에서 데이터를 전달하는 단계가 추가로 수행됩니다.
Doris v2.1.8부터는 public_host와 arrow_flight_sql_proxy_port를 모든 BE 노드의 be.conf에서 여러 BE 노드가 공유하는 외부 접속 IP와 포트로 설정할 수 있습니다. 그러면 쿼리 결과가 올바르게 전달되어 ADBC Client에 반환됩니다.
public_host={nginx ip}
arrow_flight_sql_proxy_port={nginx port}
자주 묻는 질문
1. i/o timeout 오류
질문: 전체 오류 메시지는 connection error: desc = "transport: Error while dialing: dial tcp <ip:arrow_flight_port>: i/o timeout"입니다.
답변: 오류 메시지의 <ip:arrow_flight_port>에 해당하는 역할에 따라 두 가지 경우로 나누어 확인합니다.
경우 1: <ip:arrow_flight_port>가 FE 노드의 IP 및 arrow_flight_port인 경우
- FE 노드의 Arrow Flight Server가 정상적으로 시작되었는지 확인합니다.
Arrow Flight SQL service is started가fe/log/fe.log에 있으면 정상적으로 시작된 것입니다. - FE Arrow Flight Server가 정상적으로 시작되었다면 클라이언트 머신에서 이 IP로
ping이 가능한지 확인합니다. 불가능하다면 FE 노드에 외부에서 접근 가능한 IP를 활성화하고 클러스터를 다시 배포해야 합니다.
경우 2: <ip:arrow_flight_port>가 BE 노드의 IP 및 arrow_flight_port인 경우
- BE 노드의 Arrow Flight Server가 정상적으로 시작되었는지 확인합니다.
Arrow Flight Service bind to host가be/log/be.INFO에 있으면 정상적으로 시작된 것입니다. - BE Arrow Flight Server가 정상적으로 시작되었다면 클라이언트 머신에서 이 IP로
ping이 가능한지 확인합니다.
BE 노드가 클러스터 내부 네트워크에 있다는 사실을 알고 있다면 다음 두 가지 방법 중 하나를 사용합니다.
- 각 BE 노드에 외부에서 접근 가능한 IP를 활성화합니다. Doris v2.1.8부터는
public_host를 해당 BE 노드의be.conf에서 이 IP로 설정하고, 같은 방식으로 모든 BE 노드의public_host를 클라이언트에서 접근 가능한 해당 IP로 설정합니다. - 여러 BE가 동일한 외부 접속 IP를 공유하는 구성 절을 참고하여 모든 BE 노드 앞에 리버스 프록시를 추가합니다.
BE가 완전히 내부 네트워크에 있는지 확실하지 않다면 다음 단계에 따라 확인합니다.
- BE 노드 머신에서
ifconfig를 실행하여 모든 IP를 조회합니다. 그중 하나는<ip:arrow_flight_port>의 IP와 일치하고,show backends로 출력되는 IP와도 일치해야 합니다. ping으로ifconfig가 반환한 나머지 IP를 하나씩 확인합니다.- 클라이언트에서 접근할 수 있는 IP가 있다면 해당 IP를
public_host로 설정합니다. 클라이언트에서 접근할 수 있는 IP가 없다면 BE 노드는 완전히 내부 네트워크에 있는 것입니다.
2. JDBC 또는 Java로 Arrow Flight SQL에 연결할 때 발생하는 module java.base does not "opens java.nio"... 오류
질문: 전체 오류는 다음 중 하나일 수 있습니다.
module java.base does not "opens java.nio" to unnamed modulemodule java.base does not "opens java.nio" to org.apache.arrow.memory.corejava.lang.NoClassDefFoundError: Could not initialize class org.apache.arrow.memory.util.MemoryUtil (Internal; Prepare)
답변: 다음과 같이 해결합니다.
JAVA_OPTS_FOR_JDK_17설정(fe/conf/fe.conf)에--add-opens=java.base/java.nio=ALL-UNNAMED가 포함되어 있는지 확인합니다. 없으면 추가합니다.- Java 사용 방법의 주의 사항을 참고하여 Java 명령에
--add-opens=java.base/java.nio=ALL-UNNAMED를 추가합니다. - IntelliJ IDEA에서 디버깅할 때는
--add-opens=java.base/java.nio=ALL-UNNAMED를Build and run항목에 추가합니다. 이 항목은Run/Debug Configurations에 있습니다.
3. ARM 환경에서 발생하는 arrow flight schema timeout 오류
질문: 전체 오류는 get flight info statement failed, arrow flight schema timeout, TimeoutException: Waited 5000 milliseconds for io.grpc.stub.Client입니다.
답변: Linux 커널 버전이 <= 4.19.90이면 4.19.279 이상으로 업그레이드하거나, 낮은 버전의 Linux 커널 환경에서 Doris BE를 다시 컴파일해야 합니다. 구체적인 컴파일 방법은 docs/dev/install/source-install/compilation-arm 문서를 참고하세요.
원인: 오래된 Linux 커널에는 Arrow와의 호환성 문제가 있습니다. cpp: arrow::RecordBatch::MakeEmpty()가 Arrow Record Batch를 생성하는 중에 멈추기 때문에, BE의 Arrow Flight Server가 FE의 RPC 요청에 5000ms 이내에 응답하지 못하고 FE는 클라이언트에 RPC 시간 초과 오류를 반환합니다. Spark와 Flink도 Doris에서 데이터를 읽을 때 쿼리 결과를 Arrow Record Batch로 변환한 후 반환하므로 같은 문제가 발생합니다.
KylinV10 SP2 및 SP3의 Linux 커널 버전은 4.19.90-24.4.v2101.ky10.aarch64까지만 제공되며 더 이상 업그레이드할 수 없습니다. 따라서 KylinV10에서 Doris BE를 다시 컴파일해야 합니다. 새 ldb_toolchain으로 컴파일한 후에도 문제가 지속되면 이전 버전인 ldb_toolchain v0.17로 컴파일해 보세요. ARM 환경에서 인터넷에 접근할 수 없다면 Huawei Cloud는 ARM + KylinV10을, Alibaba Cloud는 x86 + KylinV10을 제공합니다.
4. jdbc:arrow-flight-sql의 배치별 읽기 크기 변경 방법
질문: 일부 시나리오에서는 성능 향상을 위해 배치 크기를 변경해야 합니다.
답변: setTargetBatchSize 설정을 makeJdbcConfig 메서드(org.apache.arrow.adbc.driver.jdbc.JdbcArrowReader 내)에서 수정합니다(기본값 1024). 그런 다음 수정한 파일을 원본과 동일한 경로 구조로 로컬 디렉터리에 저장하여 원본 파일을 덮어쓰면 변경 사항이 적용됩니다.
5. ADBC v0.10은 병렬 읽기를 지원하지 않음
질문: ADBC v0.10의 JDBC 및 Java ADBC/JDBC Driver는 병렬 읽기를 지원하나요?
답변: 지원하지 않습니다. stmt.executePartitioned() 메서드가 구현되어 있지 않기 때문입니다. 네이티브 FlightClient를 사용하여 여러 Endpoint에서 병렬로 읽는 기능을 직접 구현해야 합니다. 호출 흐름은 다음과 같습니다.
sqlClient = new FlightSqlClient
execute   = sqlClient.execute(sql)
endpoints = execute.getEndpoints()
for (FlightEndpoint endpoint : endpoints) { ... }
또한 ADBC v0.10의 기본 AdbcStatement는 실제로는 JdbcStatement입니다. executeQuery 이후 행 형식의 JDBC ResultSet이 다시 Arrow 열 형식으로 변환됩니다. Java ADBC 기능은 ADBC 1.0.0에서 더 완성될 것으로 예상됩니다. 자세한 내용은 GitHub Issue를 참고하세요.
6. URL에 데이터베이스 이름 지정
질문: URL에 데이터베이스 이름을 지정할 수 있나요?
답변: Arrow v15.0 기준으로 Arrow JDBC Connector는 URL에 데이터베이스 이름을 지정하는 기능을 지원하지 않습니다. 예를 들어 test 데이터베이스를 jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}/test?useServerPrepStmts=false에 지정해도 적용되지 않습니다. SQL use database를 직접 실행해야 합니다. Arrow v18.0은 URL에 데이터베이스 이름을 지정하는 기능을 지원하지만, 실제 사용 시에는 여전히 버그가 있습니다.
7. Python ADBC에서 Cannot disable autocommit 경고 출력
질문: 전체 경고는 Warning: Cannot disable autocommit; conn will not be DB-API 2.0 compliant입니다.
답변: Python을 사용할 때 이 경고는 무시해도 됩니다. Python ADBC Client의 문제이며 쿼리에는 영향을 주지 않습니다.
8. Python의 grpc: received message larger than max 오류
질문: 전체 오류는 grpc: received message larger than max (20748753 vs. 16777216)입니다.
답변: Python: grpc: received message larger than max #2078을 참고하여 Database Option에 adbc_driver_flightsql.DatabaseOptions.WITH_MAX_MSG_SIZE.value를 추가합니다.
9. invalid bearer token 오류
질문: 클라이언트에서 invalid bearer token 오류가 발생합니다.
답변: 다음 조치를 취할 수 있습니다.
-
현재 사용자의 최대 연결 수를 변경합니다.
SET PROPERTY FOR 'root' 'max_user_connections' = '10000'; -
fe.conf에 다음 두 항목을 추가하고 FE를 다시 시작합니다.qe_max_connection=30000
arrow_flight_token_cache_size=8000
원인: 장기 연결 유지 메커니즘
ADBC Client와 Arrow Flight Server 간의 연결은 본질적으로 장기 연결입니다. Auth Token, Connection, Session을 서버에 캐시해야 합니다. 연결이 생성되면 개별 쿼리가 끝나더라도 즉시 닫히지 않습니다. 클라이언트가 close() 요청을 보내야 정리됩니다. 실제로는 클라이언트가 close()를 보내지 않는 경우가 많아 Auth Token, Connection, Session이 서버에 오랫동안 남아 있습니다. 기본적으로 3일 후에 만료되거나, 연결 수가 arrow_flight_token_cache_size 한도를 초과하면 LRU에 따라 제거됩니다.
원인: 기본 연결 한도가 너무 작음
Doris v2.1.8 기준으로 Arrow Flight 연결과 MySQL/JDBC 연결은 다음과 같은 연결 한도를 공유합니다.
- FE의 모든 사용자에 대한 총 연결 수:
qe_max_connection, 기본값1024. - 사용자별 연결 수:
max_user_connections(UserProperty내), 기본값100.
Arrow Flight SQL은 JDBC를 대체하는 용도로 자주 사용되지만, JDBC 연결은 쿼리가 끝나면 즉시 해제됩니다. 따라서 Arrow Flight SQL을 사용할 때는 Doris의 기본 연결 한도가 너무 작아 연결 수가 arrow_flight_token_cache_size를 초과하고, 아직 사용 중인 연결이 제거되는 경우가 많습니다.
10. JDBC 또는 Java로 Datetime 타입을 읽을 때 timestamp 반환
질문: JDBC 또는 Java로 Arrow Flight SQL에 연결하여 Datetime 타입을 읽으면 timestamp(예: 1740993808)가 반환되고, 형식이 지정된 시간(예: 2025-03-03 17:23:28Z)은 반환되지 않습니다.
답변: JDBC 또는 Java로 Arrow Flight SQL에 연결하여 Datetime 타입을 읽을 때는 timestamp를 직접 변환해야 합니다. Arrow Flight SQL 예제에 Java Datetime 타입 파싱 추가 #48578을 참고하세요. Python Arrow Flight SQL은 Datetime 타입에 대해 2025-03-03 17:23:28Z를 반환하지만, JDBC 또는 Java는 1740993808을 반환합니다.
11. JDBC 또는 Java JDBC Client에서 Array 중첩 타입을 읽을 때 발생하는 오류
질문: 전체 오류는 Configuration does not provide a mapping for array column 2입니다.
답변: sample/arrow-flight-sql을 참고하여 Java ADBC Client로 전환하는 것이 좋습니다.
Python ADBC Client, Java ADBC Client, Java JDBC DriverManager는 모두 Array 중첩 타입을 문제없이 읽습니다. 이 문제는 JDBC 또는 Java JDBC Client를 사용해 Arrow Flight SQL에 연결할 때만 발생합니다. Arrow Flight JDBC는 Arrow에서 공식적으로 개발한 것이 아니라 서드파티 데이터베이스 회사인 Dremio에서 개발한 것으로, 호환성이 상대적으로 떨어집니다. 이전에도 다른 호환성 문제가 발견되었으므로 Java ADBC Client를 우선 권장합니다.