Broker Load
Broker Load는 MySQL API를 통해 시작합니다. Doris는 LOAD 문에 지정된 정보에 따라 원격 데이터 소스에서 데이터를 직접 가져옵니다. 이는 비동기 데이터 적재 방식입니다. 작업을 제출한 후에는 SHOW LOAD 문으로 데이터 적재 진행 상황과 결과를 확인해야 합니다.
이 방식은 사용 중단 예정이며 5.0 버전에서 제거됩니다. 대신 "insert into table select xxx from tvf or catalog table"을 사용하세요.
Broker Load는 다음과 같은 일반적인 시나리오에 적합합니다.
- 원본 데이터가 원격 시스템(예: 객체 스토리지 또는 HDFS)에 저장되어 있습니다.
- 한 번에 적재하는 데이터의 양이 큽니다(GB~TB 수준).
- 데이터를 배치 단위로 비동기 적재하고, 동시 실행과 재시도는 Doris가 직접 제어하도록 하려는 경우입니다.
Lakehouse / TVF의 HDFS TVF 또는 S3 TVF를
INSERT INTO와 함께 사용하여 데이터를 적재할 수도 있습니다. TVF 기반INSERT INTO는 현재 동기 데이터 적재 방식이며, Broker Load는 비동기 데이터 적재 방식입니다.
초기 Doris 버전에서는 S3 Load와 HDFS Load 모두 WITH BROKER를 통해 특정 Broker 프로세스에 연결했습니다. 버전이 발전하면서 S3 Load와 HDFS Load는 더 이상 별도의 Broker 프로세스에 의존하지 않게 되었지만, 여전히 Broker Load와 유사한 구문을 사용합니다. 이러한 역사적 배경과 구문의 유사성 때문에 S3 Load, HDFS Load, Broker Load를 통틀어 Broker Load라고 부릅니다.
제약 사항
다음 표는 Broker Load의 지원 범위를 요약한 것입니다.
| 구분 | 지원 범위 |
|---|---|
| 스토리지 백엔드 | S3 프로토콜, HDFS 프로토콜, 기타 프로토콜(해당 Broker 프로세스 필요) |
| 파일 경로 패턴 | 와일드카드 *, ?, [abc], [a-z]; 범위 확장 {1..10}, {a,b,c}. 전체 구문은 파일 경로 패턴을 참조하세요. |
| 데이터 형식 | CSV, JSON, PARQUET, ORC |
| 압축 유형 | PLAIN, GZ, LZO, BZ2, LZ4FRAME, DEFLATE, LZOP, LZ4BLOCK, SNAPPYBLOCK, ZLIB, ZSTD |
기본 원리
데이터 적재 작업을 제출하면 다음 과정이 진행됩니다.
- FE가 해당 실행 계획을 생성하고, 현재 BE 수와 파일 크기를 기준으로 여러 BE에 분배하여 실행합니다.
- 각 BE는 데이터의 일부를 적재합니다. Broker에서 데이터를 가져와 변환한 후 Doris 시스템에 기록합니다.
- 모든 BE가 데이터 적재를 완료하면 FE가 최종적으로 데이터 적재 성공 여부를 판단합니다.
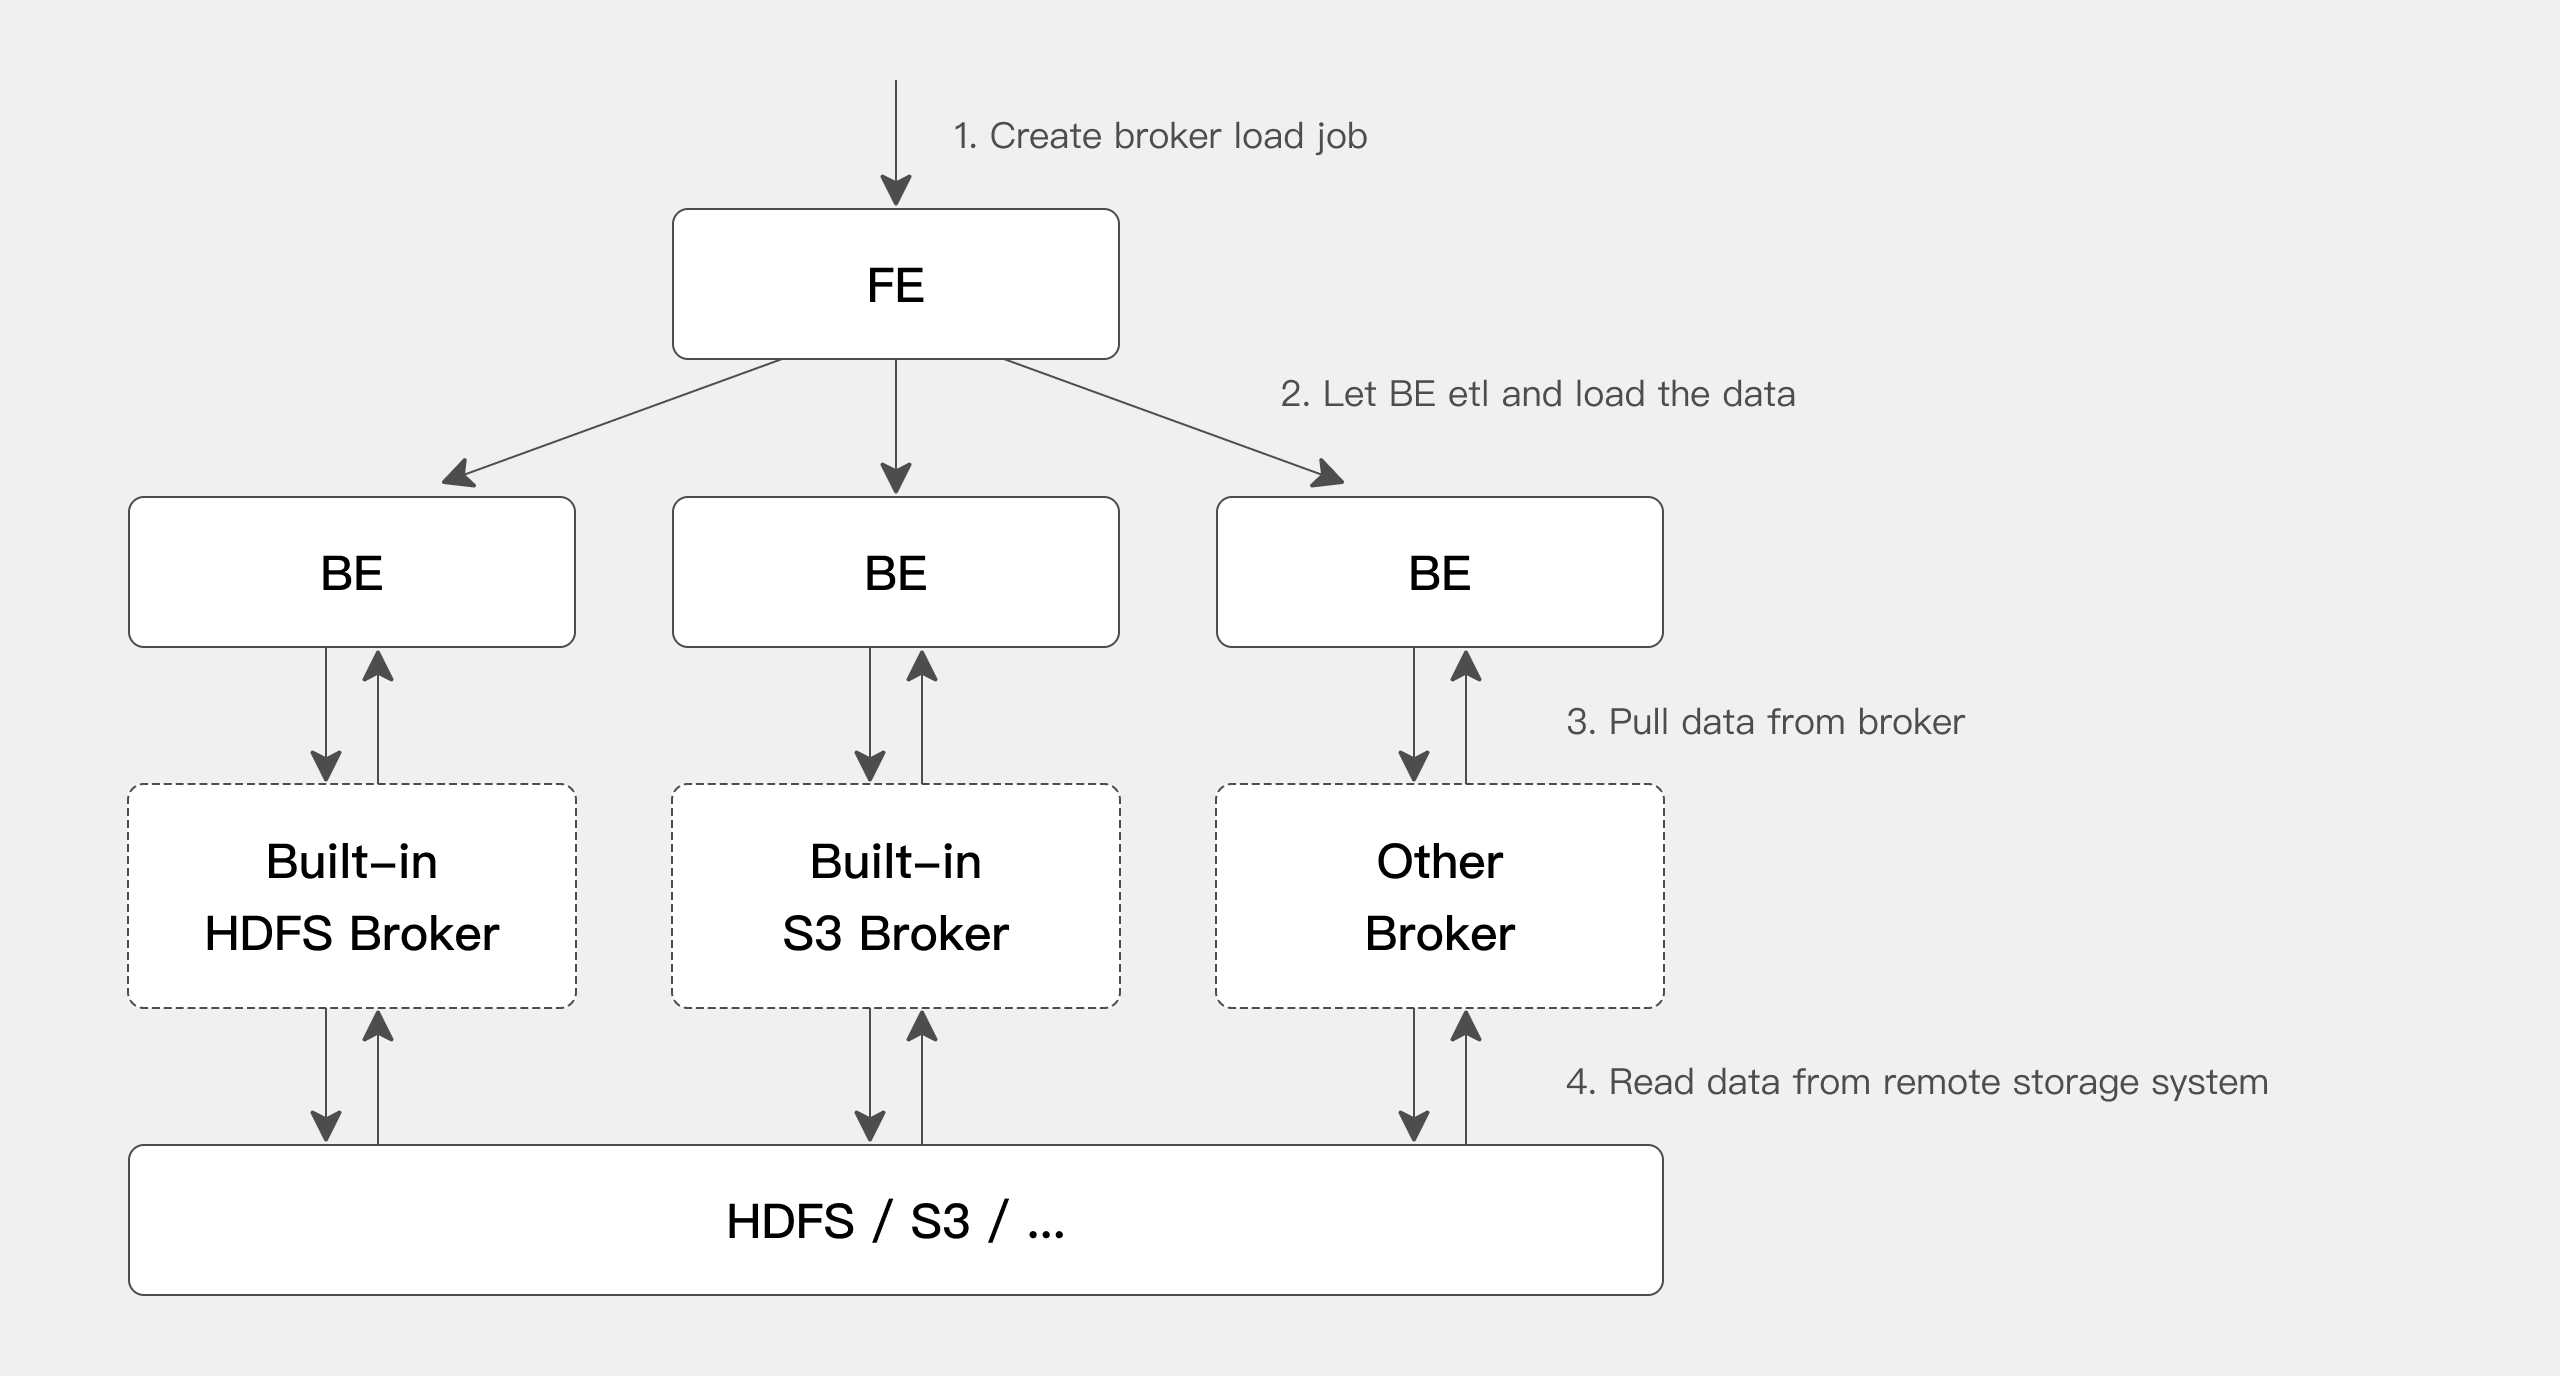
BE는 Broker 프로세스를 통해 원격 스토리지 시스템에서 데이터를 읽습니다. Broker를 도입한 주요 목적은 다음과 같습니다.
- 생태계 호환성: Broker 표준에 따라 Java로 개발할 수 있어 빅데이터 생태계의 다양한 스토리지 시스템을 쉽게 지원할 수 있습니다.
- 오류 격리: Broker 프로세스가 BE 프로세스와 분리되어 있어 BE의 안정성이 향상됩니다.
BE는 HDFS와 S3를 기본으로 지원하므로 HDFS 또는 S3에서 데이터를 적재할 때 별도의 Broker 프로세스를 시작할 필요가 없습니다. 사용자 정의 Broker 구현을 사용하는 경우에는 해당 Broker 프로세스를 배포해야 합니다.
빠른 시작
이 절에서는 S3 Load를 예로 들어 전체 과정을 설명합니다. 전체 구문은 SQL 매뉴얼의 Broker Load를 참조하세요.
사전 확인 사항
1. Doris 테이블 권한
Broker Load를 사용하려면 대상 테이블에 대한 INSERT 권한이 필요합니다. 이 권한이 없으면 GRANT 명령으로 부여하세요.
2. S3 인증 및 연결 정보
AWS S3를 예로 들면 다음과 같습니다. 다른 객체 스토리지 시스템에서도 이를 참고할 수 있습니다.
| 정보 | 확인 방법 |
|---|---|
| AK / SK | Access keys를 AWS Console의 My Security Credentials에서 확인하거나 생성합니다. |
| REGION | 버킷 생성 시 선택하며, 버킷 목록에서도 확인할 수 있습니다. |
| ENDPOINT | AWS 문서: S3 엔드포인트를 참조하세요. |
데이터 적재 작업 생성
1단계: S3에 CSV 파일 준비
다음 내용으로 brokerload_example.csv를 생성합니다.
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64
2단계: Doris에 대상 테이블 생성
CREATE TABLE testdb.test_brokerload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
3단계: Broker Load 작업 제출
버킷 이름과 S3 인증 정보를 실제 값으로 바꿉니다.
LOAD LABEL broker_load_2022_04_01
(
    DATA INFILE("s3://your_bucket_name/brokerload_example.csv")
    INTO TABLE test_brokerload
    COLUMNS TERMINATED BY ","
    FORMAT AS "CSV"
    (user_id, name, age)
)
WITH S3
(
    "provider" = "S3",
    "AWS_ENDPOINT" = "https://s3.us-west-2.amazonaws.com",
    "AWS_ACCESS_KEY" = "<your-ak>",
    "AWS_SECRET_KEY"="<your-sk>",
    "AWS_REGION" = "us-west-2",
    "compress_type" = "PLAIN"
)
PROPERTIES
(
    "timeout" = "3600"
);
provider 필드는 실제 객체 스토리지 서비스 제공업체에 맞게 설정해야 합니다. Doris가 지원하는 provider 값은 다음과 같습니다.
| provider | 제공업체 |
|---|---|
S3 | Amazon AWS |
AZURE | Microsoft Azure |
GCP | Google GCP |
OSS | Alibaba Cloud |
COS | Tencent Cloud |
OBS | Huawei Cloud |
BOS | Baidu Cloud |
제공업체가 목록에 없는 경우(예: MinIO)에는 S3(AWS 호환 모드)를 사용해 볼 수 있습니다.
데이터 적재 작업 조회
Broker Load는 비동기 데이터 적재 방식입니다. SHOW LOAD 명령으로 구체적인 결과를 확인할 수 있습니다.
mysql> show load order by createtime desc limit 1\G;
*************************** 1. row ***************************
         JobId: 41326624
         Label: broker_load_2022_04_01
         State: FINISHED
      Progress: ETL:100%; LOAD:100%
          Type: BROKER
       EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=27
      TaskInfo: cluster:N/A; timeout(s):1200; max_filter_ratio:0.1
      ErrorMsg: NULL
    CreateTime: 2022-04-01 18:59:06
  EtlStartTime: 2022-04-01 18:59:11
 EtlFinishTime: 2022-04-01 18:59:11
 LoadStartTime: 2022-04-01 18:59:11
LoadFinishTime: 2022-04-01 18:59:11
           URL: NULL
    JobDetails: {"Unfinished backends":{"5072bde59b74b65-8d2c0ee5b029adc0":[]},"ScannedRows":27,"TaskNumber":1,"All backends":{"5072bde59b74b65-8d2c0ee5b029adc0":[36728051]},"FileNumber":1,"FileSize":5540}
1 row in set (0.01 sec)
데이터 적재 작업 취소
Broker Load 작업의 상태가 CANCELLED 또는 FINISHED가 아니면 수동으로 취소할 수 있습니다. 취소할 때는 대상 작업의 레이블을 지정해야 합니다. 구문은 CANCEL LOAD를 참조하세요.
예를 들어, 레이블이 broker_load_2022_04_01이고 데이터베이스가 demo인 데이터 적재 작업은 다음과 같이 취소합니다.
CANCEL LOAD FROM demo WHERE LABEL = "broker_load_2022_04_01";
컴퓨팅 그룹 바인딩
스토리지와 컴퓨팅이 분리된 모드에서 Broker Load는 다음 우선순위에 따라 컴퓨팅 그룹을 선택합니다.
use db@cluster문에 지정된 컴퓨팅 그룹을 선택합니다.- 사용자 속성
default_compute_group에 지정된 컴퓨팅 그룹을 선택합니다. - 현재 사용자에게 권한이 있는 컴퓨팅 그룹 중 하나를 선택합니다.
스토리지와 컴퓨팅이 통합된 모드에서는 사용자 속성 resource_tags.location에 지정된 컴퓨팅 그룹을 선택합니다. 사용자 속성에 지정되어 있지 않으면 이름이 default인 컴퓨팅 그룹을 사용합니다.
참조
데이터 적재 명령 구문
LOAD LABEL load_label
(
data_desc1[, data_desc2, ...]
[format_properties]
)
WITH [S3|HDFS|BROKER broker_name]
[broker_properties]
[load_properties]
[COMMENT "comments"];
WITH 절은 스토리지 시스템에 접근하는 방식을 지정하고, broker_properties는 해당 접근 방식의 구성 매개변수를 제공합니다.
| 절 | 설명 |
|---|---|
S3 | S3 프로토콜을 사용하는 스토리지 시스템입니다. |
HDFS | HDFS 프로토콜을 사용하는 스토리지 시스템입니다. |
BROKER broker_name | 기타 프로토콜을 사용하는 스토리지 시스템입니다. 사용 가능한 broker_name 목록은 SHOW BROKER로 확인할 수 있습니다. 자세한 내용은 아래의 "기타 Broker를 통한 데이터 적재"를 참조하세요. |
데이터 적재 구성 매개변수
데이터 적재 속성
| 속성 이름 | 유형 | 기본값 | 설명 |
|---|---|---|---|
timeout | Long | 14400 | 데이터 적재 제한 시간으로, 단위는 초입니다. 범위는 1~259200초입니다. |
max_filter_ratio | Float | 0.0 | 허용 가능한 잘못된 데이터의 최대 비율입니다. 기본적으로 오류를 전혀 허용하지 않습니다. 값의 범위는 0~1입니다. 오류 비율이 이 값을 초과하면 데이터 적재가 실패합니다. WHERE 조건으로 필터링된 행은 잘못된 데이터에 포함되지 않습니다. |
strict_mode | Boolean | false | 엄격 모드 활성화 여부입니다. |
partial_columns | Boolean | false | 부분 컬럼 업데이트 사용 여부입니다. Merge on Write를 사용하는 Unique Key 테이블에서만 적용됩니다. |
timezone | String | "Asia/Shanghai" | 이 데이터 적재에 사용할 시간대입니다. 시간대와 관련된 모든 함수의 결과에 영향을 줍니다. |
load_parallelism | Integer | 8 | 각 BE에서 동시에 실행되는 인스턴스 수의 상한입니다. |
send_batch_parallelism | Integer | 1 | sink 노드가 데이터를 전송할 때의 동시 실행 수입니다. memtable-on-sink가 비활성화된 경우에만 적용됩니다. |
load_to_single_tablet | Boolean | false | 파티션마다 하나의 tablet에만 적재할지 여부입니다. 무작위 버킷 분할을 사용하는 OLAP 테이블에서만 허용됩니다. |
priority | HIGH / NORMAL / LOW | NORMAL | 데이터 적재 작업의 우선순위입니다. |
형식 속성
| 매개변수 이름 | 유형 | 기본값 | 설명 |
|---|---|---|---|
skip_lines | Integer | 0 | CSV 파일 시작 부분에서 지정된 수의 줄을 건너뜁니다. 형식이 csv_with_names 또는 csv_with_names_and_types인 경우에는 적용되지 않습니다. |
trim_double_quotes | Boolean | false | 필드를 감싸는 큰따옴표 제거 여부입니다. |
enclose | String | "" | 필드에 줄바꿈이나 구분자가 포함되어 있을 때 사용하는 감싸기 문자입니다. 예를 들어 구분자가 ,이고 감싸기 문자가 '이면 'b,c'를 하나의 필드로 파싱합니다. |
escape | String | "" | 감싸기 문자를 이스케이프하는 데 사용하는 이스케이프 문자입니다. 예를 들어 이스케이프 문자가 \이고 감싸기 문자가 '이면 필드 'b,\'c'를 'b,'c'로 올바르게 파싱합니다. |
- 형식 매개변수는 원본 파일의 파싱 방식(예: 구분자 및 따옴표 처리)을 정의합니다. 이 매개변수는
PROPERTIES절에 설정하며, 해당 절은LOAD문 내부에 있어야 합니다. - 데이터 적재 매개변수는 데이터 적재 동작(예: 제한 시간 및 재시도)을 제어합니다. 이 매개변수는 최상위
PROPERTIES블록에 설정하며, 해당 블록은LOAD문 외부에 있어야 합니다.
LOAD LABEL s3_load_example (
    DATA INFILE("s3://bucket/path/file.csv")
    INTO TABLE users
    COLUMNS TERMINATED BY ","
    FORMAT AS "CSV"
    (user_id, name, age)
    PROPERTIES (
        "trim_double_quotes" = "true"  -- Format parameter
    )
)
WITH S3 (
    ...
)
PROPERTIES (
    "timeout" = "3600"  -- Load parameter
);
fe.conf 시스템 수준 구성
다음은 모든 Broker Load 데이터 적재 작업에 적용되는 시스템 수준 구성입니다. 주로 fe.conf를 수정하여 조정합니다.
| 구성 항목 | 유형 | 기본값 | 설명 |
|---|---|---|---|
min_bytes_per_broker_scanner | Long | 67108864 (64 MB) | 단일 BE가 처리하는 최소 데이터 양으로, 단위는 바이트입니다. |
max_bytes_per_broker_scanner | Long | 536870912000 (500 GB) | 단일 BE가 처리하는 최대 데이터 양으로, 단위는 바이트입니다. 단일 데이터 적재 작업이 지원하는 최대 데이터 양은 대략 max_bytes_per_broker_scanner * number of BE nodes입니다. 더 많은 데이터를 처리해야 한다면 이 값을 적절히 늘리세요. |
max_broker_concurrency | Integer | 10 | 단일 작업의 최대 데이터 적재 동시 실행 수입니다. |
default_load_parallelism | Integer | 8 | BE 노드당 최대 동시 실행 인스턴스 수입니다. |
broker_load_default_timeout_second | Integer | 14400 | Broker Load 데이터 적재의 기본 제한 시간으로, 단위는 초입니다. |
데이터 적재 동시 실행 수 계산
최소 처리 데이터 양, 최대 동시 실행 수, 원본 파일 크기, 클러스터의 현재 BE 수가 함께 해당 데이터 적재의 동시 실행 수를 결정합니다.
Concurrency of this import = Math.min(source file size / min_bytes_per_broker_scanner, max_broker_concurrency, number of current BE nodes * load_parallelism)
Amount processed by a single BE for this import = source file size / concurrency of this import
세션 변수
| 세션 변수 | 유형 | 기본값 | 설명 |
|---|---|---|---|
time_zone | String | "Asia/Shanghai" | 기본 시간대입니다. 데이터 적재 중 시간대 관련 함수의 결과에 영향을 줍니다. |
send_batch_parallelism | Integer | 1 | sink 노드가 데이터를 전송할 때의 동시 실행 수입니다. memtable-on-sink가 비활성화된 경우에만 적용됩니다. |
데이터 적재 예제
다음은 Broker Load의 일반적인 사용 시나리오입니다.
시나리오 1: HDFS에서 TXT 파일 적재
LOAD LABEL demo.label_20220402
(
    DATA INFILE("hdfs://host:port/tmp/test_hdfs.txt")
    INTO TABLE `load_hdfs_file_test`
    COLUMNS TERMINATED BY "\t"
    (id,age,name)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
)
PROPERTIES
(
    "timeout"="1200",
    "max_filter_ratio"="0.1"
);
시나리오 2: NameNode HA 구성을 사용하는 HDFS
LOAD LABEL demo.label_20220402
(
    DATA INFILE("hdfs://hafs/tmp/test_hdfs.txt")
    INTO TABLE `load_hdfs_file_test`
    COLUMNS TERMINATED BY "\t"
    (id,age,name)
)
with HDFS
(
    "hadoop.username" = "user",
    "fs.defaultFS"="hdfs://hafs",
    "dfs.nameservices" = "hafs",
    "dfs.ha.namenodes.hafs" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.hafs.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.hafs.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.hafs" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
PROPERTIES
(
    "timeout"="1200",
    "max_filter_ratio"="0.1"
);
시나리오 3: 와일드카드로 두 파일 묶음을 찾아 두 테이블에 적재
Broker Load는 파일 경로에서 와일드카드(*, ?, [...])와 범위 패턴({1..10})을 지원합니다. 전체 구문은 파일 경로 패턴을 참조하세요.
LOAD LABEL example_db.label2
(
    DATA INFILE("hdfs://host:port/input/file-10*")
    INTO TABLE `my_table1`
    PARTITION (p1)
    COLUMNS TERMINATED BY ","
    (k1, tmp_k2, tmp_k3)
    SET (
        k2 = tmp_k2 + 1,
        k3 = tmp_k3 + 1
    ),
    DATA INFILE("hdfs://host:port/input/file-20*")
    INTO TABLE `my_table2`
    COLUMNS TERMINATED BY ","
    (k1, k2, k3)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
와일드카드로 file-10*와 file-20*에 해당하는 두 파일 묶음을 찾아 각각 my_table1과 my_table2에 적재합니다. my_table1의 데이터는 파티션 p1에 적재되며, 원본 파일의 두 번째와 세 번째 컬럼 값은 각각 1씩 증가한 후 적재됩니다.
시나리오 4: 와일드카드로 HDFS에서 데이터 일괄 적재
LOAD LABEL example_db.label3
(
    DATA INFILE("hdfs://host:port/user/doris/data/*/*")
    INTO TABLE `my_table`
    COLUMNS TERMINATED BY "\\x01"
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
구분자를 Hive에서 일반적으로 사용하는 기본 구분자인 \\x01로 지정하고, 와일드카드 *를 사용하여 data 디렉터리 아래의 모든 하위 디렉터리에 있는 파일을 지정합니다.
시나리오 5: Parquet 형식 데이터 적재
LOAD LABEL example_db.label4
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    FORMAT AS "parquet"
    (k1, k2, k3)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
FORMAT AS를 지정하지 않으면 기본적으로 파일 확장자에 따라 형식이 결정됩니다.
시나리오 6: 파일 경로에서 파티션 필드 추출
LOAD LABEL example_db.label5
(
    DATA INFILE("hdfs://host:port/input/city=beijing/*/*")
    INTO TABLE `my_table`
    FORMAT AS "csv"
    (k1, k2, k3)
    COLUMNS FROM PATH AS (city, utc_date)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
my_table의 컬럼은 k1, k2, k3, city, utc_date입니다.
디렉터리 hdfs://hdfs_host:hdfs_port/user/doris/data/input/dir/city=beijing에는 다음 파일이 있습니다.
hdfs://hdfs_host:hdfs_port/input/city=beijing/utc_date=2020-10-01/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=beijing/utc_date=2020-10-02/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=tianji/utc_date=2020-10-03/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=tianji/utc_date=2020-10-04/0000.csv
파일에는 세 컬럼 k1, k2, k3만 들어 있습니다. 나머지 두 컬럼인 city와 utc_date는 파일 경로에서 추출합니다.
시나리오 7: 적재할 데이터 필터링
LOAD LABEL example_db.label6
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    (k1, k2, k3)
    SET (
        k2 = k2 + 1
    )
    PRECEDING FILTER k1 = 1
    WHERE k1 > k2
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
원본 데이터에서 k1 = 1이고 변환 후 k1 > k2인 행만 적재합니다.
시나리오 8: 파일 경로에서 시간 파티션 필드 추출
LOAD LABEL example_db.label7
(
    DATA INFILE("hdfs://host:port/user/data/*/test.txt")
    INTO TABLE `tbl12`
    COLUMNS TERMINATED BY ","
    (k2,k3)
    COLUMNS FROM PATH AS (data_time)
    SET (
        data_time=str_to_date(data_time, '%Y-%m-%d %H%%3A%i%%3A%s')
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
시간에 %3A가 포함되어 있습니다. HDFS 경로에는 :를 사용할 수 없으므로 모든 : 문자를 %3A로 바꿉니다.
해당 경로에는 다음 파일이 있습니다.
/user/data/data_time=2020-02-17 00%3A00%3A00/test.txt
/user/data/data_time=2020-02-18 00%3A00%3A00/test.txt
테이블 스키마:
CREATE TABLE IF NOT EXISTS tbl12 (
    data_time DATETIME,
    k2        INT,
    k3        INT
) DISTRIBUTED BY HASH(data_time) BUCKETS 10
PROPERTIES (
    "replication_num" = "3"
);
시나리오 9: Merge를 사용한 데이터 적재
LOAD LABEL example_db.label8
(
    MERGE DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    (k1, k2, k3, v2, v1)
    DELETE ON v2 > 100
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
)
PROPERTIES
(
    "timeout" = "3600",
    "max_filter_ratio" = "0.1"
);
my_table은 Unique Key 테이블이어야 합니다. 적재할 데이터에서 v2 > 100이면 해당 행을 삭제로 처리합니다. 데이터 적재 제한 시간은 3600초이며, 허용되는 오류 비율은 10%입니다.
시나리오 10: source_sequence 컬럼을 지정하여 대체 순서 보장
LOAD LABEL example_db.label9
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    COLUMNS TERMINATED BY ","
    (k1,k2,source_sequence,v1,v2)
    ORDER BY source_sequence
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
my_table은 Sequence 컬럼이 지정된 Unique Key 모델 테이블이어야 합니다. 데이터 순서는 원본 데이터의 source_sequence 컬럼 값으로 보장됩니다.
시나리오 11: json_root / jsonpaths를 사용한 JSON 데이터 적재
LOAD LABEL example_db.label10
(
    DATA INFILE("hdfs://host:port/input/file.json")
    INTO TABLE `my_table`
    FORMAT AS "json"
    PROPERTIES(
      "json_root" = "$.item",
      "jsonpaths" = "[\"$.id\", \"$.city\", \"$.code\"]"
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
jsonpaths는 column list 및 SET (column_mapping)과 함께 사용할 수도 있습니다.
LOAD LABEL example_db.label10
(
    DATA INFILE("hdfs://host:port/input/file.json")
    INTO TABLE `my_table`
    FORMAT AS "json"
    (id, code, city)
    SET (id = id * 10)
    PROPERTIES(
      "json_root" = "$.item",
      "jsonpaths" = "[\"$.id\", \"$.city\", \"$.code\"]"
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
JSON 파일의 루트 노드에 있는 JSON 객체를 적재하려면 jsonpaths를 $.로 설정합니다. 즉, PROPERTIES("jsonpaths"="$.")로 설정합니다.
고급 구성
S3 Load URL 접근 방식
S3 SDK는 기본적으로 virtual-hosted-style 접근 방식을 사용합니다. 그러나 일부 객체 스토리지 시스템은 virtual-hosted-style을 활성화하지 않았거나 지원하지 않습니다. use_path_style 매개변수를 추가하면 path-style을 강제로 사용할 수 있습니다.
WITH S3
(
    "AWS_ENDPOINT" = "AWS_ENDPOINT",
    "AWS_ACCESS_KEY" = "AWS_ACCESS_KEY",
    "AWS_SECRET_KEY"="AWS_SECRET_KEY",
    "AWS_REGION" = "AWS_REGION",
    "use_path_style" = "true"
)
S3 Load 임시 자격 증명
S3 프로토콜을 지원하는 모든 객체 스토리지에 접근할 때 임시 자격 증명(TOKEN)을 사용할 수 있습니다.
WITH S3
(
    "AWS_ENDPOINT" = "AWS_ENDPOINT",
    "AWS_ACCESS_KEY" = "AWS_TEMP_ACCESS_KEY",
    "AWS_SECRET_KEY" = "AWS_TEMP_SECRET_KEY",
    "AWS_TOKEN" = "AWS_TEMP_TOKEN",
    "AWS_REGION" = "AWS_REGION"
)
HDFS 인증
1. Simple 인증
Simple 인증은 Hadoop 구성 hadoop.security.authentication을 simple로 설정하는 방식입니다.
(
    "username" = "user",
    "password" = ""
);
username을 접근에 사용할 사용자로 설정하고 비밀번호는 비워 둡니다.
2. Kerberos 인증
이 인증 방식에는 다음 정보가 필요합니다.
| 매개변수 | 설명 |
|---|---|
hadoop.security.authentication | 인증 방식을 kerberos로 지정합니다. |
hadoop.kerberos.principal | Kerberos principal을 지정합니다. |
hadoop.kerberos.keytab | Kerberos keytab 파일의 경로를 지정합니다. Broker 프로세스가 있는 서버의 절대 경로여야 하며, Broker 프로세스가 이 파일에 접근할 수 있어야 합니다. |
kerberos_keytab_content | keytab 파일의 base64 인코딩된 내용을 지정합니다. 이 매개변수와 hadoop.kerberos.keytab 중 하나를 사용합니다. |
예제:
(
    "hadoop.security.authentication" = "kerberos",
    "hadoop.kerberos.principal" = "doris@YOUR.COM",
    "hadoop.kerberos.keytab" = "/home/doris/my.keytab"
)
(
    "hadoop.security.authentication" = "kerberos",
    "hadoop.kerberos.principal" = "doris@YOUR.COM",
    "kerberos_keytab_content" = "ASDOWHDLAWIDJHWLDKSALDJSDIWALD"
)
Kerberos 인증을 사용하려면 krb5.conf 파일이 필요합니다. 이 파일에는 Kerberos 구성 정보가 포함되며, 일반적으로 /etc 디렉터리에 설치됩니다. KRB5_CONFIG 환경 변수로 기본 위치를 재정의할 수도 있습니다. 다음은 krb5.conf 내용의 예입니다.
[libdefaults]
    default_realm = DORIS.HADOOP
    default_tkt_enctypes = des3-hmac-sha1 des-cbc-crc
    default_tgs_enctypes = des3-hmac-sha1 des-cbc-crc
    dns_lookup_kdc = true
    dns_lookup_realm = false

[realms]
    DORIS.HADOOP = {
        kdc = kerberos-doris.hadoop.service:7005
    }
HDFS HA 모드
이 구성은 HA 모드로 배포된 HDFS 클러스터에 접근하는 데 사용합니다.
| 매개변수 | 설명 |
|---|---|
dfs.nameservices | HDFS 서비스 이름(사용자 정의)을 지정합니다. 예: "dfs.nameservices" = "my_ha". |
dfs.ha.namenodes.xxx | 사용자 정의 NameNode 이름입니다. 여러 이름은 쉼표로 구분합니다. xxx는 dfs.nameservices에 지정한 사용자 정의 이름입니다. 예: "dfs.ha.namenodes.my_ha" = "my_nn". |
dfs.namenode.rpc-address.xxx.nn | NameNode의 RPC 주소를 지정합니다. nn은 dfs.ha.namenodes.xxx에 지정한 NameNode 이름입니다. 예: "dfs.namenode.rpc-address.my_ha.my_nn" = "host:port". |
dfs.client.failover.proxy.provider.[nameservice ID] | 클라이언트가 NameNode에 연결할 때 사용할 provider를 지정합니다. 기본값은 org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider입니다. |
예제:
(
    "fs.defaultFS" = "hdfs://my_ha",
    "dfs.nameservices" = "my_ha",
    "dfs.ha.namenodes.my_ha" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.my_ha.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.my_ha.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.my_ha" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
HA 모드는 위의 두 인증 방식과 함께 사용할 수 있습니다. 예를 들어 Simple 인증으로 HA HDFS에 접근하려면 다음과 같이 설정합니다.
(
    "username"="user",
    "password"="passwd",
    "fs.defaultFS" = "hdfs://my_ha",
    "dfs.nameservices" = "my_ha",
    "dfs.ha.namenodes.my_ha" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.my_ha.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.my_ha.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.my_ha" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
기타 Broker를 통한 데이터 적재
기타 원격 스토리지 시스템용 Broker는 Doris 클러스터의 선택적 프로세스입니다. 주로 원격 스토리지의 파일과 디렉터리에 대한 읽기 및 쓰기를 지원하는 데 사용합니다. Doris는 현재 다음 원격 스토리지 시스템을 위한 Broker 구현을 제공합니다.
- Tencent Cloud CHDFS
- Tencent Cloud GFS
- JuiceFS
이전 버전에서는 다양한 객체 스토리지 시스템용 Broker도 지원했지만, 현재는 객체 스토리지에서 데이터를 적재할 때 WITH S3 사용을 권장합니다. WITH BROKER는 더 이상 권장하지 않습니다.
Broker는 RPC 서비스 포트를 통해 서비스를 제공하는 상태 비저장 Java 프로세스입니다. 원격 스토리지의 읽기 및 쓰기 작업을 위해 POSIX와 유사한 파일 연산(예: open, pread, pwrite)을 캡슐화합니다. Broker는 그 외의 정보를 기록하지 않습니다. 원격 스토리지의 연결 정보, 파일 정보, 권한 정보 등 필요한 모든 정보는 RPC 호출의 매개변수로 전달해야 합니다.
Broker는 데이터 전달 경로 역할만 하며 연산에는 참여하지 않으므로 메모리 사용량이 적습니다. 일반적으로 Doris 시스템에는 하나 이상의 Broker 프로세스를 배포합니다. 같은 유형의 Broker는 이름(Broker 이름)이 지정된 그룹을 구성합니다.
Broker 정보
Broker 정보는 이름과 인증 정보로 구성됩니다. 일반적인 구문은 다음과 같습니다.
WITH BROKER "broker_name"
(
    "username" = "xxx",
    "password" = "yyy",
    "other_prop" = "prop_value",
    ...
);
이름(Broker 이름)
WITH BROKER "broker_name" 절로 기존 Broker 이름을 지정합니다. Broker 이름은 사용자가 ALTER SYSTEM ADD BROKER 명령으로 Broker 프로세스를 추가할 때 지정한 이름입니다. 일반적으로 하나의 이름은 하나 이상의 Broker 프로세스에 대응하며, Doris는 이 이름을 기준으로 사용 가능한 Broker 프로세스를 선택합니다. 클러스터에 있는 Broker는 SHOW BROKER로 확인할 수 있습니다.
Broker 이름은 사용자가 정의한 이름일 뿐, Broker 유형을 나타내지는 않습니다.
인증 정보
Broker 유형과 접근 방식에 따라 필요한 인증 정보가 다릅니다. 인증 정보는 일반적으로 WITH BROKER "broker_name" 뒤의 속성 맵에 키-값 쌍으로 제공합니다.
Broker별 연결 구성
Alibaba Cloud OSS
(
    "fs.oss.accessKeyId" = "",
    "fs.oss.accessKeySecret" = "",
    "fs.oss.endpoint" = ""
)
Baidu Cloud BOS
BOS를 사용할 때는 해당 SDK 패키지를 다운로드해야 합니다. 구체적인 구성 및 사용 방법은 BOS HDFS 공식 문서를 참조하세요. 다운로드하고 압축을 푼 후 JAR 패키지를 Broker의 lib 디렉터리에 넣습니다.
(
    "fs.bos.access.key" = "xx",
    "fs.bos.secret.access.key" = "xx",
    "fs.bos.endpoint" = "xx"
)
Huawei Cloud OBS
(
    "fs.obs.access.key" = "xx",
    "fs.obs.secret.key" = "xx",
    "fs.obs.endpoint" = "xx"
)
JuiceFS
(
    "fs.defaultFS" = "jfs://xxx/",
    "fs.jfs.impl" = "io.juicefs.JuiceFileSystem",
    "fs.AbstractFileSystem.jfs.impl" = "io.juicefs.JuiceFS",
    "juicefs.meta" = "xxx",
    "juicefs.access-log" = "xxx"
)
GCS
Broker를 통해 GCS에 접근하려면 Project ID가 필요합니다. 다른 매개변수는 선택 사항입니다. 전체 매개변수 구성은 GCS 구성을 참조하세요.
(
    "fs.gs.project.id" = "Your Project ID",
    "fs.AbstractFileSystem.gs.impl" = "com.google.cloud.hadoop.fs.gcs.GoogleHadoopFS",
    "fs.gs.impl" = "com.google.cloud.hadoop.fs.gcs.GoogleHadoopFileSystem",
)
자주 묻는 질문 및 문제 해결
일반적인 오류
1. 데이터 적재 오류: Scan bytes per broker scanner exceed limit:xxx
"데이터 적재 시간 초과" 절을 참조하세요. FE 구성 항목 max_bytes_per_broker_scanner와 max_broker_concurrency를 수정합니다.
2. 데이터 적재 오류: failed to send batch 또는 TabletWriter add batch with unknown id
query_timeout과 streaming_load_rpc_max_alive_time_sec를 적절히 조정합니다.
3. 데이터 적재 오류: LOAD_RUN_FAIL; msg:Invalid Column Name:xxx
PARQUET 또는 ORC 데이터의 경우 파일 헤더의 컬럼 이름이 Doris 테이블의 컬럼 이름과 일치해야 합니다. 예를 들면 다음과 같습니다.
(tmp_c1,tmp_c2)
SET
(
    id=tmp_c2,
    name=tmp_c1
)
이는 Parquet 또는 ORC 파일에서 이름이 (tmp_c1, tmp_c2)인 컬럼을 가져와 Doris 테이블의 (id, name) 컬럼에 매핑한다는 뜻입니다. SET을 지정하지 않으면 column의 컬럼을 매핑에 사용합니다.
참고: 일부 Hive 버전에서 직접 생성한 ORC 파일의 헤더는 Hive 메타데이터가 아니라
(_col0, _col1, _col2, ...)이므로Invalid Column Name오류가 발생할 수 있습니다. 이 경우SET으로 매핑하세요.
4. 데이터 적재 오류: Failed to get S3 FileSystem for bucket is null/empty
버킷 정보가 잘못되었거나 존재하지 않거나, 버킷 형식이 지원되지 않는 경우입니다. 예를 들어 GCS에서 _가 포함된 버킷 이름(예: s3://gs_bucket/load_tbl)을 생성하면 S3 클라이언트가 GCS에 접근할 때 오류를 반환합니다. 버킷 경로를 생성할 때는 _를 사용하지 않는 것이 좋습니다.
5. 데이터 적재 시간 초과
데이터 적재의 기본 timeout은 4시간입니다. 시간 초과가 발생하더라도 최대 제한 시간을 바로 늘리는 것은 권장하지 않습니다. 단일 데이터 적재가 4시간을 초과하면 적재할 파일을 나누어 여러 배치로 적재하는 것이 좋습니다. 제한 시간을 지나치게 길게 설정하면 한 번의 실패 후 재시도하는 비용이 매우 커지기 때문입니다.
다음 공식으로 Doris 클러스터가 한 번의 데이터 적재에서 처리할 수 있는 최대 예상 데이터 양을 추정할 수 있습니다.
Expected maximum import file data volume = 14400s * 10M/s * number of BEs

For example, if the number of BEs in the cluster is 10:
Expected maximum import file data volume = 14400s * 10M/s * 10 = 1440000M ≈ 1440G

Note: A typical user environment may not reach 10M/s, so it is recommended to split files larger than 500G before importing.
추가 도움말
Broker Load의 자세한 구문과 권장 사용법은 Broker Load 명령 매뉴얼을 참조하세요. MySQL 클라이언트 명령줄에서 HELP BROKER LOAD를 실행하여 추가 도움말을 확인할 수도 있습니다.