Stream Load
Stream Load는 HTTP를 통해 로컬 파일이나 데이터 스트림을 Doris로 적재할 수 있습니다. Stream Load는 동기식 데이터 적재 방식으로, 실행이 끝나면 적재 결과를 반환하므로 응답을 통해 적재 성공 여부를 확인할 수 있습니다. 일반적으로 Stream Load는 10 GB 미만의 파일을 적재하는 데 사용할 수 있습니다. 더 큰 파일은 먼저 분할한 다음 각 부분을 Stream Load로 적재하세요. Stream Load는 한 배치의 적재 작업에 대해 원자성을 보장합니다. 즉, 모든 행이 성공적으로 적재되거나 아무 행도 적재되지 않습니다.
curl을 직접 사용하는 단일 동시 실행 적재보다 전용 데이터 적재 도구인 Doris Streamloader를 사용하는 것이 좋습니다. Doris Streamloader는 Doris로 데이터를 적재하기 위한 전용 클라이언트 도구로, 여러 적재 작업을 동시에 실행하여 대용량 데이터 적재 시간을 줄일 수 있습니다. 사용법과 실무 활용에 관한 자세한 내용은 Doris Streamloader 문서를 참조하세요.
사용 사례
Stream Load는 다음과 같은 일반적인 시나리오에 적합합니다.
- 로컬 또는 원격 CSV, JSON, Parquet, ORC 파일을 Doris로 적재하는 경우.
- 프로그램(Java, Go, Python 등)에서 HTTP 스트림을 통해 데이터를 지속적으로 쓰는 경우.
- 단일 적재 작업의 원자성이 필요한 경우(모든 행이 성공하거나 모두 실패).
- 일반적으로 크기가 10 GB 미만인 단일 파일을 적재하는 경우. 더 큰 파일은 적재 전에 분할하거나 Doris Streamloader를 사용하세요.
CSV 파일을 적재할 때는 null 값과 빈 문자열을 명확히 구분하세요.
- null 값(null):
\N으로 표현합니다. 예를 들어a,\N,b는 가운데 열이 null임을 의미합니다. - 빈 문자열: 두 구분자 사이에 문자가 없으면 빈 문자열입니다. 예를 들어
a,,b에서는 두 쉼표 사이에 문자가 없으므로 가운데 열이 빈 문자열입니다.
기본 원리
Stream Load를 사용하면 HTTP를 통해 FE 노드에 적재 작업을 요청합니다. FE는 부하 분산을 위해 라운드 로빈 방식으로 BE 노드에 요청을 리디렉션합니다. 특정 BE 노드로 HTTP 요청을 직접 보낼 수도 있습니다. Stream Load에서 Doris는 한 노드를 Coordinator로 지정합니다. Coordinator 노드는 데이터를 수신하고 다른 노드로 분배하는 역할을 합니다.
다음 그림은 Stream Load의 주요 흐름을 보여 줍니다.
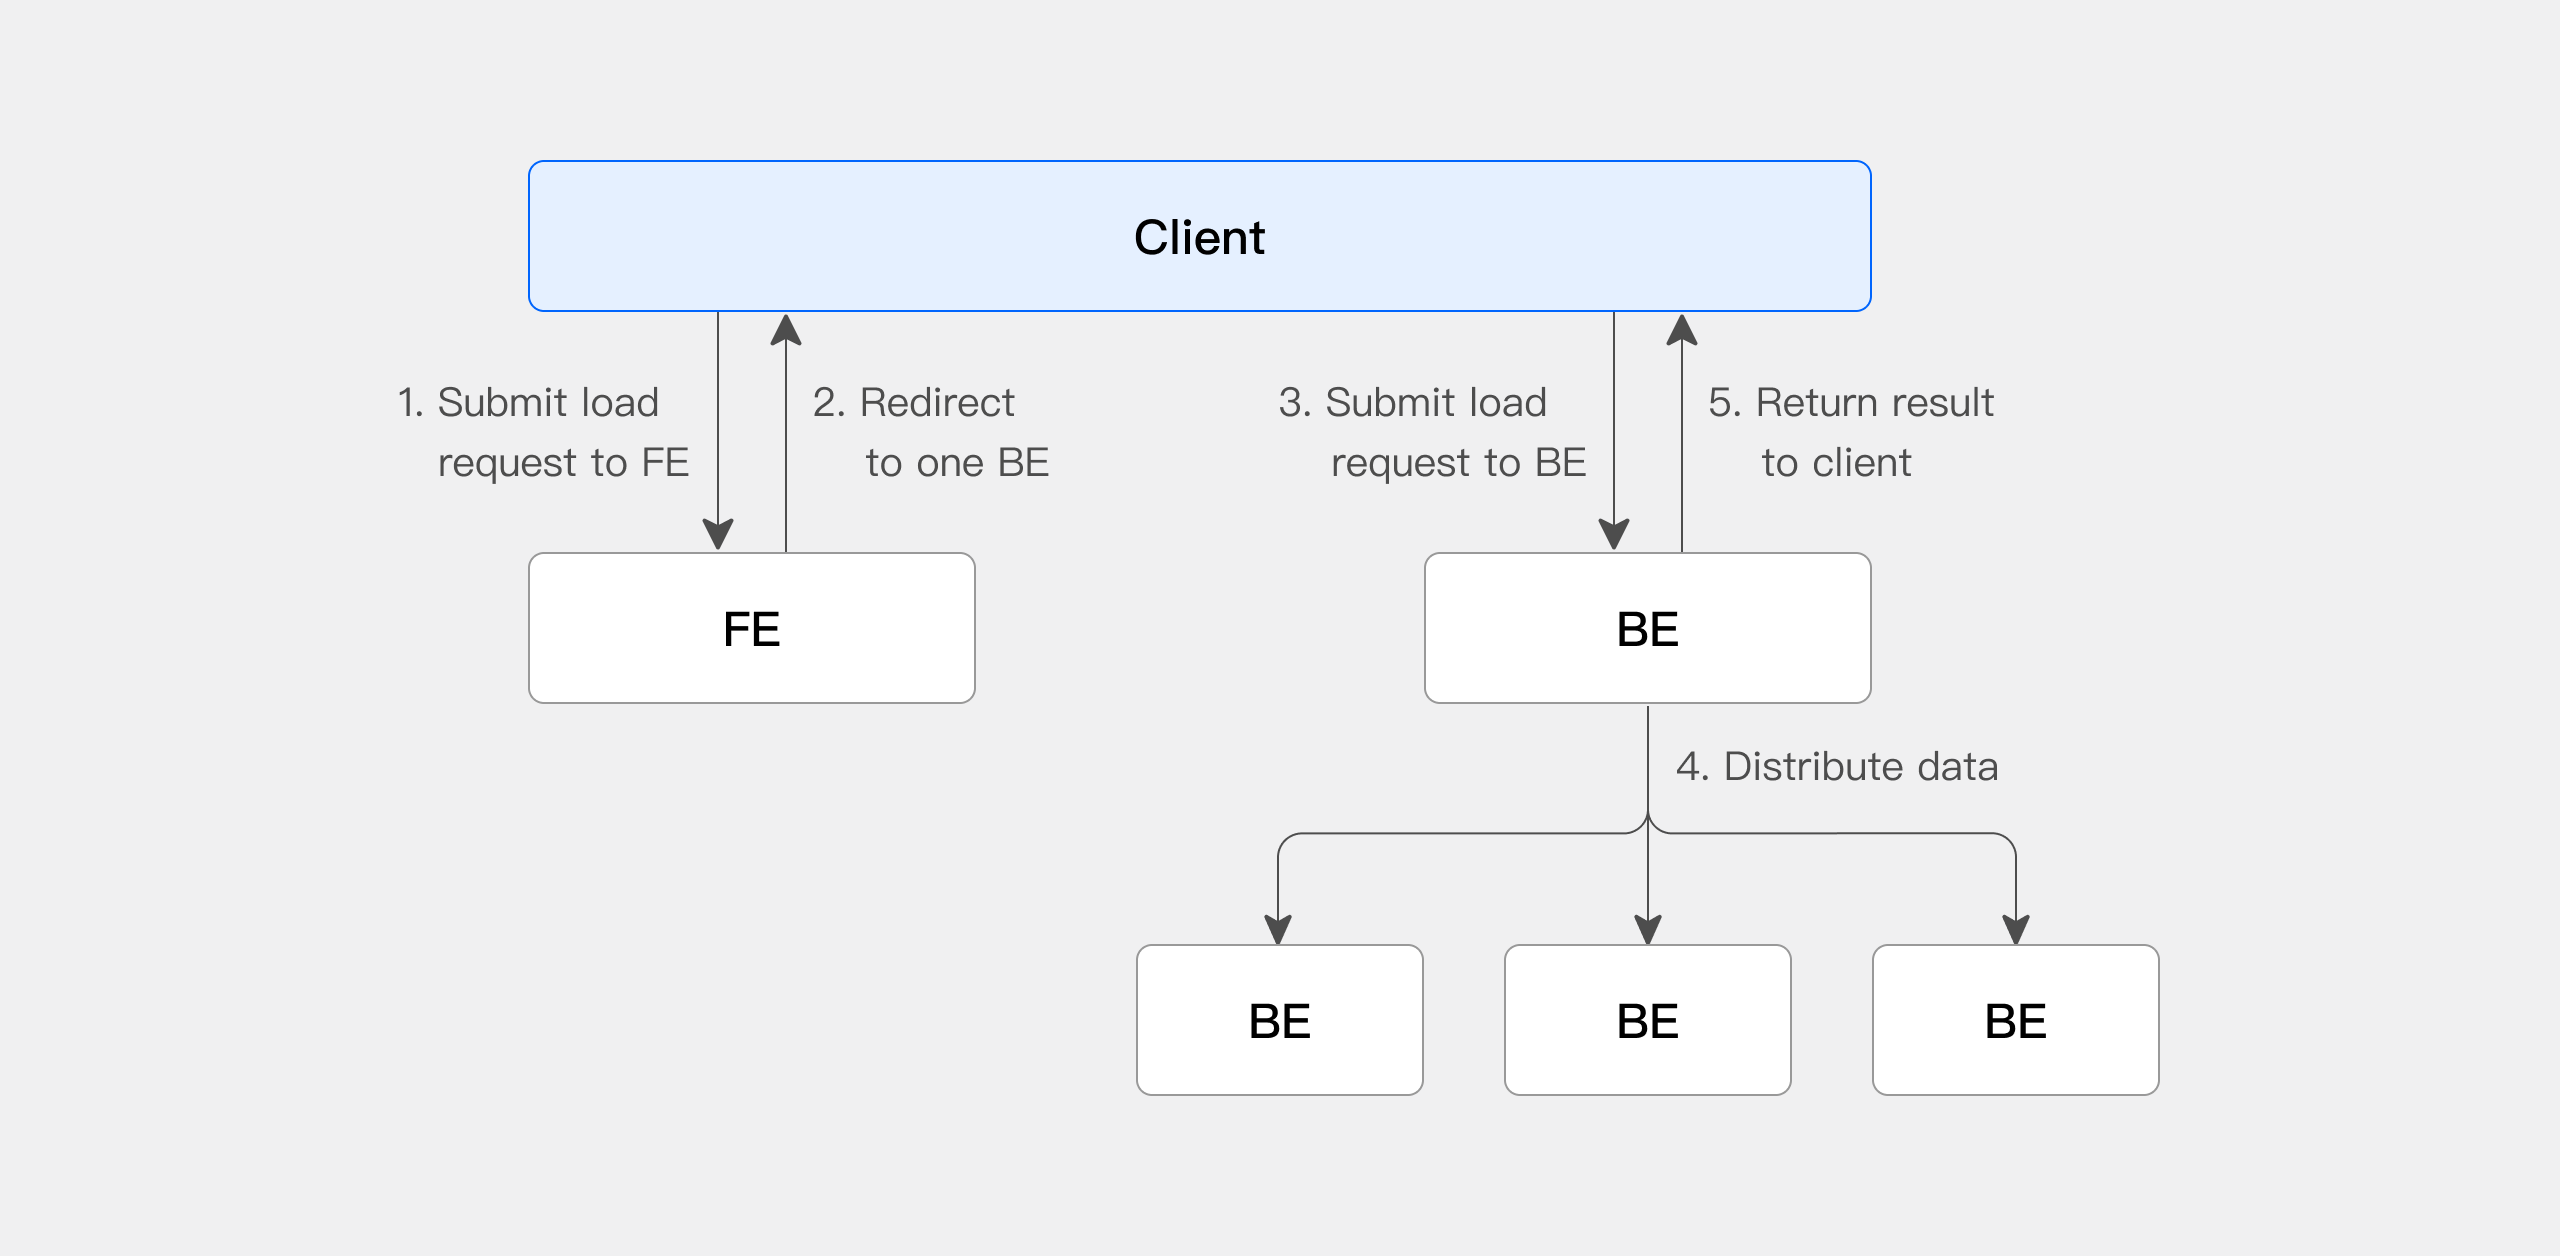
실행 흐름은 다음과 같습니다.
- Client가 FE에 Stream Load 적재 작업 요청을 제출합니다.
- FE는 라운드 로빈 순서로 BE를 선택하여 적재 작업의 스케줄링을 담당하는 Coordinator 노드로 지정하고, Client에 HTTP 리디렉션을 반환합니다.
- Client가 Coordinator BE 노드에 연결하여 적재 요청을 제출합니다.
- Coordinator BE가 해당 BE 노드들에 데이터를 분배합니다. 적재가 완료되면 Client에 적재 결과를 반환합니다.
- Client가 BE 노드를 Coordinator로 직접 지정하여 적재 작업을 분배하도록 할 수도 있습니다.
빠른 시작
Stream Load는 HTTP를 통해 요청을 제출하고 데이터를 전송합니다. 다음 예제에서는 curl 도구를 사용하여 Stream Load로 적재 작업을 제출하는 방법을 보여 줍니다.
사전 요구 사항
Stream Load를 사용하려면 대상 테이블에 대한 INSERT 권한이 필요합니다. 사용자에게 INSERT 권한이 없으면 GRANT 명령으로 부여하세요.
적재 작업 생성
CSV 데이터 적재
-
적재할 데이터 생성
다음 내용으로 CSV 파일
streamload_example.csv를 생성합니다.1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64 -
대상 Doris 테이블 생성
다음 구문으로 Doris에 데이터를 적재할 테이블을 생성합니다.
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
적재 작업 시작
curl명령으로 Stream Load 적재 작업을 제출할 수 있습니다.curl --location-trusted -u <doris_user>:<doris_password> \
-H "Expect:100-continue" \
-H "column_separator:," \
-H "columns:user_id,name,age" \
-T streamload_example.csv \
-XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_loadStream Load는 동기식 데이터 적재 방식이며, 적재 결과를 사용자에게 직접 반환합니다.
{
    "TxnId": 3,
    "Label": "123",
    "Comment": "",
    "TwoPhaseCommit": "false",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 10,
    "NumberLoadedRows": 10,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 118,
    "LoadTimeMs": 173,
    "BeginTxnTimeMs": 1,
    "StreamLoadPutTimeMs": 70,
    "ReadDataTimeMs": 2,
    "WriteDataTimeMs": 48,
    "CommitAndPublishTimeMs": 52
} -
적재된 데이터 확인
mysql> select count(*) from testdb.test_streamload;
+----------+
| count(*) |
+----------+
|       10 |
+----------+
JSON 데이터 적재
-
적재할 데이터 생성
다음 내용으로 JSON 파일
streamload_example.json을 생성합니다.[
{"userid":1,"username":"Emily","userage":25},
{"userid":2,"username":"Benjamin","userage":35},
{"userid":3,"username":"Olivia","userage":28},
{"userid":4,"username":"Alexander","userage":60},
{"userid":5,"username":"Ava","userage":17},
{"userid":6,"username":"William","userage":69},
{"userid":7,"username":"Sophia","userage":32},
{"userid":8,"username":"James","userage":64},
{"userid":9,"username":"Emma","userage":37},
{"userid":10,"username":"Liam","userage":64}
] -
대상 Doris 테이블 생성
다음 구문으로 Doris에 데이터를 적재할 테이블을 생성합니다.
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
적재 작업 시작
curl명령으로 Stream Load 적재 작업을 제출할 수 있습니다.curl --location-trusted -u <doris_user>:<doris_password> \
-H "label:124" \
-H "Expect:100-continue" \
-H "format:json" -H "strip_outer_array:true" \
-H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
-H "columns:user_id,name,age" \
-T streamload_example.json \
-XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load참고JSON 파일의 내용이 JSON 배열이 아니라 줄마다 하나의 JSON 객체로 구성되어 있으면 헤더
-H "strip_outer_array:false"와-H "read_json_by_line:true"를 추가하세요. JSON 파일의 루트 노드에 있는 JSON 객체를 적재하려면jsonpaths를$.로 설정하세요. 예:-H "jsonpaths:[\"$.\"]".Stream Load는 동기식 데이터 적재 방식이며, 적재 결과를 사용자에게 직접 반환합니다.
{
    "TxnId": 7,
    "Label": "125",
    "Comment": "",
    "TwoPhaseCommit": "false",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 10,
    "NumberLoadedRows": 10,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 471,
    "LoadTimeMs": 52,
    "BeginTxnTimeMs": 0,
    "StreamLoadPutTimeMs": 11,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 23,
    "CommitAndPublishTimeMs": 16
}
적재 작업 조회
기본적으로 Stream Load는 결과를 Client에 동기식으로 반환하므로 시스템에서 Stream Load 작업 이력을 기록하지 않습니다. 기록을 활성화하려면 enable_stream_load_record=true 설정을 be.conf에 추가하세요. 자세한 내용은 BE 설정을 참조하세요.
설정을 완료하면 show stream load 명령으로 완료된 Stream Load 작업을 조회할 수 있습니다.
mysql> show stream load from testdb;
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
| Label | Db     | Table           | ClientIp      | Status  | Message | Url  | TotalRows | LoadedRows | FilteredRows | UnselectedRows | LoadBytes | StartTime               | FinishTime              | User | Comment |
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
| 12356 | testdb | test_streamload | 192.168.88.31 | Success | OK      | N/A  | 10        | 10         | 0            | 0              | 118       | 2023-11-29 08:53:00.594 | 2023-11-29 08:53:00.650 | root |         |
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
1 row in set (0.00 sec)
적재 작업 취소
사용자는 Stream Load를 수동으로 취소할 수 없습니다. Stream Load는 시간 초과가 발생하거나 적재 오류가 발생하면 시스템에서 자동으로 취소합니다.
Compute Group 바인딩
Stream Load를 실행할 Compute Group을 지정할 수 있습니다.
스토리지와 컴퓨팅 분리 모드
스토리지와 컴퓨팅 분리 모드에서는 다음과 같이 Compute Group을 지정할 수 있습니다.
-
HTTP Header 매개변수로 지정합니다.
-H "cloud_cluster:cluster1"Doris 4.0.0부터는
compute_group매개변수도 사용할 수 있습니다.-H "compute_group:cluster1"compute_group과cloud_cluster를 모두 설정하면compute_group이 우선 적용됩니다. -
Stream Load에 바인딩된 사용자의 속성에서 Compute Group을 지정합니다. 사용자 속성과 HTTP Header에 모두 Compute Group을 지정하면 Header에 지정한 값이 우선 적용됩니다.
set property for user1 'default_compute_group'='cluster1'; -
사용자 속성과 HTTP Header에 모두 Compute Group을 지정하지 않으면 Stream Load에 바인딩된 사용자가 접근할 수 있는 Compute Group 중 하나를 선택합니다. 사용자가 접근할 수 있는 Compute Group이 없으면 적재가 실패합니다.
Doris 4.0 계열의 4.0.8 이상 버전과 Doris 4.1 계열의 4.1.4 이상 버전에서는 컴퓨팅과 스토리지 분리 모드에서 Stream Load의 Compute Group 라우팅과 실행 계획 간 불일치가 수정되었습니다.
compute_group헤더가cloud_cluster보다 우선 적용됩니다. 이전에는 FE가cloud_cluster만 인식했습니다.- 실행 계획을 생성할 때 요청을 실제로 수신하는 BE의 Compute Group을 사용하므로, 계획이 실제 실행되는 Compute Group과 다른 Compute Group에 배치되는 일이 없습니다.
- 이 처리 경로에서는 적재 계정의 대상 Compute Group 접근 권한, Compute Group의 존재 여부 및 상태도 검증합니다. 따라서 적재 계정에 요청을 실제로 처리하는 Compute Group에 대한 접근 권한이 없으면 업그레이드 후 권한 오류로 적재가 실패하며, 해당 계정에 필요한 권한을 부여해야 합니다.
4.1.4 버전부터 BE의 Stream Load 엔드포인트(PUT /api/{db}/{table}/_stream_load, PUT /api/_http_stream, PUT /api/{db}/_stream_load_2pc)는 전역 LOAD 권한을 사전 검사하지 않습니다. 권한 검증은 실제로 데이터를 쓰는 데이터베이스와 테이블을 대상으로 FE에서 일관되게 처리합니다.
이에 따라 데이터베이스 또는 테이블 수준의 LOAD_PRIV만 보유한 계정도 전역 LOAD 권한 없이 Stream Load와 2PC 커밋 / 중단을 실행할 수 있습니다.
스토리지와 컴퓨팅 통합 모드
스토리지와 컴퓨팅 통합 모드에서는 Stream Load에 바인딩된 사용자의 속성으로만 Compute Group을 지정할 수 있습니다. 사용자 속성에 Compute Group을 지정하지 않으면 이름이 default인 Compute Group이 선택됩니다.
set property for user1 'resource_tags.location'='group_1';
참조
적재 명령
Stream Load의 적재 구문은 다음과 같습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
  -H "Expect:100-continue" [-H ""...] \
  -T <file_path> \
  -XPUT http://fe_host:http_port/api/{db}/{table}/_stream_load
Stream Load는 HTTP 청크 방식과 비청크 방식의 데이터 적재를 모두 지원합니다. 비청크 방식으로 적재할 때는 업로드할 콘텐츠의 길이를 나타내는 Content-Length를 지정해야 하며, 이를 통해 데이터의 무결성을 보장합니다.
적재 설정 매개변수
FE 설정
1. stream_load_default_timeout_second
| 항목 | 설명 |
|---|---|
| 기본값 | 259200 (s) |
| 동적 설정 | 예 |
| FE Master 전용 설정 | 예 |
설명: Stream Load의 기본 시간 제한입니다. 적재 작업의 시간 제한을 초 단위로 지정합니다. 적재 작업이 설정된 timeout 내에 완료되지 않으면 시스템에서 작업을 취소하고 작업 상태가 CANCELLED로 변경됩니다. 지정된 시간 내에 원본 파일을 적재할 수 없으면 Stream Load 요청에 별도의 시간 제한을 설정하거나, FE 매개변수 stream_load_default_timeout_second를 조정하여 전역 기본 시간 제한을 설정할 수 있습니다.
BE 설정
1. streaming_load_max_mb
| 항목 | 설명 |
|---|---|
| 기본값 | 10240 (MB) |
| 동적 설정 | 예 |
설명: Stream Load의 최대 적재 크기입니다. 사용자의 원본 파일이 이 값을 초과하면 BE 매개변수 streaming_load_max_mb를 조정하세요.
Header 매개변수
적재 매개변수는 HTTP Header를 통해 전달할 수 있습니다. 각 매개변수는 다음과 같습니다.
| 태그 | 매개변수 설명 |
|---|---|
| label | 이번 적재의 레이블을 지정합니다. 같은 레이블의 데이터는 한 번만 적재할 수 있습니다. 레이블을 지정하지 않으면 Doris가 자동으로 생성합니다. 레이블을 지정하면 같은 데이터의 중복 적재를 방지할 수 있습니다. 기본적으로 Doris는 적재 작업 레이블을 사흘 동안 보관하며, label_keep_max_second로 보관 기간을 조정할 수 있습니다. 예를 들어 이번 적재의 레이블을 123으로 지정하려면 -H "label:123" 명령을 사용합니다. 레이블을 사용하면 같은 데이터의 중복 적재를 방지할 수 있습니다. 같은 데이터 배치에는 항상 같은 레이블을 사용하는 것이 좋습니다. 이렇게 하면 같은 배치에 대한 중복 요청이 한 번만 수락되어 At-Most-Once 의미 체계를 보장합니다. 특정 레이블의 적재 작업이 CANCELLED 상태이면 해당 레이블을 다시 사용할 수 있습니다. |
| column_separator | 적재 파일의 열 구분자를 지정합니다. 기본값은 \t입니다. 보이지 않는 문자는 \x를 접두사로 사용하고 구분자를 십육진수로 표현합니다. 여러 문자의 조합을 열 구분자로 사용할 수도 있습니다. 예를 들어 Hive 파일 구분자 \x01은 -H "column_separator:\x01" 명령으로 지정합니다. |
| line_delimiter | 적재 파일의 줄 구분자를 지정합니다. 기본값은 \n입니다. 여러 문자의 조합을 줄 구분자로 사용할 수도 있습니다. 예를 들어 줄 구분자를 \n으로 지정하려면 -H "line_delimiter:\n" 명령을 사용합니다. |
| columns | 적재 파일의 열과 테이블의 열 간 매핑을 지정합니다. 원본 파일의 열이 테이블의 열과 정확히 일치하면 이 필드를 지정하지 않아도 됩니다. 원본 파일이 테이블 스키마와 일치하지 않으면 일부 데이터 변환에 이 필드가 필요합니다. 열은 두 가지 형태로 지정할 수 있습니다. 적재 파일의 필드에 직접 대응하는 경우 필드 이름을 그대로 사용하고, 파생 열을 나타내는 경우 column_name = expression 구문을 사용합니다. 자세한 예제는 적재 중 데이터 변환을 참조하세요. |
| where | 데이터의 일부를 추출하는 데 사용합니다. 불필요한 데이터를 필터링하려면 이 옵션을 사용하세요. 예를 들어 k1 열이 20180601인 데이터만 적재하려면 적재 시 -H "where: k1 = 20180601"을 지정합니다. |
| max_filter_ratio | 형식이 올바르지 않은 데이터 등의 이유로 필터링되어 제외되는 데이터의 최대 허용 비율입니다. 기본적으로 오류를 허용하지 않습니다. 값의 범위는 0부터 1까지입니다. 적재 오류 비율이 이 값을 초과하면 적재가 실패합니다. where 조건으로 필터링되어 제외된 행은 잘못된 형식의 데이터로 집계하지 않습니다. 예를 들어 올바른 데이터를 최대한 모두 적재하려면(100% 허용) -H "max_filter_ratio:1" 명령을 지정합니다. |
| partitions | 이번 적재에 사용할 파티션을 지정합니다. 데이터가 속하는 파티션을 알 수 있으면 이 옵션을 지정하는 것이 좋습니다. 지정된 파티션에 속하지 않는 데이터는 필터링되어 제외됩니다. 예를 들어 p1 및 p2 파티션에 적재하려면 -H "partitions: p1, p2" 명령을 지정합니다. |
| timeout | 적재 시간 제한을 초 단위로 지정합니다. 기본값은 600초입니다. 유효 범위는 1초부터 259200초까지입니다. 예를 들어 적재 시간 제한을 1200 s로 설정하려면 -H "timeout:1200" 명령을 지정합니다. |
| strict_mode | 이번 적재에서 엄격 모드를 활성화할지 지정합니다. 기본적으로 비활성화되어 있습니다. 예를 들어 엄격 모드를 활성화하려면 -H "strict_mode:true" 명령을 지정합니다. |
| timezone | 이번 적재에 사용할 시간대를 지정합니다. 기본값은 클러스터의 현재 시간대입니다. 이 매개변수는 적재에 사용되는 모든 시간대 관련 함수의 결과에 영향을 줍니다. 예를 들어 적재 시간대를 Africa/Abidjan으로 설정하려면 -H "timezone:Africa/Abidjan" 명령을 지정합니다. |
| exec_mem_limit | 적재 메모리 제한입니다. 기본값은 2 GB입니다. 단위는 바이트입니다. |
| format | 이번 적재의 데이터 형식을 지정합니다. 기본값은 CSV입니다. 현재 지원하는 형식은 CSV, JSON, arrow, csv_with_names(CSV 파일의 첫 번째 행을 제외할 수 있음), csv_with_names_and_types(CSV 파일의 처음 두 행을 제외할 수 있음), Parquet, ORC입니다. 예를 들어 적재 데이터 형식을 JSON으로 지정하려면 -H "format:json" 명령을 사용합니다. |
| jsonpaths | JSON 데이터를 적재하는 방식은 두 가지입니다. 단순 모드는 jsonpaths를 지정하지 않을 때 사용하며 JSON 데이터가 객체 타입이어야 합니다. 매칭 모드는 JSON 데이터가 비교적 복잡하고 jsonpaths 매개변수로 해당 값을 매칭해야 할 때 사용합니다. 단순 모드에서는 JSON의 키가 테이블의 열 이름과 일대일로 대응해야 합니다. 예를 들어 JSON 데이터 {"k1":1, "k2":2, "k3":"hello"}에서는 k1, k2, k3가 테이블의 열에 대응해야 합니다. |
| strip_outer_array | strip_outer_array를 true로 설정하면 JSON 데이터가 배열 객체로 시작하며 해당 배열을 펼쳐서 처리합니다. 기본값은 false입니다. JSON 데이터의 최외곽이 []로 표현되는 배열이면 strip_outer_array를 true로 설정하세요. 예를 들어 데이터가 [{"k1" : 1, "v1" : 2},{"k1" : 3, "v1" : 4}]일 때 strip_outer_array를 true로 설정하면 Doris에 적재할 때 두 행이 생성됩니다. |
| json_root | json_root는 JSON 문서의 루트 노드를 지정하는 유효한 jsonpath 문자열입니다. 기본값은 ""입니다. |
| merge_type | 데이터의 병합 유형입니다. 다음 세 가지 유형을 지원합니다. - APPEND(기본값): 이번 배치의 모든 데이터를 기존 데이터에 추가합니다. - DELETE: 이번 배치의 키와 일치하는 모든 행을 삭제합니다. - MERGE: delete 조건과 함께 사용해야 합니다. delete 조건에 일치하는 데이터는 DELETE 의미 체계로 처리하고 나머지는 APPEND 의미 체계로 처리합니다.예를 들어 MERGE 모드는 다음과 같이 지정합니다. -H "merge_type: MERGE" -H "delete: flag=1". |
| delete | MERGE와 함께 사용할 때만 유효하며, 데이터의 삭제 조건을 지정합니다. |
| function_column.sequence_col | UNIQUE KEYS 모델에만 적용됩니다. 키 열이 같은 경우 값 열이 source_sequence 열의 순서대로 REPLACE되도록 보장합니다. source_sequence는 데이터 소스의 열 또는 테이블 스키마의 열일 수 있습니다. |
| fuzzy_parse | Boolean 값입니다. true로 설정하면 첫 번째 행을 스키마로 사용하여 JSON을 파싱합니다. 이 옵션을 활성화하면 JSON 적재 효율이 높아질 수 있지만, 모든 JSON 객체의 키 순서가 첫 번째 행과 같아야 합니다. 기본값은 false입니다. JSON 형식에서만 사용합니다. |
| num_as_string | Boolean 값입니다. true로 설정하면 JSON 데이터를 파싱할 때 숫자 타입을 문자열로 변환하여 정밀도 손실 없이 적재되도록 합니다. |
| read_json_by_line | Boolean 값입니다. true로 설정하면 줄마다 하나의 JSON 객체를 읽을 수 있습니다. 기본값은 false입니다. |
| send_batch_parallelism | Integer 값입니다. 배치 데이터 전송의 병렬도를 설정합니다. 병렬도 값이 BE 설정 max_send_batch_parallelism_per_job을 초과하면 Coordinator 역할의 BE는 max_send_batch_parallelism_per_job 값을 사용합니다. |
| hidden_columns | 적재 데이터에 포함된 숨겨진 열을 지정합니다. Header에 Columns가 없을 때 적용됩니다. 여러 숨겨진 열은 쉼표로 구분합니다. 시스템은 사용자가 지정한 데이터를 사용하여 적재합니다. 아래 예제에서 적재 데이터의 마지막 열은 __DORIS_SEQUENCE_COL__입니다. hidden_columns: __DORIS_DELETE_SIGN__,__DORIS_SEQUENCE_COL__ |
| load_to_single_tablet | Boolean 값입니다. true로 설정하면 단일 작업의 데이터를 해당 파티션의 단일 tablet에만 적재할 수 있습니다. 기본값은 false입니다. 이 매개변수는 랜덤 버킷팅을 사용하는 OLAP 테이블에 데이터를 적재할 때만 설정할 수 있습니다. |
| compress_type | 파일의 압축 형식을 지정합니다. 현재는 CSV 파일 압축만 지원합니다. 지원하는 압축 형식은 gz, lzo, bz2, lz4, lzop, deflate입니다. |
| trim_double_quotes | Boolean 값입니다. 기본값은 false입니다. true로 설정하면 CSV 파일의 모든 필드에서 가장 바깥쪽 큰따옴표를 제거합니다. |
| skip_lines | Integer 값입니다. 기본값은 0입니다. CSV 파일의 처음 몇 줄을 건너뜁니다. format을 csv_with_names 또는 csv_with_names_and_types로 설정하면 이 매개변수는 유효하지 않습니다. |
| comment | String 값입니다. 기본값은 빈 문자열입니다. 작업에 추가 정보를 기록합니다. |
| enclose | 둘러싸는 문자를 지정합니다. CSV 데이터 필드에 줄 구분자나 열 구분자가 포함되어 있으면 단일 바이트 문자를 둘러싸는 문자로 지정하여 의도치 않게 데이터가 잘리는 것을 방지할 수 있습니다. 예를 들어 열 구분자가 ,이고 둘러싸는 문자가 '일 때 데이터가 "a,'b,c'"이면 b,c는 하나의 필드로 파싱됩니다. 참고: enclose를 "로 설정하면 trim_double_quotes를 true로 설정해야 합니다. |
| escape | 이스케이프 문자를 지정합니다. 필드 안에서 둘러싸는 문자와 동일한 문자를 이스케이프하는 데 사용합니다. 예를 들어 데이터가 "a,'b,'c'"이고 둘러싸는 문자가 '일 때 b,'c를 하나의 필드로 파싱하려면 \\와 같은 단일 바이트 이스케이프 문자를 지정하고 데이터를 "a,'b,\\'c'"로 수정합니다. |
| memtable_on_sink_node | 데이터 적재 시 MemTable forward를 활성화할지 지정합니다. 기본값은 false입니다. |
| unique_key_update_mode | Unique 테이블의 업데이트 모드입니다. 현재는 Merge-On-Write Unique 테이블에만 적용됩니다. UPSERT, UPDATE_FIXED_COLUMNS, UPDATE_FLEXIBLE_COLUMNS의 세 가지 유형을 지원합니다. UPSERT: upsert 의미 체계로 데이터를 적재합니다. UPDATE_FIXED_COLUMNS: 부분 열 업데이트를 사용하여 데이터를 적재합니다. UPDATE_FLEXIBLE_COLUMNS: 유연한 부분 열 업데이트를 사용하여 데이터를 적재합니다. |
| partial_update_new_key_behavior | Unique 테이블에서 부분 열 업데이트 또는 유연한 열 업데이트를 수행할 때 새로 삽입되는 행의 처리 방식입니다. APPEND와 ERROR의 두 가지 유형을 사용할 수 있습니다.- APPEND: 새 행 삽입을 허용합니다.- ERROR: 새 행을 삽입하면 적재가 실패하고 오류를 보고합니다. |
적재 반환값
Stream Load는 동기식 데이터 적재 방식으로, 다음과 같이 적재 요청의 응답을 통해 적재 결과를 사용자에게 반환합니다.
{
    "TxnId": 1003,
    "Label": "b6f3bc78-0d2c-45d9-9e4c-faa0a0149bee",
    "Status": "Success",
    "ExistingJobStatus": "FINISHED", // optional
    "Message": "OK",
    "NumberTotalRows": 1000000,
    "NumberLoadedRows": 1000000,
    "NumberFilteredRows": 1,
    "NumberUnselectedRows": 0,
    "LoadBytes": 40888898,
    "LoadTimeMs": 2144,
    "BeginTxnTimeMs": 1,
    "StreamLoadPutTimeMs": 2,
    "ReadDataTimeMs": 325,
    "WriteDataTimeMs": 1933,
    "CommitAndPublishTimeMs": 106,
    "ErrorURL": "http://192.168.1.1:8042/api/_load_error_log?file=__shard_0/error_log_insert_stmt_db18266d4d9b4ee5-abb00ddd64bdf005_db18266d4d9b4ee5_abb00ddd64bdf005"
}
반환 결과의 매개변수는 다음 표와 같습니다.
| 매개변수 이름 | 설명 |
|---|---|
| TxnId | 적재 트랜잭션의 ID입니다. |
| Label | 적재 작업의 레이블로, -H "label:<label_id>"로 지정합니다. |
| Status | 적재의 최종 상태입니다. - Success: 적재에 성공했습니다. - Publish Timeout: 적재는 완료되었지만 데이터가 표시되기까지 지연될 수 있습니다. 재시도할 필요가 없습니다. - Label Already Exists: 레이블이 중복되었습니다. 새 레이블이 필요합니다. - Fail: 적재에 실패했습니다. |
| ExistingJobStatus | 해당 레이블에 대응하는 기존 적재 작업의 상태입니다. 이 필드는 Status가 Label Already Exists일 때만 표시됩니다. 이 상태를 통해 기존 레이블에 해당하는 적재 작업의 상태를 확인할 수 있습니다. RUNNING은 작업이 아직 실행 중임을 의미하고, FINISHED는 작업이 성공했음을 의미합니다. |
| Message | 적재 오류 메시지입니다. |
| NumberTotalRows | 적재에서 처리한 전체 행 수입니다. |
| NumberLoadedRows | 성공적으로 적재한 행 수입니다. |
| NumberFilteredRows | 데이터 품질 검사를 통과하지 못한 행 수입니다. |
| NumberUnselectedRows | where 조건으로 필터링되어 제외된 행 수입니다. |
| LoadBytes | 적재한 바이트 수입니다. |
| LoadTimeMs | 적재 완료에 걸린 시간으로, 단위는 밀리초입니다. |
| BeginTxnTimeMs | FE에 트랜잭션 시작을 요청하는 데 걸린 시간으로, 단위는 밀리초입니다. |
| StreamLoadPutTimeMs | FE에 적재 데이터의 실행 계획을 요청하여 가져오는 데 걸린 시간으로, 단위는 밀리초입니다. |
| ReadDataTimeMs | 데이터를 읽는 데 걸린 시간으로, 단위는 밀리초입니다. |
| WriteDataTimeMs | 데이터를 쓰는 데 걸린 시간으로, 단위는 밀리초입니다. |
| CommitAndPublishTimeMs | FE에 트랜잭션 커밋과 게시를 요청하는 데 걸린 시간으로, 단위는 밀리초입니다. |
| ErrorURL | 데이터 품질 문제가 있으면 이 URL에 접속하여 구체적인 오류 행을 확인할 수 있습니다. |
ErrorURL을 사용하면 데이터 품질 문제로 적재에 실패한 데이터를 확인할 수 있습니다. curl "<ErrorURL>" 명령으로 오류 데이터 정보를 직접 확인하세요.
적재 예제
적재 시간 제한 및 최대 적재 크기 설정
적재 작업의 시간 제한은 초 단위입니다. 적재 작업이 설정된 timeout 내에 완료되지 않으면 시스템에서 작업을 취소하고 작업 상태가 CANCELLED로 변경됩니다. timeout 매개변수를 지정하거나 stream_load_default_timeout_second 매개변수를 fe.conf에 추가하여 Stream Load의 적재 시간 제한을 조정할 수 있습니다.
적재하기 전에 파일 크기를 기준으로 적재 시간 제한을 계산하세요. 예를 들어 파일 크기가 100 GB이고 예상 적재 속도가 50 MB/s인 경우 다음과 같습니다.
Import time ~= 100GB / 50MB/s ~= 2048s
다음 명령은 timeout을 3000 s로 설정한 Stream Load 적재 작업을 생성합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "timeout:3000" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
최대 허용 오류 비율 설정
Doris 적재 작업은 형식이 잘못된 데이터의 일부를 허용할 수 있습니다. 허용 비율은 max_filter_ratio로 설정합니다. 기본값은 0이며, 잘못된 데이터가 단 한 행이라도 있으면 전체 적재 작업이 실패합니다. 문제가 있는 일부 데이터 행을 무시하려면 이 매개변수를 0부터 1 사이의 값으로 설정하세요. 그러면 Doris가 데이터 형식이 잘못된 행을 자동으로 건너뜁니다. 허용 비율의 계산 방법에 관한 자세한 내용은 데이터 변환 문서를 참조하세요.
다음 명령은 max_filter_ratio를 0.4로 설정한 Stream Load 적재 작업을 생성합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "max_filter_ratio:0.4" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
적재 필터 조건 설정
적재 중에는 WHERE 매개변수로 적재할 데이터를 조건에 따라 필터링할 수 있습니다. 필터링되어 제외된 데이터는 필터 비율 계산에 포함되지 않으며 max_filter_ratio 설정에 영향을 주지 않습니다. 적재가 완료되면 num_rows_unselected에서 필터링되어 제외된 행 수를 확인할 수 있습니다.
다음 명령은 WHERE 필터 조건을 지정한 Stream Load 적재 작업을 생성합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "where:age>=35" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
지정된 파티션에 데이터 적재
로컬 파일의 데이터를 테이블의 p1 및 p2 파티션에 적재하며, 오류 비율은 20%까지 허용합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "label:123" \
    -H "Expect:100-continue" \
    -H "max_filter_ratio:0.2" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -H "partitions: p1, p2" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
적재 시간대 지정
DATETIME 관련 타입은 절대적인 시점만 표현하고 시간대 정보를 포함하지 않으며, Doris 시스템 시간대에 따라 변경되지 않습니다. 따라서 시간대 정보가 있는 데이터는 적재 시 지정된 대상 시간대의 데이터로 변환하여 일관되게 처리합니다. Doris 시스템의 시간대는 세션 변수 time_zone이 나타내는 시간대입니다.
적재 시 대상 시간대는 timezone 매개변수로 지정합니다. 시간대를 변환하거나 시간대의 영향을 받는 함수를 평가할 때 이 변수는 세션 변수 time_zone을 대신합니다. 따라서 특별한 경우가 아니면 적재 트랜잭션의 timezone 설정은 현재 Doris 클러스터의 time_zone과 일치해야 합니다. 즉, 시간대 정보가 있는 모든 시간 데이터는 해당 시간대로 변환됩니다.
예를 들어 Doris 시스템 시간대가 +08:00이고 적재 데이터의 시간 열에 2012-01-01 01:00:00+00:00과 2015-12-12 12:12:12-08:00의 두 행이 있으면, 적재 트랜잭션에 -H "timezone: +08:00"을 지정할 때 두 행이 모두 해당 시간대로 변환되어 2012-01-01 09:00:00과 2015-12-13 04:12:12가 됩니다.
시간대에 관한 자세한 내용은 시간대 문서를 참조하세요.
스트리밍 방식으로 적재
Stream Load는 HTTP 프로토콜을 기반으로 하므로 Java, Go, Python 등의 프로그램에서 스트림 형태로 데이터를 쓸 수 있습니다. Stream Load라는 이름도 여기에서 유래했습니다.
다음은 bash 파이프라인 명령으로 이 사용법을 보여 주는 예제입니다. 적재할 데이터는 로컬 파일에서 읽는 대신 프로그램에서 생성합니다.
seq 1 10 | awk '{OFS="\t"}{print $1, $1 * 10}' | curl --location-trusted -u root -T - http://host:port/api/testDb/testTbl/_stream_load
적재 시 CSV의 첫 번째 줄 건너뛰기
파일 데이터:
 id,name,age
 1,doris,20
 2,flink,10
format=csv_with_names를 지정하여 적재 시 첫 번째 줄을 건너뜁니다.
curl --location-trusted -u root -T test.csv -H "label:1" -H "format:csv_with_names" -H "column_separator:," http://host:port/api/testDb/testTbl/_stream_load
merge_type을 사용하여 Delete 작업 수행
Stream Load에는 APPEND, DELETE, MERGE의 세 가지 적재 유형이 있습니다. merge_type 매개변수로 유형을 조정할 수 있습니다. 적재 데이터의 키와 일치하는 모든 행을 삭제하려면 다음 명령을 사용하세요.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: DELETE" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
적재 전 테이블의 데이터가 다음과 같다고 가정합니다.
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      3 |        2 | tom      |    2 |
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
적재 데이터는 다음과 같습니다.
3,2,tom,0
적재 후 일치하는 행이 테이블에서 삭제되며, 결과 집합은 다음과 같습니다.
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
merge_type을 사용하여 Merge 작업 수행
merge_type을 MERGE로 설정하면 적재 데이터를 테이블에 병합합니다. MERGE 의미 체계는 DELETE 조건과 함께 사용해야 합니다. DELETE 조건에 일치하는 행은 DELETE 의미 체계로 처리하고, 나머지 행은 APPEND 의미 체계로 테이블에 추가합니다. 예를 들어 다음 작업은 siteid가 1인 행을 삭제하고 나머지 데이터를 테이블에 추가합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: MERGE" \
    -H "delete: siteid=1" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
적재 전 데이터가 다음과 같다고 가정합니다.
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
|      1 |        1 | jim      |    2 |
+--------+----------+----------+------+
적재 데이터는 다음과 같습니다.
2,1,grace,2
3,2,tom,2
1,1,jim,2
적재 후 siteid = 1인 행은 삭제되고, siteid가 2와 3인 행은 테이블에 추가됩니다.
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      2 |        1 | grace    |    2 |
|      3 |        2 | tom      |    2 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
적재 시 Merge에 사용할 Sequence 열 지정
Unique Key 테이블에 Sequence 열을 설정하면 키 열이 같은 경우 REPLACE 집계 함수의 교체 순서를 Sequence 열의 값으로 결정합니다. 큰 값이 작은 값을 대체할 수 있습니다. 이러한 테이블에서 DORIS_DELETE_SIGN을 기준으로 삭제를 표시할 때는 키가 같고 Sequence 열의 값이 현재 값보다 크거나 같아야 합니다. function_column.sequence_col 매개변수를 merge_type: DELETE와 함께 지정하면 삭제 작업을 수행할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: DELETE" \
    -H "function_column.sequence_col: age" \
    -H "column_separator:," \
    -H "columns: name, gender, age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
테이블의 구조가 다음과 같다고 가정합니다.
mysql> SET show_hidden_columns=true;
Query OK, 0 rows affected (0.00 sec)

mysql> DESC table1;
+------------------------+--------------+------+-------+---------+---------+
| Field                  | Type         | Null | Key   | Default | Extra   |
+------------------------+--------------+------+-------+---------+---------+
| name                   | VARCHAR(100) | No   | true  | NULL    |         |
| gender                 | VARCHAR(10)  | Yes  | false | NULL    | REPLACE |
| age                    | INT          | Yes  | false | NULL    | REPLACE |
| __DORIS_DELETE_SIGN__  | TINYINT      | No   | false | 0       | REPLACE |
| __DORIS_SEQUENCE_COL__ | INT          | Yes  | false | NULL    | REPLACE |
+------------------------+--------------+------+-------+---------+---------+
4 rows in set (0.00 sec)
원본 테이블의 데이터가 다음과 같다고 가정합니다.
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| li    | male   |   10 |
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
1. Sequence 매개변수가 적용되는 경우: 적재할 Sequence 열의 값이 테이블의 기존 값보다 크거나 같음
적재 데이터는 다음과 같습니다.
li,male,10
function_column.sequence_col: age가 지정되어 있고 age가 테이블의 기존 열 값보다 크거나 같으므로 원래 행이 삭제되며, 테이블 데이터는 다음과 같이 바뀝니다.
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
2. Sequence 매개변수가 적용되지 않는 경우: 적재할 Sequence 열의 값이 테이블의 기존 값보다 작거나 같음
적재 데이터는 다음과 같습니다.
li,male,9
function_column.sequence_col: age가 지정되어 있지만 age가 테이블의 기존 열 값보다 작으므로 DELETE 작업이 적용되지 않습니다. 테이블 데이터는 변경되지 않고 기본 키가 li인 행도 계속 표시됩니다.
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| li    | male   |   10 |
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
행이 삭제되지 않는 이유는 내부 처리 순서에 있습니다. 시스템은 먼저 키가 같은 행들을 확인하고 Sequence 열 값이 더 큰 행을 외부에 노출한 다음, 해당 행의 DORIS_DELETE_SIGN 값이 1인지 확인합니다. 값이 1이면 외부에 노출하지 않고, 0이면 계속 읽을 수 있습니다.
둘러싸는 문자가 포함된 데이터 적재
CSV 데이터에 구분자나 열 구분자가 포함되어 있으면 단일 바이트 문자를 둘러싸는 문자로 지정하여 데이터가 잘리는 것을 방지할 수 있습니다.
다음 데이터의 열에는 구분자 ,가 포함되어 있습니다.
Zhang San,30,'Shanghai City, Huangpu District, Dagu Road'
둘러싸는 문자를 '로 지정하면 "Shanghai City, Huangpu District, Dagu Road"를 하나의 필드로 지정할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "enclose:'" \
    -H "columns:username,age,address" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
필드 안에도 둘러싸는 문자가 포함되어 있으면 먼저 열 안의 해당 문자를 이스케이프해야 합니다. 예를 들어 "Shanghai City, Huangpu District, 'Dagu Road"를 하나의 필드로 처리하려면 다음과 같이 작성합니다.
Zhang San,30,'Shanghai City, Huangpu District, \'Dagu Road'
escape 매개변수로 단일 바이트 이스케이프 문자를 지정할 수 있습니다. 다음 예제에서는 \를 사용합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "enclose:'" \
    -H "escape:\\" \
    -H "columns:username,age,address" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
DEFAULT CURRENT_TIMESTAMP 필드가 있는 테이블에 데이터 적재
다음 예제에서는 필드에 DEFAULT CURRENT_TIMESTAMP가 포함된 테이블에 데이터를 적재합니다.
테이블 스키마:
CREATE TABLE testDb.testTbl (
    `id` BIGINT(30) NOT NULL,
    `order_code` VARCHAR(30) DEFAULT NULL COMMENT '',
    `create_time` DATETIMEv2(3) DEFAULT CURRENT_TIMESTAMP
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 10;
JSON 데이터 형식:
{"id":1,"order_Code":"avc"}
적재 명령:
curl --location-trusted -u root -T test.json -H "label:1" -H "format:json" -H 'columns: id, order_code, create_time=CURRENT_TIMESTAMP()' http://host:port/api/testDb/testTbl/_stream_load
단순 모드로 JSON 데이터 적재
JSON 필드가 테이블의 열 이름과 일대일로 대응하면 "strip_outer_array:true"와 "format:json"을 지정하여 JSON 데이터를 테이블에 적재할 수 있습니다.
예를 들어 테이블이 다음과 같이 정의되어 있다고 가정합니다.
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
적재 데이터의 필드 이름은 테이블의 필드 이름과 일대일로 대응합니다.
[
{"user_id":1,"name":"Emily","age":25},
{"user_id":2,"name":"Benjamin","age":35},
{"user_id":3,"name":"Olivia","age":28},
{"user_id":4,"name":"Alexander","age":60},
{"user_id":5,"name":"Ava","age":17},
{"user_id":6,"name":"William","age":69},
{"user_id":7,"name":"Sophia","age":32},
{"user_id":8,"name":"James","age":64},
{"user_id":9,"name":"Emma","age":37},
{"user_id":10,"name":"Liam","age":64}
]
다음 명령으로 JSON 데이터를 테이블에 적재할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
매칭 모드로 복잡한 JSON 데이터 적재
JSON 데이터가 복잡하여 테이블의 열 이름과 일대일로 대응할 수 없거나 추가 열이 있는 경우, jsonpaths 매개변수로 열 이름을 매핑하여 매칭 방식으로 적재할 수 있습니다. 예를 들어 다음과 같은 데이터가 있다고 가정합니다.
[
{"userid":1,"hudi":"lala","username":"Emily","userage":25,"userhp":101},
{"userid":2,"hudi":"kpkp","username":"Benjamin","userage":35,"userhp":102},
{"userid":3,"hudi":"ji","username":"Olivia","userage":28,"userhp":103},
{"userid":4,"hudi":"popo","username":"Alexander","userage":60,"userhp":103},
{"userid":5,"hudi":"uio","username":"Ava","userage":17,"userhp":104},
{"userid":6,"hudi":"lkj","username":"William","userage":69,"userhp":105},
{"userid":7,"hudi":"komf","username":"Sophia","userage":32,"userhp":106},
{"userid":8,"hudi":"mki","username":"James","userage":64,"userhp":107},
{"userid":9,"hudi":"hjk","username":"Emma","userage":37,"userhp":108},
{"userid":10,"hudi":"hua","username":"Liam","userage":64,"userhp":109}
]
jsonpaths 매개변수를 지정하면 지정한 열을 매칭할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
    -H "columns:user_id,name,age" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
적재할 JSON 루트 노드 지정
JSON 데이터에 중첩된 JSON 필드가 있으면 적재할 JSON의 루트 노드를 지정해야 합니다. 기본값은 ""입니다.
다음 데이터에서는 comment 열 내부의 데이터를 테이블에 적재하려고 합니다.
[
    {"user":1,"comment":{"userid":101,"username":"Emily","userage":25}},
    {"user":2,"comment":{"userid":102,"username":"Benjamin","userage":35}},
    {"user":3,"comment":{"userid":103,"username":"Olivia","userage":28}},
    {"user":4,"comment":{"userid":104,"username":"Alexander","userage":60}},
    {"user":5,"comment":{"userid":105,"username":"Ava","userage":17}},
    {"user":6,"comment":{"userid":106,"username":"William","userage":69}},
    {"user":7,"comment":{"userid":107,"username":"Sophia","userage":32}},
    {"user":8,"comment":{"userid":108,"username":"James","userage":64}},
    {"user":9,"comment":{"userid":109,"username":"Emma","userage":37}},
    {"user":10,"comment":{"userid":110,"username":"Liam","userage":64}}
    ]
먼저 json_root 매개변수로 루트 노드를 comment로 설정한 다음, jsonpaths 매개변수로 열 이름 매핑을 완료합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -H "json_root: $.comment" \
    -H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
    -H "columns:user_id,name,age" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Array 데이터 타입 적재
다음 데이터에는 배열 타입이 포함되어 있습니다.
1|Emily|[1,2,3,4]
2|Benjamin|[22,45,90,12]
3|Olivia|[23,16,19,16]
4|Alexander|[123,234,456]
5|Ava|[12,15,789]
6|William|[57,68,97]
7|Sophia|[46,47,49]
8|James|[110,127,128]
9|Emma|[19,18,123,446]
10|Liam|[89,87,96,12]
다음 스키마의 테이블에 데이터를 적재합니다.
CREATE TABLE testdb.test_streamload(
    typ_id     BIGINT          NOT NULL COMMENT "ID",
    name       VARCHAR(20)     NULL     COMMENT "name",
    arr        ARRAY<int(10)>  NULL     COMMENT "array"
)
DUPLICATE KEY(typ_id)
DISTRIBUTED BY HASH(typ_id) BUCKETS 10;
Stream Load 작업을 사용하면 텍스트 파일의 ARRAY 타입 데이터를 테이블에 직접 적재할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:|" \
    -H "columns:typ_id,name,arr" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Map 데이터 타입 적재
다음 예제처럼 적재 데이터에 Map 타입이 포함되어 있다고 가정합니다.
[
{"user_id":1,"namemap":{"Emily":101,"age":25}},
{"user_id":2,"namemap":{"Benjamin":102,"age":35}},
{"user_id":3,"namemap":{"Olivia":103,"age":28}},
{"user_id":4,"namemap":{"Alexander":104,"age":60}},
{"user_id":5,"namemap":{"Ava":105,"age":17}},
{"user_id":6,"namemap":{"William":106,"age":69}},
{"user_id":7,"namemap":{"Sophia":107,"age":32}},
{"user_id":8,"namemap":{"James":108,"age":64}},
{"user_id":9,"namemap":{"Emma":109,"age":37}},
{"user_id":10,"namemap":{"Liam":110,"age":64}}
]
다음 스키마의 테이블에 데이터를 적재합니다.
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "ID",
    namemap            Map<STRING, INT>  NULL     COMMENT "namemap"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
Stream Load 작업을 사용하면 텍스트 파일의 Map 타입 데이터를 테이블에 직접 적재할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format: json" \
    -H "strip_outer_array:true" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Bitmap 데이터 타입 적재
적재 중 Bitmap 타입 데이터를 처리할 때는 to_bitmap으로 데이터를 Bitmap으로 변환하거나, bitmap_empty 함수로 Bitmap을 채울 수 있습니다.
예를 들어 적재 데이터가 다음과 같다고 가정합니다.
1|koga|17723
2|nijg|146285
3|lojn|347890
4|lofn|489871
5|jfin|545679
6|kon|676724
7|nhga|767689
8|nfubg|879878
9|huang|969798
10|buag|97997
Bitmap 타입이 포함된 다음 테이블에 데이터를 적재합니다.
CREATE TABLE testdb.test_streamload(
    typ_id     BIGINT                NULL   COMMENT "ID",
    hou        VARCHAR(10)           NULL   COMMENT "one",
    arr        BITMAP  BITMAP_UNION  NOT NULL   COMMENT "two"
)
AGGREGATE KEY(typ_id,hou)
DISTRIBUTED BY HASH(typ_id,hou) BUCKETS 10;
to_bitmap을 사용하여 데이터를 Bitmap 타입으로 변환할 수 있습니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "columns:typ_id,hou,arr,arr=to_bitmap(arr)" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
HLL 데이터 타입 적재
hll_hash 함수로 데이터를 HLL 타입으로 변환할 수 있습니다. 다음과 같은 데이터가 있다고 가정합니다.
1001|koga
1002|nijg
1003|lojn
1004|lofn
1005|jfin
1006|kon
1007|nhga
1008|nfubg
1009|huang
1010|buag
다음 테이블에 데이터를 적재합니다.
CREATE TABLE testdb.test_streamload(
    typ_id           BIGINT          NULL   COMMENT "ID",
    typ_name         VARCHAR(10)     NULL   COMMENT "NAME",
    pv               hll hll_union   NOT NULL   COMMENT "hll"
)
AGGREGATE KEY(typ_id,typ_name)
DISTRIBUTED BY HASH(typ_id) BUCKETS 10;
hll_hash 함수를 사용하여 적재합니다.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "column_separator:|" \
    -H "columns:typ_id,typ_name,pv=hll_hash(typ_id)" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
열 매핑, 파생 열 및 필터링
Doris는 적재 구문에서 다양한 열 변환 및 필터링 작업과 대부분의 내장 함수를 지원합니다. 이 기능의 사용법에 관한 자세한 내용은 데이터 변환 문서를 참조하세요.
적재 시 엄격 모드 활성화
strict_mode 속성으로 적재 작업을 엄격 모드로 실행할지 설정합니다. 이 속성은 열 매핑, 변환 및 필터링 결과에 영향을 줍니다. 엄격 모드에 관한 자세한 내용은 엄격 모드 문서를 참조하세요.
적재 중 부분 열 업데이트 또는 유연한 부분 열 업데이트 수행
적재 중 부분 열 업데이트를 지정하는 방법은 열 업데이트 문서를 참조하세요.
자주 묻는 질문
Stream Load는 수동 취소를 지원하나요?
아니요. Stream Load는 시간 초과나 적재 오류가 발생하면 시스템에서 자동으로 취소합니다. 사용자는 실행 중인 Stream Load 작업을 수동으로 취소할 수 없습니다.
단일 Stream Load 파일에 크기 제한이 있나요?
단일 적재 파일은 10 GB 이하로 유지하는 것이 좋습니다. 더 큰 파일은 적재 전에 분할하세요. BE 설정 매개변수 streaming_load_max_mb를 조정하여 단일 적재 한도를 늘리거나, Doris Streamloader로 여러 적재 작업을 동시에 실행하여 성능을 높일 수도 있습니다.
과거 Stream Load 작업은 어떻게 조회하나요?
기본적으로 시스템은 Stream Load 작업 이력을 기록하지 않습니다. enable_stream_load_record=true를 be.conf에 설정하고 재시작한 다음, show stream load from <db>로 이력을 조회하세요.
"Label Already Exists" 오류는 어떻게 처리하나요?
이 오류는 같은 레이블이 이미 사용되었음을 의미합니다. 응답의 ExistingJobStatus 필드로 기존 작업의 상태를 확인할 수 있습니다.
RUNNING: 작업이 아직 실행 중입니다. 완료될 때까지 기다리세요.FINISHED: 작업이 성공적으로 완료되었습니다. 재시도할 필요가 없습니다.- CANCELLED 상태이면 같은 레이블로 새 적재를 시작할 수 있습니다.
At-Most-Once 의미 체계를 보장하고 중복 적재를 방지하려면 같은 데이터 배치에 항상 같은 레이블을 사용하는 것이 좋습니다.
데이터 형식 오류로 적재가 실패하면 어떻게 하나요?
다음과 같이 문제를 찾아 처리할 수 있습니다.
- 응답의
ErrorURL필드를 통해 구체적인 오류 행을 확인합니다.curl "<ErrorURL>". max_filter_ratio(범위: 0부터 1까지)를 적절히 높여 형식이 잘못된 데이터의 일부를 허용합니다.- CSV에서 null 값(
\N)과 빈 문자열(두 구분자 사이에 문자가 없음)이 올바르게 사용되었는지 확인합니다. - 열 구분자, 줄 구분자, 둘러싸는 문자(
enclose), 이스케이프 문자(escape) 설정이 실제 파일 내용과 일치하는지 확인합니다.
적재 시간 초과(CANCELLED)는 어떻게 처리하나요?
데이터 양을 기준으로 적절한 시간 제한을 추정하세요.
Import time ~= File size / Estimated import speed (for example, 50MB/s)
시간 제한은 두 가지 방법으로 조정할 수 있습니다.
- 단일 적재: Header 매개변수
-H "timeout:3000"을 사용합니다. - 전역 설정: FE 매개변수
stream_load_default_timeout_second를 조정합니다.
CSV에서 null 값과 빈 문자열은 어떻게 구분하나요?
| 유형 | 표현 방식 | 예제 | 가운데 열의 의미 |
|---|---|---|---|
| null 값 | \N 사용 | a,\N,b | 가운데 열이 null임 |
| 빈 문자열 | 두 구분자 사이에 문자가 없음 | a,,b | 가운데 열이 빈 문자열임 |