Apache Doris 개요
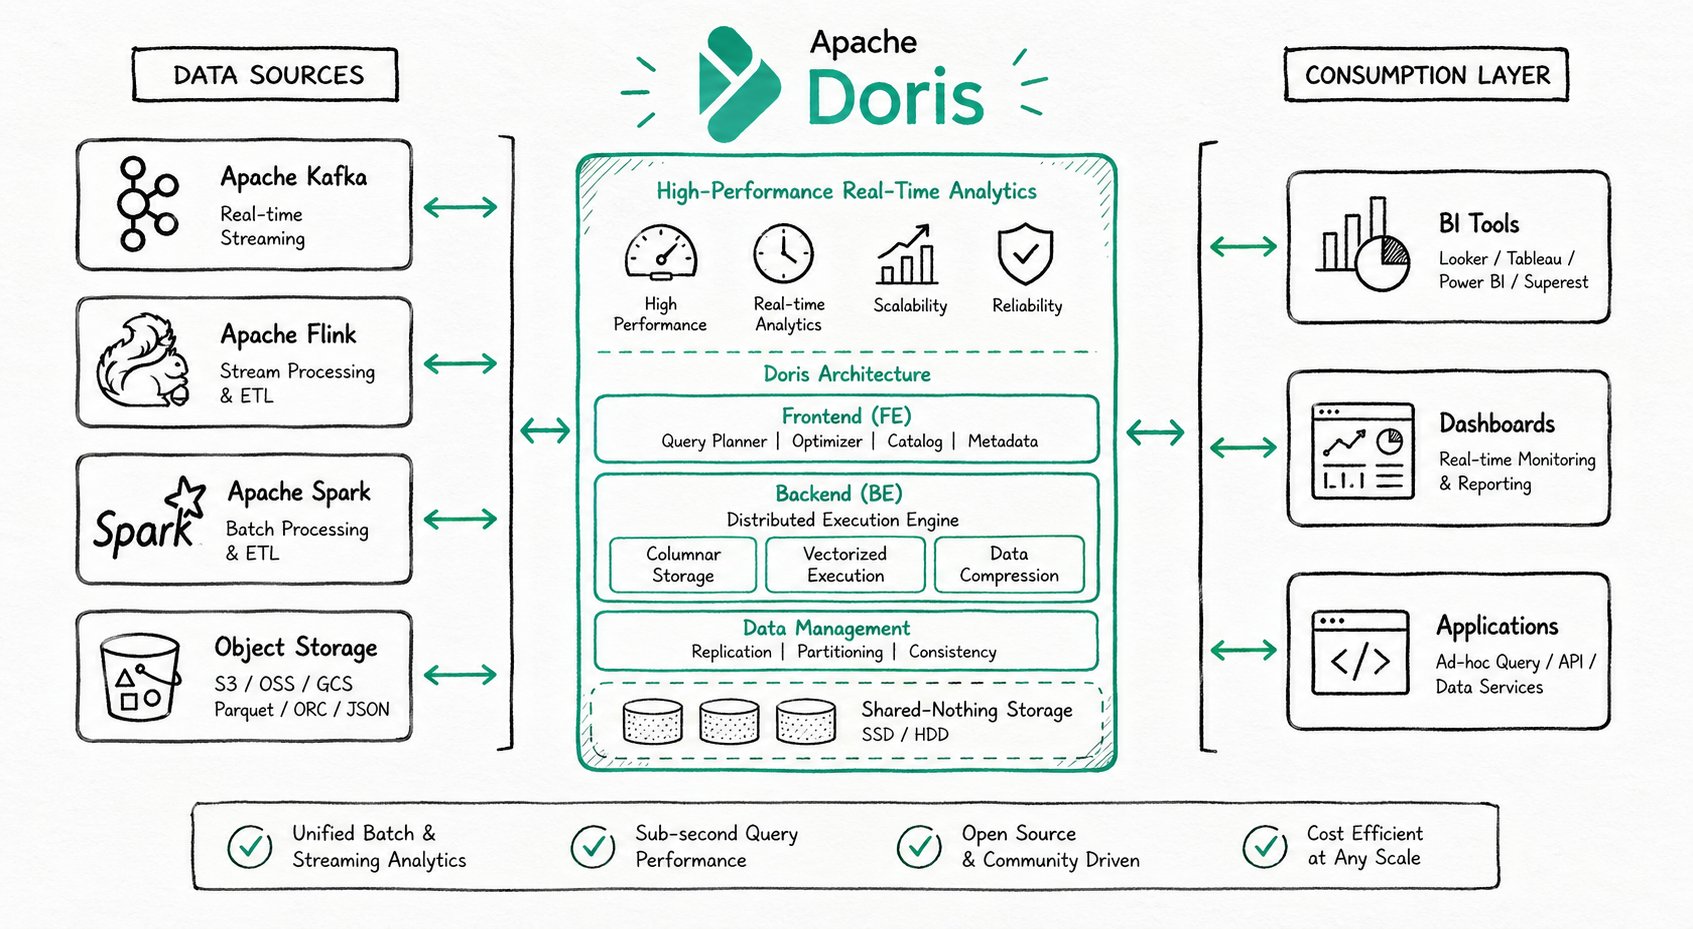
Apache Doris는 MPP 아키텍처 기반의 고성능 실시간 분석 데이터베이스입니다. 효율성, 단순성, 통합성을 바탕으로 대규모 데이터 세트에 대한 쿼리 결과를 일 초 미만에 반환하며, 하나의 시스템에서 동시성이 높은 포인트 쿼리와 처리량이 높은 복잡한 분석을 모두 지원합니다.
주요 특징
| 기능 | 수치 및 사양 |
|---|---|
| 쿼리 지연 시간 | < 1초 (서브초 응답) |
| 데이터 수집 지연 시간 | 초 단위 (실시간 데이터 수집) |
| 동시 처리 성능 | 10,000+ QPS |
| 저장 규모 | PB급 / 클러스터당 수백 대의 머신 |
| SQL 인터페이스 | MySQL 프로토콜 호환 계층, ANSI SQL 문법 |
주요 사용 사례
Apache Doris는 다음 세 가지 유형의 시나리오에서 널리 사용됩니다.
실시간 데이터 분석
내부 및 외부 실시간 보고서, 대시보드, 사용자 행동 분석, A/B 테스트 플랫폼, 로그 검색 및 분석에 사용합니다.
대표 사례:
- 실시간 대시보드: 초 단위로 갱신되는 광군제 주문량 모니터링
- 사용자 프로필 분석: 고객 세분화 및 정밀 마케팅
- 로그 검색 및 분석: 문제 해결 및 성능 최적화
레이크하우스 분석
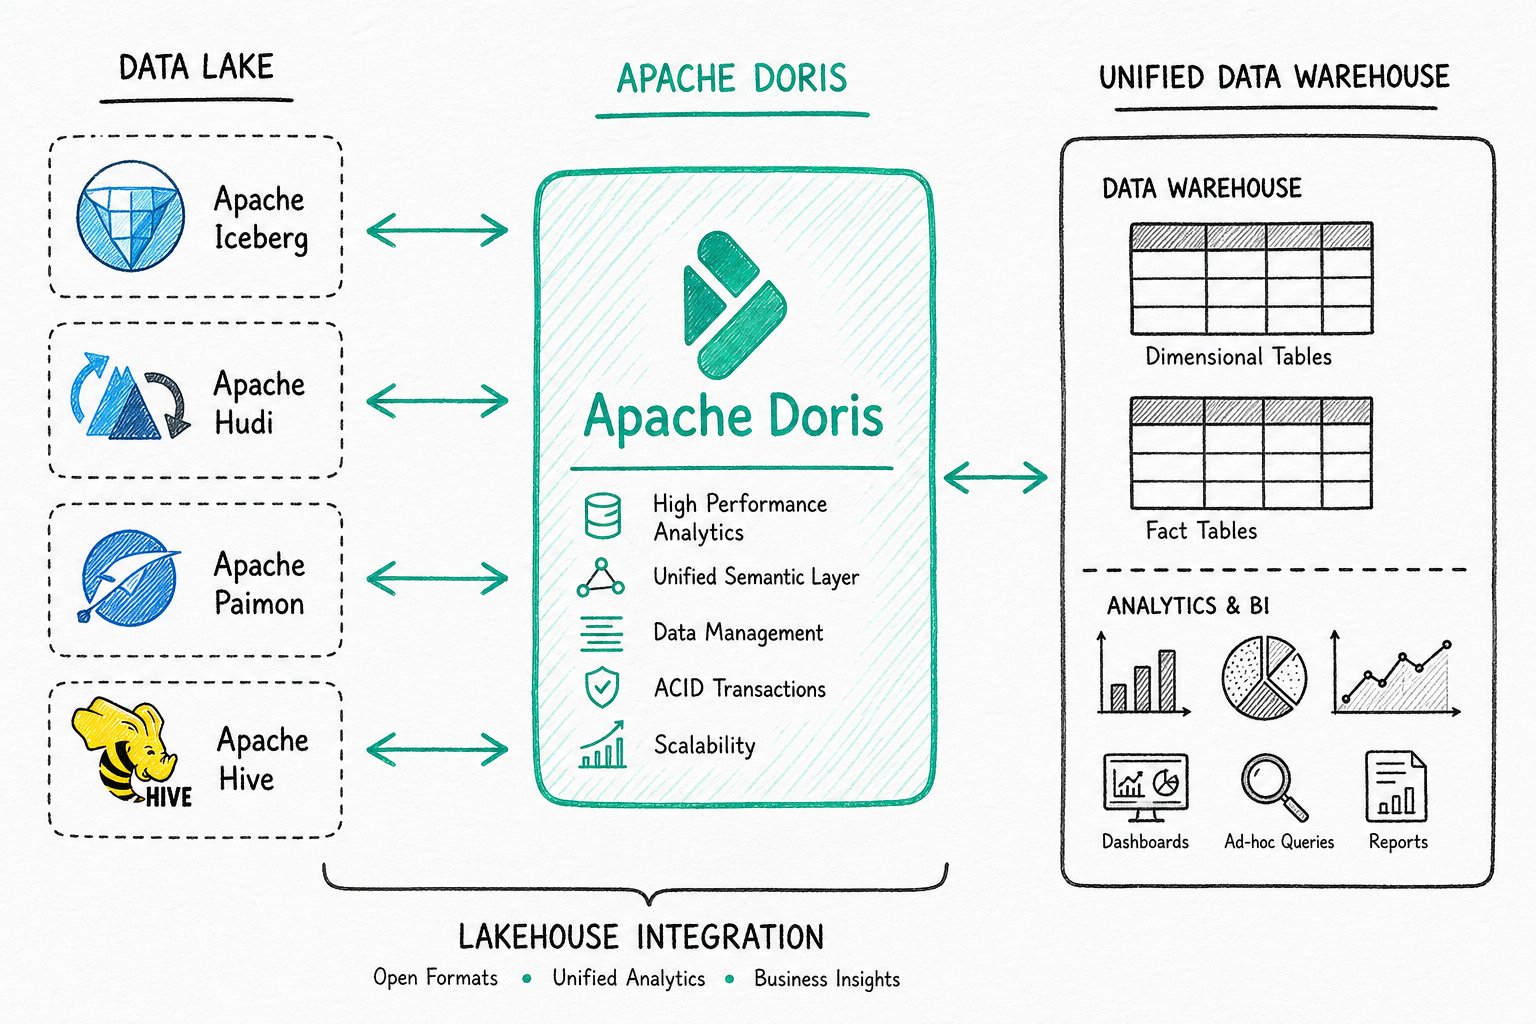
통합 데이터 웨어하우스 구축, 데이터 레이크에 대한 연합 쿼리 가속, 혼합 워크로드 분석에 사용합니다.
하이브리드 검색 및 분석 (AI 데이터 스택)
대규모 모델 시대에 Apache Doris는 전문 검색, 벡터 검색, AI 함수 기능을 긴밀하게 통합하여 데이터 저장, 검색, 분석을 아우르는 완전한 AI 데이터 스택을 구축합니다.
| 시나리오 | 설명 |
|---|---|
| 에이전트용 분석 | AI 에이전트를 위한 밀리초 단위 실시간 의사 결정 (사기 탐지, 지능형 추천) |
| 하이브리드 검색 및 분석 | 하나의 SQL 문에서 벡터 유사도 검색, 키워드 필터링, 집계 분석을 함께 실행 |
| RAG 애플리케이션 | 기업 지식 기반 질의응답, 지능형 고객 서비스, 문서 어시스턴트 |
| 의미 검색 | 언어 간 검색, 동의어 인식, 의도 파악 |
| AI 관측 가능성 | 모델 학습 모니터링, 추론 추적, 로그 분석 |
시스템 아키텍처
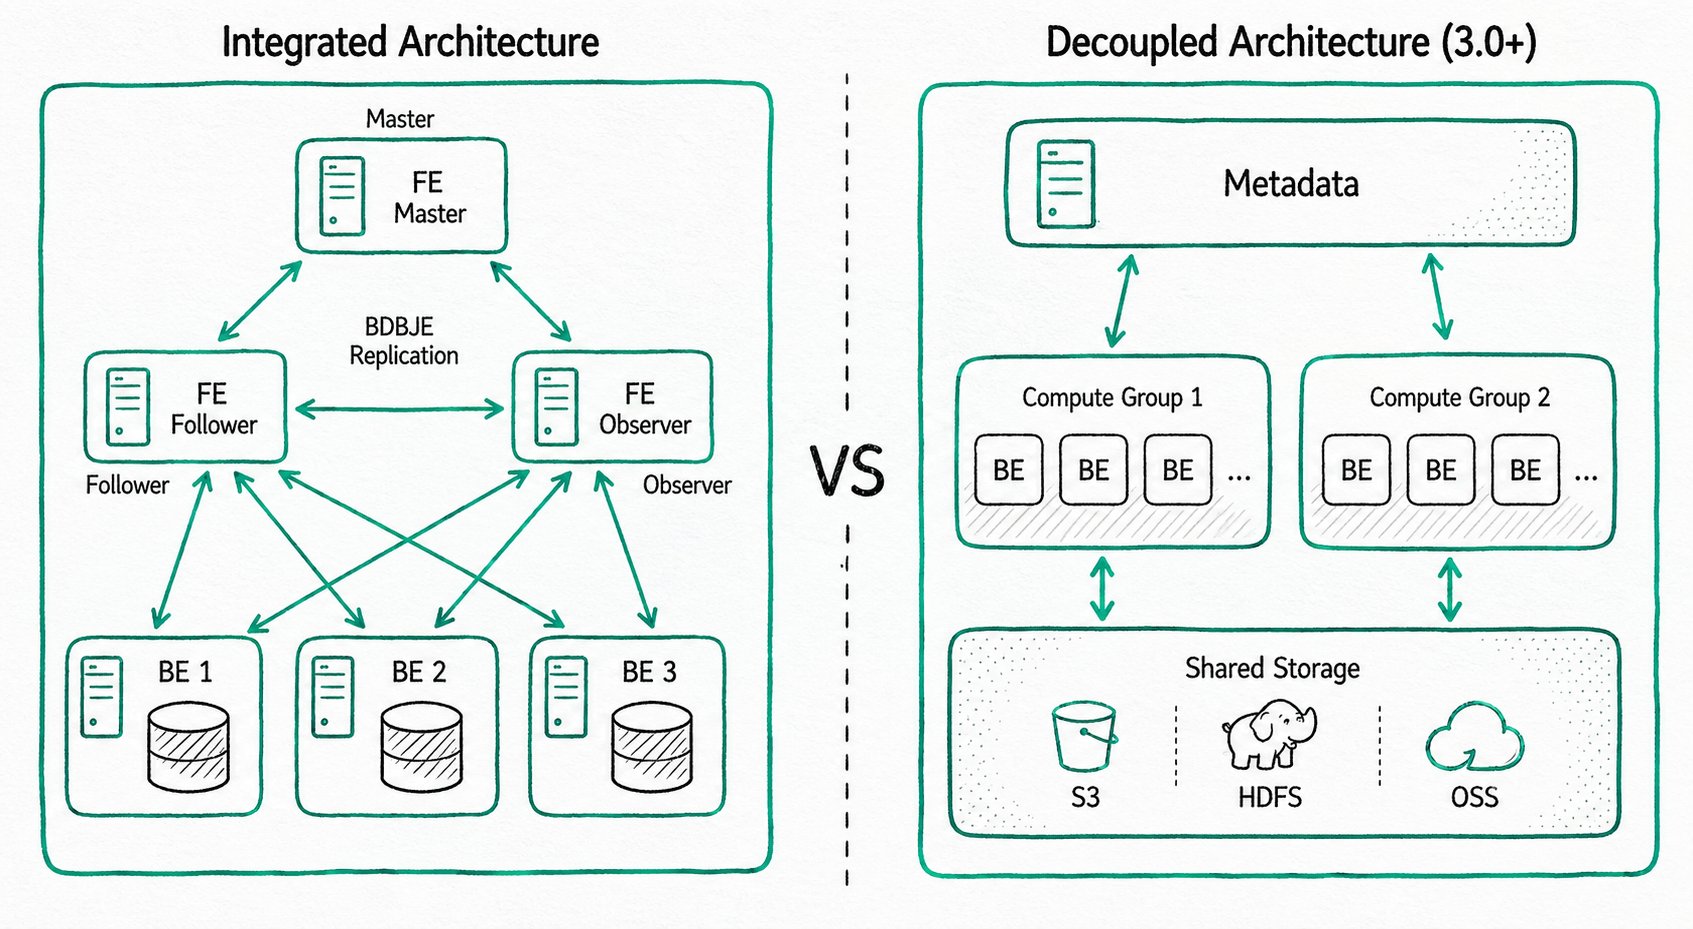
Apache Doris는 MySQL 프로토콜과 높은 호환성을 갖추고 표준 SQL을 지원합니다. 다양한 클라이언트 도구로 접근할 수 있으며 BI 도구와도 원활하게 연동됩니다. 배포 시 비즈니스 요구 사항에 따라 스토리지와 컴퓨팅 통합 아키텍처 또는 스토리지와 컴퓨팅 분리 아키텍처를 선택할 수 있습니다.
스토리지와 컴퓨팅 통합 아키텍처
두 가지 유형의 프로세스로 구성된 간결한 아키텍처입니다.
- Frontend (FE): 요청 수신, 쿼리 구문 분석, 메타데이터 관리, 노드 관리를 담당합니다.
- Backend (BE): 데이터를 저장하고 쿼리를 실행합니다 (다중 복제본 저장).
운영 환경에서는 고가용성을 위해 여러 FE 노드를 배포합니다. FE 노드에는 Master, Follower, Observer의 세 가지 역할이 있습니다.
스토리지와 컴퓨팅 분리 아키텍처 (공유 스토리지)
스토리지와 컴퓨팅을 분리하여 저장 용량과 컴퓨팅 리소스를 독립적으로 확장할 수 있습니다.
- 컴퓨팅 계층: 여러 컴퓨팅 그룹으로 구성되며, 각 그룹은 독립적인 테넌트를 지원할 수 있습니다.
- 스토리지 계층: S3, HDFS, OSS 등의 공유 스토리지를 사용합니다.
선택 기준: 비즈니스 규모가 감당할 만하고 간단한 운영을 선호한다면 통합 아키텍처를 선택합니다. 탄력적인 확장이 필요하다면 분리 아키텍처를 선택합니다.
기술적 특징
스토리지 엔진
Apache Doris는 컬럼형 저장 기술을 사용하여 데이터를 컬럼 단위로 인코딩, 압축, 읽기 처리합니다. 이를 통해 높은 압축률을 달성하고 불필요한 데이터 스캔을 줄여 IO와 CPU 리소스를 효율적으로 사용합니다. 초광폭 테이블 시나리오 (10,000+ 컬럼)에 맞춰 최적화되어 희소 컬럼을 효율적으로 저장하고 쿼리할 수 있습니다. 다양한 비즈니스 시나리오를 지원하기 위해 여러 인덱스 구조 (Sorted Compound Key, Min/Max, BloomFilter, 역색인, 벡터 인덱스)와 저장 모델 (Duplicate 모델, Aggregate 모델, Unique 모델)을 제공합니다. 또한 강한 일관성을 보장하는 단일 테이블 구체화된 뷰와 비동기로 갱신되는 다중 테이블 구체화된 뷰를 지원합니다.
- 컬럼형 저장: 컬럼 단위 인코딩, 압축, 읽기로 높은 압축률을 달성하고 IO를 줄입니다.
- 다양한 인덱스: Sorted Compound Key, Min/Max, BloomFilter, 역색인, 벡터 인덱스
- 저장 모델: Duplicate 모델, Aggregate 모델, Unique 모델 (행 단위 업데이트 지원)
- 구체화된 뷰: 강한 일관성을 보장하는 단일 테이블 구체화된 뷰와 비동기 다중 테이블 구체화된 뷰
벡터 인덱스와 역색인은 Hybrid Search (하이브리드 검색 및 분석)를 지원하는 핵심 기술입니다. 자세한 내용은 AI 개요를 참고하세요.
쿼리 엔진
Apache Doris 쿼리 엔진은 MPP (Massively Parallel Processing) 아키텍처를 기반으로 노드 간 및 노드 내 병렬 실행과 여러 대용량 테이블 간 분산 Shuffle Join을 지원합니다. 복잡한 다중 테이블 조인 시나리오에서는 전역 쿼리 계획, 분산 조인 전략, Runtime Filter 기술을 사용하여 데이터 전송을 크게 줄이고 조인 성능을 높입니다. Doris는 벡터화 실행을 사용합니다. 모든 메모리 내 구조가 컬럼형 레이아웃을 사용하므로 가상 함수 호출을 크게 줄이고 캐시 적중률을 높이며 SIMD 명령어를 효율적으로 활용합니다. 이를 통해 와이드 테이블 집계 시나리오에서 5-10배의 성능 향상을 제공합니다. Adaptive Query Execution (AQE)과 Pipeline 실행 엔진을 결합하여 런타임 통계를 기반으로 실행 계획을 동적으로 최적화하고 멀티코어 CPU를 충분히 활용합니다.
- MPP 아키텍처: 노드 간 및 노드 내 병렬 실행, 대용량 테이블을 위한 분산 Shuffle Join
- 벡터화 실행: 컬럼형 메모리 레이아웃, SIMD 명령어, 5-10배 성능 향상
- Adaptive Query Execution (AQE): Runtime Filter로 조인을 동적으로 최적화합니다.
- Pipeline 실행 엔진: 멀티코어 CPU에서 병렬로 실행하며, 스레드 수 제한으로 스레드 과다 생성을 방지합니다.
하이브리드 검색 기능 (AI 강화)
Apache Doris는 하나의 SQL 문에 정형 데이터 분석, 전문 검색, 벡터 검색을 결합합니다. 데이터 이동이나 이기종 시스템 통합 없이 하나의 시스템에서 벡터 유사도 검색, 키워드 필터링, 집계 분석을 함께 지원합니다. 동적 JSON 구조를 기본 지원하는 VARIANT 타입과 초 단위 필드 변경을 지원하는 Light Schema Change를 결합하여 RAG 애플리케이션, 의미 검색, 기업 지식 기반 등의 AI 시나리오에 효율적인 데이터 기반을 제공합니다.
SELECT * FROM products
WHERE match(query_vector, 'summer breathable shoes')  -- Vector similarity search
  AND body MATCH 'breathable lightweight'           -- Full-text keyword search
  AND category_id = 1                                -- Structured filtering
GROUP BY brand
ORDER BY sales_count DESC;
- 통합 아키텍처: 데이터 이동이나 이기종 시스템 통합이 필요하지 않습니다.
- 하이브리드 쿼리 성능: 하나의 SQL 문에서 벡터, 키워드, 집계 연산을 함께 실행합니다.
- VARIANT 타입: 동적 JSON을 기본 지원하며, Light Schema Change로 초 단위 필드 변경이 가능합니다.
생태계 연동
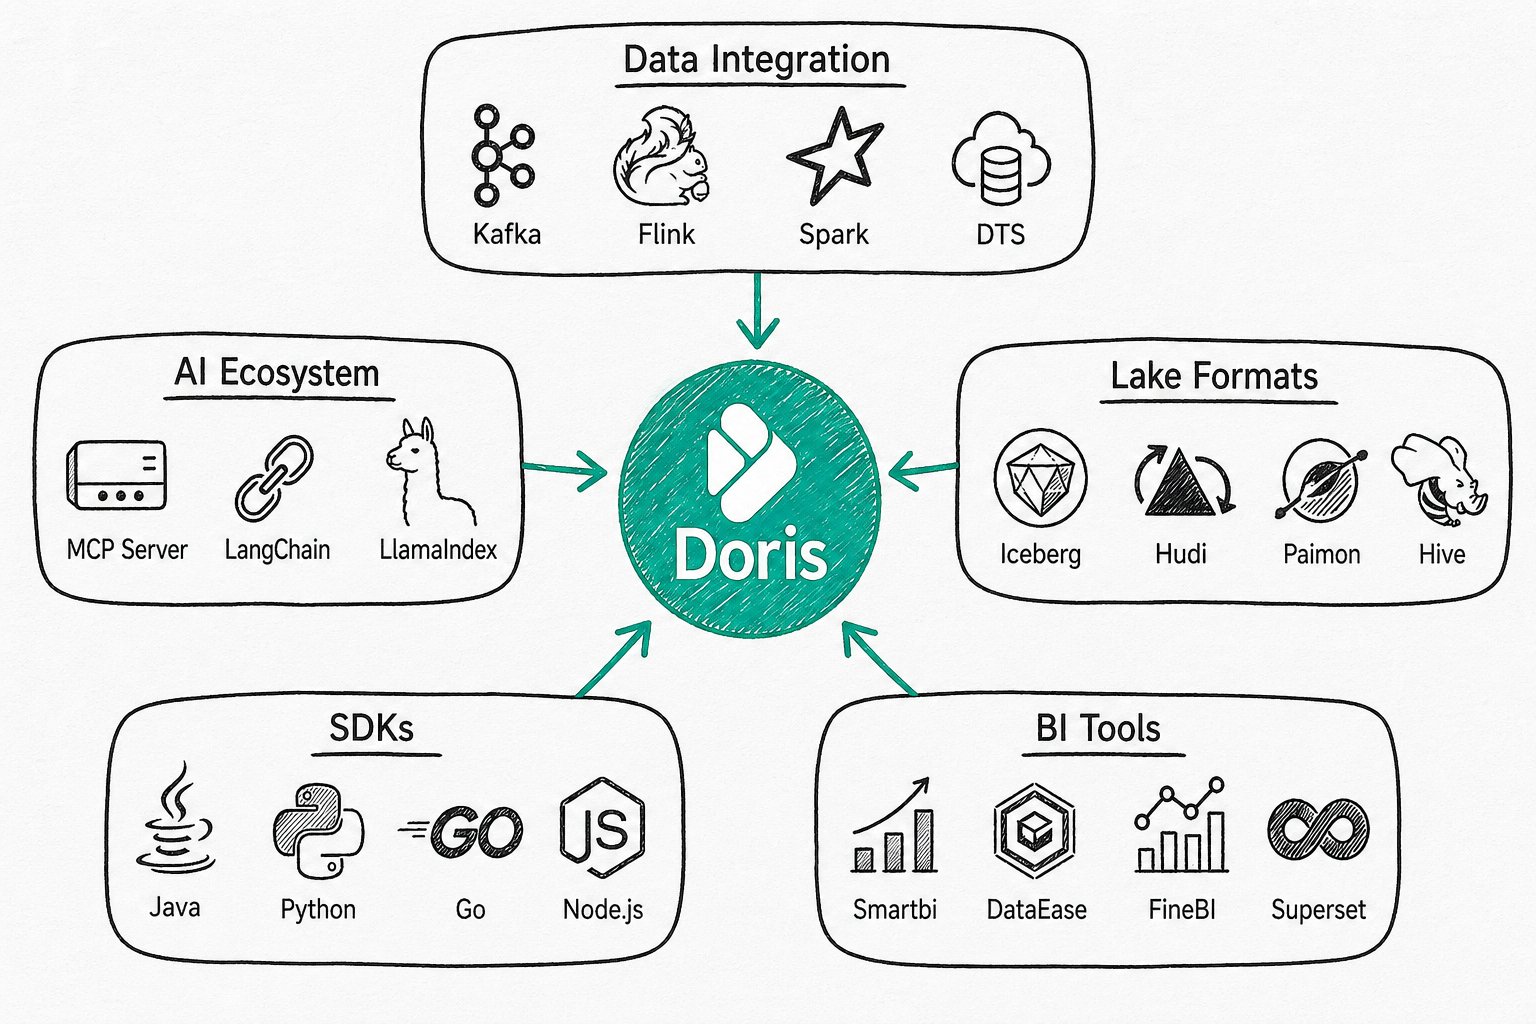
Apache Doris는 주요 데이터 생태계와 긴밀하게 연동됩니다.
커뮤니티 및 기여
커뮤니티에 참여해 주세요: https://doris.apache.org/community/join-community