하이브리드 검색
요약 Apache Doris 하이브리드 검색은 하나의 테이블에서 하나의 SQL 쿼리로 전문 검색 매칭과 벡터 유사도를 결합합니다. 일반적으로 Elasticsearch와 벡터 데이터베이스에 나누어 저장할 컬럼에 역색인과 ANN 인덱스를 모두 구성합니다. 하나의
WHERE절에서MATCH_ANY와l2_distance_approximate를 함께 사용하여 필터링과 순위 산정을 한 번에 처리합니다.
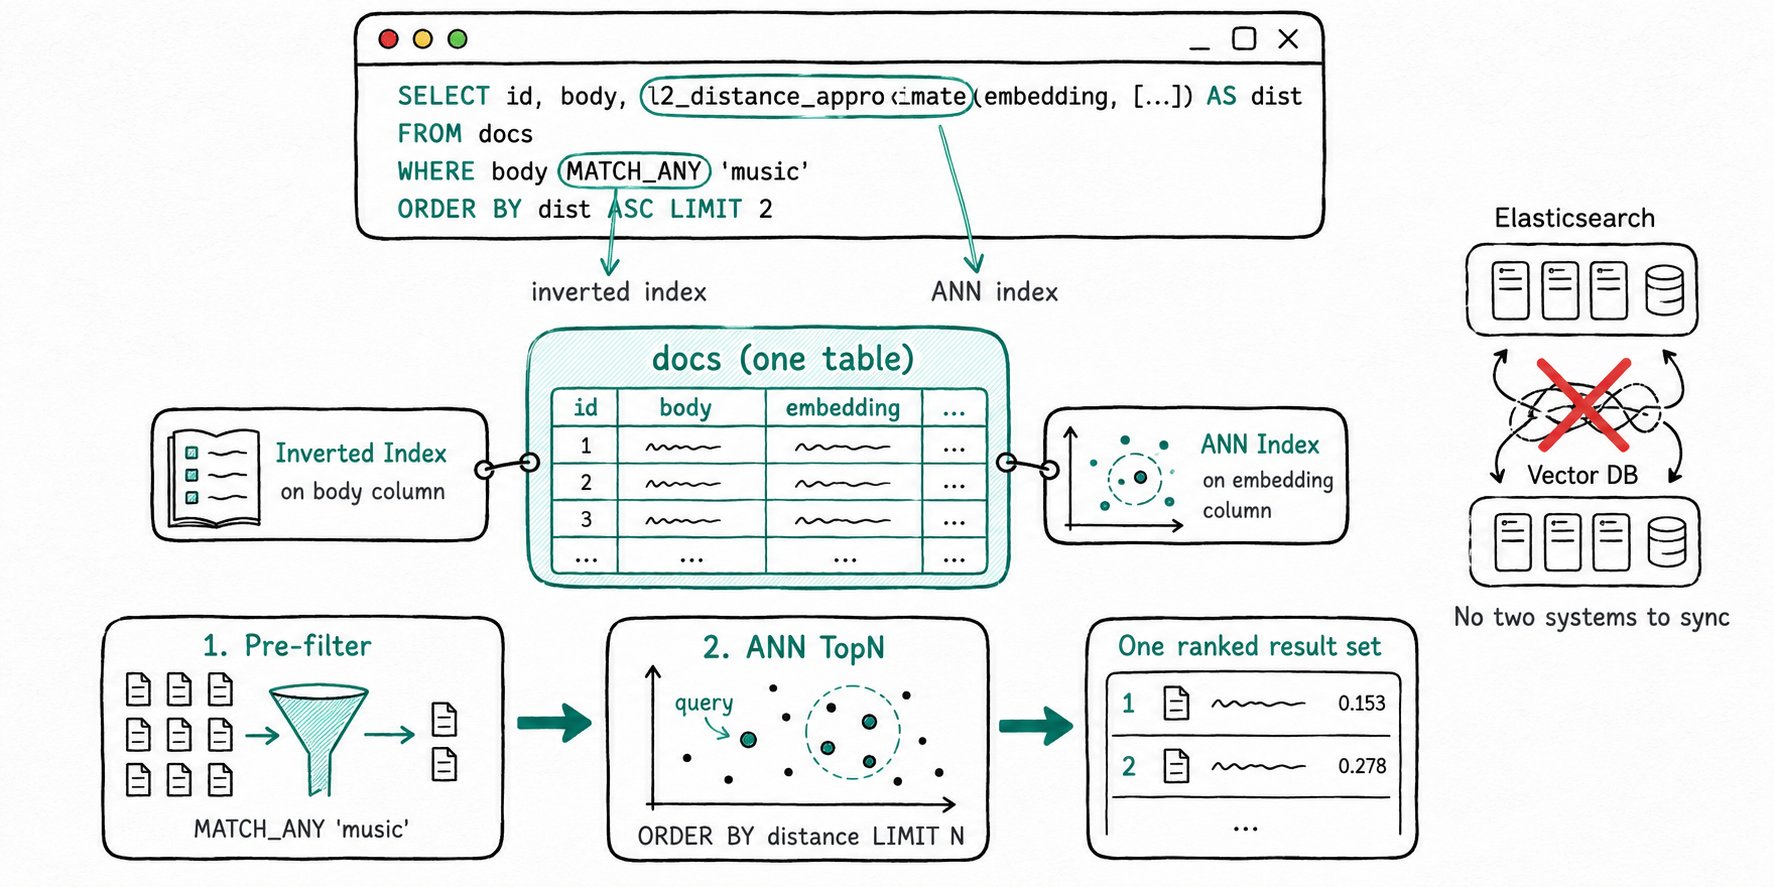
Apache Doris에서 하이브리드 검색을 사용하는 이유는 무엇인가요?
Apache Doris 하이브리드 검색은 두 가지 검색 방식을 하나의 SQL 쿼리로 통합하므로 웨어하우스와 별도로 검색 클러스터를 운영할 필요가 없습니다. 검색 워크로드에서 한 가지 검색 방식만 사용하는 경우는 드뭅니다. "가벼운 트레일 러닝화"를 검색하는 사용자는 "러닝"과 "트레일"이 정확히 일치하는 결과뿐 아니라 "오프로드"나 "거친 지형"을 설명하는 상품도 의미에 따라 검색되기를 원합니다. 일반적인 해결책은 두 시스템에 작업을 나누는 것이지만, 여기에는 다음과 같은 비용이 따릅니다.
- 두 데이터 수집 파이프라인을 동기화해야 하며, 그렇지 않으면 검색 재현율에 차이가 생깁니다.
- 두 쿼리 언어를 사용하고, 직접 작성한 결합 로직으로 결과를 합쳐야 합니다.
- 두 클러스터의 용량을 산정하고 모니터링하며 비용을 지불해야 합니다.
Apache Doris는 이를 하나의 테이블과 하나의 SQL 문으로 통합하며, 다른 쿼리를 실행하는 것과 동일한 MPP 엔진으로 처리합니다.
Apache Doris 하이브리드 검색이란 무엇인가요?
Apache Doris 하이브리드 검색은 별도의 엔진이 아니라 쿼리 패턴입니다. 하나의 테이블에 역색인과 ANN 인덱스를 모두 구성할 수 있습니다. 역색인은 MATCH_* 연산자와 score()를 통한 BM25 점수 산정을 지원하며, ANN 인덱스는 l2_distance_approximate와 inner_product_approximate 같은 근사 벡터 거리 함수를 지원합니다. Apache Doris 플래너는 하나의 쿼리에서 두 인덱스를 모두 읽고 순위가 매겨진 하나의 결과 집합을 반환합니다.
주요 용어
- 역색인:
STRING컬럼에 구성하는 전문 검색 인덱스입니다. 토크나이저로는english,standard, 중국어 등이 있습니다. - ANN 인덱스:
ARRAY<FLOAT>컬럼에 구성하는 근사 최근접 이웃 인덱스입니다. 백엔드로는 HNSW, IVF, IVF on-disk가 있습니다. - 사전 필터링: Apache Doris의 기본 전략입니다. 먼저 스칼라 조건과 텍스트 조건을 적용한 다음, 조건을 통과한 행에서 벡터 거리를 기준으로 TopN을 선택합니다.
Apache Doris 하이브리드 검색은 어떻게 동작하나요?
Apache Doris 하이브리드 검색은 데이터 적재 시 두 인덱스를 모두 구축한 다음, 역색인으로 필터링하고 ANN 인덱스로 순위를 매기는 단일 MPP 실행 계획에서 두 인덱스를 사용합니다.
- 데이터 적재 시 인덱스 구축. 데이터를 수집할 때 역색인은 각 텍스트 컬럼을 토큰화하고, ANN 인덱스는 각 벡터를 바탕으로 HNSW 그래프 또는 IVF 코드북을 구축합니다. 두 인덱스는 기본 테이블과 함께 동일한 스토리지 계층에 저장됩니다.
- 한 번에 실행 계획 수립. 쿼리에서
MATCH_*연산자와 벡터 거리 함수를 함께 사용하면 플래너는 텍스트 조건을 역색인으로, 거리 함수를 ANN 인덱스로 전달합니다. 두 번째 쿼리나 클라이언트 측 조인이 필요하지 않습니다. - 필터링 후 순위 산정. Apache Doris는 먼저 역색인으로 사전 필터링을 수행한 다음, 조건을 통과한 행 집합에서 ANN TopN을 실행합니다. 이는 일반적인 "ANN 검색 후 필터링" 패턴과 반대 순서이며, 필터 조건을 만족하는 행이 적을 때도 높은 검색 재현율을 유지합니다.
- 상황에 따른 대체 실행. 필터 조건을 만족하는 행이 너무 적어 ANN 탐색에서 지나치게 많은 후보를 건너뛰게 되면, Apache Doris는 필터링된 집합의 모든 벡터를 직접 계산하여 점수를 산정하는 방식으로 전환합니다. 동일한 SQL이 계속 동작하며 실행 경로만 달라집니다.
- 결과 반환. 정렬되고 개수가 제한된 하나의 결과 집합을 반환합니다. 외부 결합 서비스나 애플리케이션 측 순위 통합 로직이 필요하지 않습니다.
빠른 시작
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  body STRING NOT NULL,
  INDEX idx_body(body) USING INVERTED PROPERTIES("parser"="english"),
  INDEX idx_vec(embedding) USING ANN
    PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music'),
  (2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today'),
  (3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend'),
  (4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update');

SELECT id, body,
       l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
FROM docs
WHERE body MATCH_ANY 'music'   -- inverted index pre-filter
ORDER BY dist ASC              -- ANN TopN over the filtered rows
LIMIT 2;
예상 결과
+------+---------------------+----------+
| id   | body                | dist     |
+------+---------------------+----------+
|    1 | this is about music | 0.663325 |
|    3 | latest music trend  | 1.280625 |
+------+---------------------+----------+
MATCH_ANY 'music'은 후보 집합을 body에 "music"이 포함된 행으로 좁힙니다. 그런 다음 ANN 인덱스가 쿼리 벡터와의 거리를 기준으로 해당 행의 순위를 매겨 가장 가까운 두 행을 반환합니다.
Apache Doris 하이브리드 검색은 언제 사용해야 하나요?
별도의 벡터 데이터베이스를 운영하지 않고 동일한 데이터에 대해 하나의 SQL 쿼리로 키워드 필터링과 벡터 유사도 검색을 수행해야 할 때 Apache Doris 하이브리드 검색을 사용하세요.
적합한 경우
- 의미 기반 순위 산정 전에 키워드 필터(테넌트, 문서 유형, 날짜 범위)로 검색 대상 문서 집합을 좁혀야 하는 RAG 검색.
- 구조화된 필터(브랜드, 가격, 재고 여부)와 제목 및 설명의 임베딩 유사도를 함께 사용하는 제품 또는 Catalog 검색.
- 사용자가 "X를 반드시 포함"하는 조건과 "Y와 유사"한 조건을 자주 함께 사용하는 로그 및 문서 검색.
- SQL 분석을 위해 이미 Doris에 데이터를 저장하고 있으며, 벡터 데이터베이스로 복사본을 전송하고 싶지 않은 워크로드.
적합하지 않은 경우
- 필터링과 분석이 필요 없는 십억 건 규모의 순수 ANN 검색. 전용 벡터 데이터베이스가 메모리를 더 적게 사용하고 쿼리당 비용도 더 낮을 수 있습니다.
AGGREGATE KEY가 필요하거나 merge-on-write 없이UNIQUE KEY를 사용하는 테이블. 현재 ANN 인덱스에는DUPLICATE KEY또는 MoWUNIQUE KEY테이블이 필요합니다.- NULL을 허용하는 벡터 컬럼. 벡터 컬럼은
NOT NULL ARRAY<FLOAT>여야 하며, 인덱스와 일치하는 고정 차원을 가져야 합니다. - 두 점수 산정 방식의 결과를 Reciprocal Rank Fusion으로 결합해야 하는 워크로드. 단일 패스 패턴은 키워드 사전 필터링 후 벡터 거리를 기준으로 순위를 매깁니다. BM25 순위와 벡터 순위를 결합하려면 Reciprocal Rank Fusion의 두 목록을 사용하는 SQL 패턴을 사용하세요.
다른 방식과의 비교
| 항목 | Doris 하이브리드 검색 | Elasticsearch + 벡터 데이터베이스 | 벡터 데이터베이스만 사용 |
|---|---|---|---|
| 데이터 수집 파이프라인 | 하나 | 두 개, 동기화 유지 필요 | 하나 |
| 쿼리 경로 | 하나의 SQL | 애플리케이션 측 결합 | 하나의 API |
| 필터 표현력 | SQL 전체 기능(조인, 범위, 집계) | DSL, 제한적인 조인 | 태그와 메타데이터만 지원 |
| 동일한 데이터에 대한 분석 | MPP SQL 전체 기능 | 제한적 | 미지원 |
동일한 데이터에 대해 조인이나 집계도 필요하다면 Doris의 하이브리드 검색이 유용합니다. 매우 큰 규모에서 벡터 조회만 수행한다면 일반적으로 전용 벡터 데이터베이스를 운영하는 편이 더 간단합니다.
추가 자료
- 벡터 인덱스: 하이브리드 검색에서 벡터 검색을 담당하는 ANN 인덱스입니다.
- 전문 검색: 토크나이저와
MATCH_*연산자 계열을 포함한 역색인 기반 검색을 설명합니다. - BM25 관련성 점수 산정:
score()가 텍스트 매칭 결과의 순위를 매기는 방법을 설명합니다. 두 점수 산정 방식을 사용하는 패턴에서는 벡터 거리와 함께 사용하세요. - Reciprocal Rank Fusion: 단일 패스 결합만으로 충분하지 않을 때 BM25 순위와 벡터 순위를 결합하는 SQL 패턴입니다.
- 임베딩:
EMBED()는 ANN 인덱스가 읽는 벡터를 생성합니다. - 벡터 인덱스 개요: 인덱스 속성과 쿼리 패턴에 대한 전체 참조 문서입니다.
- 역색인 개요: 토크나이저, MATCH 연산자, 분석기 선택 방법을 설명합니다.
- 벡터 검색 실전 가이드: 데이터 준비부터 튜닝까지 전체 과정을 안내합니다.
- Doris의 AI: 하이브리드 검색과 Doris의 다른 AI 기능을 함께 활용하는 방법을 설명합니다.