Glue + AWS S3 Tables 연동
AWS S3 Tables는 Apache Iceberg 테이블 형식 표준과 호환되는 읽기 및 쓰기 인터페이스를 제공하는 특수한 유형의 S3 Bucket입니다. Amazon S3를 기반으로 구축되어 S3 자체와 동일한 내구성, 가용성, 확장성 및 성능 특성을 제공합니다. 또한 S3 Tables는 다음과 같은 기능을 제공합니다:
- 일반 S3 Bucket에 저장된 Iceberg 테이블과 비교하면, S3 Tables는 쿼리 성능이 최대 3x, 초당 트랜잭션 수가 최대 10x 더 높습니다.
- 자동화된 테이블 관리. S3 Tables는 작은 파일 병합, 스냅샷 관리, 불필요한 파일 정리 등을 통해 Iceberg 테이블 데이터를 자동으로 최적화합니다.
S3 Tables의 출시로 Lakehouse 아키텍처가 더욱 단순해지고, 클라우드 네이티브 레이크 웨어하우스 시스템의 가능성이 넓어졌습니다. 여기에는 콜드·핫 데이터 분리, 데이터 아카이빙, 데이터 백업, 컴퓨팅과 스토리지 분리 아키텍처가 포함되며, 이들 모두 S3 Tables를 기반으로 완전히 새로운 아키텍처로 발전할 수 있습니다.
Amazon S3 Tables는 Iceberg API와 호환성이 높으므로 Apache Doris를 S3 Tables와 빠르게 연동할 수 있습니다. 이 글에서는 Apache Doris를 S3 Tables에 연결하여 데이터를 분석하고 처리하는 방법을 설명합니다.
이 기능은 Doris 3.1부터 지원됩니다
사용 가이드
01 S3 Table Bucket 생성
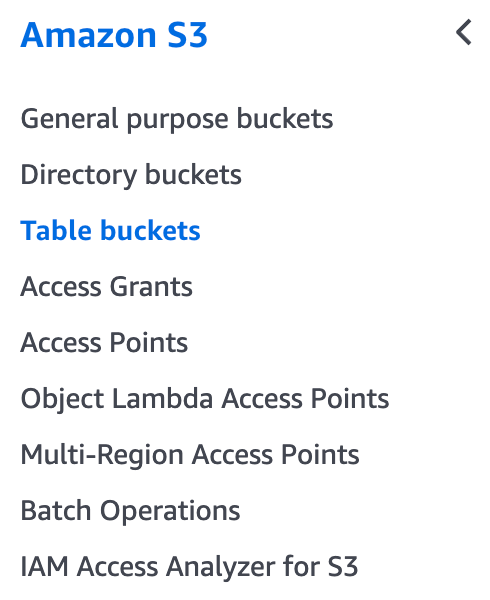
S3 Table Bucket은 S3에서 출시한 세 번째 유형의 Bucket으로, 기존 General purpose bucket 및 Directory bucket과 동등한 유형입니다.
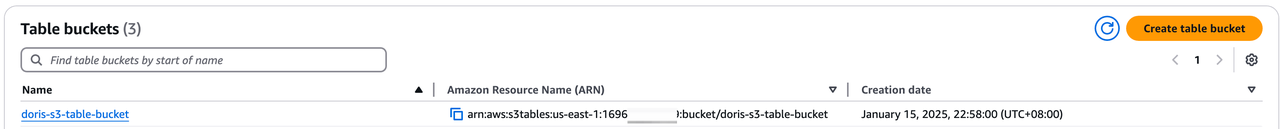
여기서는 이름이 doris-s3-table-bucket인 Table Bucket을 생성합니다. 생성된 Table Bucket은 ARN으로 식별됩니다.
02 Iceberg Catalog 생성
-
AWS S3 Table Rest Catalog를 사용하여
s3 tables에 연결CREATE CATALOG aws_s3_tables PROPERTIES (
'type' = 'iceberg',
'iceberg.catalog.type' = 'rest',
'warehouse' = 'arn:aws:s3tables:us-east-1:<account_id>:bucket/<s3_table_bucket_name>',
'iceberg.rest.uri' = 'https://s3tables.us-east-1.amazonaws.com/iceberg',
'iceberg.rest.sigv4-enabled' = 'true',
'iceberg.rest.signing-name' = 's3tables',
'iceberg.rest.signing-region' = 'us-east-1',
'iceberg.rest.access-key-id' = '<ak>',
'iceberg.rest.secret-access-key' = '<sk>'
); -
Glue Rest Catalog를 사용하여
s3 tables에 연결CREATE CATALOG glue_s3 PROPERTIES (
'type' = 'iceberg',
'iceberg.catalog.type' = 'rest',
'iceberg.rest.uri' = 'https://glue.<region>.amazonaws.com/iceberg',
'warehouse' = '<acount_id>:s3tablescatalog/<s3_table_bucket_name>',
'iceberg.rest.sigv4-enabled' = 'true',
'iceberg.rest.signing-name' = 'glue',
'iceberg.rest.access-key-id' = '<ak>',
'iceberg.rest.secret-access-key' = '<sk>',
'iceberg.rest.signing-region' = '<region>'
);
03 S3Tables 접근
Doris > SWITCH aws_s3_tables;

Doris > SHOW DATABASES;
+--------------------+
| Database           |
+--------------------+
| information_schema |
| my_namespace       |
| mysql              |
+--------------------+

Doris > USE my_namespace;

Doris > SHOW TABLES;
+------------------------+
| Tables_in_my_namespace |
+------------------------+
| my_table               |
+------------------------+

Doris > SELECT * FROM my_table;
+------+------+-------+
| id   | name | value |
+------+------+-------+
|    1 | ABC  |   100 |
|    2 | XYZ  |   200 |
+------+------+-------+
04 S3Tables 테이블 생성 및 데이터 쓰기
Doris > CREATE TABLE partition_table (
    ->   `ts` DATETIME COMMENT 'ts',
    ->   `id` INT COMMENT 'col1',
    ->   `pt1` STRING COMMENT 'pt1',
    ->   `pt2` STRING COMMENT 'pt2'
    -> )
    -> PARTITION BY LIST (day(ts), pt1, pt2) ();

Doris > INSERT INTO partition_table VALUES
    -> ("2024-01-01 08:00:00", 1000, "us-east", "PART1"),
    -> ("2024-01-02 10:00:00", 1002, "us-sout", "PART2");
Query OK, 2 rows affected
{'status':'COMMITTED', 'txnId':'1736935786473'}

Doris > SELECT * FROM partition_table;
+----------------------------+------+---------+-------+
| ts                         | id   | pt1     | pt2   |
+----------------------------+------+---------+-------+
| 2024-01-02 10:00:00.000000 | 1002 | us-sout | PART2 |
| 2024-01-01 08:00:00.000000 | 1000 | us-east | PART1 |
+----------------------------+------+---------+-------+
05 Time Travel 사용
데이터를 한 번 더 삽입한 다음, $snapshots 시스템 테이블을 사용하여 Iceberg 스냅샷을 확인할 수 있습니다:
Doris > INSERT INTO partition_table VALUES
    -> ("2024-01-03 08:00:00", 1000, "us-east", "PART1"),
    -> ("2024-01-04 10:00:00", 1002, "us-sout", "PART2");
Query OK, 2 rows affected (9.76 sec)
{'status':'COMMITTED', 'txnId':'1736935786474'}
Doris > SELECT * FROM partition_table$snapshots\G
*************************** 1. row ***************************
 committed_at: 2025-01-15 23:27:01
  snapshot_id: 6834769222601914216
    parent_id: -1
    operation: append
manifest_list: s3://80afcb3f-6edf-46f2-7fhehwj6cengfwc7n6iz7ipzakd7quse1b--table-s3/metadata/snap-6834769222601914216-1-a6b2230d-fc0d-4c1d-8f20-94bb798f27b1.avro
      summary: {"added-data-files":"2","added-records":"2","added-files-size":"5152","changed-partition-count":"2","total-records":"2","total-files-size":"5152","total-data-files":"2","total-delete-files":"0","total-position-deletes":"0","total-equality-deletes":"0","iceberg-version":"Apache Iceberg 1.6.1 (commit 8e9d59d299be42b0bca9461457cd1e95dbaad086)"}
*************************** 2. row ***************************
 committed_at: 2025-01-15 23:30:00
  snapshot_id: 5670090782912867298
    parent_id: 6834769222601914216
    operation: append
manifest_list: s3://80afcb3f-6edf-46f2-7fhehwj6cengfwc7n6iz7ipzakd7quse1b--table-s3/metadata/snap-5670090782912867298-1-beeed339-be96-4710-858b-f39bb01cc3ff.avro
      summary: {"added-data-files":"2","added-records":"2","added-files-size":"5152","changed-partition-count":"2","total-records":"4","total-files-size":"10304","total-data-files":"4","total-delete-files":"0","total-position-deletes":"0","total-equality-deletes":"0","iceberg-version":"Apache Iceberg 1.6.1 (commit 8e9d59d299be42b0bca9461457cd1e95dbaad086)"}
VERSION AS OF 구문을 사용하여 서로 다른 스냅샷을 쿼리합니다:
Doris > SELECT * FROM partition_table FOR VERSION AS OF 5670090782912867298;
+----------------------------+------+---------+-------+
| ts                         | id   | pt1     | pt2   |
+----------------------------+------+---------+-------+
| 2024-01-04 10:00:00.000000 | 1002 | us-sout | PART2 |
| 2024-01-03 08:00:00.000000 | 1000 | us-east | PART1 |
| 2024-01-01 08:00:00.000000 | 1000 | us-east | PART1 |
| 2024-01-02 10:00:00.000000 | 1002 | us-sout | PART2 |
+----------------------------+------+---------+-------+

Doris > SELECT * FROM partition_table FOR VERSION AS OF 6834769222601914216;
+----------------------------+------+---------+-------+
| ts                         | id   | pt1     | pt2   |
+----------------------------+------+---------+-------+
| 2024-01-02 10:00:00.000000 | 1002 | us-sout | PART2 |
| 2024-01-01 08:00:00.000000 | 1000 | us-east | PART1 |
+----------------------------+------+---------+-------+
06 EMR Spark를 사용하여 S3 Tables 접근
Doris를 사용하여 쓴 데이터는 Spark로도 접근할 수 있습니다:
spark-shell --jars /usr/share/aws/iceberg/lib//iceberg-spark-runtime-3.5_2.12-1.6.1-amzn-1.jar \
--packages software.amazon.s3tables:s3-tables-catalog-for-iceberg-runtime:0.1.3 \
--conf spark.sql.catalog.s3tablesbucket=org.apache.iceberg.spark.SparkCatalog \
--conf spark.sql.catalog.s3tablesbucket.catalog-impl=software.amazon.s3tables.iceberg.S3TablesCatalog \
--conf spark.sql.catalog.s3tablesbucket.warehouse=arn:aws:s3tables:us-east-1:169698000000:bucket/doris-s3-table-bucket \
--conf spark.sql.defaultCatalog=s3tablesbucket \
--conf spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions
scala> spark.sql("SELECT * FROM s3tablesbucket.my_namespace.`partition_table` ").show()
+-------------------+----+-------+-----+
|                 ts|  id|    pt1|  pt2|
+-------------------+----+-------+-----+
|2024-01-02 10:00:00|1002|us-sout|PART2|
|2024-01-01 08:00:00|1000|us-east|PART1|
|2024-01-04 10:00:00|1002|us-sout|PART2|
|2024-01-03 08:00:00|1000|us-east|PART1|
+-------------------+----+-------+-----+