Apache Doris 기반 통합 Log/Trace/Metrics 분석 구축
옵저버빌리티는 시스템이 외부로 출력하는 데이터를 통해 내부 상태를 추론할 수 있는 능력입니다. 옵저버빌리티 플랫폼은 Logging, Tracing, Metrics라는 세 가지 핵심 데이터를 수집, 저장하고 시각화합니다. 이를 통해 팀은 분산 시스템의 실행 상태를 종합적으로 파악할 수 있습니다. 또한 리소스 최적화, 장애 알림, 근본 원인 분석을 지원하여 궁극적으로 시스템 신뢰성과 사용자 경험을 개선합니다.
옵저버빌리티가 점점 더 중요해지는 이유
주요 활용 시나리오
옵저버빌리티 플랫폼은 현대적인 분산 시스템의 필수 인프라로 자리 잡았으며, 주로 다음 다섯 가지 시나리오에 활용됩니다.
| 시나리오 | 가치 | 대표적인 활용 사례 |
|---|---|---|
| 문제 해결 및 근본 원인 분석 | 장애 복구 시간을 단축하고 비즈니스 연속성 보장 | 실시간 모니터링, 이상 탐지, 분산 추적, 카오스 엔지니어링 |
| 성능 최적화 및 리소스 계획 | 성능 병목을 파악하고 클라우드 리소스 비용 절감 | 리소스 사용률 분석, 부하 분산, 자동 확장, 용량 예측 |
| 비즈니스 의사결정 지원 | IT 성능을 비즈니스 성과와 연결 | 사용자 경험 지표 분석, 제품 기능 최적화 |
| 보안 및 규정 준수 모니터링 | 비정상적인 동작을 탐지하고 자동으로 대응 | 제로데이 공격 탐지, 로그 감사, 규정 준수를 위한 데이터 보관 |
| 개발 및 운영 협업 | 카나리 배포와 코드 최적화 지원 | 트래픽 태깅, 호출 체인 분석, 배포 진행 상황 평가 |
옵저버빌리티 고도화를 이끄는 두 가지 주요 추세
- 비즈니스 및 IT 시스템의 복잡성 증가: 클라우드 컴퓨팅과 마이크로서비스의 발전으로 GenAI 애플리케이션의 요청 하나가 App, 서비스 게이트웨이, 인증 서비스, 과금 서비스, RAG 엔진, Agent 엔진, 벡터 데이터베이스, 비즈니스 데이터베이스, 분산 캐시, 메시지 큐, 대규모 모델 API 등 수십 개의 서비스를 거칠 수 있습니다. 이처럼 복잡한 시스템에서는 서버에 로그인하여 실행 상태를 확인하고 장애를 분석하는 방식으로는 더 이상 효과적으로 대응하기 어렵습니다. 옵저버빌리티 플랫폼은 Log, Trace, Metrics 데이터의 수집과 저장을 통합하고 일관된 시각화 분석 기능을 제공하여 문제를 빠르고 효과적으로 드러냅니다.
- 비즈니스 신뢰성 요구 수준의 상승: 시스템 장애가 사용자 경험에 미치는 영향과 그에 따른 비용이 커지면서 장애 위치 파악과 복구 효율에 대한 요구도 높아지고 있습니다. 옵저버빌리티는 도메인 간 데이터 통합과 전체 현황 시각화를 통해 팀이 문제의 근본 원인을 빠르게 찾아 비즈니스 중단 시간을 줄이도록 지원합니다. 또한 전체 데이터 분석과 예측을 통해 리소스 병목을 미리 파악하므로, 팀은 조기에 대응하여 장애를 예방할 수 있습니다.
옵저버빌리티 솔루션 선택 방법
옵저버빌리티 데이터의 주요 특성
대규모 데이터의 저장과 분석 문제를 해결하는 것은 모든 옵저버빌리티 솔루션의 핵심 과제입니다. 옵저버빌리티 데이터에는 다음과 같은 다섯 가지 특성이 있습니다.
- 방대한 데이터 저장량과 높은 비용 민감도: Log와 Trace 데이터는 일반적으로 규모가 매우 크고 하루 종일 지속적으로 생성됩니다. 중견·대기업이 매일 생성하는 옵저버빌리티 데이터는 TB, 심지어 PB 규모에 이릅니다. 비즈니스 요구나 규제 요건을 충족하기 위해 데이터를 반년 이상 보관해야 하는 경우가 많으며, 전체 저장량은 흔히 PB 규모에 달해 높은 비용이 발생합니다. 시간이 지날수록 데이터의 가치도 점차 낮아지므로 옵저버빌리티 플랫폼은 저장 비용에 특히 민감합니다.
- 실시간 처리가 필요한 높은 쓰기 처리량: 매일 TB 또는 PB 규모의 새로운 데이터를 처리하려면 플랫폼은 1-10 GB/s의 쓰기 처리량과 초당 수백만~수천만 건의 레코드 쓰기를 지원해야 합니다. 동시에 문제 해결이나 보안 추적처럼 신속한 대응이 필요한 시나리오를 고려하면, 데이터의 최신성과 가용성을 보장하도록 쓰기 지연 시간을 초 단위로 유지해야 합니다.
- 전문 검색을 활용한 실시간 분석: Log와 Trace 데이터에는 텍스트가 많이 포함되어 있어 키워드와 구문을 빠르게 검색하는 것이 핵심 요구 사항입니다. 데이터 규모가 방대하므로 기존의 전체 스캔과 문자열 매칭 방식으로는 실시간 응답 요구를 충족할 수 없습니다. 텍스트에 역색인을 구축하는 것이 초 단위 쿼리 응답을 구현하는 핵심입니다.
- 빈번한 확장이 필요한 동적 스키마: 로그 데이터는 비정형 원시 로그(자유 형식 텍스트)에서 주로 JSON 형식의 반정형 Log와 Trace로 발전해 왔습니다. 데이터 생성 주체가 JSON 내부 필드를 동적으로 조정하므로 스키마가 매우 유연합니다. 기존 데이터베이스와 데이터 웨어하우스는 이처럼 유연한 스키마를 가진 데이터를 효율적으로 처리하기 어렵습니다. 데이터 레이크는 저장의 유연성을 제공하지만 처리 성능과 실시간 요구 사항을 충족하지 못합니다.
- 다양한 데이터 소스 및 분석 도구와의 통합 필요: 옵저버빌리티 생태계에는 다양한 데이터 수집기와 시각화 분석 도구가 있습니다. 저장 및 분석 엔진은 다양한 데이터와 도구의 통합 요구를 충족하도록 여러 생태계 도구와 연동되어야 합니다.
솔루션 평가를 위한 네 가지 핵심 기준
Elasticsearch, ClickHouse, Doris, 클라우드 공급업체의 로그 서비스 등 여러 솔루션을 성능, 비용, 개방성, 사용 편의성이라는 네 가지 기준으로 평가할 수 있습니다.
1. 성능: 쓰기 성능과 쿼리 성능
옵저버빌리티는 문제 해결처럼 긴급한 상황에서 자주 활용되므로 쿼리 응답 속도와 데이터 최신성 모두에 높은 수준이 요구됩니다. 한편으로는 쿼리 응답이 빨라야 합니다. 특히 Log/Trace 데이터의 텍스트에 대해 실시간 전문 검색을 제공해야 반복적인 탐색 분석을 지원할 수 있습니다. 다른 한편으로는 가장 최근에 생성된 데이터를 쿼리할 수 있어야 하며, 초 단위의 데이터 최신성이 요구됩니다.
| 솔루션 | 쓰기 성능 | 전문 검색 | 집계 분석 |
|---|---|---|---|
| Elasticsearch | 처리량이 많을 때 쓰기 성능이 비교적 낮으며, 피크 시간대에는 쓰기 거부와 높은 지연 시간이 발생하기 쉬움 | 역색인 + 전문 검색으로 잘 알려져 있으며, 초 단위 실시간 검색 지원 | 집계 분석 성능이 비교적 낮음 |
| 클라우드 공급업체 로그 서비스 | 리소스를 추가하여 성능 확보 | 성능 요구 사항 충족 | 성능 요구 사항 충족 |
| ClickHouse | 열 지향 스토리지 + 벡터화 엔진으로 높은 쓰기 성능 제공 | Elasticsearch 및 Doris보다 몇 배에서 수십 배 느리며, 아직 실험 단계 | 높은 집계 쿼리 성능 |
| Doris | 열 지향 스토리지 + 벡터화 엔진에 옵저버빌리티에 최적화된 역색인을 결합하여 Elasticsearch보다 약 5배 빠름 | Elasticsearch보다 약 2배 빠름 | Elasticsearch보다 6-21배 빠름 |
2. 비용: 저장 비용과 컴퓨팅 비용
중견·대기업이 매일 생성하는 옵저버빌리티 데이터는 TB 또는 PB 규모에 이를 수 있으며, 전체 저장량은 흔히 PB, 심지어 EB 규모에 달합니다. 비즈니스 데이터와 비교하면 옵저버빌리티 데이터는 양이 더 많고 가치 밀도가 낮으며, 시간이 지나면서 가치가 점차 줄어듭니다. 따라서 저장 비용과 컴퓨팅 비용 모두에 매우 민감합니다.
| 솔루션 | 압축률 | 저장 / 컴퓨팅 비용 |
|---|---|---|
| Elasticsearch | 약 1.5:1(행 지향 스토리지 + 역색인 + docvalue 열 지향 스토리지) | 높은 저장 비용. JVM 오버헤드와 역색인 구축으로 높은 CPU 사용률 발생 |
| Doris | 5:1 ~ 10:1, 핫·콜드 계층화로 비용 추가 절감 | Elasticsearch 대비 50%-80% 절감. 단일 복제본 쓰기, 시계열 컴팩션, 벡터화된 인덱스 구축으로 쓰기 비용 절감 |
| ClickHouse | 압축률이 우수한 열 지향 스토리지 | 낮은 저장 및 쓰기 비용 |
| 클라우드 공급업체 로그 서비스 | - | Elasticsearch와 마찬가지로 높은 비용 |
3. 개방성: 오픈 소스와 멀티 클라우드 중립성
옵저버빌리티 플랫폼을 구축할 때는 특정 공급업체에 종속되지 않도록 해야 합니다. 솔루션이 오픈 소스인지, 여러 클라우드에서 제공되는지, 개방적인 생태계를 지원하는지 살펴보세요.
| 솔루션 | 프로젝트 운영 주체 | 멀티 클라우드 지원 | 생태계 개방성 |
|---|---|---|---|
| Elasticsearch | Elastic | 여러 클라우드에서 제공 | ELK 생태계는 다른 생태계와의 연계가 비교적 제한적이며, Kibana는 Elasticsearch만 지원 |
| Doris | Apache Software Foundation | 주요 클라우드 공급업체에서 SaaS 제공 | OpenTelemetry, Grafana, ELK 등 오픈 소스 생태계를 지원하며 중립성 유지 |
| ClickHouse | ClickHouse Inc. | 여러 클라우드에서 제공 | OpenTelemetry와 Grafana 지원. 옵저버빌리티 상용 솔루션 기업 인수 이후 중립성에 영향 |
| 클라우드 공급업체 로그 서비스 | 각 클라우드 공급업체 | 자체 클라우드에 종속 | 오픈 소스가 아니며, 클라우드 간 마이그레이션이 어려움 |
4. 사용 편의성: 유지보수성과 편의성
옵저버빌리티 플랫폼은 데이터 규모가 크기 때문에 일반적으로 분산 아키텍처를 채택합니다. 배포, 확장, 업그레이드와 같은 운영 작업의 편의성과 쿼리 인터페이스의 개발자 친화성은 모두 중요한 고려 사항입니다.
| 솔루션 | 인터페이스 및 운영 |
|---|---|
| Elasticsearch | Kibana는 사용하기 쉬운 인터페이스와 우수한 유지보수성을 제공하지만, DSL 쿼리 언어가 복잡하여 진입 장벽이 높음 |
| Doris | Kibana와 유사한 대화형 검색 및 분석 인터페이스를 제공하고 네이티브 Kibana / Grafana 인터페이스와 연동. MySQL과 호환되는 표준 SQL 지원. 아키텍처가 단순하며 온라인 업그레이드 및 확장, 자동 부하 분산을 지원하고 시각적 Cluster Manager 제공 |
| ClickHouse | 자체 SQL 방언 사용. 로컬 테이블 + 분산 테이블이라는 내부 개념이 사용자에게 노출되고, 확장 시 자동으로 부하를 분산할 수 없어 대개 별도의 운영 시스템 구축이 필요 |
| 클라우드 공급업체 로그 서비스 | SaaS 서비스로 직접 유지보수할 필요가 없으며 사용이 편리함 |
선택 결론
위 비교를 종합하면 Doris는 성능, 비용, 개방성, 사용 편의성이라는 네 가지 기준 모두에서 뚜렷한 장점을 갖추고 있습니다. 낮은 비용으로 높은 쓰기 및 쿼리 성능을 제공하고, SQL 인터페이스가 간단하여 사용하기 쉽습니다. 또한 단순한 아키텍처 덕분에 유지보수와 확장이 용이하며, 여러 클라우드에서 일관된 경험을 제공합니다. 따라서 옵저버빌리티 플랫폼 구축에 이상적인 선택입니다.
Doris 기반 옵저버빌리티 솔루션
시스템 아키텍처
Doris는 MPP 분산 아키텍처를 채택한 현대적인 데이터 웨어하우스입니다. 벡터화 실행 엔진, CBO 옵티마이저, 다양한 인덱스, 구체화된 뷰 등의 고급 기술을 결합하여 대규모 실시간 데이터를 매우 빠르게 쿼리하고 분석할 수 있습니다. Doris는 단일 테이블 벤치마크인 ClickBench와 다중 테이블 벤치마크인 TPC-H, TPC-DS를 비롯한 여러 권위 있는 분석 데이터베이스 성능 벤치마크에서 세계 최상위권, 나아가 최고 성적을 기록했습니다.
옵저버빌리티 시나리오의 특성에 맞춰 Doris는 역색인과 매우 빠른 전문 검색 기능을 추가하고, 쓰기 성능과 저장 공간 효율을 극대화했습니다. 이를 통해 사용자는 Doris를 기반으로 성능이 높고 비용이 낮으며 개방적인 옵저버빌리티 플랫폼을 구축할 수 있습니다.
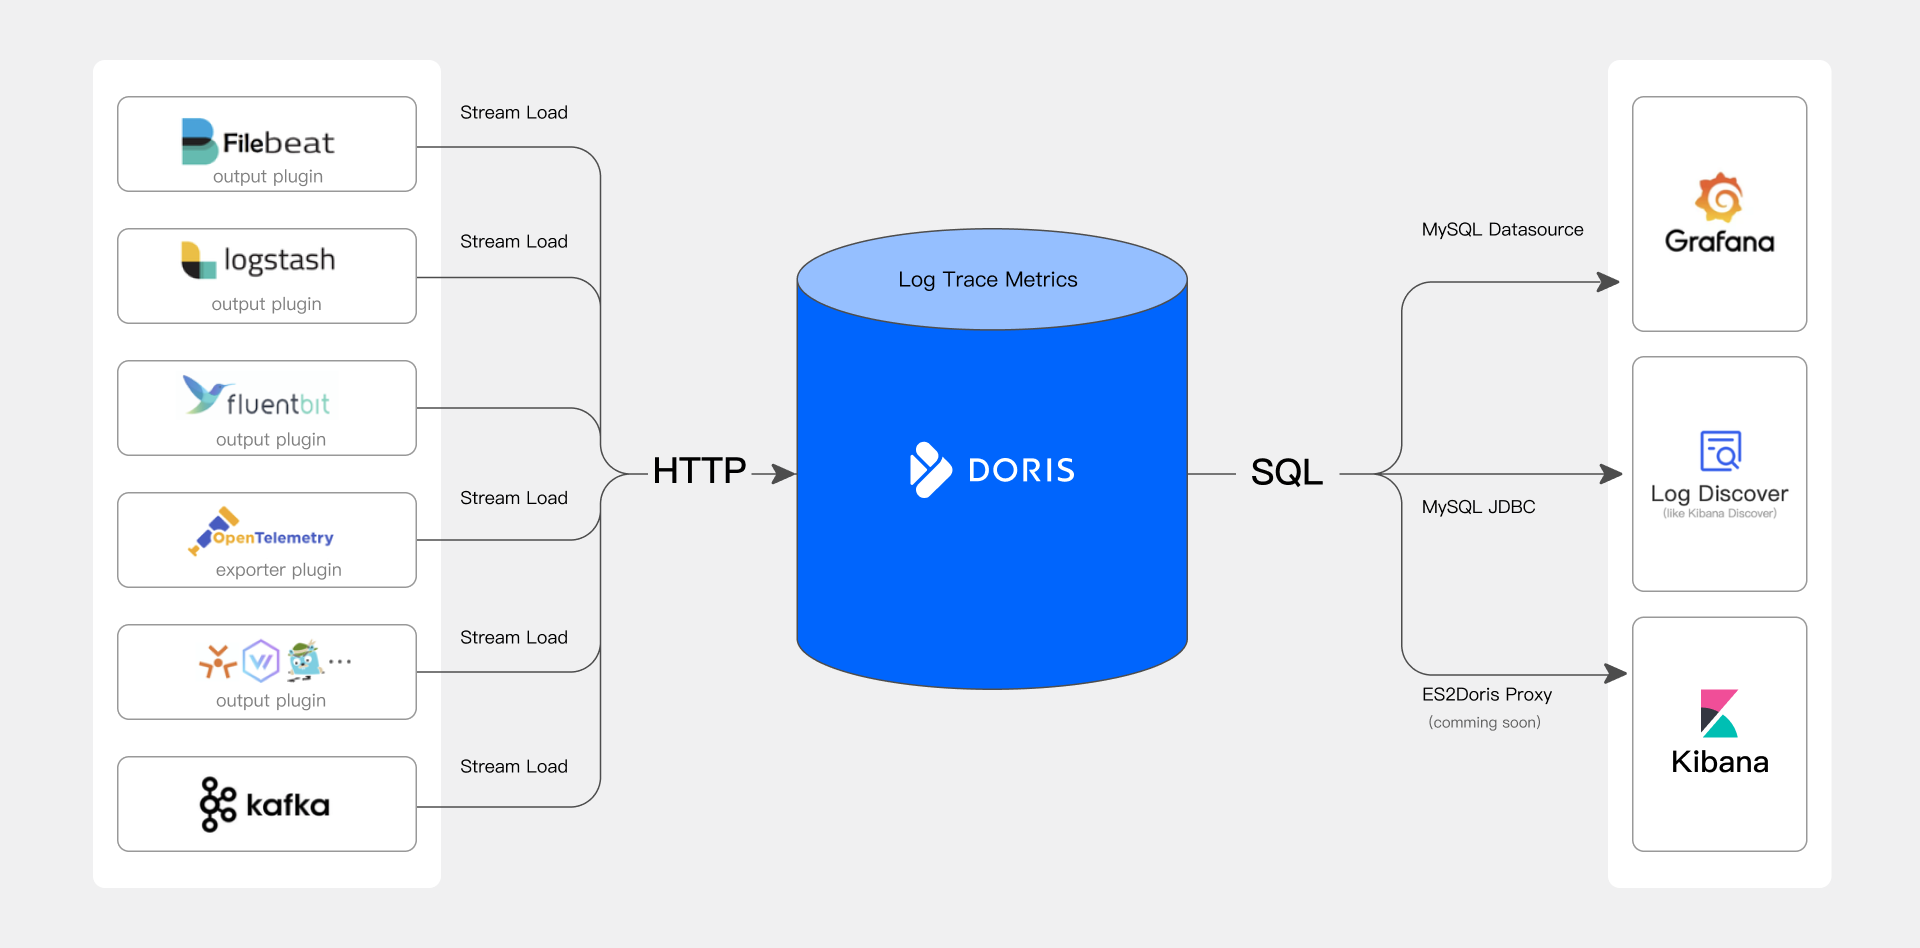
Doris 기반 옵저버빌리티 플랫폼은 세 가지 핵심 구성 요소로 이루어집니다.
- 데이터 수집 및 전처리: 개방형 OpenTelemetry 생태계와 ELK 생태계의 Logstash, Filebeat 등 다양한 옵저버빌리티 데이터 수집 도구를 지원합니다. 이러한 도구는 HTTP API를 통해 Log, Trace, Metrics 데이터를 Doris에 씁니다.
- 데이터 저장 및 분석 엔진: Doris는 옵저버빌리티 데이터를 높은 성능과 낮은 비용으로 통합 저장하고, SQL 인터페이스를 통해 풍부한 검색 및 분석 기능을 제공합니다.
- 쿼리 분석 및 시각화: 널리 사용되는 Grafana와 ELK 생태계의 Kibana 등 주요 시각화 분석 도구와 연동합니다. 사용자에게 간단하고 사용하기 쉬운 검색, 분석, 알림 인터페이스를 제공하여 실시간 모니터링과 신속한 대응을 지원합니다.
솔루션의 핵심 장점
높은 성능
- 높은 처리량과 낮은 지연 시간의 쓰기: 매일 PB 규모(10 GB/s)의 Log, Trace, Metrics 데이터를 지속적이고 안정적으로 쓸 수 있으며, 지연 시간을 초 단위, 나아가 1s 이내로 유지합니다.
- 고성능 역색인 및 전문 검색: 로그 키워드 검색과 같은 일반적인 쿼리에 초 단위로 응답하며, ClickHouse보다 3-10배 빠릅니다.
- 고성능 집계 분석: MPP 분산 아키텍처와 벡터화된 Pipeline 실행 엔진이 클러스터의 분산 처리 및 CPU 멀티스레딩 리소스를 충분히 활용합니다. ClickBench 테스트에서 세계 최상위권의 성능을 보이며, 추세 분석과 모니터링 알림 같은 일반적인 쿼리에 적합합니다.
낮은 비용
- 높은 압축률과 저렴한 저장 비용: PB 규모의 대용량 저장을 지원하며, 인덱스를 포함한 압축률은 5:1 ~ 10:1입니다. Elasticsearch보다 저장 비용을 50%-80% 절감할 수 있습니다. 콜드 데이터를 S3/HDFS에 저장할 수 있어 저장 비용을 추가로 50% 절감합니다.
- 저렴한 쓰기 비용: 동일한 쓰기 트래픽에서 Elasticsearch보다 CPU 리소스 사용량이 70% 넘게 감소합니다.
유연한 스키마
- 최상위 필드 변경: Light Schema Change를 통해 ADD/DROP COLUMN/INDEX 작업을 수행하여 수초 안에 스키마 변경을 완료할 수 있습니다. 설계 단계에서는 현재 어떤 필드에 인덱스가 필요한지만 고려하면 됩니다.
- 내부 필드 변경: 확장 가능한 JSON 데이터를 위해 설계된 반정형 데이터 타입 VARIANT는 JSON 필드 이름과 타입을 자동으로 인식하고, 자주 등장하는 필드를 열 지향 스토리지로 분리하여 압축률과 분석 성능을 높입니다. Elasticsearch의 Dynamic Mapping과 달리 VARIANT는 필드 타입 변경을 허용합니다.
사용 편의성
- 표준 SQL 인터페이스: MySQL 프로토콜 및 문법과 호환되므로 엔지니어와 데이터 분석가가 SQL 쿼리를 직접 사용할 수 있습니다.
- 옵저버빌리티 생태계 지원: OpenTelemetry와 ELK 생태계를 포괄하고 Grafana, Kibana 등의 시각화 도구와 연동하여 데이터 수집과 시각화 분석을 용이하게 합니다.
- 편리한 운영: 서비스 중단 없는 온라인 확장과 자동 부하 분산을 지원합니다. 온프레미스 배포에는 시각적 Cluster Manager와 K8s Operator 도구를 제공하며, 클라우드에서는 바로 사용할 수 있는 완전 관리형 서비스를 제공합니다.
개방성
- 오픈 소스: Doris는 Apache Software Foundation의 최상위 오픈 소스 프로젝트로, 전 세계 5,000개가 넘는 기업에서 사용하고 있으며 OpenTelemetry, Grafana 등의 옵저버빌리티 생태계를 지원합니다.
- 멀티 클라우드 중립성: 주요 클라우드 공급업체가 Doris SaaS를 제공하므로 여러 클라우드에서 일관된 경험을 누릴 수 있습니다.
데모 및 스크린샷
다음에서는 OpenTelemetry 커뮤니티의 종합 데모를 통해 Doris 기반 옵저버빌리티 플랫폼을 살펴봅니다.
관측 대상 시스템
관측 대상 비즈니스 시스템은 시연용 전자상거래 웹사이트입니다. 프런트엔드 인터페이스, 인증, 장바구니, 거래, 물류, 광고, 추천, 위험 관리 등 열 개가 넘는 모듈로 구성됩니다. 전체 시스템의 복잡성이 높아 옵저버빌리티 데이터의 수집, 저장, 분석에 상당한 어려움이 따릅니다.
데이터 흐름
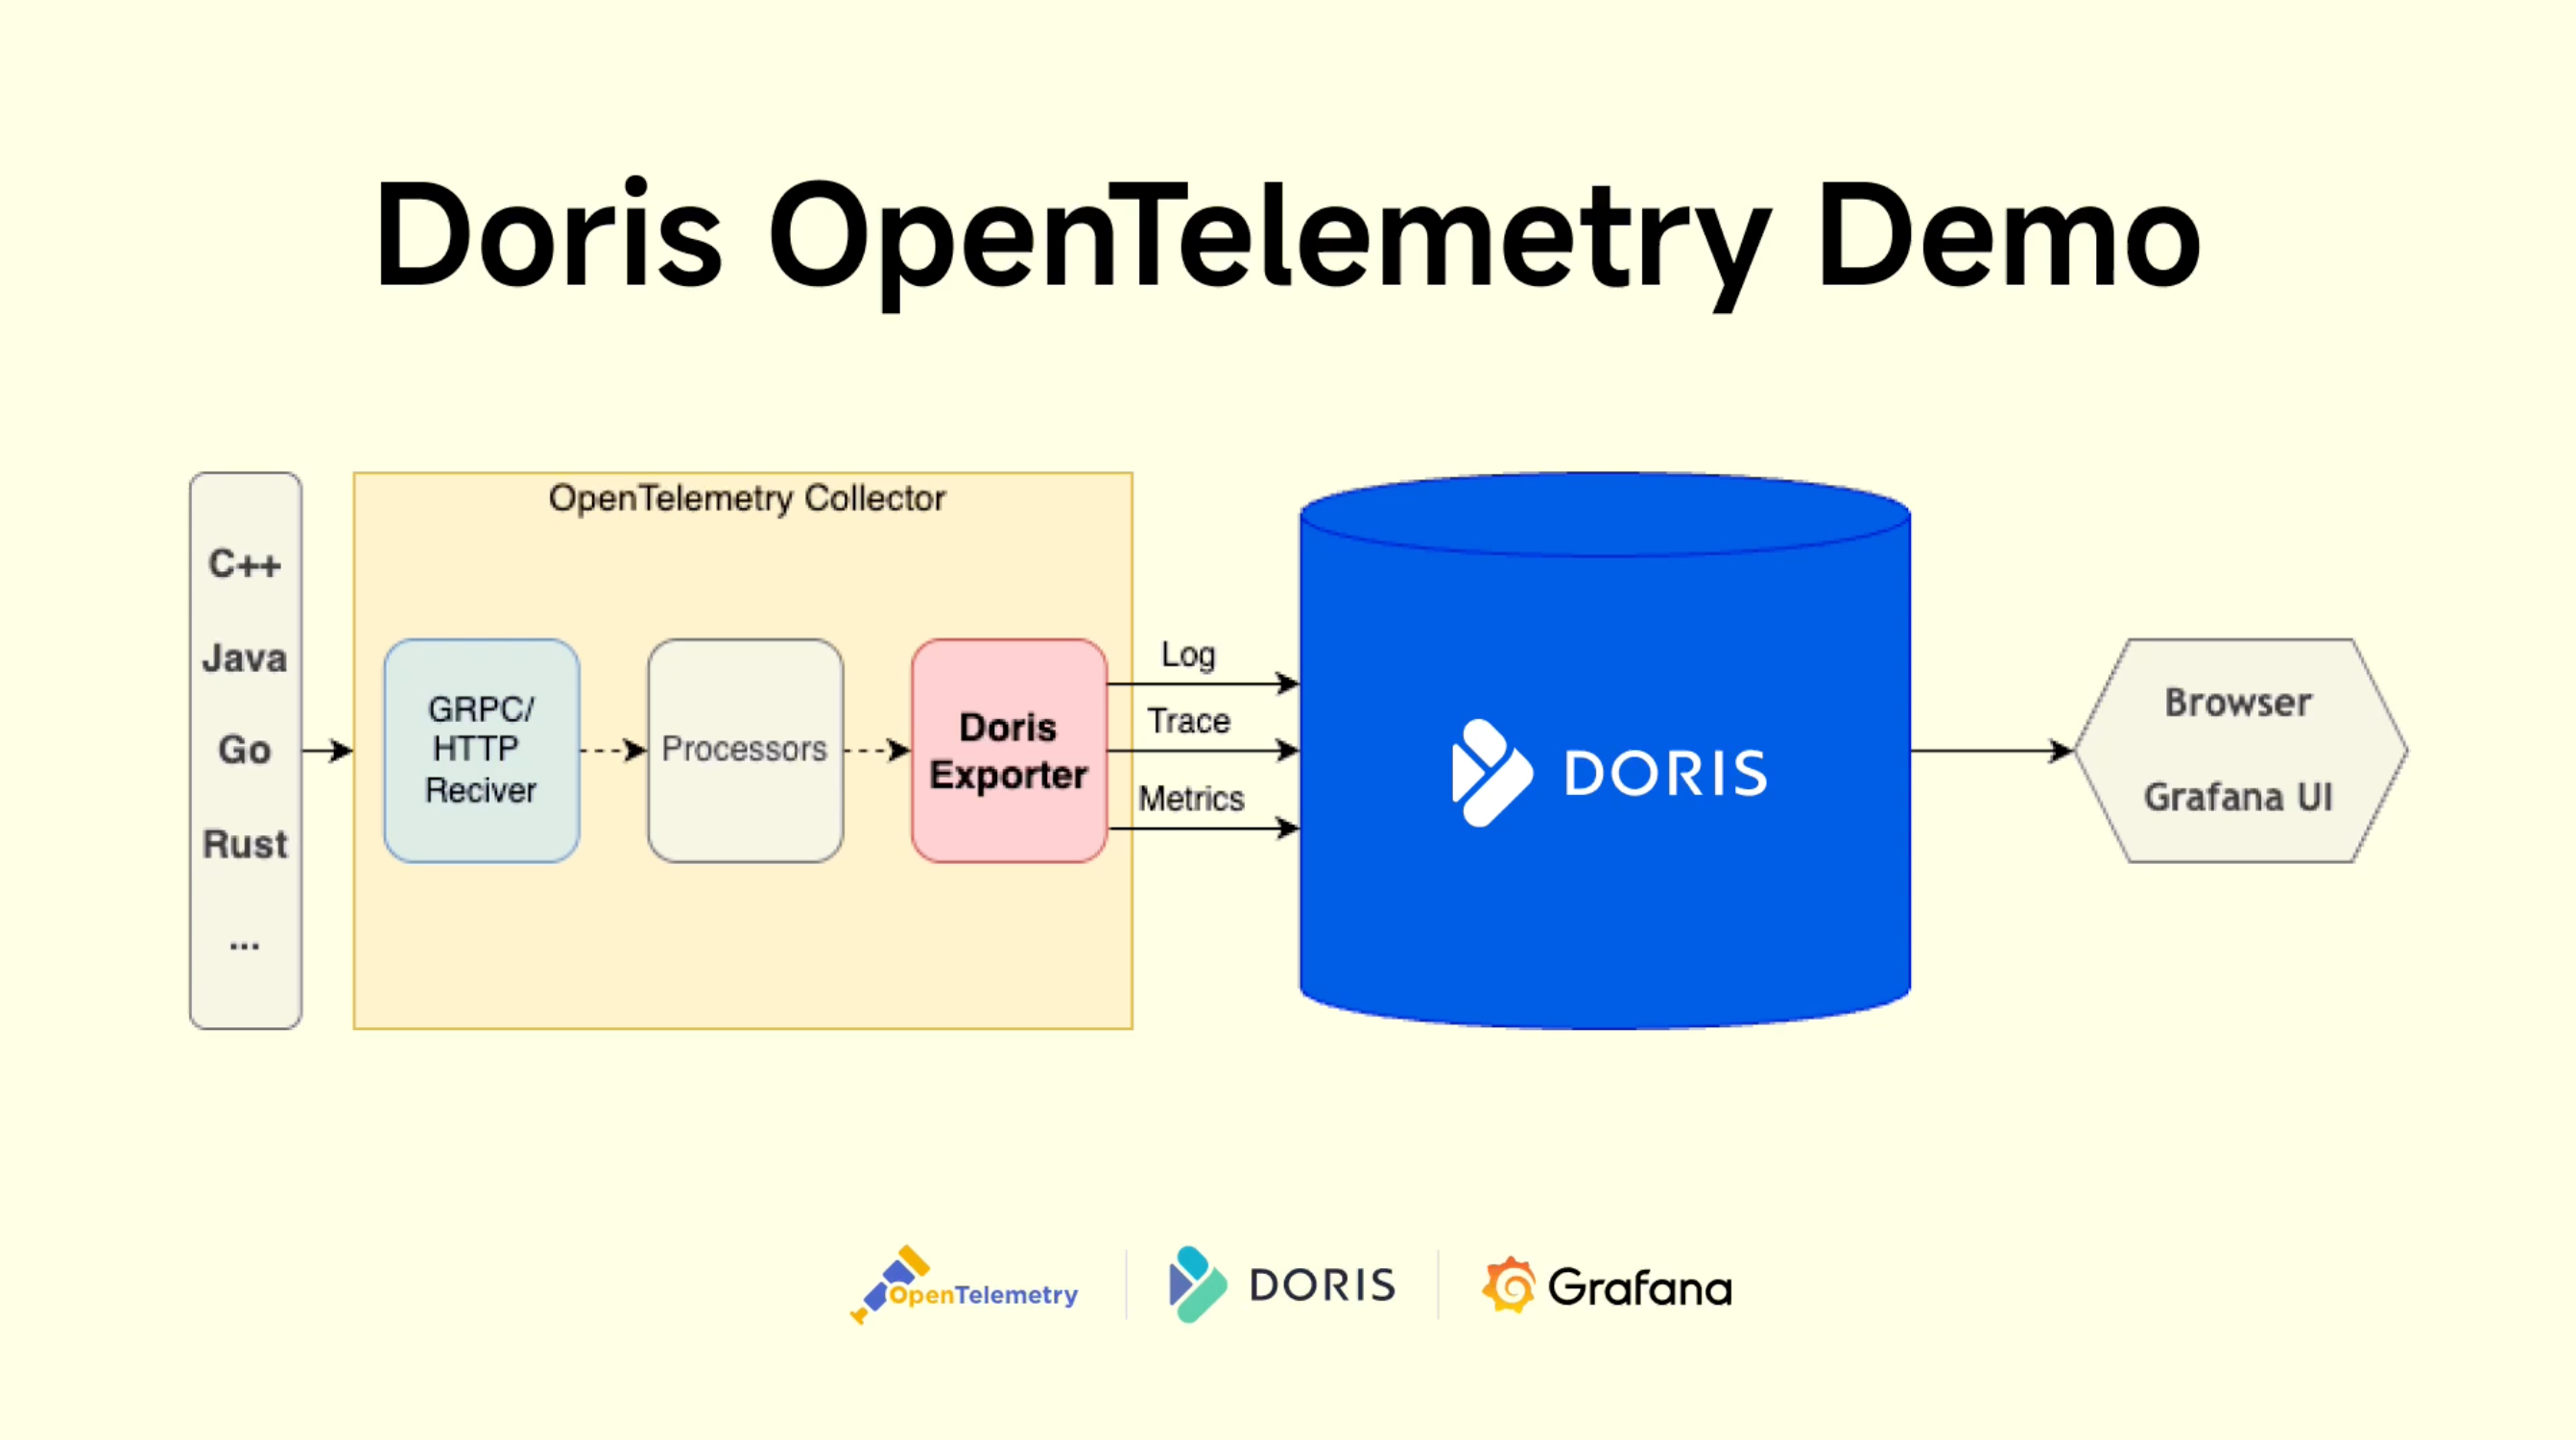
부하 시뮬레이션 프로그램인 Load Generator가 진입 서비스에 지속적으로 요청을 보내면 전체 전자상거래 시스템에서 대량의 옵저버빌리티 데이터(Log, Trace, Metrics)가 생성됩니다. 데이터 흐름은 다음과 같습니다.
- OpenTelemetry의 여러 언어용 SDK로 수집
- OpenTelemetry Collector로 전송
- Collector 내부의 Processors로 전처리
- OpenTelemetry Doris Exporter를 통해 Doris에 쓰기
- Doris가 MySQL 인터페이스를 통해 상위 분석 도구(예: Grafana)와 연결하여 시각적 쿼리 및 분석 기능 제공
시각화
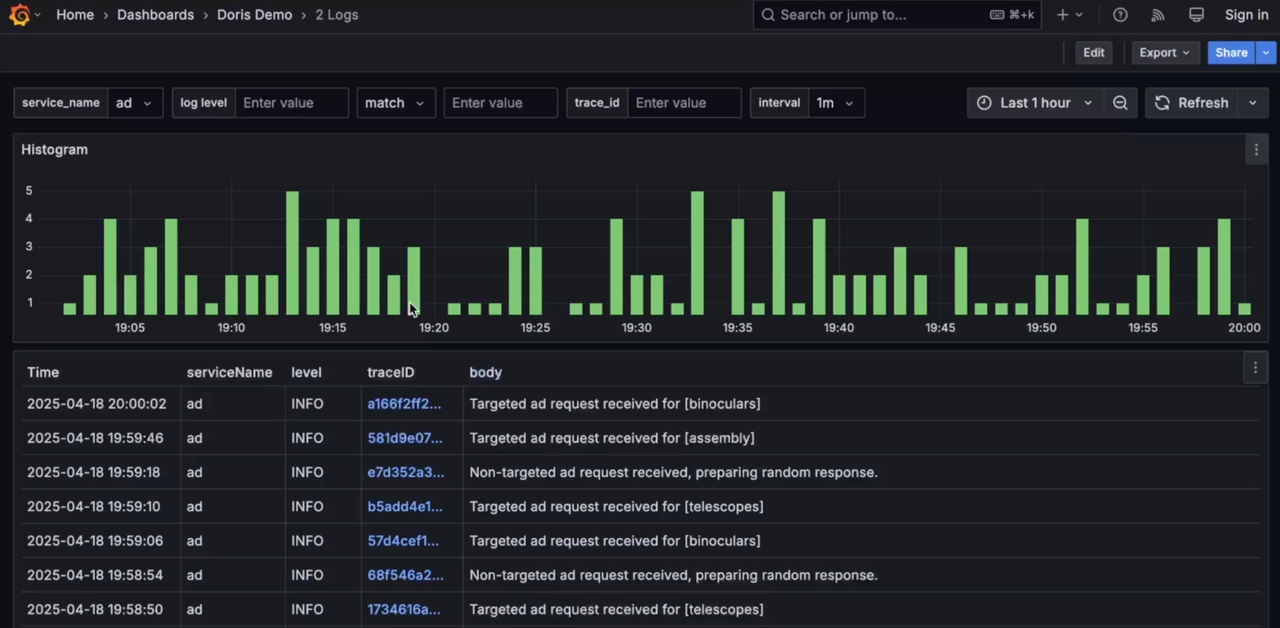
Grafana는 MySQL Datasource를 통해 Doris에 연결하여 Log, Trace, Metrics를 통합 시각화하고 분석하며, Log와 Trace 간 연계 기능을 제공합니다.
-
Log
-
Trace
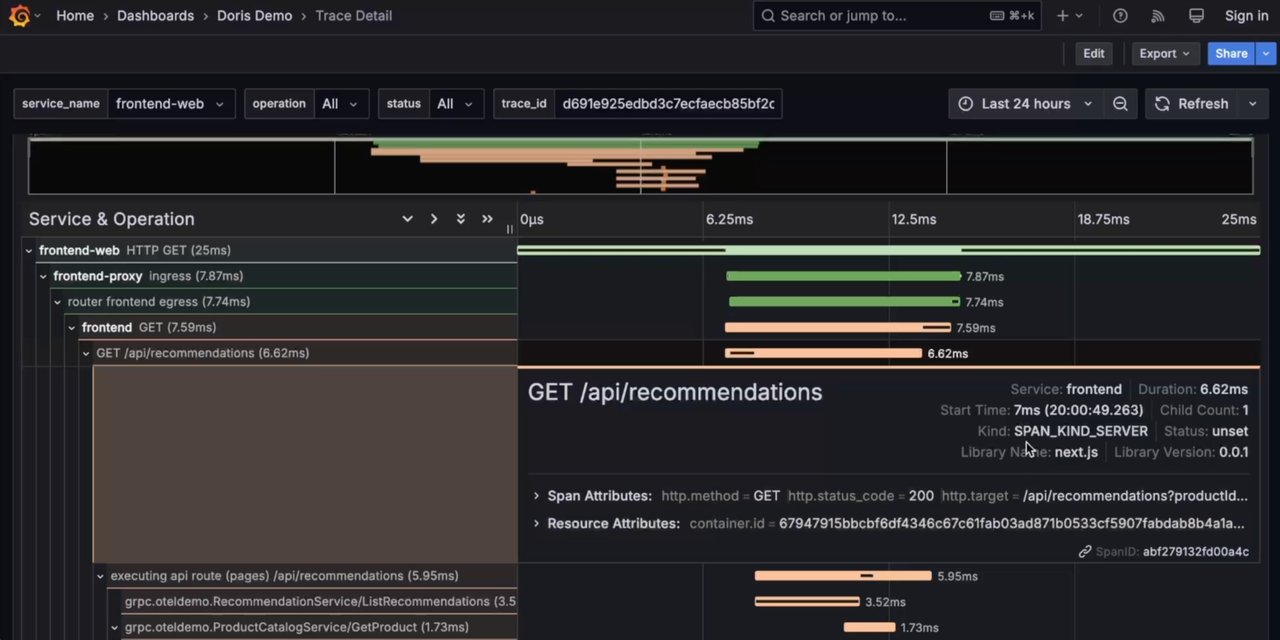
-
Metrics
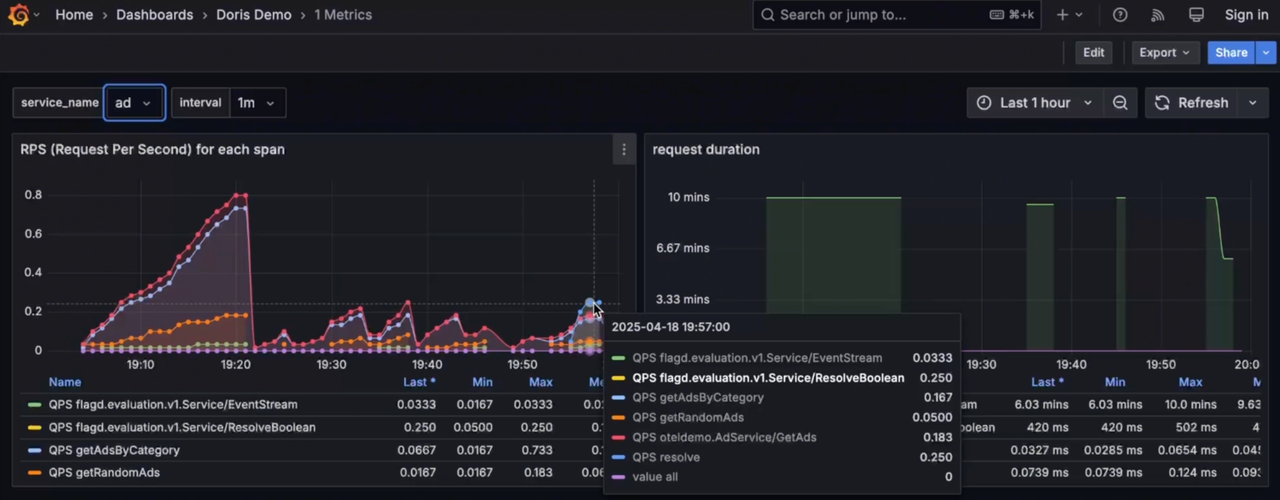
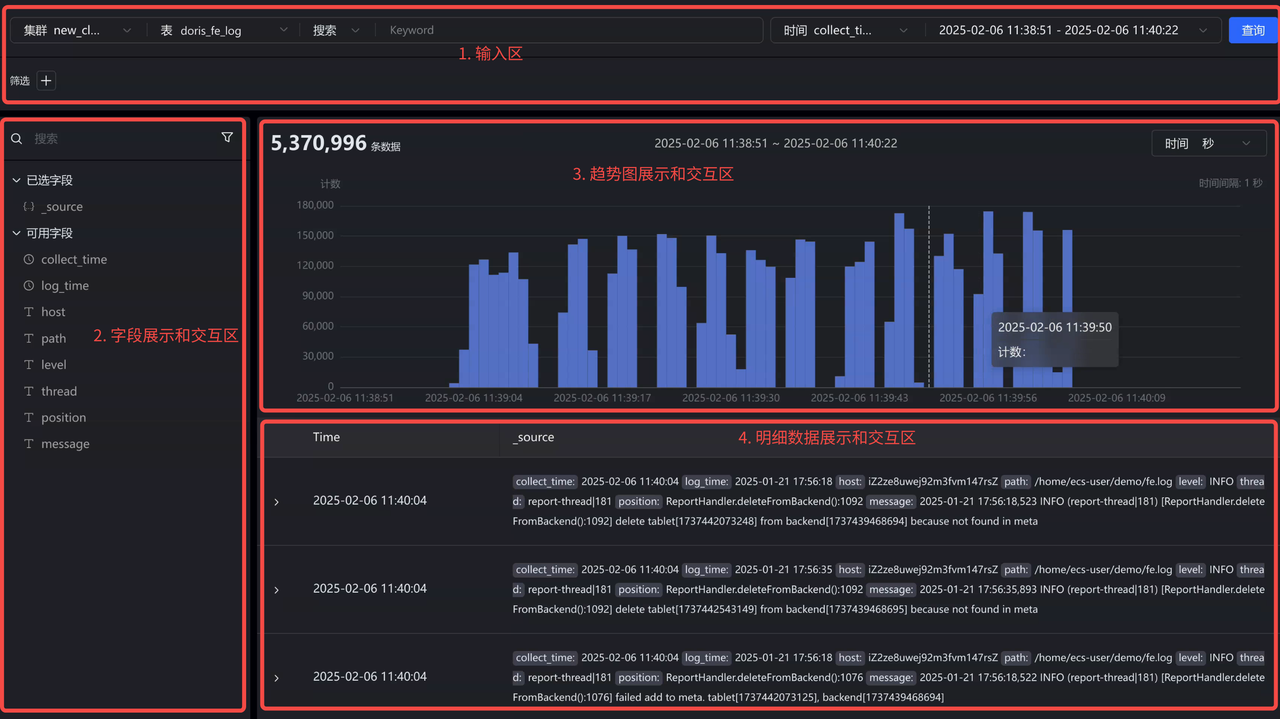
Grafana의 Log 시각화 및 분석 기능은 Kibana에 비해 비교적 단순합니다. 이에 타사 공급업체들은 Kibana Discover와 유사한 검색 및 분석 기능을 구현했습니다. 향후 이러한 기능을 Grafana Doris Datasource에도 통합하여 더 나은 통합 Log/Trace/Metrics 시각화 분석 경험을 제공할 예정입니다. 또한 Elasticsearch 쿼리 프로토콜과의 호환성을 통해 향후 네이티브 Kibana도 Doris에 직접 연결할 수 있게 됩니다. ELK 사용자는 기존 로그 수집 및 시각화 분석 방식을 바꾸지 않고 Elasticsearch를 Doris로 대체하여 비용을 절감하고 효율을 높일 수 있습니다.