Trace 저장 및 분석
이 문서에서는 Apache Doris에서 Trace 데이터를 저장하고 분석하는 방법을 테이블 생성부터 수집, 쿼리까지 전체 과정에 걸쳐 설명합니다.
빠른 탐색
전체 도입 과정은 세 단계로 구성되며, 순서대로 진행할 수 있습니다.
| 단계 | 내용 | 목표 |
|---|---|---|
| 1. 테이블 생성 | Doris에 Trace 저장용 테이블 생성 | Trace 쓰기 및 쿼리 패턴에 맞게 성능 최적화 |
| 2. 수집 | OpenTelemetry를 통해 Doris에 Trace 데이터 쓰기 | 애플리케이션에서 Collector를 거쳐 Doris로 이어지는 파이프라인 연결 |
| 3. 쿼리 | Grafana에서 Trace 데이터 시각적 분석 | 검색, 지연 시간 분포 확인, Trace 세부 정보 조회 |
1. 테이블 생성
Trace 데이터는 쓰기 및 쿼리 패턴에 뚜렷한 특성이 있습니다. 테이블을 생성할 때 이러한 특성에 맞게 설정하면 성능을 높일 수 있습니다.
1.1 주요 설정 항목
다음 표는 테이블 생성 시 고려해야 할 주요 설정 항목과 권장 방식을 정리한 것입니다.
| 설정 항목 | 권장 방식 | 설명 |
|---|---|---|
| 파티셔닝 | 시간 필드에 RANGE 파티션을 적용하고 동적 파티셔닝을 활성화하여 일별 파티션을 자동으로 관리 | 파티션을 자동으로 순환 관리하여 핫/콜드 데이터 분리와 만료 데이터 정리가 쉬워짐 |
| 정렬 키 | service_name과 DATETIME 타입의 시간 필드를 키로 사용 | 특정 서비스를 시간 범위로 스캔하는 쿼리의 속도를 몇 배 높임 |
| 버킷 수 | 클러스터 전체 디스크 수의 약 3배 | 병렬성을 확보하면서 작은 파일 수를 제어 |
| 버킷팅 전략 | RANDOM을 사용하고 쓰기 시 단일 tablet으로 데이터 적재 | 쓰기 배치 처리 효율 향상 |
| Compaction | time_series Compaction 정책 사용 | 쓰기 증폭을 줄이며, 이는 처리량이 높은 Trace 쓰기에서 리소스를 최적화하는 데 매우 중요함 |
| 반정형 필드 | span_attributes와 resource_attributes에 VARIANT 타입 사용 | JSON을 하위 컬럼으로 자동 분리하여 저장하므로 압축 효율과 하위 컬럼 필터링 및 분석 성능이 향상됨 |
| 인덱스 | 자주 쿼리하는 필드에 역색인 생성 | 동등 조건 필터링과 범위 쿼리 속도 향상 |
| 전문 검색 | parser 매개변수로 토크나이저를 지정하고(일반적으로 unicode면 충분함), 필요에 따라 support_phrase 활성화 | support_phrase는 구문 쿼리를 활성화하며, 필요하지 않으면 비활성화하여 저장 공간을 절약 |
| 복제본 | 클라우드 디스크는 복제본 1개를 사용할 수 있으며, 물리 디스크는 최소 2개 사용 권장 | 안정성과 비용 사이의 균형 확보 |
| 핫/콜드 데이터 분리 | log_s3 객체 스토리지와 log_policy_3day 정책 설정 | 3일이 지난 데이터를 S3로 자동 이동하여 핫 스토리지 비용 절감 |
1.2 테이블 생성 SQL 예제
다음 예제는 리소스, 스토리지 정책, 테이블을 생성하는 전체 과정을 보여 줍니다.
CREATE DATABASE log_db;
USE log_db;

-- Not required in the storage-compute decoupled mode
CREATE RESOURCE "log_s3"
PROPERTIES
(
    "type" = "s3",
    "s3.endpoint" = "your_endpoint_url",
    "s3.region" = "your_region",
    "s3.bucket" = "your_bucket",
    "s3.root.path" = "your_path",
    "s3.access_key" = "your_ak",
    "s3.secret_key" = "your_sk"
);

-- Not required in the storage-compute decoupled mode
CREATE STORAGE POLICY log_policy_3day
PROPERTIES(
    "storage_resource" = "log_s3",
    "cooldown_ttl" = "259200"
);

CREATE TABLE trace_table
(
    service_name          VARCHAR(200),
    timestamp             DATETIME(6),
    service_instance_id   VARCHAR(200),
    trace_id              VARCHAR(200),
    span_id               STRING,
    trace_state           STRING,
    parent_span_id        STRING,
    span_name             STRING,
    span_kind             STRING,
    end_time              DATETIME(6),
    duration              BIGINT,
    span_attributes       VARIANT,
    events                ARRAY<STRUCT<timestamp:DATETIME(6), name:STRING, attributes:MAP<STRING, STRING>>>,
    links                 ARRAY<STRUCT<trace_id:STRING, span_id:STRING, trace_state:STRING, attributes:MAP<STRING, STRING>>>,
    status_message        STRING,
    status_code           STRING,
    resource_attributes   VARIANT,
    scope_name            STRING,
    scope_version         STRING,
    INDEX idx_timestamp(timestamp) USING INVERTED,
    INDEX idx_service_instance_id(service_instance_id) USING INVERTED,
    INDEX idx_trace_id(trace_id) USING INVERTED,
    INDEX idx_span_id(span_id) USING INVERTED,
    INDEX idx_trace_state(trace_state) USING INVERTED,
    INDEX idx_parent_span_id(parent_span_id) USING INVERTED,
    INDEX idx_span_name(span_name) USING INVERTED,
    INDEX idx_span_kind(span_kind) USING INVERTED,
    INDEX idx_end_time(end_time) USING INVERTED,
    INDEX idx_duration(duration) USING INVERTED,
    INDEX idx_span_attributes(span_attributes) USING INVERTED,
    INDEX idx_status_message(status_message) USING INVERTED,
    INDEX idx_status_code(status_code) USING INVERTED,
    INDEX idx_resource_attributes(resource_attributes) USING INVERTED,
    INDEX idx_scope_name(scope_name) USING INVERTED,
    INDEX idx_scope_version(scope_version) USING INVERTED
)
ENGINE = OLAP
DUPLICATE KEY(service_name, timestamp)
PARTITION BY RANGE(timestamp) ()
DISTRIBUTED BY RANDOM BUCKETS 250
PROPERTIES (
"compression" = "zstd",
"compaction_policy" = "time_series",
"inverted_index_storage_format" = "V2",
"dynamic_partition.enable" = "true",
"dynamic_partition.create_history_partition" = "true",
"dynamic_partition.time_unit" = "DAY",
"dynamic_partition.start" = "-30",
"dynamic_partition.end" = "1",
"dynamic_partition.prefix" = "p",
"dynamic_partition.buckets" = "250",
"dynamic_partition.replication_num" = "2", -- Not required in storage-compute decoupled mode
"replication_num" = "2", -- Not required in storage-compute decoupled mode
"storage_policy" = "log_policy_3day" -- Not required in storage-compute decoupled mode
);
2. Trace 수집
Doris는 OpenTelemetry와 같은 Trace 수집 시스템과 연동할 수 있는 개방적이고 범용적인 Stream HTTP API를 제공합니다.
2.1 전체 파이프라인
애플리케이션 → OpenTelemetry SDK/Agent → OpenTelemetry Collector(Doris Exporter 포함) → Doris 테이블로 이어집니다.
2.2 OpenTelemetry 연동 단계
1단계: 애플리케이션에 OpenTelemetry SDK 통합
이 예제에서는 공식 Spring Boot 데모에 OpenTelemetry Java SDK를 통합하여, 간단한 문자열 Hello World!를 경로 /에 대한 응답으로 반환합니다.
OpenTelemetry Java Agent를 다운로드합니다. Java Agent를 사용하면 기존 애플리케이션을 수정할 필요가 없다는 장점이 있습니다.
다른 언어와 연동 방법은 다음을 참조하세요.
2단계: OpenTelemetry Collector 배포 및 설정
OpenTelemetry Collector를 다운로드하고 압축을 해제합니다.
이름이
otelcol-contrib로 시작하는 릴리스 패키지를 다운로드하세요. 이 패키지에는 Trace 데이터를 Doris에 적재할 수 있는 Doris Exporter 구성 요소가 포함되어 있습니다.
다음과 같이 otel_demo.yaml 설정 파일을 생성합니다. 더 많은 설정 옵션은 Doris Exporter 문서를 참조하세요.
receivers:
    otlp: # otlp protocol, receives data sent by the OpenTelemetry Java Agent
        protocols:
            grpc:
                endpoint: 0.0.0.0:4317
            http:
                endpoint: 0.0.0.0:4318

processors:
    batch:
        send_batch_size: 100000 # Number of records per batch; recommended batch size is between 100M and 1G
        timeout: 10s

exporters:
    doris:
        endpoint: http://localhost:8030 # FE HTTP address
        database: doris_db_name
        username: doris_username
        password: doris_password
        table:
            traces: doris_table_name
        create_schema: true # Whether to automatically create the schema; when set to false, you need to create the table manually
        mysql_endpoint: localhost:9030  # FE MySQL address
        history_days: 10
        create_history_days: 10
        timezone: Asia/Shanghai
        timeout: 60s # http stream load client timeout
        log_response: true
        sending_queue:
            enabled: true
            num_consumers: 20
            queue_size: 1000
        retry_on_failure:
            enabled: true
            initial_interval: 5s
            max_interval: 30s
        headers:
            load_to_single_tablet: "true"
3단계: OpenTelemetry Collector 실행
./otelcol-contrib --config otel_demo.yaml
4단계: Spring Boot 샘플 애플리케이션 시작
애플리케이션을 시작하기 전에 몇 가지 환경 변수만 설정하면 되며, 코드를 변경할 필요는 없습니다.
export JAVA_TOOL_OPTIONS="${JAVA_TOOL_OPTIONS} -javaagent:/your/path/to/opentelemetry-javaagent.jar" # Path to the OpenTelemetry Java Agent
export OTEL_JAVAAGENT_LOGGING="none" # Disable otel logging to avoid interfering with the service's own logs
export OTEL_SERVICE_NAME="myproject"
export OTEL_TRACES_EXPORTER="otlp" # Use the otlp protocol to send trace data
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4317" # Address of the OpenTelemetry Collector

java -jar myproject-0.0.1-SNAPSHOT.jar
5단계: 샘플 애플리케이션에 접속하여 Trace 데이터 생성
curl localhost:8080을 실행하면 hello 서비스가 호출됩니다. OpenTelemetry Java Agent는 Trace 데이터를 자동으로 생성하여 OpenTelemetry Collector로 전송합니다. 이어서 Collector는 설정된 Doris Exporter를 통해 Trace 데이터를 Doris 테이블에 씁니다(기본 테이블 이름은 otel.otel_traces).
3. Trace 쿼리
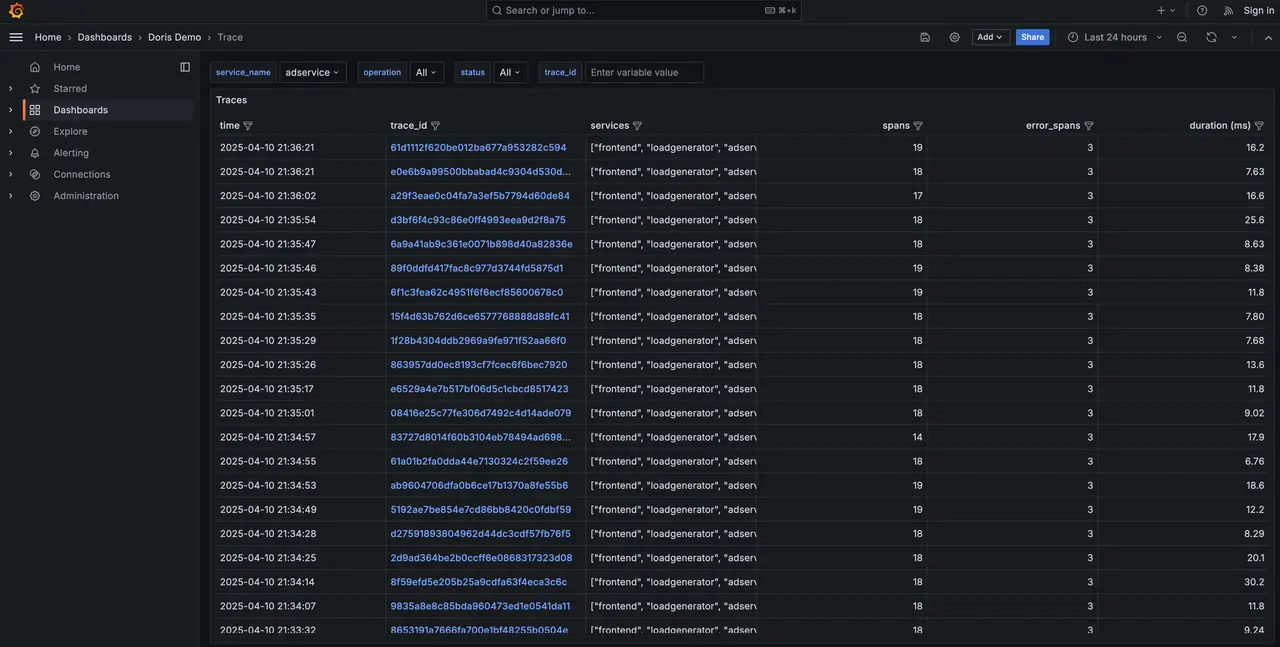
Trace 쿼리는 일반적으로 Grafana와 같은 시각적 인터페이스를 통해 수행합니다. 대표적인 사용 사례는 다음과 같습니다.
-
시간 범위와 서비스 이름으로 필터링하여 지연 시간 분포 차트와 최신 Trace를 포함한 Trace 개요를 표시합니다.
-
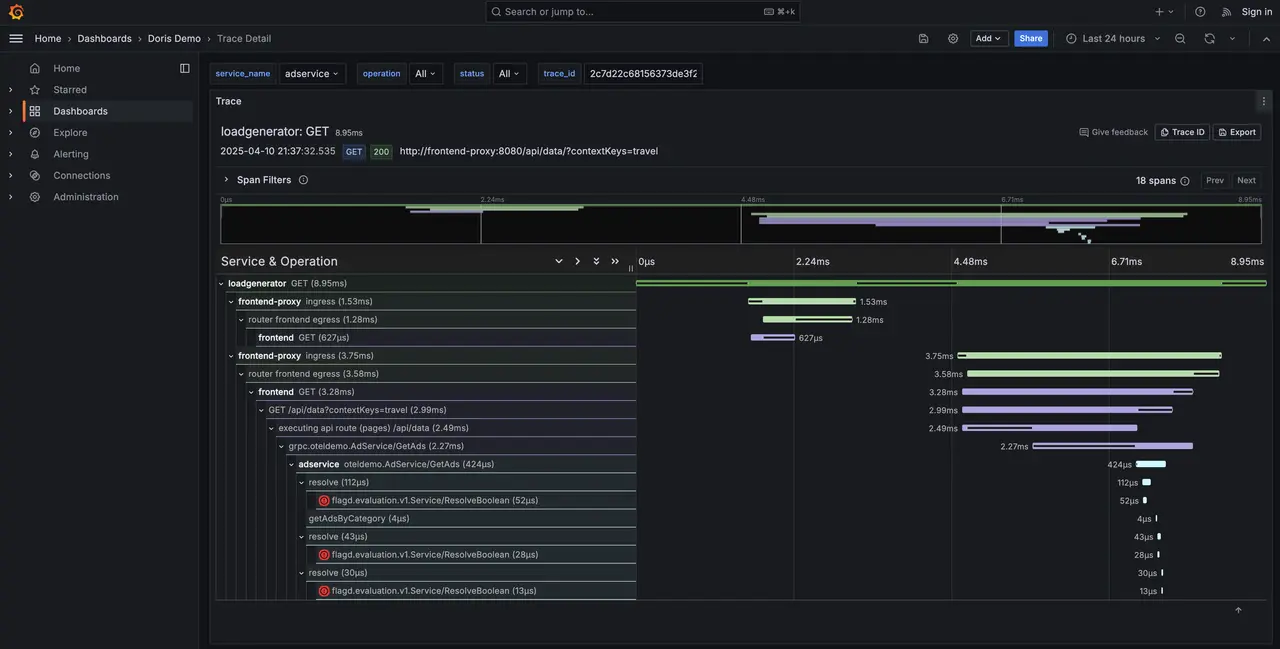
링크를 클릭하여 Trace 세부 정보를 확인합니다.