Colocation Join
Colocation Join은 Doris가 제공하는 Join 최적화 기능입니다. 여러 테이블을 동일한 규칙에 따라 같은 BE 노드에 배치하면 버킷 열에 대한 Join 연산을 로컬에서 완료할 수 있어, 노드 간 데이터 전송을 피하고 쿼리 속도를 높일 수 있습니다.
이 문서는 Colocation Join의 원리, 구현, 사용법 및 고려 사항을 설명합니다.
적용 가능 여부 확인
Colocation Join을 사용하기 전에 다음 사항을 확인하세요.
- Join에 참여하는 두 개 이상의 테이블이 동일한 Colocation Group에 추가되어 있어야 합니다.
- Join Key가 버킷 열(Distribution Key)과 일치해야 합니다.
- 테이블의 복제본 수와 버킷 수가 같고, 데이터 분포가 안정적이어야 합니다(
IsStable = true). - 대용량 테이블 간 Join으로 인해 쿼리에 뚜렷한 Shuffle 성능 병목이 있어야 합니다.
용어
| 용어 | 약어 | 설명 |
|---|---|---|
| Colocation Group | CG | CG는 하나 이상의 테이블을 포함합니다. 같은 그룹의 테이블은 동일한 Colocation Group Schema와 데이터 샤드 분포를 공유합니다. |
| Colocation Group Schema | CGS | CG에 속한 테이블의 Colocation 관련 공통 스키마 정보를 정의합니다. 여기에는 버킷 열 타입, 버킷 수, 복제본 수가 포함됩니다. |
원리
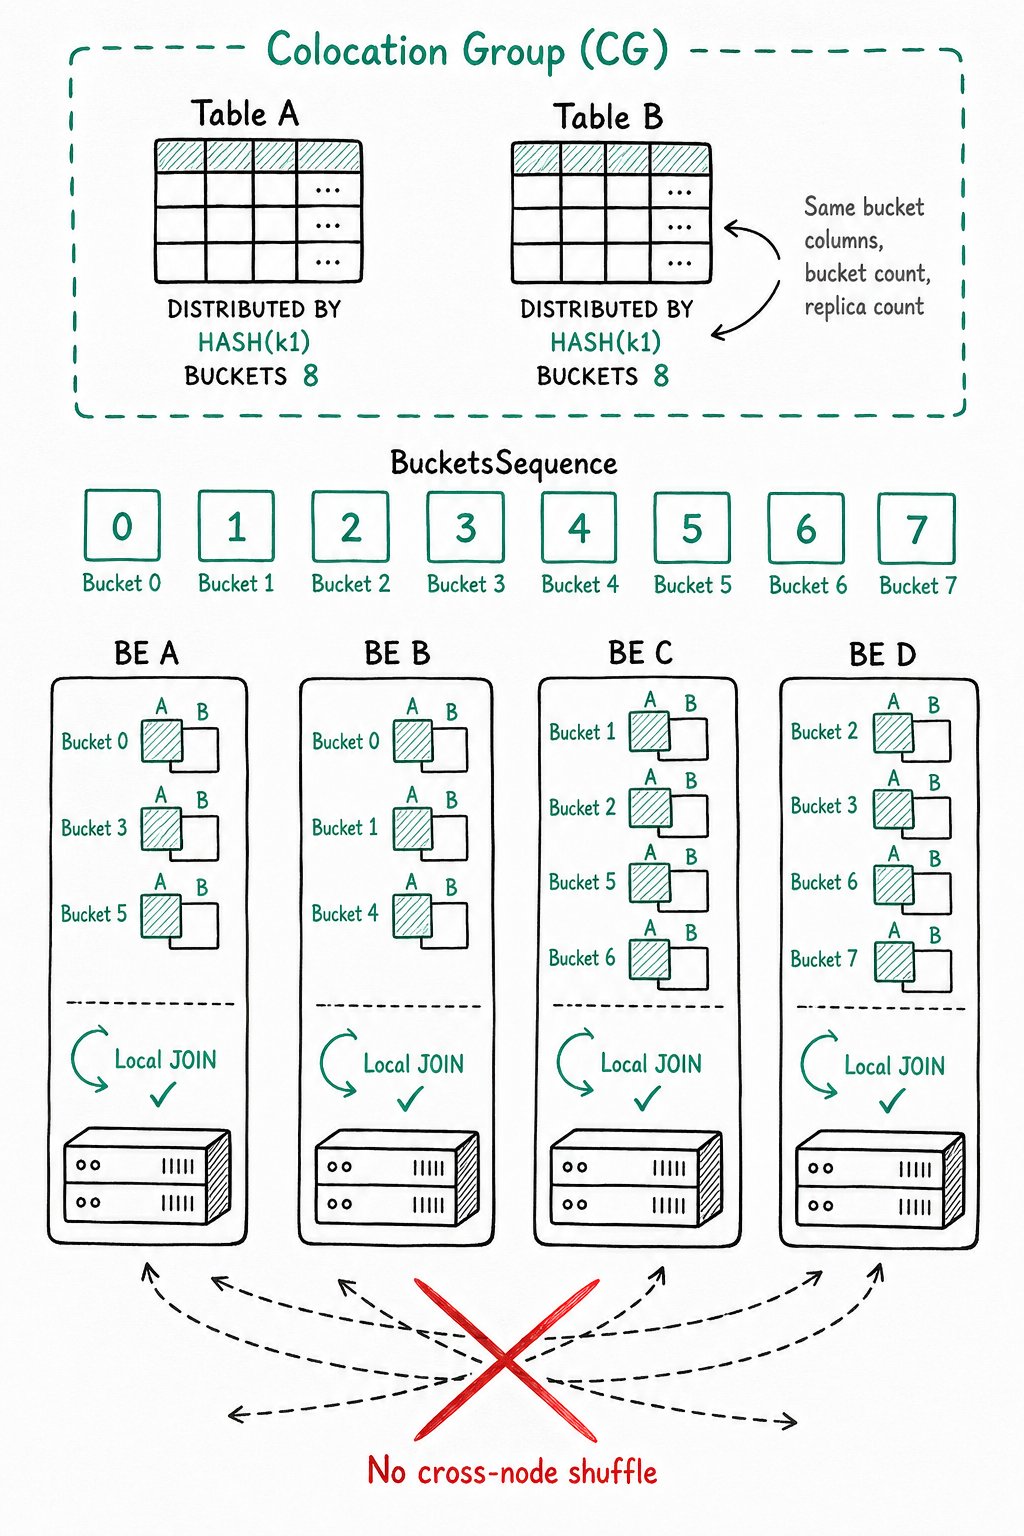
Colocation Join 기능은 동일한 CGS를 공유하는 테이블들을 하나의 CG로 묶고, 이 테이블들의 대응하는 데이터 샤드가 같은 BE 노드에 배치되도록 합니다. 따라서 CG 내 테이블이 버킷 열에 대해 Join 연산을 수행할 때 로컬 데이터로 직접 Join할 수 있어 노드 간 데이터 전송 시간이 줄어듭니다.
버킷과 BucketsSequence
테이블 데이터는 버킷 열 값을 해싱한 후 버킷 수로 나눈 나머지에 따라 최종적으로 버킷에 배치됩니다. 테이블에 버킷이 8개 있다고 가정하면, 총 8개의 버킷은 [0, 1, 2, 3, 4, 5, 6, 7]입니다. 이 시퀀스를 BucketsSequence라고 합니다. 각 버킷에는 하나 이상의 데이터 샤드(Tablet)가 포함됩니다.
- 단일 파티션 테이블의 경우 버킷에는 Tablet이 하나만 포함됩니다.
- 다중 파티션 테이블의 경우 버킷에는 여러 Tablet이 포함됩니다.
동일한 CG에 속한 테이블의 제약 조건
테이블이 동일한 데이터 분포를 공유하도록 하려면 같은 CG에 속한 테이블의 다음 속성이 동일해야 합니다.
-
버킷 열과 버킷 수
버킷 열은 테이블 생성문에서
DISTRIBUTED BY HASH(col1, col2, ...)로 지정한 열입니다. 버킷 열은 어떤 열의 값을 해싱에 사용하여 테이블 데이터를 서로 다른 Tablet으로 나눌지 결정합니다. 같은 CG에 속한 테이블은 버킷 열의 타입과 개수, 버킷 수가 모두 정확히 같아야 여러 테이블의 데이터 샤드를 일대일로 대응시켜 분산할 수 있습니다. -
복제본 수
같은 CG에 속한 모든 테이블의 모든 파티션은 복제본 수가 일치해야 합니다. 일치하지 않으면 일부 Tablet의 복제본에 대응하는 다른 테이블의 샤드 복제본이 같은 BE에 없을 수 있습니다.
같은 CG에 속한 테이블의 파티션 수, 파티션 범위, 파티션 열 타입은 같을 필요가 없습니다.
데이터 분포 예시
버킷 열과 버킷 수가 정해지면 같은 CG에 속한 테이블은 동일한 BucketsSequence를 공유합니다. 복제본 수는 각 버킷 내 Tablet의 여러 복제본을 어느 BE에 저장할지 결정합니다.
BucketsSequence가 [0, 1, 2, 3, 4, 5, 6, 7]이고 BE 노드가 4개 [A, B, C, D] 있다고 가정하면, 가능한 데이터 분포는 다음과 같습니다.
+---+ +---+ +---+ +---+ +---+ +---+ +---+ +---+
| 0 | | 1 | | 2 | | 3 | | 4 | | 5 | | 6 | | 7 |
+---+ +---+ +---+ +---+ +---+ +---+ +---+ +---+
| A | | B | | C | | D | | A | | B | | C | | D |
|   | |   | |   | |   | |   | |   | |   | |   |
| B | | C | | D | | A | | B | | C | | D | | A |
|   | |   | |   | |   | |   | |   | |   | |   |
| C | | D | | A | | B | | C | | D | | A | | B |
+---+ +---+ +---+ +---+ +---+ +---+ +---+ +---+
CG에 속한 모든 테이블의 데이터는 위 규칙에 따라 균등하게 분산됩니다. 따라서 버킷 열 값이 같은 데이터는 동일한 BE 노드에 위치하며, 로컬 데이터로 Join을 수행할 수 있습니다.
사용법
테이블 생성 시 Colocation Group 지정
목적: 새로 생성하는 테이블을 지정한 Colocation Group에 추가합니다.
명령: "colocate_with" = "group_name"을 PROPERTIES에 지정합니다.
예시:
CREATE TABLE tbl (k1 int, v1 int sum)
DISTRIBUTED BY HASH(k1)
BUCKETS 8
PROPERTIES(
    "colocate_with" = "group1"
);
설명:
- 지정한 그룹이 없으면 Doris는 현재 테이블만 포함하는 그룹을 자동으로 생성합니다.
- 그룹이 이미 있으면 Doris는 현재 테이블이 Colocation Group Schema를 충족하는지 확인합니다. 충족하면 테이블을 생성하여 그룹에 추가합니다. 또한 기존 그룹의 데이터 분포 규칙에 따라 샤드와 복제본을 생성합니다.
- 그룹은 데이터베이스에 속하며, 그룹 이름은 해당 데이터베이스 내에서 고유합니다. 내부 저장소에서 그룹의 전체 이름은
dbId_groupName이지만, 사용자에게는groupName만 표시됩니다.
데이터베이스 간 Global Group 생성
Doris는 2.0 버전에서 데이터베이스 간 그룹을 지원합니다.
목적: 데이터베이스 간 Colocate Join을 구현합니다.
명령: 테이블을 생성할 때 그룹 이름의 접두사로 __global__ 키워드를 사용합니다.
예시:
CREATE TABLE tbl (k1 int, v1 int sum)
DISTRIBUTED BY HASH(k1)
BUCKETS 8
PROPERTIES(
    "colocate_with" = "__global__group1"
);
설명: __global__ 접두사가 있는 그룹은 데이터베이스에 속하지 않으며, 이름이 전역적으로 고유합니다. Global Group을 생성하면 데이터베이스 간 Colocate Join을 구현할 수 있습니다.
테이블 삭제
그룹의 마지막 테이블이 완전히 삭제되면 그룹도 자동으로 삭제됩니다.
완전한 삭제란 휴지통에서도 삭제되는 것을 의미합니다. 일반적으로 DROP TABLE 명령으로 테이블을 삭제하면 기본적으로 하루 동안 휴지통에 보관된 후 삭제됩니다.
그룹 조회
목적: 클러스터에 존재하는 Colocation Group의 정보와 데이터 분포를 조회합니다.
1. 클러스터의 모든 그룹 조회
SHOW PROC '/colocation_group';

+-------------+--------------+--------------+------------+----------------+----------+----------+
| GroupId     | GroupName    | TableIds     | BucketsNum | ReplicationNum | DistCols | IsStable |
+-------------+--------------+--------------+------------+----------------+----------+----------+
| 10005.10008 | 10005_group1 | 10007, 10040 | 10         | 3              | int(11)  | true     |
+-------------+--------------+--------------+------------+----------------+----------+----------+
필드 설명:
| 필드 | 설명 |
|---|---|
| GroupId | 클러스터 전체에서 고유한 그룹 식별자입니다. 앞부분은 데이터베이스 ID이고, 뒷부분은 그룹 ID입니다. |
| GroupName | 그룹의 전체 이름입니다. |
| TableIds | 그룹에 포함된 테이블 ID 목록입니다. |
| BucketsNum | 버킷 수입니다. |
| ReplicationNum | 복제본 수입니다. |
| DistCols | 분산 열, 즉 버킷 열의 타입입니다. |
| IsStable | 그룹이 안정 상태인지 나타냅니다. 안정 상태의 정의는 Colocation 복제본 균형 조정 및 복구 절을 참조하세요. |
2. 특정 그룹의 데이터 분포 조회
SHOW PROC '/colocation_group/10005.10008';

+-------------+---------------------+
| BucketIndex | BackendIds          |
+-------------+---------------------+
| 0           | 10004, 10002, 10001 |
| 1           | 10003, 10002, 10004 |
| 2           | 10002, 10004, 10001 |
| 3           | 10003, 10002, 10004 |
| 4           | 10002, 10004, 10003 |
| 5           | 10003, 10002, 10001 |
| 6           | 10003, 10004, 10001 |
| 7           | 10003, 10004, 10002 |
+-------------+---------------------+
필드 설명:
| 필드 | 설명 |
|---|---|
| BucketIndex | 버킷 시퀀스의 인덱스입니다. |
| BackendIds | 해당 버킷의 데이터 샤드가 위치한 BE 노드 ID 목록입니다. |
위 명령에는 ADMIN 권한이 필요하며, 일반 사용자는 사용할 수 없습니다.
테이블의 Colocate Group 속성 변경
목적: 기존 테이블을 Colocation Group에 추가하거나, 다른 Colocation Group으로 이동하거나, Colocation Group에서 제거합니다.
1. 그룹 설정 또는 이동
ALTER TABLE tbl SET ("colocate_with" = "group2");
동작:
- 테이블이 이전에 어떤 그룹에도 속하지 않았다면, 이 명령은 스키마를 확인하고 테이블을 그룹에 추가합니다. 그룹이 없으면 생성합니다.
- 테이블이 이전에 다른 그룹에 속해 있었다면, 이 명령은 먼저 기존 그룹에서 테이블을 제거한 후 새 그룹에 추가합니다. 그룹이 없으면 생성합니다.
2. Colocation 속성 제거
ALTER TABLE tbl SET ("colocate_with" = "");
기타 관련 작업
Colocation 속성이 있는 테이블에서 파티션을 추가하거나(ADD PARTITION) 복제본 수를 변경하면, Doris는 해당 변경이 Colocation Group Schema를 위반하는지 확인합니다. 위반하면 변경을 거부합니다.
Colocation 복제본 균형 조정 및 복구
Colocation 테이블의 복제본 분포는 그룹에 지정된 분포를 따라야 하므로, 복제본 복구와 균형 조정 방식이 일반 샤드와 다릅니다.
그룹의 안정 상태
그룹 자체에는 Stable 속성이 있습니다.
| 상태 | 의미 | 쿼리에 미치는 영향 |
|---|---|---|
| Stable (true) | 그룹에 속한 테이블의 모든 샤드가 현재 변경되지 않는 상태입니다. | Colocation 기능이 정상적으로 작동합니다. |
| Unstable (false) | 그룹에 속한 테이블의 일부 샤드가 복구 또는 이동 중입니다. | 관련 테이블의 Colocation Join이 일반 Join으로 전환됩니다. |
복제본 복구
복제본은 지정된 BE 노드에만 저장할 수 있습니다. 따라서 BE를 사용할 수 없게 되면(예: 비정상 종료 또는 Decommission) 이를 대체할 새 BE를 찾아야 합니다. Doris는 부하가 가장 낮은 BE를 우선적으로 선택합니다. 대체한 후에는 기존 BE에 있던 해당 버킷의 모든 데이터 샤드를 복구해야 합니다. 이동 중에는 그룹이 Unstable로 표시됩니다.
복제본 균형 조정
Doris는 Colocation 테이블의 샤드를 모든 BE 노드에 균등하게 분산하려고 합니다. 두 가지 균형 조정 방식의 차이는 다음과 같습니다.
| 유형 | 균형 조정 단위 | 설명 |
|---|---|---|
| 일반 테이블 | 개별 복제본 | 각 복제본마다 부하가 더 낮은 BE를 개별적으로 찾습니다. |
| Colocation 테이블 | 버킷 | 버킷 내 모든 복제본을 함께 이동합니다. |
균형 조정에는 간단한 알고리즘을 사용합니다. 복제본의 실제 크기는 고려하지 않고 복제본 수만을 기준으로 BucketsSequence를 모든 BE에 균등하게 분산합니다. 구체적인 알고리즘은 ColocateTableBalancer.java의 코드 주석을 참조하세요.
- 참고 1: 현재 Colocation 복제본 균형 조정 및 복구 알고리즘은 이기종 Doris 클러스터에서 잘 작동하지 않을 수 있습니다. 이기종 배포란 BE 노드 간 디스크 용량, 개수 또는 디스크 타입(SSD와 HDD)이 서로 다른 구성을 의미합니다. 이기종 환경에서는 용량이 작은 BE 노드와 용량이 큰 BE 노드에 같은 수의 복제본이 저장될 수 있습니다.
- 참고 2: 그룹이 Unstable 상태이면 해당 테이블이 참여하는 Join이 일반 Join으로 전환됩니다. 이로 인해 클러스터의 쿼리 성능이 크게 저하될 수 있습니다. 시스템이 자동으로 균형을 조정하지 않도록 하려면 FE 설정
disable_colocate_balance로 자동 균형 조정을 비활성화하고, 적절한 시점에 다시 활성화할 수 있습니다. 자세한 내용은 고급 작업 절을 참조하세요.
쿼리 실행
Colocation 테이블을 쿼리하는 방법은 일반 테이블과 같으며, 사용자가 Colocation 속성을 알 필요는 없습니다. Colocation 테이블이 속한 그룹이 Unstable 상태이면 쿼리가 자동으로 일반 Join으로 전환됩니다.
다음 예시는 Colocation Join이 적용되었는지 확인하는 방법을 보여줍니다.
예제 테이블
테이블 1:
CREATE TABLE `tbl1` (
    `k1` date NOT NULL COMMENT "",
    `k2` int(11) NOT NULL COMMENT "",
    `v1` int(11) SUM NOT NULL COMMENT ""
) ENGINE=OLAP
AGGREGATE KEY(`k1`, `k2`)
PARTITION BY RANGE(`k1`)
(
    PARTITION p1 VALUES LESS THAN ('2019-05-31'),
    PARTITION p2 VALUES LESS THAN ('2019-06-30')
)
DISTRIBUTED BY HASH(`k2`) BUCKETS 8
PROPERTIES (
    "colocate_with" = "group1"
);
테이블 2:
CREATE TABLE `tbl2` (
    `k1` datetime NOT NULL COMMENT "",
    `k2` int(11) NOT NULL COMMENT "",
    `v1` double SUM NOT NULL COMMENT ""
) ENGINE=OLAP
AGGREGATE KEY(`k1`, `k2`)
DISTRIBUTED BY HASH(`k2`) BUCKETS 8
PROPERTIES (
    "colocate_with" = "group1"
);
쿼리 계획 조회
DESC SELECT * FROM tbl1 INNER JOIN tbl2 ON (tbl1.k2 = tbl2.k2);

+----------------------------------------------------+
| Explain String                                     |
+----------------------------------------------------+
| PLAN FRAGMENT 0                                    |
|  OUTPUT EXPRS:`tbl1`.`k1` |                        |
|   PARTITION: RANDOM                                |
|                                                    |
|   RESULT SINK                                      |
|                                                    |
|   2:HASH JOIN                                      |
|   |  join op: INNER JOIN                           |
|   |  hash predicates:                              |
|   |  colocate: true                                |
|   |    `tbl1`.`k2` = `tbl2`.`k2`                   |
|   |  tuple ids: 0 1                                |
|   |                                                |
|   |----1:OlapScanNode                              |
|   |       TABLE: tbl2                              |
|   |       PREAGGREGATION: OFF. Reason: null        |
|   |       partitions=0/1                           |
|   |       rollup: null                             |
|   |       buckets=0/0                              |
|   |       cardinality=-1                           |
|   |       avgRowSize=0.0                           |
|   |       numNodes=0                               |
|   |       tuple ids: 1                             |
|   |                                                |
|   0:OlapScanNode                                   |
|      TABLE: tbl1                                   |
|      PREAGGREGATION: OFF. Reason: No AggregateInfo |
|      partitions=0/2                                |
|      rollup: null                                  |
|      buckets=0/0                                   |
|      cardinality=-1                                |
|      avgRowSize=0.0                                |
|      numNodes=0                                    |
|      tuple ids: 0                                  |
+----------------------------------------------------+
Colocation Join이 적용되면 Hash Join 노드에 colocate: true가 표시됩니다.
적용되지 않으면 쿼리 계획은 다음과 같습니다.
+----------------------------------------------------+
| Explain String                                     |
+----------------------------------------------------+
| PLAN FRAGMENT 0                                    |
|  OUTPUT EXPRS:`tbl1`.`k1` |                        |
|   PARTITION: RANDOM                                |
|                                                    |
|   RESULT SINK                                      |
|                                                    |
|   2:HASH JOIN                                      |
|   |  join op: INNER JOIN (BROADCAST)               |
|   |  hash predicates:                              |
|   |  colocate: false, reason: group is not stable  |
|   |    `tbl1`.`k2` = `tbl2`.`k2`                   |
|   |  tuple ids: 0 1                                |
|   |                                                |
|   |----3:EXCHANGE                                  |
|   |       tuple ids: 1                             |
|   |                                                |
|   0:OlapScanNode                                   |
|      TABLE: tbl1                                   |
|      PREAGGREGATION: OFF. Reason: No AggregateInfo |
|      partitions=0/2                                |
|      rollup: null                                  |
|      buckets=0/0                                   |
|      cardinality=-1                                |
|      avgRowSize=0.0                                |
|      numNodes=0                                    |
|                                                    |
| PLAN FRAGMENT 1                                    |
|  OUTPUT EXPRS:                                     |
|   PARTITION: RANDOM                                |
|                                                    |
|   STREAM DATA SINK                                 |
|     EXCHANGE ID: 03                                |
|     UNPARTITIONED                                  |
|                                                    |
|   1:OlapScanNode                                   |
|      TABLE: tbl2                                   |
|      PREAGGREGATION: OFF. Reason: null             |
|      partitions=0/1                                |
|      rollup: null                                  |
|      buckets=0/0                                   |
|      cardinality=-1                                |
|      avgRowSize=0.0                                |
|      numNodes=0                                    |
|      tuple ids: 1                                  |
+----------------------------------------------------+
HASH JOIN 노드에 해당 이유인 colocate: false, reason: group is not stable이 표시되고, EXCHANGE 노드가 생성됩니다.
Join 유형 비교
쿼리가 Colocation Join을 사용하는지 판단하는 데 도움이 되도록, 다음 표에서 Doris의 일반적인 Join 유형을 비교합니다.
| Join 유형 | 데이터 Shuffle 여부 | 적용 조건 |
|---|---|---|
| Colocate Join | 없음 | 테이블이 동일한 Colocate Group에 속하고 IsStable=true인 경우. |
| Bucket Shuffle Join | 일부(한쪽) | Join Key가 왼쪽 테이블의 버킷 열과 일치하는 경우. |
| Shuffle Join | 있음(양쪽) | 위 조건 중 어느 것도 충족하지 않을 때의 기본 동작. |
| Broadcast Join | 있음(작은 테이블) | 오른쪽 테이블이 작은 경우. |
고급 작업
FE 설정 항목
| 설정 | 기본값 | 설명 |
|---|---|---|
disable_colocate_relocate | false | Doris의 자동 Colocation 복제본 복구를 비활성화할지 여부입니다. 기본값은 false(비활성화하지 않음)입니다. 이 매개변수는 Colocation 테이블의 복제본 복구에만 영향을 미치며, 일반 테이블에는 영향을 미치지 않습니다. |
disable_colocate_balance | false | Doris의 자동 Colocation 복제본 균형 조정을 비활성화할지 여부입니다. 기본값은 false(비활성화하지 않음)입니다. 이 매개변수는 Colocation 테이블의 복제본 균형 조정에만 영향을 미치며, 일반 테이블에는 영향을 미치지 않습니다. |
disable_colocate_join | 설명 참조 | Colocation Join 기능을 비활성화할지 여부입니다. 0.10 이하 버전에서는 기본값이 true(비활성화)입니다. 이후 버전에서는 기본값이 false(활성화)가 됩니다. |
use_new_tablet_scheduler | 설명 참조 | 0.10 이하 버전에서는 새로운 복제본 스케줄링 로직이 Colocation Join 기능과 호환되지 않습니다. 따라서 0.10 이하 버전에서 disable_colocate_join = false인 경우, use_new_tablet_scheduler = false로 설정하여 새로운 복제본 스케줄러를 비활성화해야 합니다. 이후 버전에서는 use_new_tablet_scheduler가 항상 true입니다. |
위 매개변수 disable_colocate_relocate와 disable_colocate_balance는 동적으로 변경할 수 있습니다. 자세한 내용은 HELP SHOW CONFIG;와 HELP SET CONFIG;를 참조하세요.
HTTP Restful API
Doris는 Colocation Group을 조회하고 수정할 수 있도록 Colocation Join과 관련된 여러 HTTP Restful API를 제공합니다.
이 API는 FE 측에 구현되어 있으며 fe_host:fe_http_port를 통해 접근합니다. ADMIN 권한이 필요합니다.
1. 클러스터의 모든 Colocation 정보 조회
GET /api/colocate

Returns the internal Colocation information in JSON format.

{
    "msg": "success",
    "code": 0,
    "data": {
        "infos": [
            ["10003.12002", "10003_group1", "10037, 10043", "1", "1", "int(11)", "true"]
        ],
        "unstableGroupIds": [],
        "allGroupIds": [{
            "dbId": 10003,
            "grpId": 12002
        }]
    },
    "count": 0
}
2. 그룹을 Stable 또는 Unstable로 표시
-
Stable로 표시
DELETE /api/colocate/group_stable?db_id=10005&group_id=10008

Returns: 200 -
Unstable로 표시
POST /api/colocate/group_stable?db_id=10005&group_id=10008

Returns: 200
3. 그룹의 데이터 분포 설정
이 엔드포인트는 그룹의 데이터 분포를 강제로 설정할 수 있습니다.
POST /api/colocate/bucketseq?db_id=10005&group_id=10008

Body:
[[10004,10002],[10003,10002],[10002,10004],[10003,10002],[10002,10004],[10003,10002],[10003,10004],[10003,10004],[10003,10004],[10002,10004]]

Returns 200
Body는 BucketsSequence와 각 버킷의 샤드가 분산된 BE ID를 나타내는 중첩 배열입니다.
이 명령을 사용할 때는 FE 설정 disable_colocate_relocate와 disable_colocate_balance를 true로 설정해야 할 수 있습니다. 즉, 시스템의 자동 Colocation 복제본 복구와 균형 조정을 비활성화해야 할 수 있습니다. 그렇지 않으면 시스템이 변경 사항을 자동으로 되돌릴 수 있습니다.
자주 묻는 질문
colocate: false, reason: group is not stable이 쿼리 계획에 표시됨
이는 그룹이 현재 Unstable 상태임을 나타내며, 복제본 복구 또는 균형 조정이 진행 중이기 때문일 수 있습니다. 이 경우 Join이 일반 Join으로 전환됩니다. 그룹이 Stable 상태로 돌아오면 Colocation Join을 다시 사용할 수 있습니다. IsStable 필드는 SHOW PROC '/colocation_group';로 확인할 수 있습니다.
Colocation Group이 현재 사용 가능한지 확인하는 방법
SHOW PROC "/colocation_group";를 실행하고 IsStable 필드를 확인하세요. true이면 사용 가능한 상태로, Join이 Colocate 계획을 사용할 수 있습니다. false이면 Doris가 데이터 균형을 조정하는 동안 일시적으로 사용할 수 없는 상태입니다.
IsStable=false 상태는 얼마나 지속되나요
데이터 이동 규모와 클러스터 부하에 따라 달라집니다. Doris가 Tablet 균형 조정을 완료하면 상태가 자동으로 복구됩니다. 오랫동안 false 상태가 유지되면 아래 항목을 참조하여 문제를 해결하세요.
테이블 생성 오류: 지정한 그룹에 테이블을 추가할 수 없음
다음 조건을 모두 충족하는지 확인하세요.
- 버킷 열의 타입과 개수가 그룹의 기존 테이블과 정확히 같아야 합니다.
- 버킷 수가 같아야 합니다.
- 모든 파티션의 복제본 수가 같아야 합니다.
하나라도 일치하지 않으면 테이블을 그룹에 추가할 수 없습니다.
그룹이 오랫동안 Unstable 상태로 유지됨
가능한 원인은 다음과 같습니다.
- 클러스터에서 BE가 비정상 종료되거나 Decommission되어 복제본 복구가 아직 진행 중입니다.
- 이기종 클러스터 구성으로 인해 균형 조정이 수렴하기 어렵습니다.
- 자동 균형 조정이 활성화되어 데이터 이동이 계속 발생합니다.
disable_colocate_balance = true로 설정하여 자동 균형 조정을 일시적으로 비활성화하고, 클러스터가 안정된 후 다시 활성화할 수 있습니다.
서로 다른 데이터베이스의 두 테이블이 Colocation Join을 수행할 수 있나요
가능합니다. 2.0 이상 버전에서는 __global__ 접두사가 있는 Global Group 이름을 사용하여 테이블을 생성할 수 있습니다.