분석 함수(윈도우 함수)
윈도우 함수라고도 하는 분석 함수는 결과 집합의 여러 행에 걸쳐 복잡한 계산을 수행하는 SQL 함수입니다. 윈도우 함수의 핵심 특징은 쿼리가 반환하는 행 수를 줄이지 않는다는 점입니다. 대신 각 행에 새로 계산한 값을 추가합니다.
윈도우 함수는 누적 합계, 순위, 이동 평균, 전년 동기 또는 이전 기간 대비 비교 등 다양한 데이터 분석에 유용합니다. 자세한 구문은 윈도우 함수 개요를 참조하세요.
활용 시나리오
윈도우 함수는 주로 다음과 같은 데이터 분석 시나리오에서 사용됩니다.
| 시나리오 | 대표적인 질문 | 권장 함수 |
|---|---|---|
| 순위 및 그룹화 | "각 지역의 매장에 매출 기준으로 순위를 매기세요." | RANK / DENSE_RANK / ROW_NUMBER / NTILE |
| 누적 통계 | "각 상품 카테고리의 월별 누적 매출을 계산하세요." | SUM() OVER (... ROWS UNBOUNDED PRECEDING) |
| 이동 평균 | "각 날짜의 앞뒤 사흘을 포함한 매장 매출의 이동 평균을 계산하세요." | AVG() OVER (... ROWS BETWEEN n PRECEDING AND n FOLLOWING) |
| 리포팅 분석 | "매년 매출이 가장 높은 상품 카테고리를 찾으세요." | MAX() / SUM() OVER (PARTITION BY ...) |
| 행 간 비교 | "각 카테고리의 전년 대비 매출 차이를 계산하세요." | LAG / LEAD |
빠른 시작: 이동 평균 예제
다음 예제는 테이블 생성부터 결과 확인까지의 전체 과정을 통해 윈도우 함수로 각 매장의 매출 이동 평균을 계산하는 방법을 보여 줍니다. 윈도우 범위는 현재 날짜의 이전 사흘부터 이후 사흘까지입니다.
1. 테이블 생성 및 데이터 적재
CREATE TABLE daily_sales (
    store_id INT,
    sales_date DATE,
    sales_amount DECIMAL(10, 2)
) PROPERTIES ("replication_num" = "1");

INSERT INTO daily_sales (store_id, sales_date, sales_amount) VALUES
(1, '2023-01-01', 100.00), (1, '2023-01-02', 150.00), (1, '2023-01-03', 200.00),
(1, '2023-01-04', 250.00), (1, '2023-01-05', 300.00), (1, '2023-01-06', 350.00),
(1, '2023-01-07', 400.00), (1, '2023-01-08', 450.00), (1, '2023-01-09', 500.00),
(2, '2023-01-01', 110.00), (2, '2023-01-02', 160.00), (2, '2023-01-03', 210.00),
(2, '2023-01-04', 260.00), (2, '2023-01-05', 310.00), (2, '2023-01-06', 360.00),
(2, '2023-01-07', 410.00), (2, '2023-01-08', 460.00), (2, '2023-01-09', 510.00);
2. 쿼리 작성
SELECT
    store_id,
    sales_date,
    sales_amount,
    AVG(sales_amount) OVER (
        PARTITION BY store_id
        ORDER BY sales_date
        ROWS BETWEEN 3 PRECEDING AND 3 FOLLOWING
    ) AS moving_avg_sales
FROM daily_sales;
3. 쿼리 결과
+----------+------------+--------------+------------------+
| store_id | sales_date | sales_amount | moving_avg_sales |
+----------+------------+--------------+------------------+
|        1 | 2023-01-01 |       100.00 |         175.0000 |
|        1 | 2023-01-02 |       150.00 |         200.0000 |
|        1 | 2023-01-03 |       200.00 |         225.0000 |
|        1 | 2023-01-04 |       250.00 |         250.0000 |
|        1 | 2023-01-05 |       300.00 |         300.0000 |
|        1 | 2023-01-06 |       350.00 |         350.0000 |
|        1 | 2023-01-07 |       400.00 |         375.0000 |
|        1 | 2023-01-08 |       450.00 |         400.0000 |
|        1 | 2023-01-09 |       500.00 |         425.0000 |
|        2 | 2023-01-01 |       110.00 |         185.0000 |
|        2 | 2023-01-02 |       160.00 |         210.0000 |
|        2 | 2023-01-03 |       210.00 |         235.0000 |
|        2 | 2023-01-04 |       260.00 |         260.0000 |
|        2 | 2023-01-05 |       310.00 |         310.0000 |
|        2 | 2023-01-06 |       360.00 |         360.0000 |
|        2 | 2023-01-07 |       410.00 |         385.0000 |
|        2 | 2023-01-08 |       460.00 |         410.0000 |
|        2 | 2023-01-09 |       510.00 |         435.0000 |
+----------+------------+--------------+------------------+
18 rows in set (0.09 sec)
기본 개념
윈도우 함수를 사용하기 전에 실행 순서, 파티션, 윈도우 프레임, 현재 행이라는 핵심 개념을 이해해야 합니다.
처리 순서
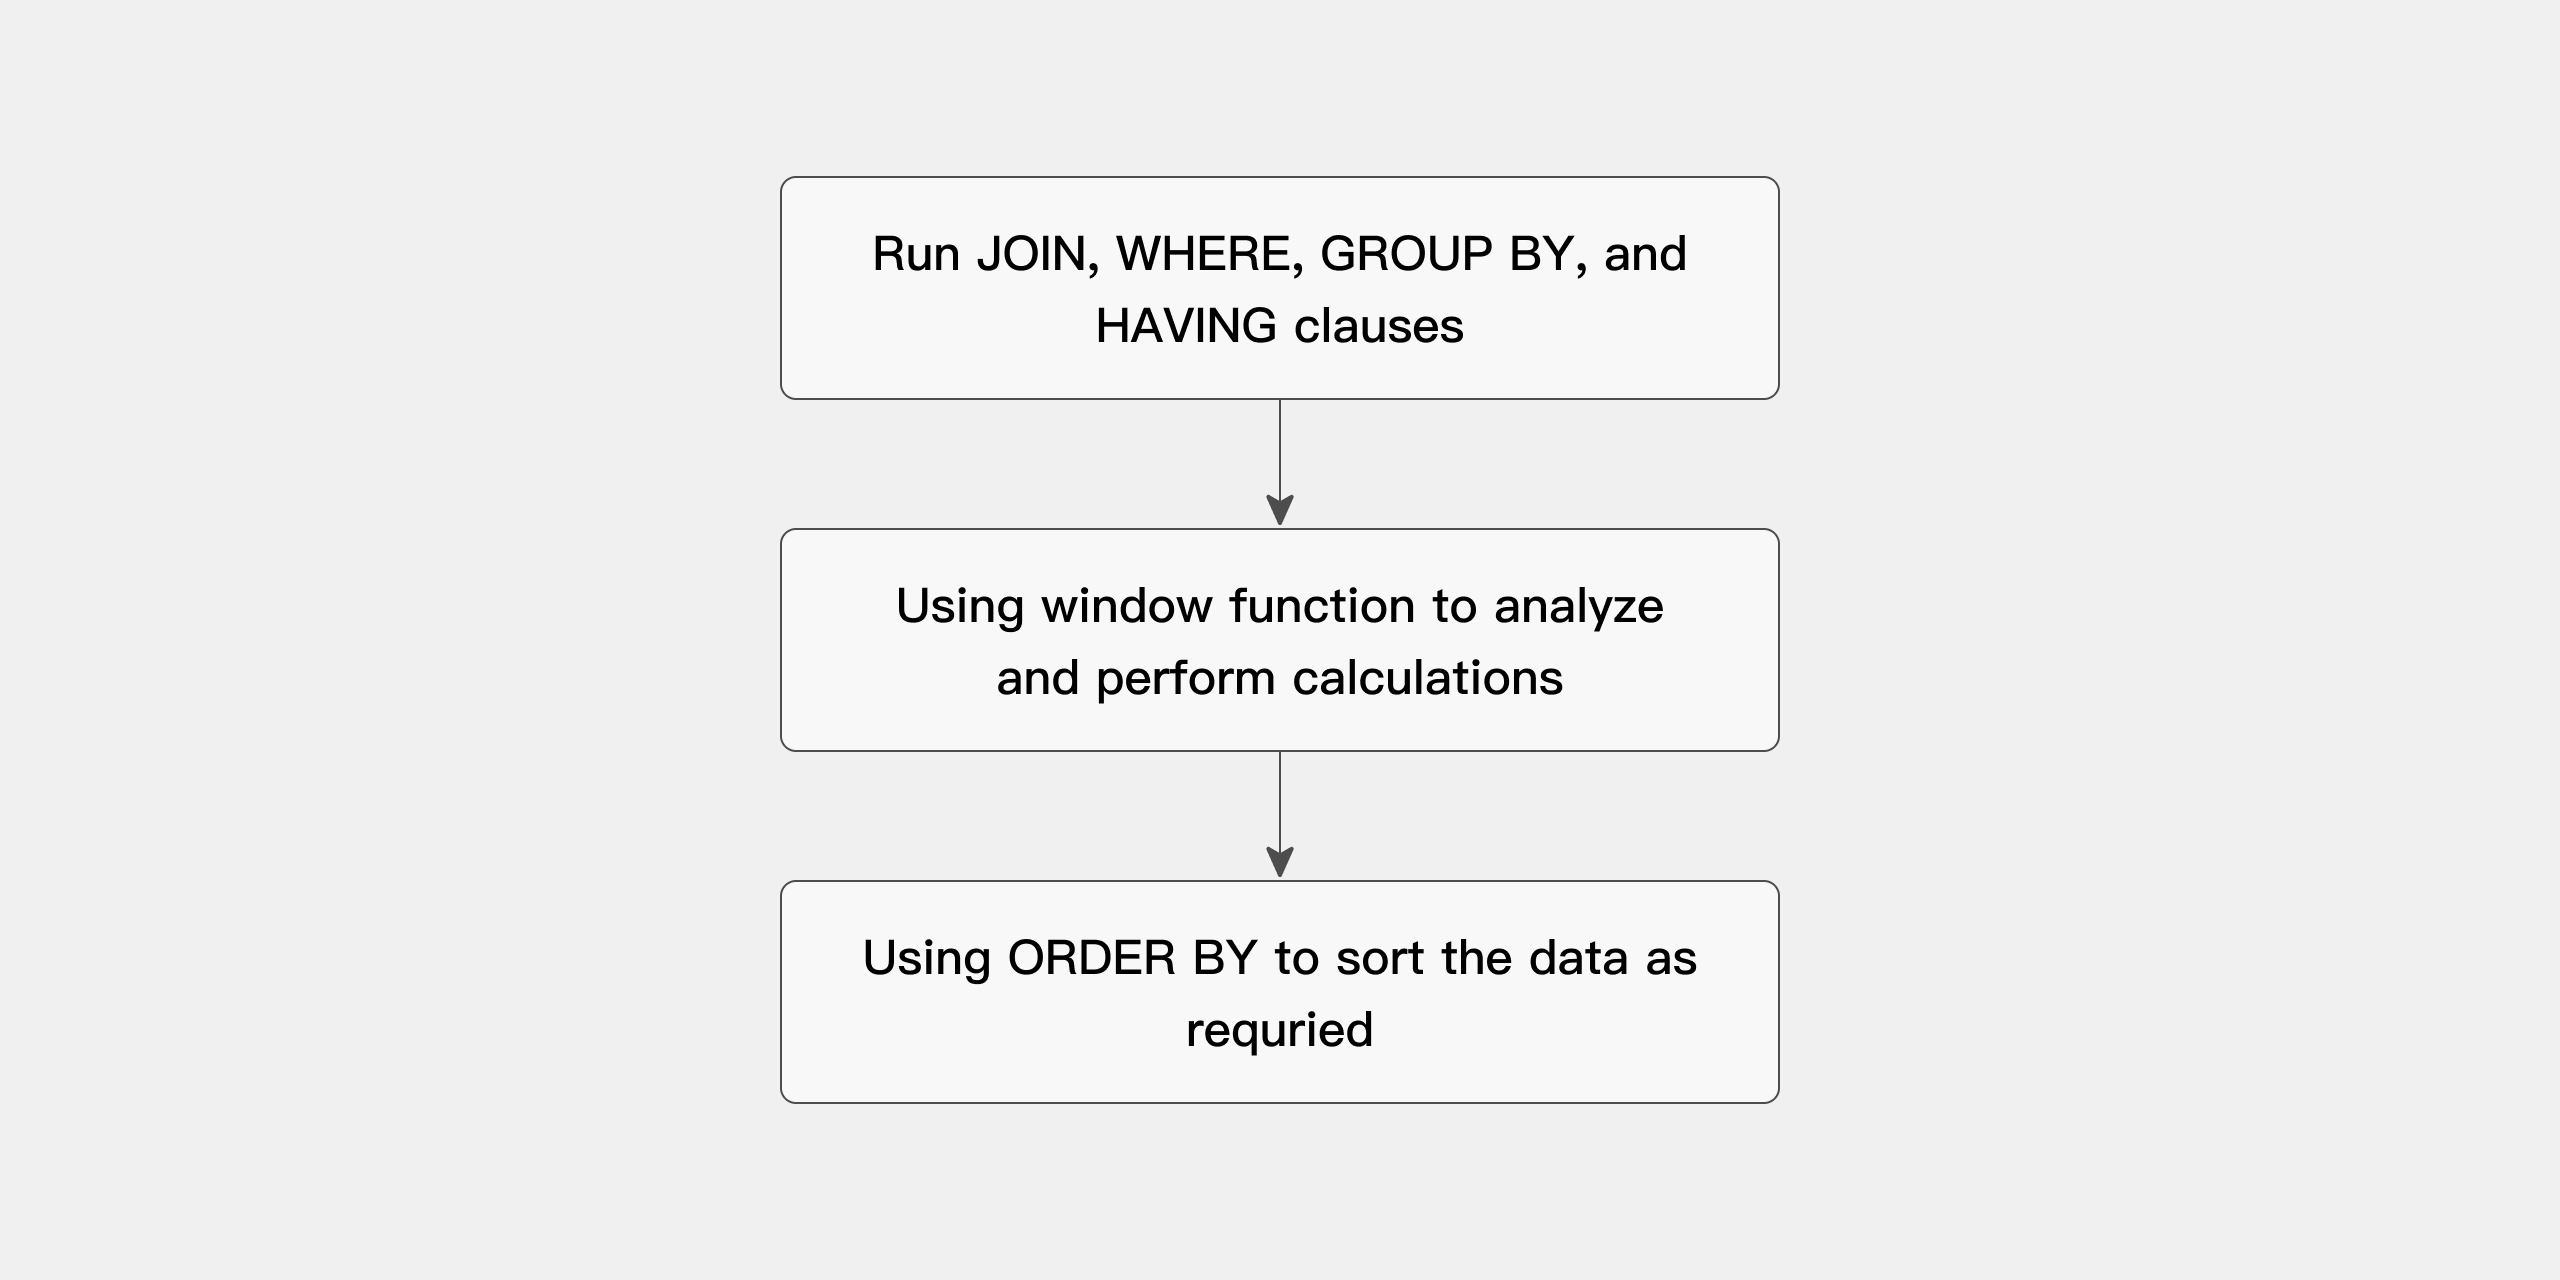
분석 함수를 사용하는 쿼리는 세 단계로 처리됩니다.
- 모든
JOIN,WHERE,GROUP BY,HAVING절을 먼저 평가합니다. - 그 결과 집합을 분석 함수에 전달하여 모든 윈도우 계산을 수행합니다.
- 쿼리 끝에
ORDER BY절이 있으면 이 절을 마지막으로 처리하여 최종 출력 순서를 결정합니다.
처리 순서는 아래 그림과 같습니다.
결과 집합의 파티션 분할
파티션은 PARTITION BY 절로 정의하는 논리적 그룹입니다. 각 파티션 안의 행은 다른 파티션과 독립적으로 계산됩니다.
분석 함수에서 사용하는 "파티션"은 테이블 파티셔닝과는 관련이 없습니다. 이 장에서 "파티션"은 분석 함수에서의 의미만을 가리킵니다.
윈도우
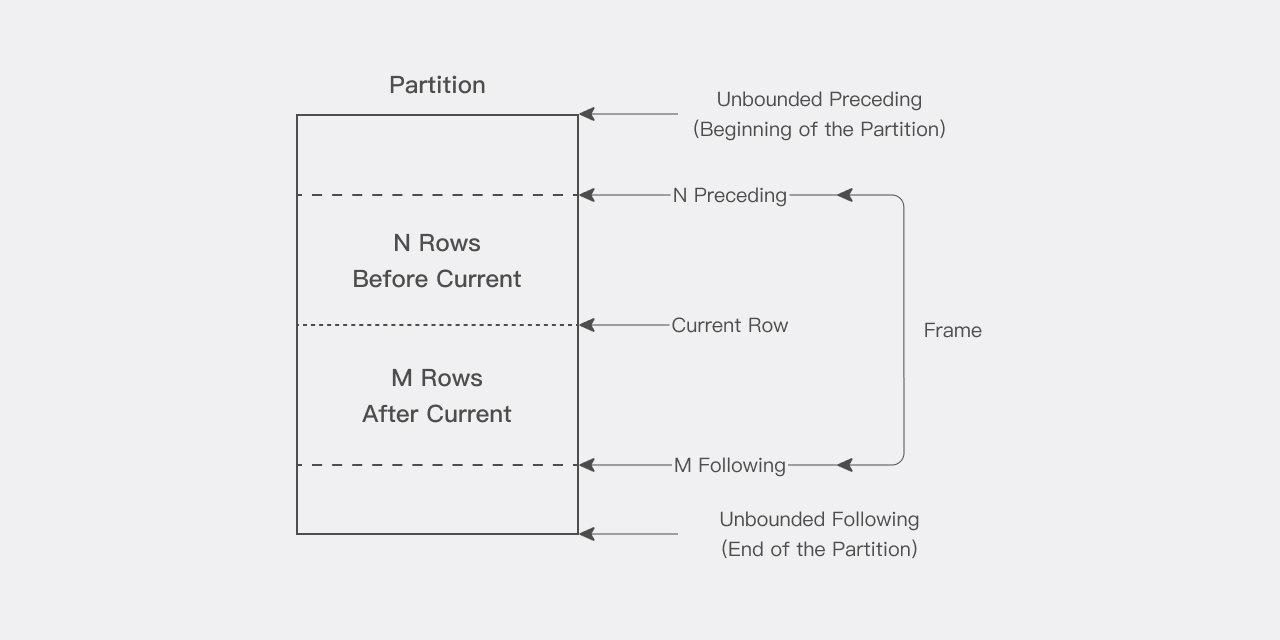
파티션의 각 행에 대해 슬라이딩 데이터 윈도우를 정의할 수 있습니다. 윈도우는 현재 행의 계산에 사용할 행의 범위를 결정합니다. 윈도우에는 시작 행과 끝 행이 있으며, 정의에 따라 한쪽 끝 또는 양쪽 끝이 이동할 수 있습니다.
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW: 누적 합계에 사용합니다. 윈도우의 시작점은 파티션의 첫 번째 행에 고정되고, 끝점은 시작 행부터 파티션의 마지막 행까지 이동합니다.ROWS BETWEEN 3 PRECEDING AND 3 FOLLOWING: 이동 평균에 사용합니다. 시작점과 끝점이 모두 현재 행을 따라 함께 이동합니다.
윈도우의 크기는 전체 파티션만큼 클 수도 있고 단일 행만큼 작을 수도 있습니다. 윈도우가 파티션 경계에 가까우면 경계로 인해 계산에 참여하는 행 수가 줄어들 수 있으며, 함수는 사용 가능한 행만으로 계산한 결과를 반환합니다.
윈도우 함수를 사용할 때는 현재 행도 계산에 포함됩니다. 따라서 n개 항목을 대상으로 계산하려면 (n-1)을 지정해야 합니다. 예를 들어 5일 평균을 계산하려면 윈도우를 ROWS BETWEEN 4 PRECEDING AND CURRENT ROW로 지정하며, 이를 ROWS 4 PRECEDING으로 줄여 쓸 수도 있습니다.
현재 행
분석 함수의 모든 계산은 파티션 내의 현재 행을 기준으로 수행됩니다. 현재 행은 윈도우의 시작점과 끝점을 결정하는 기준점입니다.
예를 들어 ROWS BETWEEN 6 PRECEDING AND 6 FOLLOWING은 중앙 이동 평균을 구하는 윈도우를 정의합니다. 이 윈도우에는 현재 행과 그 앞의 6개 행, 그 뒤의 6개 행이 포함되어 총 13개 행이 들어갑니다.
순위 함수
순위 함수는 파티션 내의 행을 정렬하거나 그룹으로 나눕니다. 참고: 지정한 정렬 컬럼의 값이 고유한 경우에만 쿼리 결과가 항상 동일합니다. 정렬 컬럼에 중복 값이 있으면 실행할 때마다 결과가 달라질 수 있습니다. 더 많은 함수는 윈도우 함수 개요를 참조하세요.
NTILE 함수
NTILE은 결과 집합을 지정한 수의 버킷(그룹)으로 나누고 각 행에 버킷 번호를 할당합니다. 데이터 분석과 리포팅에서 그룹별 순위를 구할 때 자주 사용됩니다.
구문
NTILE(num_buckets) OVER ([PARTITION BY partition_expression] ORDER BY order_expression)
매개변수 설명:
| 매개변수 | 설명 |
|---|---|
num_buckets | 행을 나눌 버킷의 수입니다. |
PARTITION BY partition_expression | 선택 사항입니다. 데이터를 파티션으로 나누는 방법을 정의합니다. |
ORDER BY order_expression | 필수 사항입니다. 데이터를 정렬하는 방법을 정의합니다. |
예제: 점수별로 학생을 버킷으로 나누기
학생들의 시험 점수가 저장된 class_student_scores 테이블이 있다고 가정하겠습니다. 학생들을 점수에 따라 4개 그룹으로 나누되, 각 그룹의 학생 수가 대략 같도록 하려고 합니다.
먼저 테이블을 생성하고 데이터를 삽입합니다.
CREATE TABLE class_student_scores (
    class_id INT,
    student_id INT,
    student_name VARCHAR(50),
    score INT
) DISTRIBUTED BY HASH(student_id) PROPERTIES('replication_num'='1');

INSERT INTO class_student_scores VALUES
(1, 1, 'Alice', 85),
(1, 2, 'Bob', 92),
(1, 3, 'Charlie', 87),
(2, 4, 'David', 78),
(2, 5, 'Eve', 95),
(2, 6, 'Frank', 80),
(2, 7, 'Grace', 90),
(2, 8, 'Hannah', 84);
그런 다음 NTILE 함수를 사용하여 학생들을 점수에 따라 버킷으로 나눕니다.
SELECT
    student_id,
    student_name,
    score,
    NTILE(4) OVER (ORDER BY score DESC) AS bucket
FROM class_student_scores;
쿼리 결과:
+------------+--------------+-------+--------+
| student_id | student_name | score | bucket |
+------------+--------------+-------+--------+
|          5 | Eve          |    95 |      1 |
|          2 | Bob          |    92 |      1 |
|          7 | Grace        |    90 |      2 |
|          3 | Charlie      |    87 |      2 |
|          1 | Alice        |    85 |      3 |
|          8 | Hannah       |    84 |      3 |
|          6 | Frank        |    80 |      4 |
|          4 | David        |    78 |      4 |
+------------+--------------+-------+--------+
8 rows in set (0.12 sec)
이 예제에서 NTILE(4)는 학생들을 점수에 따라 4개 버킷으로 나누며, 각 버킷에는 대략 같은 수의 학생이 포함됩니다.
- 행을 버킷에 균등하게 분배할 수 없으면 일부 버킷에 행이 하나 더 들어갈 수 있습니다.
NTILE은 각 파티션 안에서 독립적으로 동작합니다.PARTITION BY를 사용하면 각 파티션의 데이터를 별도로 버킷에 나눕니다.
PARTITION BY와 함께 사용하기
"먼저 반별로 그룹을 나눈 다음, 각 반의 학생들을 점수에 따라 3개 그룹으로 나누려면" NTILE과 PARTITION BY를 함께 사용할 수 있습니다.
SELECT
    class_id,
    student_id,
    student_name,
    score,
    NTILE(3) OVER (PARTITION BY class_id ORDER BY score DESC) AS bucket
FROM class_student_scores;
쿼리 결과:
+----------+------------+--------------+-------+--------+
| class_id | student_id | student_name | score | bucket |
+----------+------------+--------------+-------+--------+
|        1 |          2 | Bob          |    92 |      1 |
|        1 |          3 | Charlie      |    87 |      2 |
|        1 |          1 | Alice        |    85 |      3 |
|        2 |          5 | Eve          |    95 |      1 |
|        2 |          7 | Grace        |    90 |      1 |
|        2 |          8 | Hannah       |    84 |      2 |
|        2 |          6 | Frank        |    80 |      2 |
|        2 |          4 | David        |    78 |      3 |
+----------+------------+--------------+-------+--------+
8 rows in set (0.05 sec)
학생들이 반별로 파티션에 나뉘고, 각 반 안에서 점수에 따라 3개 버킷으로 나뉘는 것을 볼 수 있습니다. 각 버킷에는 대략 같은 수의 학생이 포함됩니다.
집계 함수
SUM, AVG, MAX, MIN과 같은 집계 함수는 OVER 절과 함께 사용하면 윈도우 함수로 동작합니다. GROUP BY 없이도 각 행에 대해 파티션 내의 집계 값을 계산합니다.
SUM으로 누적 합계 계산하기
다음 쿼리는 2000년 Books 및 Electronics 상품 카테고리의 월별 매출과 월별 누적 매출 합계를 계산합니다.
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    sum(sum(ss_net_paid)) OVER (
        PARTITION BY i_category
        ORDER BY year(d_date), month(d_date)
        ROWS UNBOUNDED PRECEDING
    ) AS cum_sales
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category IN ('Books', 'Electronics')
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
쿼리 결과:
+-------------+--------------+---------------+-------------+-------------+
| i_category  | year(d_date) | month(d_date) | total_sales | cum_sales   |
+-------------+--------------+---------------+-------------+-------------+
| Books       |         2000 |             1 |  5348482.88 |  5348482.88 |
| Books       |         2000 |             2 |  4353162.03 |  9701644.91 |
| Books       |         2000 |             3 |  4466958.01 | 14168602.92 |
| Books       |         2000 |             4 |  4495802.19 | 18664405.11 |
| Books       |         2000 |             5 |  4589913.47 | 23254318.58 |
| Books       |         2000 |             6 |  4384384.00 | 27638702.58 |
| Books       |         2000 |             7 |  4488018.76 | 32126721.34 |
| Books       |         2000 |             8 |  9909227.94 | 42035949.28 |
| Books       |         2000 |             9 | 10366110.30 | 52402059.58 |
| Books       |         2000 |            10 | 10445320.76 | 62847380.34 |
| Books       |         2000 |            11 | 15246901.52 | 78094281.86 |
| Books       |         2000 |            12 | 15526630.11 | 93620911.97 |
| Electronics |         2000 |             1 |  5534568.17 |  5534568.17 |
| Electronics |         2000 |             2 |  4472655.10 | 10007223.27 |
| Electronics |         2000 |             3 |  4316942.60 | 14324165.87 |
| Electronics |         2000 |             4 |  4211523.06 | 18535688.93 |
| Electronics |         2000 |             5 |  4723661.00 | 23259349.93 |
| Electronics |         2000 |             6 |  4127773.06 | 27387122.99 |
| Electronics |         2000 |             7 |  4286523.05 | 31673646.04 |
| Electronics |         2000 |             8 | 10004890.96 | 41678537.00 |
| Electronics |         2000 |             9 | 10143665.77 | 51822202.77 |
| Electronics |         2000 |            10 | 10312020.35 | 62134223.12 |
| Electronics |         2000 |            11 | 14696000.54 | 76830223.66 |
| Electronics |         2000 |            12 | 15344441.52 | 92174665.18 |
+-------------+--------------+---------------+-------------+-------------+
24 rows in set (0.13 sec)
이 예제에서 SUM 집계 함수는 각 행에 대해 윈도우를 정의합니다. 시작점은 파티션의 첫 번째 행(UNBOUNDED PRECEDING)에 고정되며, 끝점의 기본값은 현재 행입니다. 여기서 SUM이 중첩된 이유는 바깥쪽 SUM이 안쪽 SUM의 결과를 집계하기 때문입니다. 분석 집계 함수에서는 중첩 집계가 매우 흔하게 사용됩니다.
AVG로 이동 평균 계산하기
다음 쿼리는 2000년 Books 카테고리의 월별 매출에 대한 "3개월 이동 평균"(현재 월과 이전 두 달)을 계산합니다.
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    avg(sum(ss_net_paid)) OVER (
        ORDER BY year(d_date), month(d_date)
        ROWS 2 PRECEDING
    ) AS avg
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category = 'Books'
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
쿼리 결과:
+------------+--------------+---------------+-------------+---------------+
| i_category | year(d_date) | month(d_date) | total_sales | avg           |
+------------+--------------+---------------+-------------+---------------+
| Books      |         2000 |             1 |  5348482.88 |  5348482.8800 |
| Books      |         2000 |             2 |  4353162.03 |  4850822.4550 |
| Books      |         2000 |             3 |  4466958.01 |  4722867.6400 |
| Books      |         2000 |             4 |  4495802.19 |  4438640.7433 |
| Books      |         2000 |             5 |  4589913.47 |  4517557.8900 |
| Books      |         2000 |             6 |  4384384.00 |  4490033.2200 |
| Books      |         2000 |             7 |  4488018.76 |  4487438.7433 |
| Books      |         2000 |             8 |  9909227.94 |  6260543.5666 |
| Books      |         2000 |             9 | 10366110.30 |  8254452.3333 |
| Books      |         2000 |            10 | 10445320.76 | 10240219.6666 |
| Books      |         2000 |            11 | 15246901.52 | 12019444.1933 |
| Books      |         2000 |            12 | 15526630.11 | 13739617.4633 |
+------------+--------------+---------------+-------------+---------------+
12 rows in set (0.13 sec)
출력의 처음 두 행에서 avg 컬럼은 실제로 온전한 3개월 평균으로 계산되지 않습니다. 앞선 행이 충분하지 않기 때문입니다(SQL에서는 윈도우 크기를 3개 행으로 지정합니다).
"현재 행을 중심으로 하는" 윈도우 집계도 계산할 수 있습니다. 아래 예제는 2000년 Books 카테고리의 월별 매출에 대한 중앙 이동 평균, 즉 "이전 월, 현재 월, 다음 월"의 매출 평균을 계산합니다.
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    avg(sum(ss_net_paid)) OVER (
        ORDER BY year(d_date), month(d_date)
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS avg_sales
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category = 'Books'
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
출력의 첫 번째 행과 마지막 행에서는 경계의 한쪽에 행이 충분하지 않으므로 두 달의 데이터만으로 중앙 이동 평균을 계산합니다.
리포팅 함수
리포팅 함수는 "모든 행의 윈도우가 전체 파티션을 포함한다"는 특성이 있습니다. 주요 장점은 단일 쿼리에서 같은 데이터를 여러 번 참조할 수 있다는 점으로, 명시적인 JOIN을 생략하여 쿼리 성능을 높일 수 있습니다.
예를 들어 "매년 매출이 가장 높은 상품 카테고리 찾기"라는 요구 사항은 리포팅 함수로 구현할 수 있으며 JOIN이 필요하지 않습니다.
SELECT year, category, total_sum FROM (
    SELECT
        year(d_date) AS year,
        i_category AS category,
        sum(ss_net_paid) AS total_sum,
        max(sum(ss_net_paid)) OVER (PARTITION BY year(d_date)) AS max_sales
    FROM
        store_sales,
        date_dim d1,
        item
    WHERE
        d1.d_date_sk = ss_sold_date_sk
        AND i_item_sk = ss_item_sk
        AND year(d_date) IN (1998, 1999)
    GROUP BY
        year(d_date), i_category
) t
WHERE total_sum = max_sales;
내부 쿼리는 MAX(SUM(ss_net_paid))를 사용하여 각 연도의 카테고리별 매출 중 최댓값을 구하며, 결과는 다음과 같습니다.
+------+-------------+-------------+-------------+
| year | category    | total_sum   | max_sales   |
+------+-------------+-------------+-------------+
| 1998 | Electronics | 91723676.27 | 91723676.27 |
| 1998 | Books       | 91307909.84 | 91723676.27 |
| 1999 | Electronics | 90310850.54 | 90310850.54 |
| 1999 | Books       | 88993351.11 | 90310850.54 |
+------+-------------+-------------+-------------+
4 rows in set (0.11 sec)
외부 쿼리에서 total_sum = max_sales로 필터링하면 각 연도에서 매출이 가장 높은 카테고리를 얻을 수 있습니다.
+------+-------------+-------------+
| year | category    | total_sum   |
+------+-------------+-------------+
| 1998 | Electronics | 91723676.27 |
| 1999 | Electronics | 90310850.54 |
+------+-------------+-------------+
2 rows in set (0.12 sec)
리포팅 집계를 중첩 쿼리와 결합하면 더 복잡한 문제도 해결할 수 있습니다. 예를 들어 "상품 매출이 해당 상품 카테고리 총매출의 20%를 초과하는 하위 카테고리를 찾고, 해당 하위 카테고리에서 매출 상위 5개 상품을 선택"할 수 있습니다.
SELECT i_category AS categ, i_class AS sub_categ, i_item_id
FROM (
    SELECT
        i_item_id, i_class, i_category,
        sum(ss_net_paid) AS sales,
        sum(sum(ss_net_paid)) OVER (PARTITION BY i_category) AS cat_sales,
        sum(sum(ss_net_paid)) OVER (PARTITION BY i_class) AS sub_cat_sales,
        rank() OVER (PARTITION BY i_class ORDER BY sum(ss_net_paid) DESC) AS rank_in_line
    FROM
        store_sales,
        item
    WHERE
        i_item_sk = ss_item_sk
    GROUP BY i_class, i_category, i_item_id
) t
WHERE sub_cat_sales > 0.2 * cat_sales AND rank_in_line <= 5;
LAG / LEAD 함수
LAG와 LEAD 함수는 "행 간 비교"를 위해 설계되었습니다. 두 함수 모두 셀프 조인 없이 테이블의 여러 행에 접근할 수 있어 쿼리 효율을 크게 높여 줍니다.
LAG: 현재 행보다 지정한 오프셋만큼 앞에 있는 행에 접근합니다.LEAD: 현재 행보다 지정한 오프셋만큼 뒤에 있는 행에 접근합니다.
예제 1: LAG로 전년 대비 매출 차이 계산하기
다음 쿼리는 1999년, 2000년, 2001년, 2002년의 각 상품 카테고리에 대해 총매출, 전년도 총매출, 두 값의 차이를 조회합니다.
SELECT year, category, total_sales, before_year_sales, total_sales - before_year_sales FROM (
    SELECT
        sum(ss_net_paid) AS total_sales,
        year(d_date) AS year,
        i_category AS category,
        lag(sum(ss_net_paid), 1, 0) OVER (
            PARTITION BY i_category
            ORDER BY YEAR(d_date)
        ) AS before_year_sales
    FROM
        store_sales,
        date_dim d1,
        item
    WHERE
        d1.d_date_sk = ss_sold_date_sk
        AND i_item_sk = ss_item_sk
    GROUP BY
        YEAR(d_date), i_category
) t
WHERE year IN (1999, 2000, 2001, 2002);
쿼리 결과:
+------+-------------+-------------+-------------------+-----------------------------------+
| year | category    | total_sales | before_year_sales | (total_sales - before_year_sales) |
+------+-------------+-------------+-------------------+-----------------------------------+
| 1999 | Books       | 88993351.11 |       91307909.84 |                       -2314558.73 |
| 2000 | Books       | 93620911.97 |       88993351.11 |                        4627560.86 |
| 2001 | Books       | 90640097.99 |       93620911.97 |                       -2980813.98 |
| 2002 | Books       | 89585515.90 |       90640097.99 |                       -1054582.09 |
| 1999 | Electronics | 90310850.54 |       91723676.27 |                       -1412825.73 |
| 2000 | Electronics | 92174665.18 |       90310850.54 |                        1863814.64 |
| 2001 | Electronics | 92598527.85 |       92174665.18 |                         423862.67 |
| 2002 | Electronics | 94303831.84 |       92598527.85 |                        1705303.99 |
+------+-------------+-------------+-------------------+-----------------------------------+
8 rows in set (0.16 sec)
예제 2: 윈도우 함수로 3일 주가 평균 계산하기
다음과 같은 주식 데이터가 있다고 가정하겠습니다. 종목 코드는 JDR이고 closing_price는 일별 종가입니다.
CREATE TABLE stock_ticker (
    stock_symbol STRING,
    closing_price DECIMAL(8, 2),
    closing_date DATETIME
);

INSERT INTO stock_ticker VALUES
    ("JDR", 12.86, "2014-10-02 00:00:00"),
    ("JDR", 12.89, "2014-10-03 00:00:00"),
    ("JDR", 12.94, "2014-10-04 00:00:00"),
    ("JDR", 12.55, "2014-10-05 00:00:00"),
    ("JDR", 14.03, "2014-10-06 00:00:00"),
    ("JDR", 14.75, "2014-10-07 00:00:00"),
    ("JDR", 13.98, "2014-10-08 00:00:00");

SELECT * FROM stock_ticker ORDER BY stock_symbol, closing_date;
| stock_symbol | closing_price | closing_date        |
|--------------|---------------|---------------------|
| JDR          | 12.86         | 2014-10-02 00:00:00 |
| JDR          | 12.89         | 2014-10-03 00:00:00 |
| JDR          | 12.94         | 2014-10-04 00:00:00 |
| JDR          | 12.55         | 2014-10-05 00:00:00 |
| JDR          | 14.03         | 2014-10-06 00:00:00 |
| JDR          | 14.75         | 2014-10-07 00:00:00 |
| JDR          | 13.98         | 2014-10-08 00:00:00 |
아래 쿼리는 윈도우 함수를 사용하여 moving_average 컬럼을 생성합니다. 이 컬럼의 값은 이전 날, 현재 날, 다음 날의 주가 평균입니다. 첫날에는 이전 날이 없고 마지막 날에는 다음 날이 없으므로, 이 두 행은 실제로 이틀의 데이터만으로 평균을 계산합니다. 여기서는 모든 데이터가 PARTITION BY의 대상인 동일 종목에 속하지만, 종목을 나타내는 JDR 외에 여러 종목이 있을 때는 PARTITION BY가 같은 종목 안에서만 윈도우 계산이 수행되도록 합니다.
SELECT
    stock_symbol,
    closing_date,
    closing_price,
    avg(closing_price) OVER (
        PARTITION BY stock_symbol
        ORDER BY closing_date
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS moving_average
FROM stock_ticker;
| stock_symbol | closing_date        | closing_price | moving_average |
|--------------|---------------------|---------------|----------------|
| JDR          | 2014-10-02 00:00:00 | 12.86         | 12.87          |
| JDR          | 2014-10-03 00:00:00 | 12.89         | 12.89          |
| JDR          | 2014-10-04 00:00:00 | 12.94         | 12.79          |
| JDR          | 2014-10-05 00:00:00 | 12.55         | 13.17          |
| JDR          | 2014-10-06 00:00:00 | 14.03         | 13.77          |
| JDR          | 2014-10-07 00:00:00 | 14.75         | 14.25          |
| JDR          | 2014-10-08 00:00:00 | 13.98         | 14.36          |
부록: 예제 데이터 준비
이 문서의 집계 함수, 리포팅 함수, LAG/LEAD 예제는 모두 TPC-DS 형식의 테이블(item, store_sales, date_dim, customer_address)을 기반으로 합니다. 예제를 재현하려면 아래 단계에 따라 데이터를 준비하세요.
1. 예제 테이블 생성
CREATE DATABASE IF NOT EXISTS doc_tpcds;
USE doc_tpcds;

CREATE TABLE IF NOT EXISTS item (
    i_item_sk bigint not null,
    i_item_id char(16) not null,
    i_rec_start_date date,
    i_rec_end_date date,
    i_item_desc varchar(200),
    i_current_price decimal(7,2),
    i_wholesale_cost decimal(7,2),
    i_brand_id integer,
    i_brand char(50),
    i_class_id integer,
    i_class char(50),
    i_category_id integer,
    i_category char(50),
    i_manufact_id integer,
    i_manufact char(50),
    i_size char(20),
    i_formulation char(20),
    i_color char(20),
    i_units char(10),
    i_container char(10),
    i_manager_id integer,
    i_product_name char(50)
)
DUPLICATE KEY(i_item_sk)
DISTRIBUTED BY HASH(i_item_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS store_sales (
    ss_item_sk bigint not null,
    ss_ticket_number bigint not null,
    ss_sold_date_sk bigint,
    ss_sold_time_sk bigint,
    ss_customer_sk bigint,
    ss_cdemo_sk bigint,
    ss_hdemo_sk bigint,
    ss_addr_sk bigint,
    ss_store_sk bigint,
    ss_promo_sk bigint,
    ss_quantity integer,
    ss_wholesale_cost decimal(7,2),
    ss_list_price decimal(7,2),
    ss_sales_price decimal(7,2),
    ss_ext_discount_amt decimal(7,2),
    ss_ext_sales_price decimal(7,2),
    ss_ext_wholesale_cost decimal(7,2),
    ss_ext_list_price decimal(7,2),
    ss_ext_tax decimal(7,2),
    ss_coupon_amt decimal(7,2),
    ss_net_paid decimal(7,2),
    ss_net_paid_inc_tax decimal(7,2),
    ss_net_profit decimal(7,2)
)
DUPLICATE KEY(ss_item_sk, ss_ticket_number)
DISTRIBUTED BY HASH(ss_item_sk, ss_ticket_number) BUCKETS 32
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS date_dim (
    d_date_sk bigint not null,
    d_date_id char(16) not null,
    d_date date,
    d_month_seq integer,
    d_week_seq integer,
    d_quarter_seq integer,
    d_year integer,
    d_dow integer,
    d_moy integer,
    d_dom integer,
    d_qoy integer,
    d_fy_year integer,
    d_fy_quarter_seq integer,
    d_fy_week_seq integer,
    d_day_name char(9),
    d_quarter_name char(6),
    d_holiday char(1),
    d_weekend char(1),
    d_following_holiday char(1),
    d_first_dom integer,
    d_last_dom integer,
    d_same_day_ly integer,
    d_same_day_lq integer,
    d_current_day char(1),
    d_current_week char(1),
    d_current_month char(1),
    d_current_quarter char(1),
    d_current_year char(1)
)
DUPLICATE KEY(d_date_sk)
DISTRIBUTED BY HASH(d_date_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS customer_address (
    ca_address_sk bigint not null,
    ca_address_id char(16) not null,
    ca_street_number char(10),
    ca_street_name varchar(60),
    ca_street_type char(15),
    ca_suite_number char(10),
    ca_city varchar(60),
    ca_county varchar(30),
    ca_state char(2),
    ca_zip char(10),
    ca_country varchar(20),
    ca_gmt_offset decimal(5,2),
    ca_location_type char(20)
)
DUPLICATE KEY(ca_address_sk)
DISTRIBUTED BY HASH(ca_address_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);
2. 데이터 다운로드 및 Stream Load를 통한 데이터 적재
터미널에서 다음 명령을 실행하여 데이터를 로컬에 다운로드하고 Stream Load로 데이터를 적재합니다.
curl -L https://cdn.selectdb.com/static/doc_ddl_dir_d27a752a7b.tar -o - | tar -Jxf -

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: i_item_sk, i_item_id, i_rec_start_date, i_rec_end_date, i_item_desc, i_current_price, i_wholesale_cost, i_brand_id, i_brand, i_class_id, i_class, i_category_id, i_category, i_manufact_id, i_manufact, i_size, i_formulation, i_color, i_units, i_container, i_manager_id, i_product_name" \
    -T "doc_ddl_dir/item_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/item/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: d_date_sk, d_date_id, d_date, d_month_seq, d_week_seq, d_quarter_seq, d_year, d_dow, d_moy, d_dom, d_qoy, d_fy_year, d_fy_quarter_seq, d_fy_week_seq, d_day_name, d_quarter_name, d_holiday, d_weekend, d_following_holiday, d_first_dom, d_last_dom, d_same_day_ly, d_same_day_lq, d_current_day, d_current_week, d_current_month, d_current_quarter, d_current_year" \
    -T "doc_ddl_dir/date_dim_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/date_dim/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: ss_sold_date_sk, ss_sold_time_sk, ss_item_sk, ss_customer_sk, ss_cdemo_sk, ss_hdemo_sk, ss_addr_sk, ss_store_sk, ss_promo_sk, ss_ticket_number, ss_quantity, ss_wholesale_cost, ss_list_price, ss_sales_price, ss_ext_discount_amt, ss_ext_sales_price, ss_ext_wholesale_cost, ss_ext_list_price, ss_ext_tax, ss_coupon_amt, ss_net_paid, ss_net_paid_inc_tax, ss_net_profit" \
    -T "doc_ddl_dir/store_sales.csv" \
    http://127.0.0.1:8030/api/doc_tpcds/store_sales/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: ca_address_sk, ca_address_id, ca_street_number, ca_street_name, ca_street_type, ca_suite_number, ca_city, ca_county, ca_state, ca_zip, ca_country, ca_gmt_offset, ca_location_type" \
    -T "doc_ddl_dir/customer_address_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/customer_address/_stream_load
데이터 파일 item_1_10.dat, date_dim_1_10.dat, store_sales.csv, customer_address_1_10.dat는 이 아카이브에서도 다운로드할 수 있습니다.