집계 모델
Doris 집계 키 모델은 대규모 데이터 쿼리에서 집계 연산을 효율적으로 처리하도록 설계되었습니다. 데이터 적재 과정과 백그라운드 병합 단계에서 사전 집계를 수행하여 중복 계산을 줄이고 집계 결과만 저장하므로, 저장 공간을 절약하고 쿼리 속도를 높입니다.
적용 시나리오
집계 모델은 다음 두 가지 유형의 비즈니스 시나리오에 적합합니다.
- 상세 데이터 요약: 전자상거래 플랫폼의 월별 매출 실적, 금융 리스크 관리의 고객별 총 거래 금액, 광고 클릭 수 등의 다차원 요약 분석.
- 원시 상세 데이터에 의존하지 않는 쿼리: 경영 대시보드 보고서, 사용자 거래 행동 분석 등. 원시 상세 데이터는 데이터 레이크에 보관하고, 데이터 웨어하우스에는 요약 결과만 저장하면 됩니다.
작동 방식
집계 모델에서는 데이터를 적재할 때마다 새 버전이 생성됩니다. 버전은 백그라운드 Compaction 단계에서 병합되며, 쿼리 시점에 기본 키를 기준으로 데이터가 다시 집계됩니다. 전체 처리 흐름은 세 단계로 나뉩니다.
- 데이터 적재 단계: 데이터를 배치 단위로 적재합니다. 각 배치마다 버전이 생성되며, 집계 키가 같은 행에 대해 사전 집계(예: 합계 또는 개수 계산)를 수행합니다.
- 백그라운드 병합 단계(Compaction): 여러 버전 파일을 주기적으로 병합하여 중복을 줄이고 저장 공간을 최적화합니다.
- 쿼리 단계: 시스템이 집계 키를 기준으로 데이터를 최종 집계하여 정확한 쿼리 결과를 보장합니다.
테이블 생성 구문
AGGREGATE KEY 키워드로 집계 모델을 지정하고, Value 컬럼을 집계하는 데 사용할 Key 컬럼을 선언합니다.
CREATE TABLE IF NOT EXISTS example_tbl_agg
(
    user_id             LARGEINT    NOT NULL,
    load_date           DATE        NOT NULL,
    city                VARCHAR(20),
    last_visit_dt       DATETIME    REPLACE DEFAULT "1970-01-01 00:00:00",
    cost                BIGINT      SUM     DEFAULT "0",
    max_dwell           INT         MAX     DEFAULT "0"
)
AGGREGATE KEY(user_id, load_date, city)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
위 예제는 사용자 정보와 방문 행동을 저장하는 테이블을 정의하며, user_id, load_date, city를 집계용 Key 컬럼으로 사용합니다. 데이터를 적재할 때 Key 컬럼 값이 같은 행은 하나의 행으로 집계되며, Value 컬럼은 선언된 집계 유형에 따라 차원별로 집계됩니다.
지원되는 집계 방식
집계 테이블의 Value 컬럼은 다음 집계 방식을 지원합니다.
| 집계 방식 | 설명 |
|---|---|
| SUM | 값을 합산하며, 여러 행의 Value를 누적합니다. |
| REPLACE | 값을 대체하며, 다음 배치의 Value가 이전 행의 Value를 대체합니다. |
| MAX | 최댓값을 유지합니다. |
| MIN | 최솟값을 유지합니다. |
| REPLACE_IF_NOT_NULL | NULL이 아닌 값으로 대체합니다. REPLACE와 달리 null 값으로 대체하지 않습니다. |
| HLL_UNION | HLL 타입 컬럼에 사용하며, HyperLogLog 알고리즘으로 집계합니다. |
| BITMAP_UNION | BITMAP 타입 컬럼에 사용하며, 비트맵 합집합 집계를 수행합니다. |
위 집계 방식으로 비즈니스 요구 사항을 충족할 수 없다면 AGG_STATE 타입을 사용할 수 있습니다.
데이터 쓰기 및 집계 예제
집계 테이블의 데이터는 Key 컬럼을 기준으로 집계되며, 쓰기가 끝나면 집계가 완료됩니다.
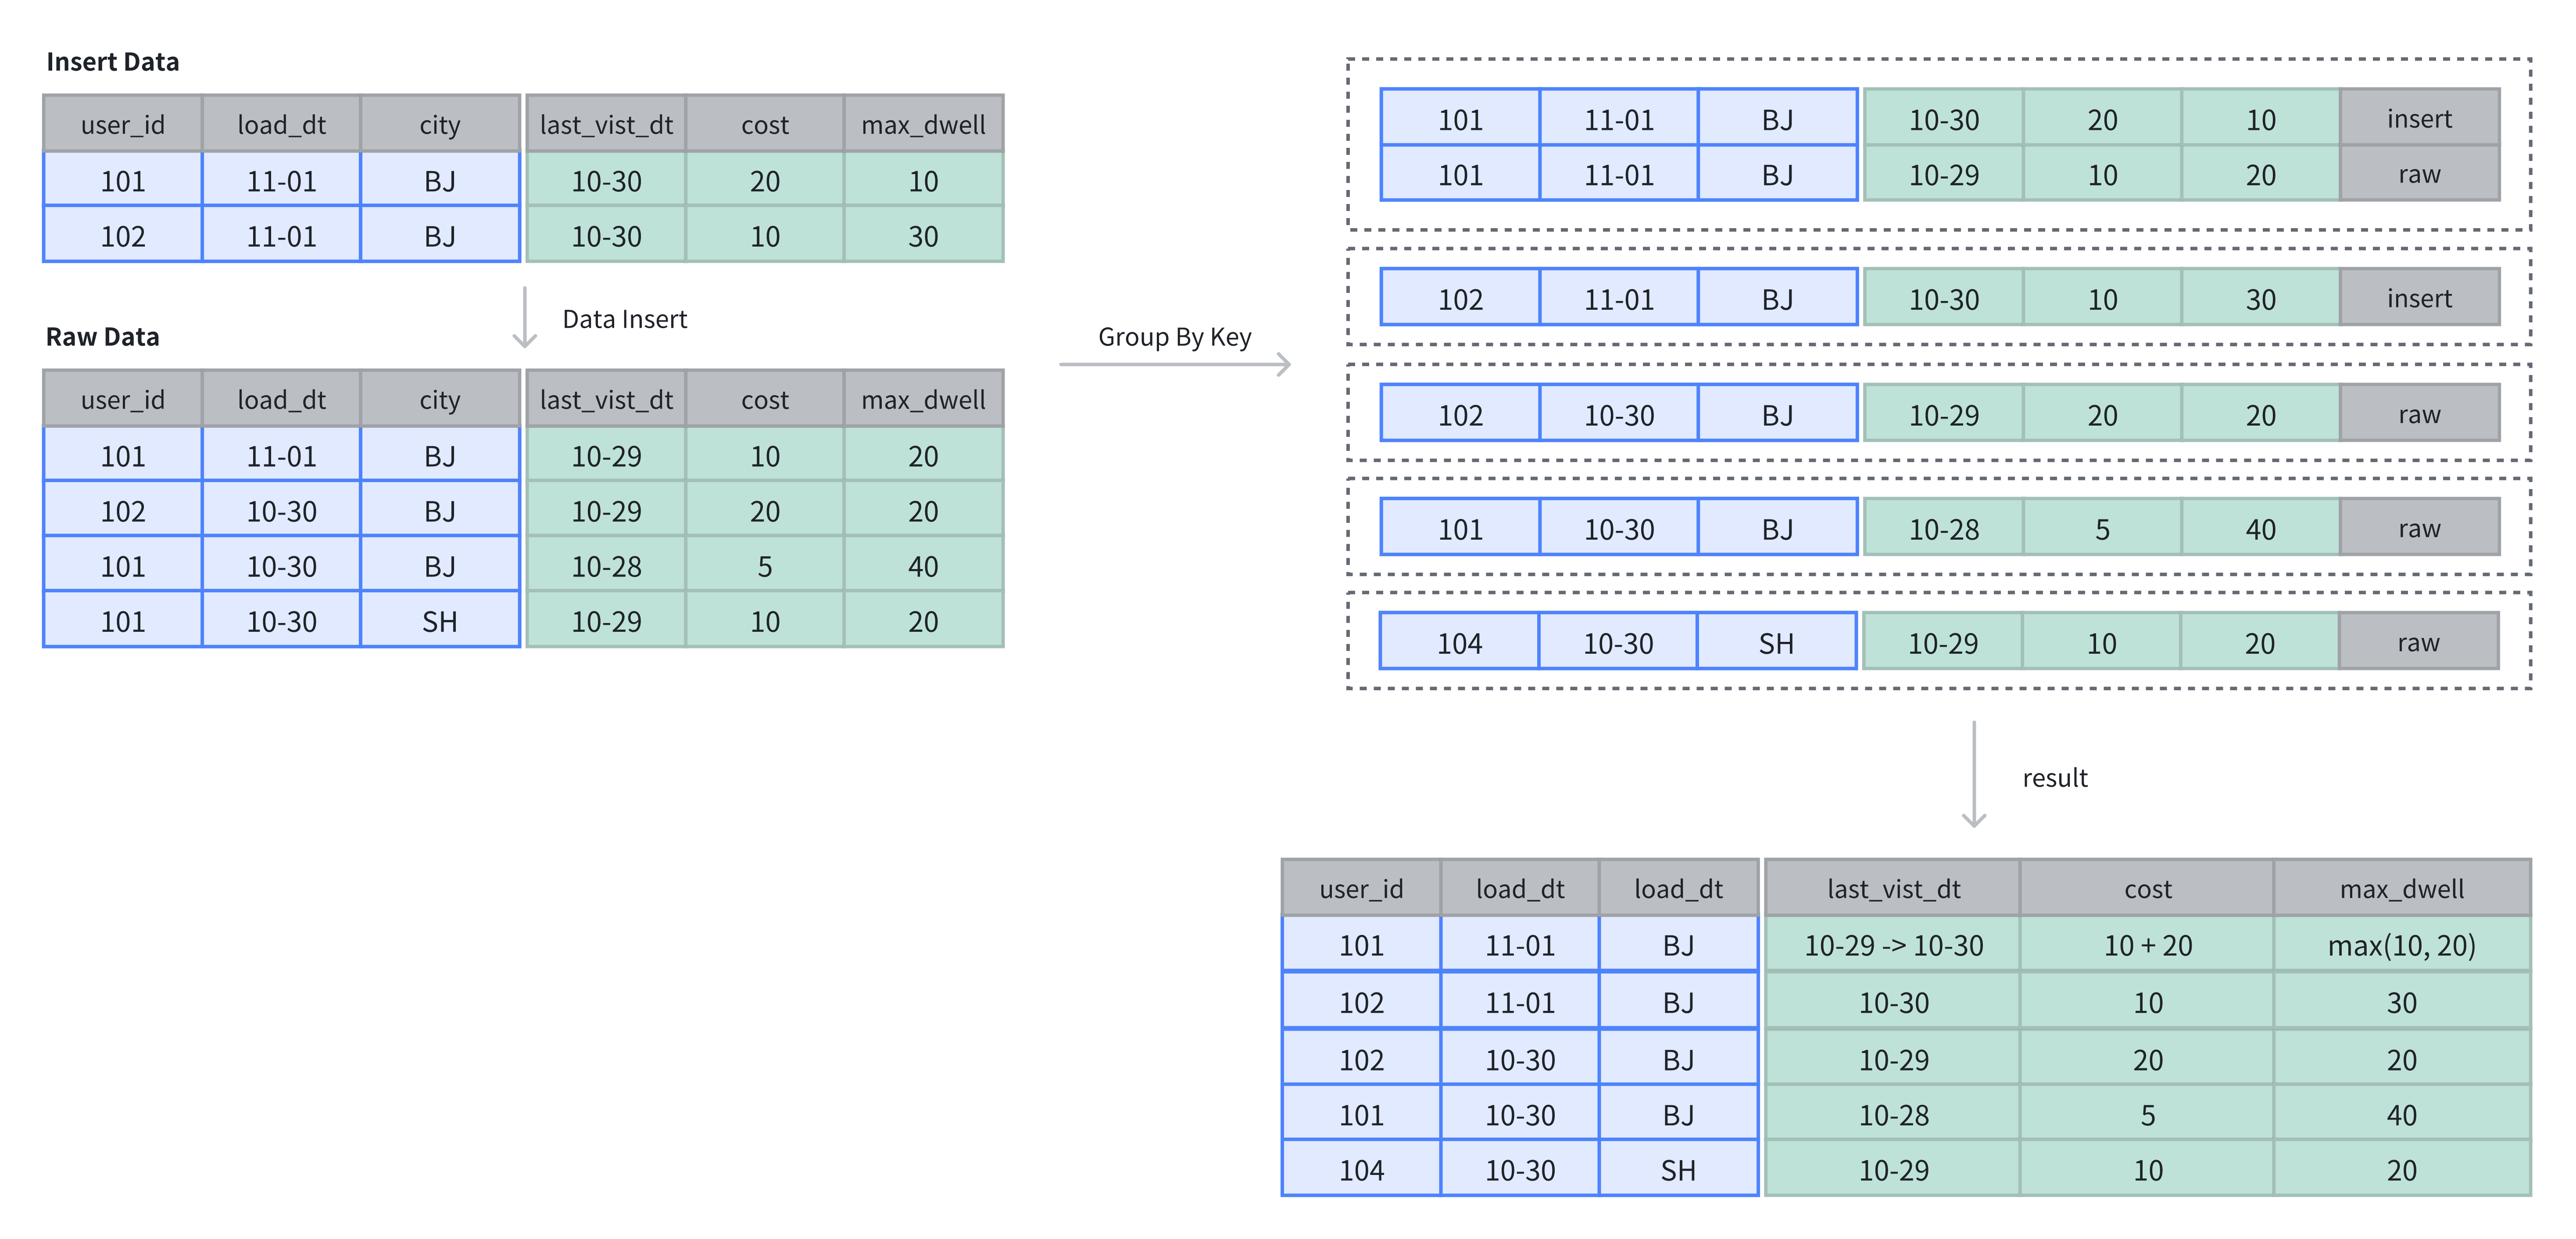
다음 예제에서 테이블에는 원래 4개의 행이 있습니다. 2개의 행을 추가로 삽입하면 Key 컬럼을 기준으로 Value 컬럼이 집계됩니다.
-- 4 rows raw data
INSERT INTO example_tbl_agg VALUES
(101, '2024-11-01', 'BJ', '2024-10-29', 10, 20),
(102, '2024-10-30', 'BJ', '2024-10-29', 20, 20),
(101, '2024-10-30', 'BJ', '2024-10-28',  5, 40),
(101, '2024-10-30', 'SH', '2024-10-29', 10, 20);

-- insert into 2 rows
INSERT INTO example_tbl_agg VALUES
(101, '2024-11-01', 'BJ', '2024-10-30', 20, 10),
(102, '2024-11-01', 'BJ', '2024-10-30', 10, 30);

-- check the rows of table
SELECT * FROM example_tbl_agg;
+---------+------------+------+---------------------+------+----------------+
| user_id | load_date  | city | last_visit_dt       | cost | max_dwell       |
+---------+------------+------+---------------------+------+----------------+
| 102     | 2024-10-30 | BJ   | 2024-10-29 00:00:00 |   20 |             20 |
| 102     | 2024-11-01 | BJ   | 2024-10-30 00:00:00 |   10 |             30 |
| 101     | 2024-10-30 | BJ   | 2024-10-28 00:00:00 |    5 |             40 |
| 101     | 2024-10-30 | SH   | 2024-10-29 00:00:00 |   10 |             20 |
| 101     | 2024-11-01 | BJ   | 2024-10-30 00:00:00 |   30 |             20 |
+---------+------------+------+---------------------+------+----------------+
AGG_STATE
AGG_STATE는 실험적 기능입니다. 개발 및 테스트 환경에서 사용하는 것을 권장합니다.
AGG_STATE는 기본 제공 집계 방식으로 요구 사항을 충족할 수 없는 시나리오에 적합합니다. 사용할 때는 다음 제약 사항에 유의하세요.
- Key 컬럼으로 사용할 수 없습니다.
- 테이블 생성 시 집계 함수 시그니처를 선언해야 합니다.
- 길이나 기본값을 지정할 필요가 없으며, 실제 저장 크기는 함수 구현에 따라 달라집니다.
테이블 생성 예제
set enable_agg_state = true;

CREATE TABLE aggstate
(
    k1   INT  NULL,
    v1   INT  SUM,
    v2   agg_state<group_concat(string)> generic
)
AGGREGATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 3;
위 예제에서 agg_state는 데이터 타입을 선언하는 데 사용하며, sum / group_concat은 집계 함수 시그니처입니다. agg_state는 데이터 타입(int, array, string과 유사)이며, 세 가지 함수 조합자 state, merge, union과 함께만 사용할 수 있습니다. 이 타입은 집계 함수의 중간 결과(예: group_concat의 중간 상태)를 나타내며, 최종 결과를 나타내지는 않습니다.
쓰기: state로 중간 결과 생성
agg_state 타입의 데이터는 반드시 state 함수를 사용하여 생성해야 합니다. 이 테이블에서는 group_concat_state를 사용합니다.
INSERT INTO aggstate VALUES (1, 1, group_concat_state('a'));
INSERT INTO aggstate VALUES (1, 2, group_concat_state('b'));
INSERT INTO aggstate VALUES (1, 3, group_concat_state('c'));
INSERT INTO aggstate VALUES (2, 4, group_concat_state('d'));
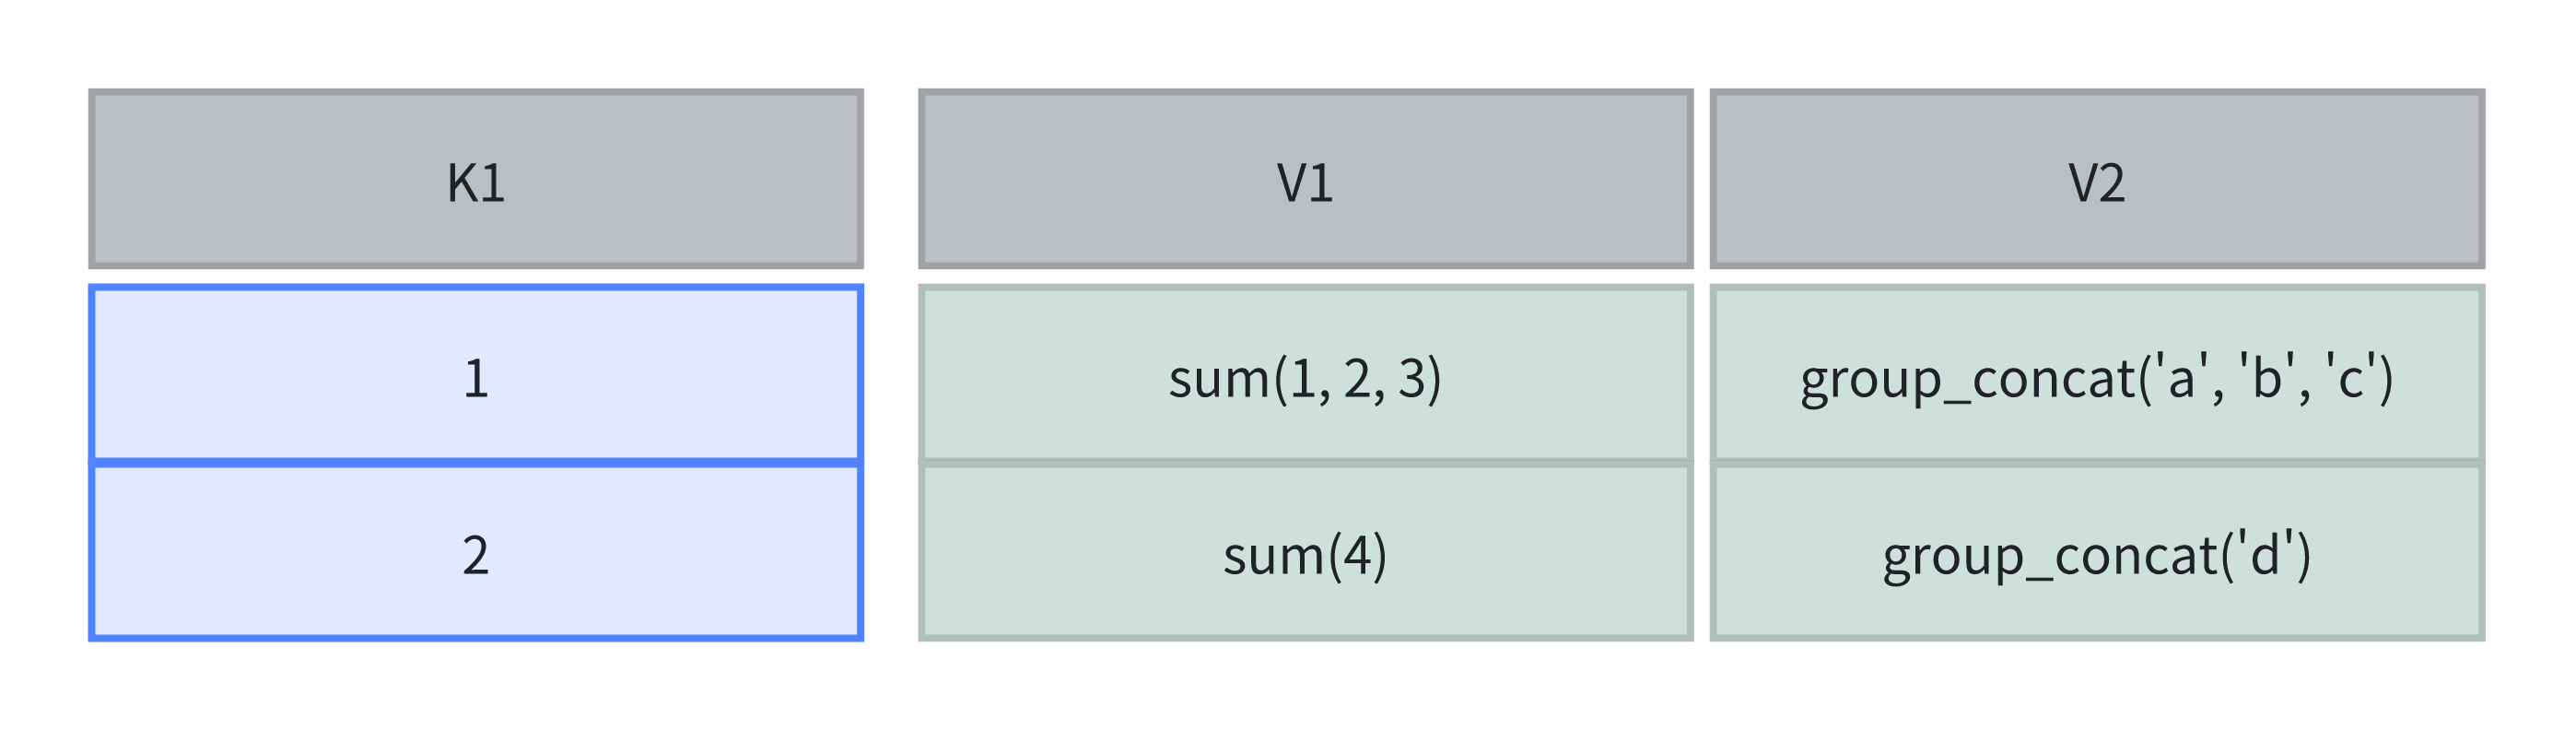
이 시점에 테이블에서 이루어지는 계산은 다음 그림과 같습니다.
쿼리: merge로 최종 결과 반환
쿼리 시점에 merge 연산을 사용하여 여러 상태를 결합하고 최종 집계 결과를 반환할 수 있습니다. group_concat은 순서에 민감하므로 결과가 일정하지 않습니다.
SELECT group_concat_merge(v2) FROM aggstate;
+------------------------+
| group_concat_merge(v2) |
+------------------------+
| d,c,b,a                |
+------------------------+
중간 결과 유지: union 연산 사용
최종 집계 결과가 필요하지 않고 중간 결과를 유지하려면 union 연산을 사용합니다.
INSERT INTO aggstate
SELECT 3, sum(v1), group_concat_union(v2) FROM aggstate;
이 시점에 테이블에서 이루어지는 계산은 다음 그림과 같습니다.
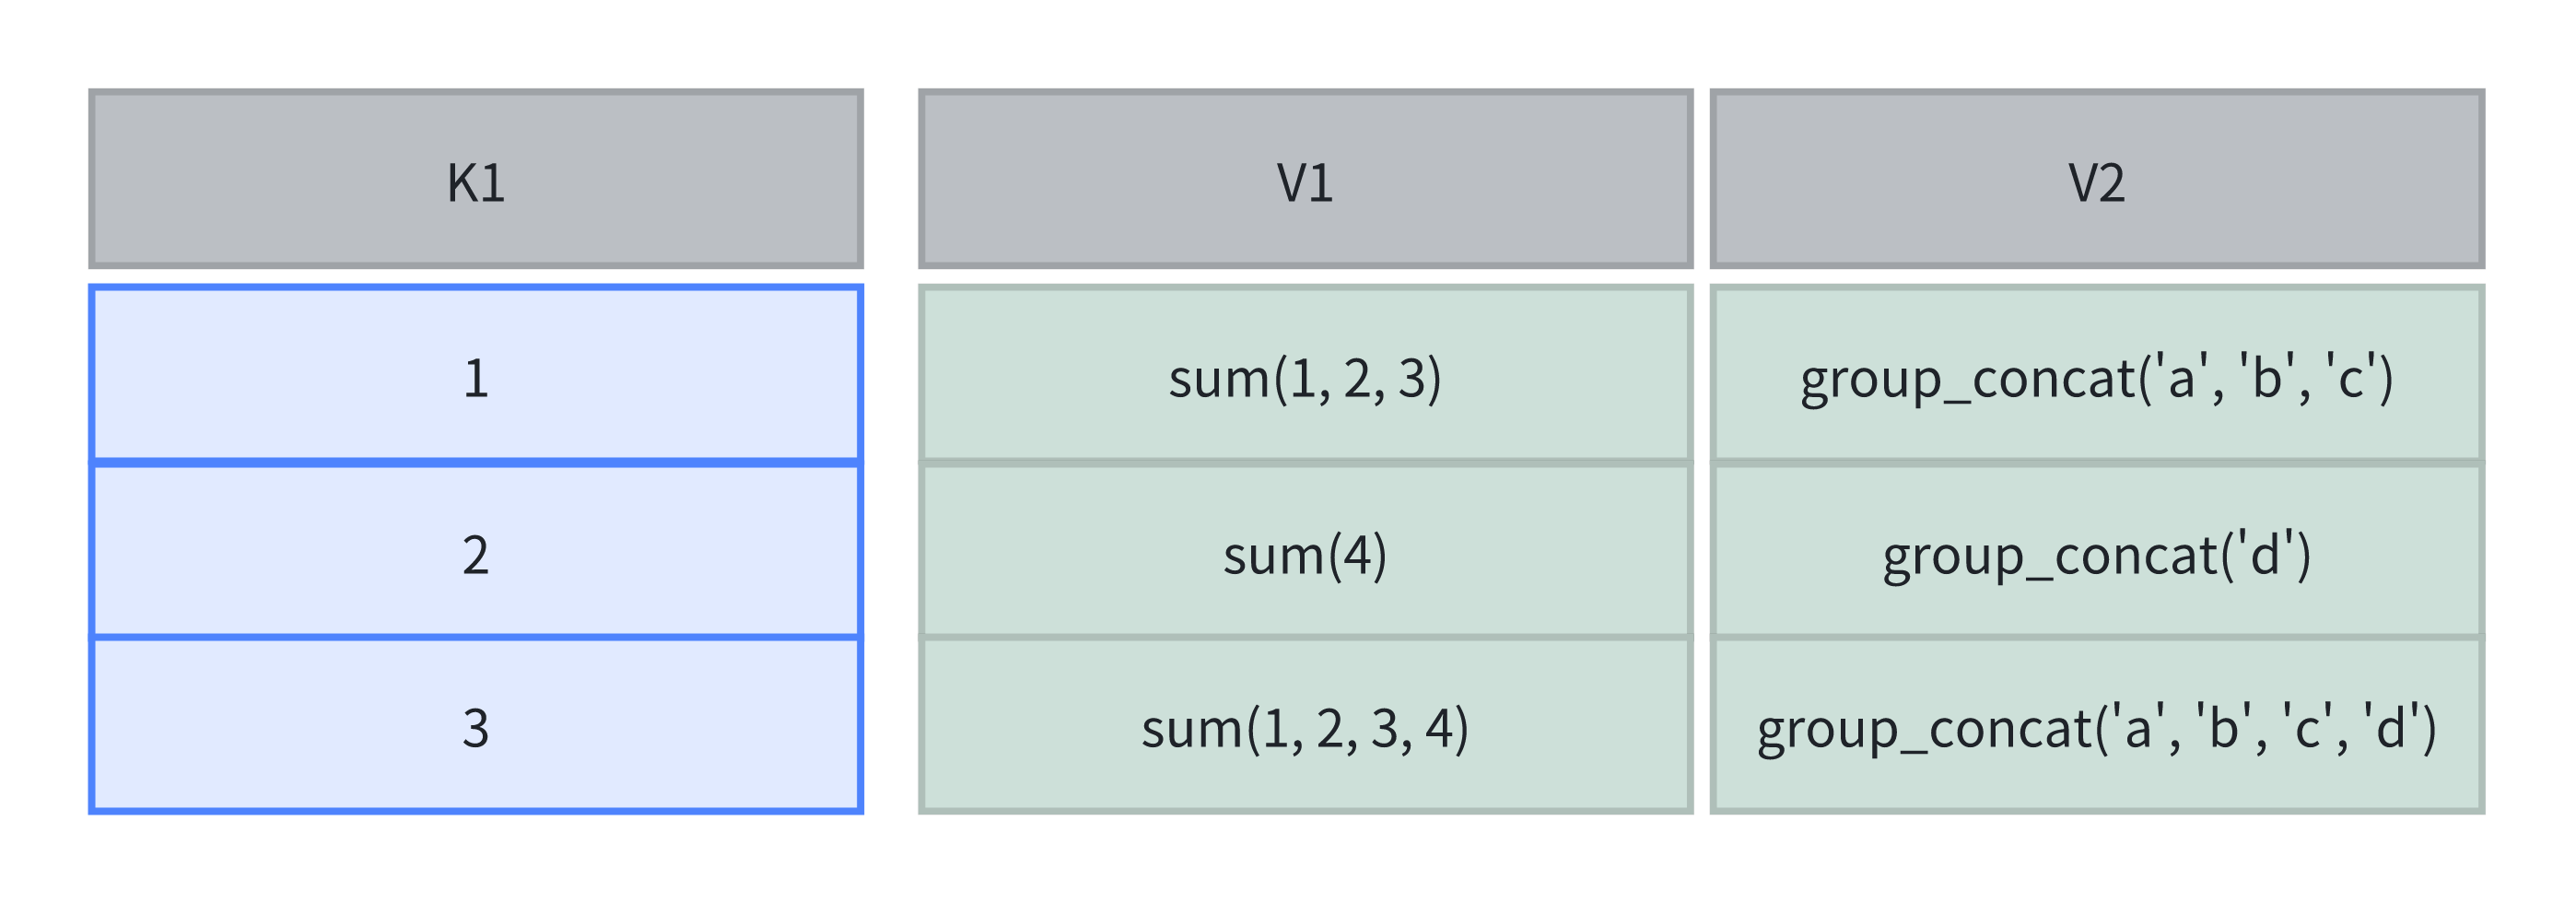
group_concat은 순서에 민감하므로 결과가 일정하지 않습니다. 쿼리 결과는 다음과 같습니다.
mysql> SELECT sum(v1), group_concat_merge(v2) FROM aggstate;
+---------+------------------------+
| sum(v1) | group_concat_merge(v2) |
+---------+------------------------+
|      20 | c,b,a,d,c,b,a,d        |
+---------+------------------------+

mysql> SELECT sum(v1), group_concat_merge(v2) FROM aggstate WHERE k1 != 2;
+---------+------------------------+
| sum(v1) | group_concat_merge(v2) |
+---------+------------------------+
|      16 | c,b,a,d,c,b,a          |
+---------+------------------------+