인덱스 개요
Apache Doris는 여러 유형의 인덱스로 쿼리 속도를 높입니다. 이 페이지에서는 인덱스 추가가 필요한지, 어떤 인덱스를 선택해야 하는지 판단할 수 있도록 안내하고 각 인덱스의 상세 문서 링크를 제공합니다.
시작하기
모든 테이블에는 Doris가 자동으로 생성하고 유지 관리하는 두 가지 인덱스가 기본으로 제공됩니다.
- 정렬 키에 생성되는 **접두사 인덱스**는 선두 Key 컬럼에 대한 필터링 속도를 높입니다. 이 인덱스를 활용하려면 가장 자주 필터링하는 컬럼을 선두 Key 컬럼으로 지정하세요.
- 모든 컬럼에 생성되는 ZoneMap 인덱스는 범위 필터나 동등 조건 필터에 해당하지 않는 데이터 블록을 건너뜁니다.
이 두 인덱스로 쿼리 패턴을 처리하기 어려울 때만 인덱스를 수동으로 추가하세요.
| 쿼리 패턴 | 권장 인덱스 | 필요한 경우 |
|---|---|---|
| 가장 자주 사용하는 컬럼으로 필터링 | 해당 컬럼을 선두 Key 컬럼으로 지정(접두사 인덱스) | 항상 가장 먼저 설계 |
| Key가 아닌 컬럼에 대한 동등 조건 또는 범위 필터 | 역색인 | 자주 필요 |
텍스트에 대한 LIKE 부분 문자열 매칭 | NGram BloomFilter 인덱스 | 경우에 따라 필요 |
| 유연성보다 인덱스 크기가 중요한 동등 조건 필터 | BloomFilter 인덱스 | 드물게 필요하며, 일반적으로 역색인을 권장 |
| 전문 검색: 키워드, 구문 또는 여러 필드 검색 | 역색인 | 텍스트를 검색할 때 |
| 벡터 유사도(Top-K 최근접 이웃) | 벡터 인덱스(ANN) | RAG, 의미 검색, 추천 및 미디어 검색에 사용 |
쿼리가 예상보다 느리다면 QueryProfile에서 각 인덱스가 데이터를 얼마나 걸러냈는지, 시간이 얼마나 걸렸는지 확인하세요. 자세한 내용은 각 인덱스의 문서를 참고하세요.
각 인덱스의 동작 방식
Apache Doris는 다양한 쿼리 시나리오에 맞춰 포인트 쿼리 인덱스, 건너뛰기 인덱스, 전문 검색 인덱스, 벡터 인덱스의 네 가지 범주를 제공합니다.
시나리오 1: 조건에 일치하는 행이 적은 경우(포인트 쿼리 인덱스)
적용 시나리오: 기본 키로 조회하거나 사용자 ID로 상세 레코드를 가져오는 등 소량의 데이터를 정확하게 찾는 경우에 적합합니다.
가속 원리: WHERE 조건을 만족하는 행의 위치를 인덱스로 직접 찾아 해당 행만 읽으므로, 행을 하나씩 스캔할 필요가 없습니다.
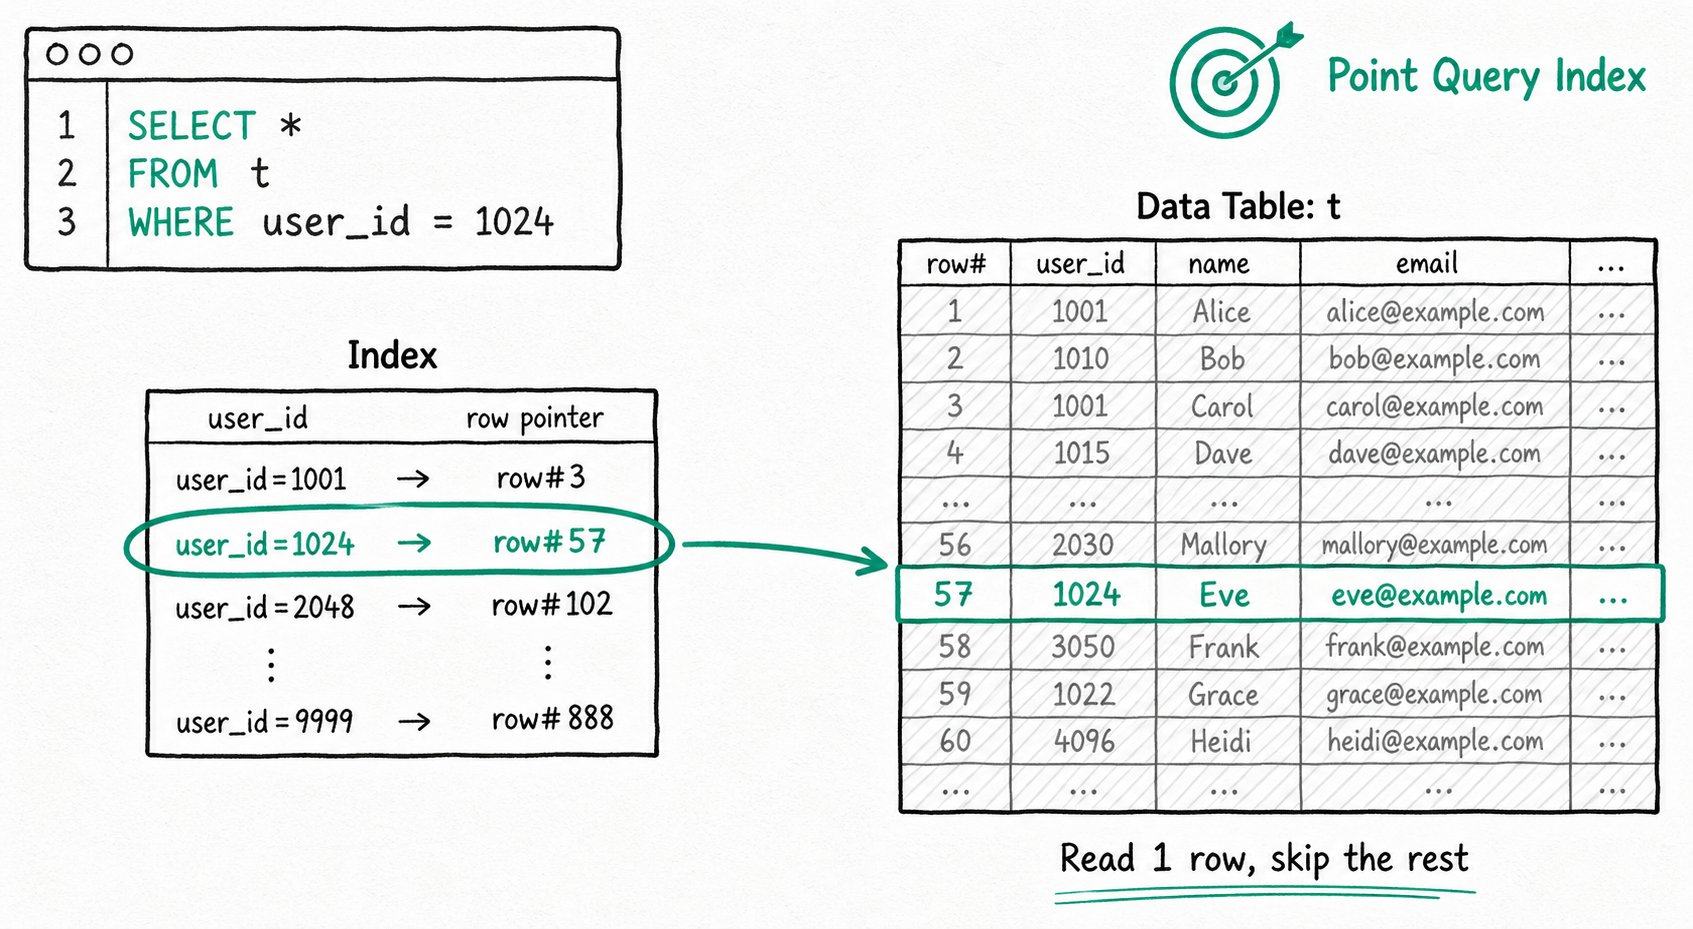
Apache Doris는 두 가지 포인트 쿼리 인덱스를 제공합니다.
- 접두사 인덱스: Doris는 데이터를 정렬 키 순서로 저장하고 1024행마다 희소 접두사 인덱스를 생성합니다. 각 인덱스 항목에는 해당 그룹의 첫 번째 행에 있는 정렬 컬럼 값이 저장됩니다. 쿼리에서 정렬 컬럼으로 필터링하면 Doris는 해당 그룹으로 바로 이동하여 그 지점부터 스캔합니다.
- 역색인: Doris는 각 값을 그 값이 포함된 행에 매핑하는 역색인 테이블을 생성합니다. 동등 조건 쿼리에서는 일치하는 행을 찾아 해당 행만 읽으므로 전체 스캔을 피하고 I/O를 줄일 수 있습니다. 역색인은 범위 필터와 텍스트 키워드 검색의 속도도 높입니다. 이 경우 알고리즘은 더 복잡하지만 기본 원리는 같습니다.
BITMAP 인덱스는 역색인으로 대체되었습니다.
시나리오 2: 조건에 일치하는 행이 많은 경우(건너뛰기 인덱스)
적용 시나리오: 시간 범위 집계나 차원 필터링처럼 대량의 데이터를 필터링해야 하는 분석 쿼리에 적합합니다.
가속 원리: 인덱스로 WHERE 조건을 만족하지 않는 데이터 블록을 식별하여 건너뛰고, 조건을 만족할 가능성이 있는 블록만 읽습니다. 그런 다음 행별로 필터링하여 최종 결과를 얻습니다.
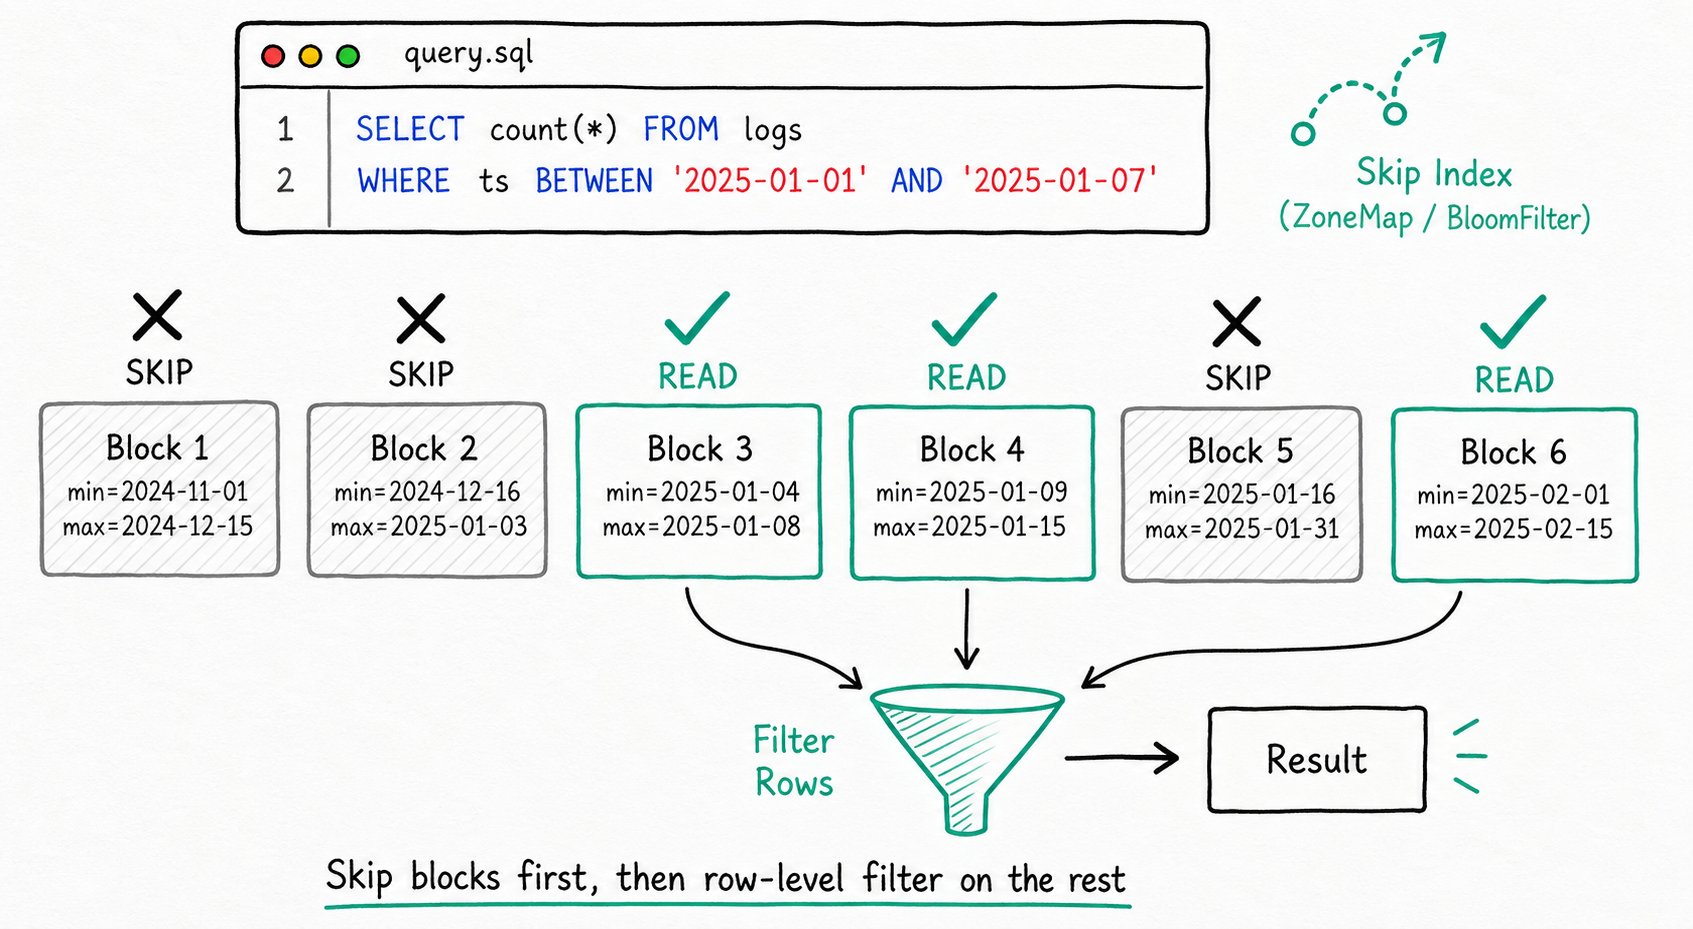
Apache Doris는 세 가지 건너뛰기 인덱스를 제공합니다.
- ZoneMap 인덱스: Doris는 각 데이터 파일(Segment)과 데이터 블록(Page)에 대해 컬럼별 통계(min, max, NULL 존재 여부)를 자동으로 유지 관리합니다. 동등 조건, 범위 및 IS NULL 필터에서는 이 통계를 사용하여 파일이나 블록에 일치하는 행이 있을 수 있는지 판단합니다. 일치하는 행이 있을 수 없다면 해당 파일이나 블록을 건너뛰어 I/O를 줄입니다.
- BloomFilter 인덱스: Doris는 매우 적은 저장 공간으로 값의 존재 여부를 확인할 수 있는 구조인 BloomFilter에 컬럼 값을 저장합니다. 동등 조건 쿼리에서 해당 값이 필터에 없으면 해당 파일이나 블록을 건너뛰어 I/O를 줄입니다.
- NGram BloomFilter 인덱스: 텍스트
LIKE쿼리의 속도를 높입니다. BloomFilter 인덱스와 같은 방식으로 동작하지만, 전체 값 대신 텍스트의 NGram 토큰을 저장합니다.LIKE쿼리를 실행할 때 Doris는 패턴을 같은 방식으로 토큰화하고 각 토큰이 필터에 있는지 확인합니다. 토큰이 하나라도 없으면 해당 파일이나 블록은 조건에 일치할 수 없으므로 건너뜁니다.
시나리오 3: 텍스트 전문 검색(역색인)
적용 시나리오: 로그 분석, 콘텐츠 검색, 지원 티켓 분석 등 텍스트 필드에서 키워드, 구문 또는 패턴 매칭으로 데이터를 찾아야 하는 경우에 적합합니다.
가속 원리: 토크나이저가 텍스트를 검색어 단위로 분리하고, 각 검색어를 해당 행 번호에 매핑하는 역색인 테이블을 생성합니다. 쿼리 시에는 검색할 텍스트를 같은 방식으로 토큰화하고, 각 검색어가 포함된 행 번호 집합을 역색인 테이블에서 가져와 AND/OR/NOT 관계에 따라 결합한 다음 일치하는 행을 직접 읽습니다. 따라서 원본 텍스트를 행별로 스캔하고 정규 표현식으로 매칭할 필요가 없습니다.
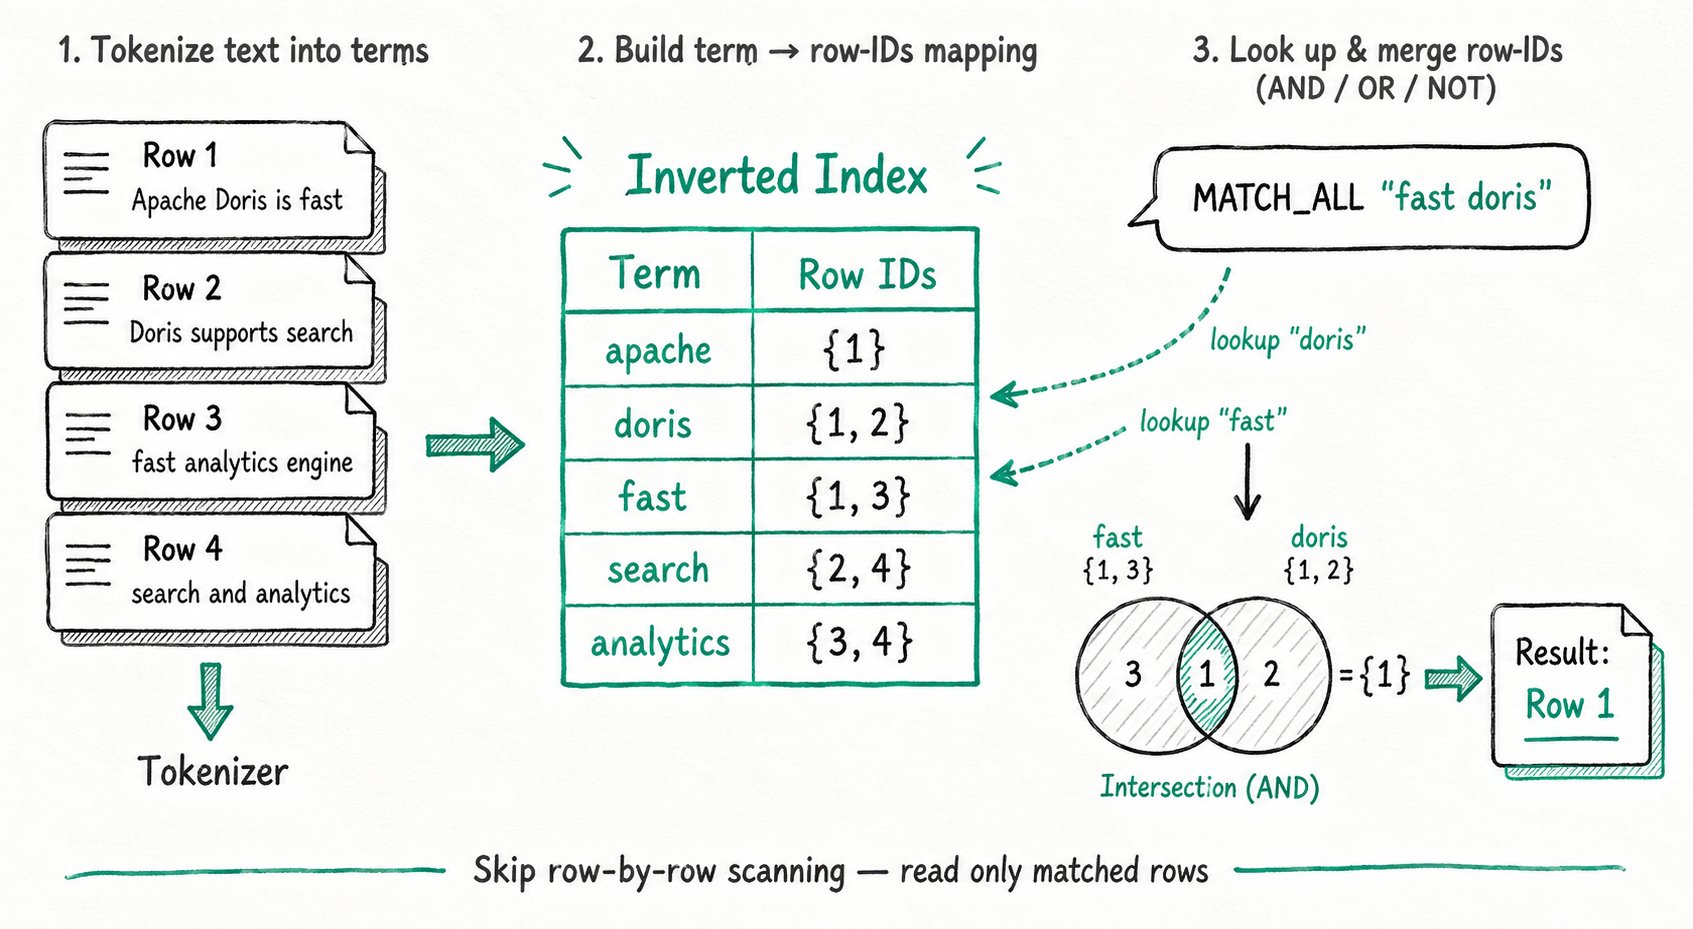
자세한 사용 방법은 역색인을 참고하세요. Apache Doris 역색인은 다음 기능을 지원합니다.
- 키워드 검색:
MATCH_ANY(단어 중 하나라도 일치)와MATCH_ALL(모든 단어가 일치)을 지원합니다. - 구문 쿼리:
MATCH_PHRASE는 단어 간 허용 거리인slop을 설정할 수 있으며, 순서를 구분하는 구문 매칭을 지원합니다.MATCH_PHRASE_PREFIX는 구문 매칭과 마지막 단어의 접두사 매칭을 함께 지원합니다.MATCH_REGEXP는 토큰화된 검색어에 대한 정규 표현식 매칭을 지원합니다. - 다국어 토큰화:
english,chinese,unicode,icu,basic,ik등의 내장 토크나이저로 중국어, 영어, 혼합 텍스트 및 다국어 시나리오를 지원합니다. - 여러 컬럼을 결합한 검색:
multi_match함수를 사용하여 여러 필드에 걸쳐 OR/AND/구문/접두사 검색을 수행합니다. - 일반 필터와의 결합: 동등 조건, 범위,
IN등의 조건 및 다른 인덱스와 AND/OR/NOT으로 자유롭게 결합할 수 있으며, 동일한 역색인을 재사용하여 쿼리를 처리합니다.
시나리오 4: 벡터 유사도 검색(벡터 인덱스)
적용 시나리오: 벡터 유사도로 Top-K 최근접 이웃을 찾거나 거리 임계값으로 필터링해야 하는 RAG(검색 증강 생성), 의미 검색, 추천 시스템, 이미지/오디오/비디오 검색에 적합합니다.
가속 원리: 기존 방식은 쿼리 벡터와 모든 레코드 간의 거리를 계산하므로 데이터 양에 비례하여 비용이 증가합니다. 벡터 인덱스(ANN, Approximate Nearest Neighbor)는 벡터 집합에 그래프(HNSW 등) 또는 클러스터링(IVF 등) 구조를 미리 구축하여 검색 공간을 소수의 후보 벡터로 제한합니다. 제어 가능한 수준의 정확도 손실을 감수하는 대신 열 배 수준의 속도 향상을 얻습니다.
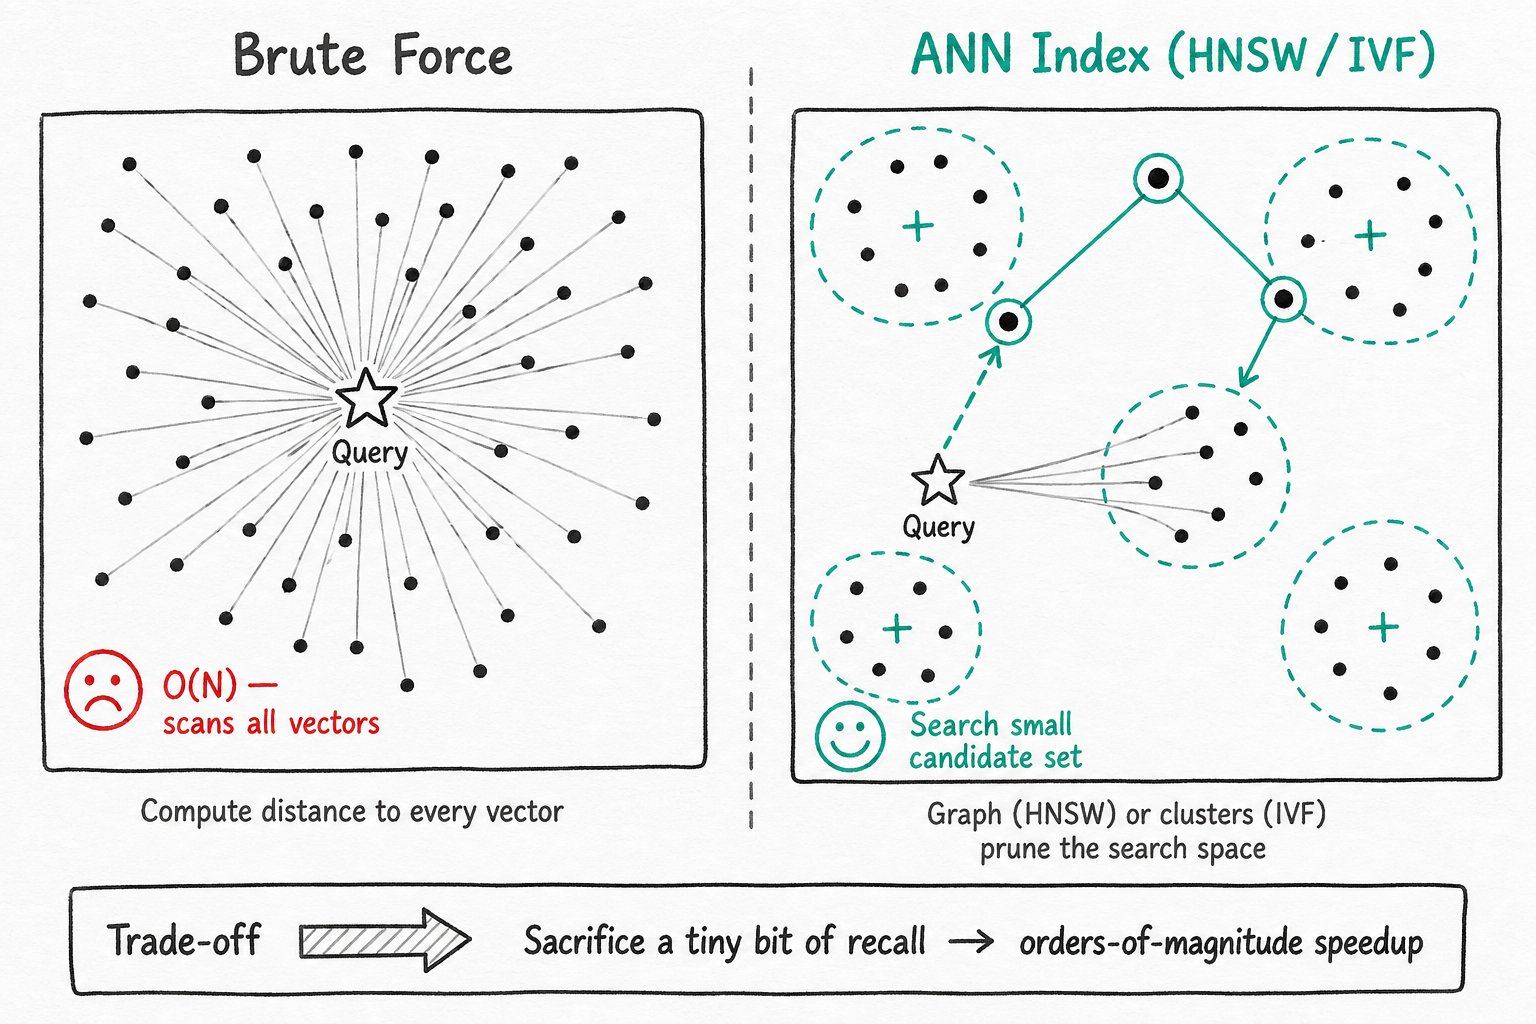
자세한 사용 방법은 벡터 인덱스를 참고하세요. Apache Doris는 버전 4.0부터 ANN 인덱스를 지원합니다. 주요 기능은 다음과 같습니다.
- 다양한 인덱스 알고리즘:
hnsw,ivf,ivf_on_disk를 지원하며, 각각 메모리 내 처리로 높은 QPS가 필요한 시나리오, 메모리가 제한된 시나리오, 초대규모 디스크 기반 시나리오에 적합합니다. - 다양한 거리 척도:
l2_distance(유클리드 거리)와inner_product(내적)를 지원합니다. 벡터에 L2 정규화를 적용하면 Cosine 유사도와 동등한 계산을 구현할 수 있습니다. - TopN / 범위 / 결합 쿼리:
l2_distance_approximate와inner_product_approximate로 ANN TopN을 구현할 수 있습니다. 거리 임계값에 기반한 범위 검색도 지원하며, 동일한 SQL 문에서 TopN과 Range 조건을 결합할 수 있습니다. - 스칼라 필터를 활용한 하이브리드 검색: 역색인 등의 보조 인덱스와 함께 동작합니다. 구조화된 조건(예:
MATCH_ANY 'music')으로 후보 집합을 먼저 필터링한 다음 해당 후보 집합에서 ANN TopN을 실행하여, 필터 조건이 적용된 벡터 검색을 수행할 수 있습니다. - 벡터 양자화:
flat,sq8,sq4,pq등의 양자화 방식을 지원하여 재현율과 메모리 및 디스크 사용량 간의 균형을 유연하게 조정할 수 있습니다.
인덱스 관리 방식
Apache Doris 인덱스는 사용자의 수동 관리가 필요한지에 따라 두 가지로 나뉩니다.
| 관리 방식 | 인덱스 유형 | 설명 |
|---|---|---|
| 자동 유지 관리 | 접두사 인덱스, ZoneMap 인덱스 | Apache Doris에 내장된 스마트 인덱스로, 사용자가 관리할 필요가 없음 |
| 수동 생성 | 역색인, BloomFilter 인덱스, NGram BloomFilter 인덱스, 벡터 인덱스 | 사용자가 쿼리 시나리오에 맞춰 선택하고 직접 생성하거나 삭제 |
인덱스 특성 비교
다음 표는 인덱스를 빠르게 선택할 수 있도록 각 유형의 장점과 제약 사항을 정리한 것입니다.
| 범주 | 인덱스 | 장점 | 제약 사항 |
|---|---|---|---|
| 포인트 쿼리 인덱스 | 접두사 인덱스 | 성능이 가장 뛰어난 내장 인덱스 | 테이블당 접두사 인덱스 집합을 하나만 구성할 수 있음 |
| 포인트 쿼리 / 전문 검색 | 역색인 | 토큰화와 키워드 매칭을 지원하고, 모든 컬럼에 생성할 수 있으며, 여러 조건의 결합을 지원하고 함수 수준의 가속 지원이 지속적으로 확대됨 | 인덱스 저장 공간이 원본 데이터와 비슷할 정도로 큼 |
| 건너뛰기 인덱스 | ZoneMap 인덱스 | 저장 공간을 적게 차지하는 내장 인덱스 | 지원하는 쿼리 유형이 적으며, 동등 조건과 범위만 지원 |
| 건너뛰기 인덱스 | BloomFilter 인덱스 | ZoneMap보다 세밀하며, 저장 공간 사용량이 적당함 | 지원하는 쿼리 유형이 적으며, 동등 조건만 지원 |
| 건너뛰기 인덱스 | NGram BloomFilter 인덱스 | LIKE 쿼리를 가속하며, 저장 공간 사용량이 적당함 | 지원하는 쿼리 유형이 적으며, LIKE 가속만 지원 |
| 벡터 인덱스 | ANN 인덱스 | 벡터 유사도 TopN / 범위 / 결합 검색을 지원하고 스칼라 필터와 연계할 수 있음. 다양한 양자화 방식으로 재현율과 리소스 사용량 간의 균형을 조정할 수 있음 | NOT NULL인 Array<Float> 컬럼에만 적용 가능. DUPLICATE KEY 테이블 모델과 merge-on-write가 활성화된 UNIQUE KEY 테이블 모델을 지원(버전 4.1.4부터 지원) |
연산자 및 함수에 대한 인덱스 지원
다음 표는 일반적인 연산자와 함수에 대한 각 인덱스 유형의 가속 지원 여부를 보여줍니다.
| 연산자 / 함수 | 접두사 인덱스 | 역색인 | ZoneMap 인덱스 | BloomFilter 인덱스 | NGram BloomFilter 인덱스 |
|---|---|---|---|---|---|
= | 지원 | 지원 | 지원 | 지원 | 미지원 |
!= | 지원 | 지원 | 미지원 | 미지원 | 미지원 |
IN | 지원 | 지원 | 지원 | 지원 | 미지원 |
NOT IN | 지원 | 지원 | 미지원 | 미지원 | 미지원 |
>, >=, <, <=, BETWEEN | 지원 | 지원 | 지원 | 미지원 | 미지원 |
IS NULL | 지원 | 지원 | 지원 | 미지원 | 미지원 |
IS NOT NULL | 지원 | 지원 | 미지원 | 미지원 | 미지원 |
LIKE | 미지원 | 미지원 | 미지원 | 미지원 | 지원 |
MATCH, MATCH_* | 미지원 | 지원 | 미지원 | 미지원 | 미지원 |
array_contains | 미지원 | 지원 | 미지원 | 미지원 | 미지원 |
array_overlaps | 미지원 | 지원 | 미지원 | 미지원 | 미지원 |
is_ip_address_in_range | 미지원 | 지원 | 미지원 | 미지원 | 미지원 |
인덱스 설계 원칙
데이터베이스 테이블의 인덱스 설계와 튜닝은 데이터 특성 및 쿼리 패턴과 밀접하게 연관되어 있으므로, 실제 시나리오에 맞춰 테스트하고 조정해야 합니다. 모든 상황에 통하는 해결책은 없지만, Apache Doris는 인덱스 사용의 어려움을 계속 줄여 나가고 있습니다. 인덱스를 설계할 때는 시작하기의 선택 기준표를 참고하여 인덱스를 선택하고 테스트하세요.