높은 동시성 데이터 적재 최적화(Group Commit)
소규모 배치 쓰기가 빈번하게 발생하는 환경에서 기존 데이터 적재 방식에는 다음과 같은 문제가 있습니다.
- 데이터 적재마다 독립적인 트랜잭션을 생성하고, 매번 FE에서 SQL 파싱과 실행 계획 생성을 거쳐야 하므로 전체 성능이 저하됩니다.
- 데이터 적재마다 새 버전이 생성되므로 버전 수가 빠르게 늘어나고 백그라운드 Compaction의 부하가 증가합니다.
이러한 문제를 해결하기 위해 Doris는 Group Commit 메커니즘을 도입했습니다. Group Commit은 기존 데이터 적재 방식을 확장하여 최적화하는 기능이며, 주로 다음을 대상으로 합니다.
INSERT INTO tbl VALUES(...)문- Stream Load
Group Commit은 백그라운드에서 여러 소규모 배치 데이터 적재를 하나의 대규모 트랜잭션으로 병합하여 커밋함으로써, 동시성이 높은 소규모 배치 쓰기의 성능을 크게 개선합니다. Group Commit을 PreparedStatement와 함께 사용하면 성능을 더욱 높일 수 있습니다.
적용 시나리오 및 선택 기준
| 시나리오 | 권장 모드 | 설명 |
|---|---|---|
| 데이터를 즉시 조회할 수 있어야 하는 높은 동시성 쓰기 | sync_mode | 여러 데이터 적재를 하나의 트랜잭션으로 병합하고 커밋 후 호출을 반환합니다. |
| 지연 시간에 민감한 고빈도 쓰기 | async_mode | 먼저 데이터를 WAL에 기록한 뒤 호출을 즉시 반환하며, 커밋은 백그라운드에서 비동기적으로 수행합니다. |
| Group Commit이 필요하지 않은 경우 | off_mode | Group Commit을 비활성화하고 일반 데이터 적재 경로를 사용합니다. |
Group Commit 모드
Group Commit 쓰기에는 세 가지 모드가 있습니다.
-
비활성화 모드(
off_mode)Group Commit을 비활성화합니다.
-
동기 모드(
sync_mode)Doris는 부하와 테이블의
group_commit_interval속성에 따라 여러 데이터 적재를 하나의 트랜잭션으로 병합하여 커밋하고, 트랜잭션이 커밋된 후 각 데이터 적재 호출을 반환합니다. 이 모드는 데이터 적재가 완료되는 즉시 데이터를 조회할 수 있어야 하는 높은 동시성 쓰기 환경에 적합합니다. -
비동기 모드(
async_mode)Doris는 먼저 데이터를 WAL(
Write Ahead Log)에 기록하고 데이터 적재 호출을 즉시 반환합니다. 이후 부하와 테이블의group_commit_interval속성에 따라 데이터를 비동기적으로 커밋하며, 커밋 후 데이터를 조회할 수 있습니다. WAL이 디스크 공간을 과도하게 차지하지 않도록 단일 데이터 적재의 데이터 양이 많으면 Doris가 자동으로sync_mode로 전환합니다. 이 모드는 지연 시간에 민감하고 쓰기가 빈번한 환경에 적합합니다.FE HTTP 인터페이스를 통해 WAL 파일 수를 확인할 수 있습니다. 자세한 내용은 여기를 참조하세요. BE 메트릭에서
wal키워드를 검색할 수도 있습니다.
빠른 시작
아래 예제는 모두 다음 테이블 스키마를 사용합니다.
CREATE TABLE `dt` (
    `id` int(11) NOT NULL,
    `name` varchar(50) NULL,
    `score` int(11) NULL
) ENGINE=OLAP
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);
테이블 속성 설정
group_commit_mode 테이블 속성은 4.1.0 버전부터 지원됩니다.
테이블 수준에서 기본 Group Commit 모드를 설정할 수 있습니다. Stream Load에서 group_commit HTTP 헤더를 설정하지 않으면 테이블 속성에 지정된 모드를 사용합니다.
1. 테이블 생성 시 설정:
CREATE TABLE `dt` (
    `id` int(11) NOT NULL,
    `name` varchar(50) NULL,
    `score` int(11) NULL
) ENGINE=OLAP
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "group_commit_mode" = "async_mode"
);
2. 테이블 속성 변경:
# Change to sync mode
ALTER TABLE dt SET ("group_commit_mode" = "sync_mode");

# Disable Group Commit
ALTER TABLE dt SET ("group_commit_mode" = "off_mode");
3. 테이블 속성 확인:
SHOW CREATE TABLE은 group_commit_mode 속성을 표시합니다(값이 off_mode인 경우 제외).
mysql> SHOW CREATE TABLE dt;
+-------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| Table | Create Table                                                                                                                                                                                                       |
+-------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| dt    | CREATE TABLE `dt` (
  `id` int(11) NOT NULL,
  `name` varchar(50) NULL,
  `score` int(11) NULL
) ENGINE=OLAP
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "group_commit_mode" = "async_mode"
) |
+-------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
1 row in set (0.00 sec)
4. 우선순위:
| 데이터 적재 방식 | 우선순위(높은 순) |
|---|---|
| Stream Load | group_commit HTTP 헤더 > 테이블 속성 group_commit_mode |
| INSERT INTO VALUES | 세션 변수 group_commit > 테이블 속성 group_commit_mode |
사용 방법
INSERT INTO VALUES
세션 변수 group_commit을 설정하여 Group Commit을 활성화합니다. 세션 변수는 테이블 속성보다 우선합니다.
비동기 모드:
# Set the session variable to enable group commit (default is off_mode), using async mode
mysql> set group_commit = async_mode;

# The returned label starts with group_commit, which tells you that group commit is in use
mysql> insert into dt values(1, 'Bob', 90), (2, 'Alice', 99);
Query OK, 2 rows affected (0.05 sec)
{'label':'group_commit_a145ce07f1c972fc-bd2c54597052a9ad', 'status':'PREPARE', 'txnId':'181508'}

# This label and txn_id match the previous one, indicating that the inserts are batched into the same load task
mysql> insert into dt(id, name) values(3, 'John');
Query OK, 1 row affected (0.01 sec)
{'label':'group_commit_a145ce07f1c972fc-bd2c54597052a9ad', 'status':'PREPARE', 'txnId':'181508'}

# The data is not immediately queryable
mysql> select * from dt;
Empty set (0.01 sec)

# After 10 seconds, the data is queryable. The data visibility delay is controlled by the table property group_commit_interval.
mysql> select * from dt;
+------+-------+-------+
| id   | name  | score |
+------+-------+-------+
|    1 | Bob   |    90 |
|    2 | Alice |    99 |
|    3 | John  |  NULL |
+------+-------+-------+
3 rows in set (0.02 sec)
동기 모드:
# Set the session variable to enable group commit (default is off_mode), using sync mode
mysql> set group_commit = sync_mode;

# The returned label starts with group_commit, which tells you that group commit is in use. The load takes at least the value of the table property group_commit_interval.
mysql> insert into dt values(4, 'Bob', 90), (5, 'Alice', 99);
Query OK, 2 rows affected (10.06 sec)
{'label':'group_commit_d84ab96c09b60587_ec455a33cb0e9e87', 'status':'PREPARE', 'txnId':'3007', 'query_id':'fc6b94085d704a94-a69bfc9a202e66e2'}

# The data is queryable immediately
mysql> select * from dt;
+------+-------+-------+
| id   | name  | score |
+------+-------+-------+
|    1 | Bob   |    90 |
|    2 | Alice |    99 |
|    3 | John  |  NULL |
|    4 | Bob   |    90 |
|    5 | Alice |    99 |
+------+-------+-------+
5 rows in set (0.03 sec)
비활성화 모드:
mysql> set group_commit = off_mode;
JDBC(PreparedStatement) 사용
JDBC insert into values로 데이터를 쓸 때 SQL 파싱과 계획 생성의 오버헤드를 줄이기 위해, Doris는 FE 측에서 MySQL 프로토콜의 PreparedStatement 기능을 지원합니다. PreparedStatement를 사용하면 SQL과 해당 데이터 적재 계획이 세션 수준의 메모리 캐시에 저장되고, 이후 데이터 적재에서는 캐시된 객체를 직접 사용하므로 FE CPU 사용률을 낮출 수 있습니다.
1. JDBC URL을 설정하고 서버 측 PreparedStatement 활성화:
url = jdbc:mysql://127.0.0.1:9030/db?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=500
2. 다음 두 가지 방법 중 하나로 group_commit 세션 변수 설정:
-
JDBC URL에
sessionVariables=group_commit=async_mode를 추가하여 설정합니다.url = jdbc:mysql://127.0.0.1:9030/db?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=500&sessionVariables=group_commit=async_mode,enable_nereids_planner=false -
SQL 문을 실행하여 설정합니다.
try (Statement statement = conn.createStatement()) {
    statement.execute("SET group_commit = async_mode;");
}
3. PreparedStatement를 사용하여 배치 쓰기 수행:
private static final String JDBC_DRIVER = "com.mysql.jdbc.Driver";
private static final String URL_PATTERN = "jdbc:mysql://%s:%d/%s?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=50&sessionVariables=group_commit=async_mode";
private static final String HOST = "127.0.0.1";
private static final int PORT = 9030;
private static final String DB = "db";
private static final String TBL = "dt";
private static final String USER = "root";
private static final String PASSWD = "";
private static final int INSERT_BATCH_SIZE = 10;

private static void groupCommitInsertBatch() throws Exception {
    Class.forName(JDBC_DRIVER);
    // add rewriteBatchedStatements=true and cachePrepStmts=true in JDBC url
    // set session variables by sessionVariables=group_commit=async_mode in JDBC url
    try (Connection conn = DriverManager.getConnection(
            String.format(URL_PATTERN, HOST, PORT, DB), USER, PASSWD)) {

        String query = "insert into " + TBL + " values(?, ?, ?)";
        try (PreparedStatement stmt = conn.prepareStatement(query)) {
            for (int j = 0; j < 5; j++) {
                // 10 rows per insert
                for (int i = 0; i < INSERT_BATCH_SIZE; i++) {
                    stmt.setInt(1, i);
                    stmt.setString(2, "name" + i);
                    stmt.setInt(3, i + 10);
                    stmt.addBatch();
                }
                int[] result = stmt.executeBatch();
            }
        }
    } catch (Exception e) {
        e.printStackTrace();
    }
}
빈번하게 실행되는 INSERT INTO 문은 대량의 감사 로그를 출력하여 최종 성능에 어느 정도 영향을 주므로, prepared statement의 감사 로그는 기본적으로 비활성화되어 있습니다. 세션 변수를 설정하여 prepared statement의 감사 로그 출력 여부를 제어할 수 있습니다.
# Set the session variable to enable audit logging for prepared statements. The default value is false, which disables audit logging for prepared statements.
set enable_prepared_stmt_audit_log=true;
JDBC 사용에 관한 자세한 내용은 INSERT를 사용한 데이터 동기화를 참조하세요.
Golang 클라이언트에서 배치 처리
Golang은 prepared statement 지원이 제한적이므로 클라이언트 측에서 직접 배치 처리하여 Group Commit 성능을 개선할 수 있습니다. 다음은 예제 프로그램입니다.
package main

import (
	"database/sql"
	"fmt"
	"math/rand"
	"strings"
	"sync"
	"sync/atomic"
	"time"

	_ "github.com/go-sql-driver/mysql"
)

const (
	host     = "127.0.0.1"
	port     = 9030
	db       = "test"
	user     = "root"
	password = ""
	table    = "async_lineitem"
)

var (
	threadCount = 20
	batchSize   = 100
)

var totalInsertedRows int64
var rowsInsertedLastSecond int64

func main() {
	dbDSN := fmt.Sprintf("%s:%s@tcp(%s:%d)/%s?parseTime=true", user, password, host, port, db)
	db, err := sql.Open("mysql", dbDSN)
	if err != nil {
		fmt.Printf("Error opening database: %s\n", err)
		return
	}
	defer db.Close()

	var wg sync.WaitGroup
	for i := 0; i < threadCount; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			groupCommitInsertBatch(db)
		}()
	}

	go logInsertStatistics()

	wg.Wait()
}

func groupCommitInsertBatch(db *sql.DB) {
	for {
		valueStrings := make([]string, 0, batchSize)
		valueArgs := make([]interface{}, 0, batchSize*16)
		for i := 0; i < batchSize; i++ {
		    valueStrings = append(valueStrings, "(?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)")
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, "N")
			valueArgs = append(valueArgs, "O")
			valueArgs = append(valueArgs, time.Now())
			valueArgs = append(valueArgs, time.Now())
			valueArgs = append(valueArgs, time.Now())
			valueArgs = append(valueArgs, "DELIVER IN PERSON")
			valueArgs = append(valueArgs, "SHIP")
			valueArgs = append(valueArgs, "N/A")
		}
		stmt := fmt.Sprintf("INSERT INTO %s VALUES %s",
			table, strings.Join(valueStrings, ","))
		_, err := db.Exec(stmt, valueArgs...)
		if err != nil {
			fmt.Printf("Error executing batch: %s\n", err)
			return
		}
		atomic.AddInt64(&rowsInsertedLastSecond, int64(batchSize))
		atomic.AddInt64(&totalInsertedRows, int64(batchSize))
	}
}

func logInsertStatistics() {
	for {
		time.Sleep(1 * time.Second)
		fmt.Printf("Total inserted rows: %d\n", totalInsertedRows)
		fmt.Printf("Rows inserted in the last second: %d\n", rowsInsertedLastSecond)
		rowsInsertedLastSecond = 0
	}
}
Stream Load
Stream Load로 데이터를 적재할 때 HTTP 헤더의 group_commit 매개변수를 설정하여 Group Commit을 활성화할 수 있습니다.
group_commit 헤더가 설정되지 않았고 테이블 속성에 group_commit_mode가 설정되어 있으면 테이블 속성의 모드를 자동으로 사용합니다.
data.csv의 내용이 다음과 같다고 가정합니다.
6,Amy,60
7,Ross,98
비동기 모드:
# Add the "group_commit:async_mode" header during load

curl --location-trusted -u {user}:{passwd} -T data.csv -H "group_commit:async_mode"  -H "column_separator:,"  http://{fe_host}:{http_port}/api/db/dt/_stream_load
{
    "TxnId": 7009,
    "Label": "group_commit_c84d2099208436ab_96e33fda01eddba8",
    "Comment": "",
    "GroupCommit": true,
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 2,
    "NumberLoadedRows": 2,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 19,
    "LoadTimeMs": 35,
    "StreamLoadPutTimeMs": 5,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 26
}

# The returned GroupCommit is true, which means the load entered the group commit path
# The returned Label starts with group_commit and is the label associated with the load that actually consumes the data
동기 모드:
# Add the "group_commit:sync_mode" header during load

curl --location-trusted -u {user}:{passwd} -T data.csv -H "group_commit:sync_mode"  -H "column_separator:,"  http://{fe_host}:{http_port}/api/db/dt/_stream_load
{
    "TxnId": 3009,
    "Label": "group_commit_d941bf17f6efcc80_ccf4afdde9881293",
    "Comment": "",
    "GroupCommit": true,
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 2,
    "NumberLoadedRows": 2,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 19,
    "LoadTimeMs": 10044,
    "StreamLoadPutTimeMs": 4,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 10038
}

# The returned GroupCommit is true, which means the load entered the group commit path
# The returned Label starts with group_commit and is the label associated with the load that actually consumes the data
Stream Load 구문과 모범 사례에 관한 자세한 내용은 Stream Load를 참조하세요.
자동 커밋 조건
시간 간격(기본값 10초) 또는 데이터 크기(기본값 64 MB) 조건 중 하나를 충족하면 데이터를 자동으로 커밋합니다. 이 두 매개변수는 함께 작동하므로 실제 사용 환경에 맞게 조정하세요.
커밋 간격 조정
기본 커밋 간격은 10초입니다. 테이블 설정을 변경하여 조정할 수 있습니다.
# Change the commit interval to 2 seconds
ALTER TABLE dt SET ("group_commit_interval_ms" = "2000");
튜닝 권장 사항:
| 설정값 예시 | 장점 | 단점 |
|---|---|---|
| 짧은 간격(예: 2초) | 데이터 조회 가능 시점까지의 지연이 줄어들어 더 높은 실시간성이 필요한 환경에 적합 | 커밋 빈도가 높아지고 버전 수가 빠르게 증가하며 백그라운드 Compaction 부하가 커짐 |
| 긴 간격(예: 30초) | 커밋 배치가 커지고 버전 수 증가 속도가 느려지며 시스템 오버헤드가 줄어듦 | 데이터 조회 가능 시점까지의 지연이 늘어남 |
업무에서 허용할 수 있는 데이터 조회 지연에 따라 값을 설정하세요. 시스템 부하가 높으면 간격을 적절히 늘릴 수 있습니다.
커밋 데이터 크기 조정
Group Commit의 기본 커밋 데이터 크기는 64 MB입니다. 테이블 설정을 변경하여 조정할 수 있습니다.
# Change the commit data size to 128MB
ALTER TABLE dt SET ("group_commit_data_bytes" = "134217728");
튜닝 권장 사항:
| 설정값 예시 | 장점 | 단점 |
|---|---|---|
| 작은 임계값(예: 32 MB) | 메모리 사용량이 적어 리소스가 제한된 환경에 적합 | 커밋 배치가 작아 처리량이 제한될 수 있음 |
| 큰 임계값(예: 256 MB) | 배치 커밋 효율과 시스템 처리량이 높아짐 | 메모리 사용량이 많아짐 |
메모리 리소스와 데이터 신뢰성 요구 사항 사이의 균형을 고려하여 값을 선택하세요. 메모리가 충분하고 더 높은 처리량이 필요하면 값을 128 MB 이상으로 늘릴 수 있습니다.
관련 시스템 설정
BE 설정
group_commit_wal_path
-
설명: Group Commit이 WAL 파일을 저장하는 디렉터리입니다.
-
기본값:
wal이라는 이름의 디렉터리가storage_root_path에 설정된 각 디렉터리 아래에 생성됩니다. 설정 예시는 다음과 같습니다.group_commit_wal_path=/data1/storage/wal;/data2/storage/wal;/data3/storage/wal
컴퓨팅-스토리지 분리 모드에서 Stream Load 전달
컴퓨팅-스토리지 분리 모드에서 로드 밸런서가 Stream Load 요청을 무작위로 분산하면 동일한 테이블의 요청이 서로 다른 BE 노드에 도착하므로 Group Commit이 이를 효율적으로 배치 처리할 수 없습니다. BE 전달 기능을 활성화하면 요청을 받은 BE가 해당 테이블의 대상 BE로 요청을 전달하므로, 동일한 테이블의 모든 요청이 하나의 BE로 모입니다.
| 설정 | 위치 | 기본값 | 설명 |
|---|---|---|---|
enable_group_commit_streamload_be_forward | FE | false | Stream Load BE 전달 기능의 활성화 여부입니다. 분리 모드에서 요청이 Group Commit을 사용하는 경우에만 적용됩니다 |
enable_group_commit_streamload_be_forward | BE | false | BE 엔드포인트 /api/{db}/{table}/_stream_load_forward에 대한 요청 허용 여부입니다. 4.0 계열의 Doris 4.0.8 및 4.1 계열의 Doris 4.1.4에서 추가되었습니다 |
FE와 BE 모두에서 이 설정을 true로 지정해야 합니다.
4.0 계열의 Doris 4.0.8 및 4.1 계열의 Doris 4.1.4부터 BE의 _stream_load_forward 엔드포인트에 다음 두 가지 제한이 적용됩니다.
- 이 엔드포인트의 사용 여부는 BE 설정
enable_group_commit_streamload_be_forward로 제어합니다. 이 값이false(기본값)이면 요청에 대해403 Forbidden과Stream load forward is disabled를 반환합니다. - 설정을 활성화한 후에도 이 엔드포인트에 대한 요청은 인증을 통과해야 하며, 전역
LOAD권한을 보유해야 합니다.
업그레이드 전에 FE에서만 이 기능을 활성화했다면 업그레이드 후 전달에 실패합니다. enable_group_commit_streamload_be_forward=true를 모든 be.conf에 추가하고 데이터 적재 계정에 LOAD 권한이 있는지 확인하세요.
Follower FE로 전달
4.1.4 버전부터 지원됩니다.
위에서 설명한 BE 전달 외에도 FE는 Group Commit을 사용하는 Stream Load 요청을 라운드 로빈 방식으로 Follower FE에 전달하여 배치 처리 부하를 여러 FE에 분산할 수 있습니다.
| 설정 | 위치 | 기본값 | 설명 |
|---|---|---|---|
enable_forward_group_commit_stream_load_to_follower | FE | false | Group Commit Stream Load 요청을 라운드 로빈 방식으로 Follower FE에 전달할지 여부입니다 |
참고: 대상 테이블의 light_schema_change가 false로 설정되어 있으면 이 전달 기능을 지원하지 않으며, 해당 요청은 오류와 함께 실패합니다.
WAL 수 제한
4.1.4 버전부터 지원됩니다.
async_mode의 Group Commit은 먼저 데이터를 WAL에 기록한 뒤 비동기적으로 재생합니다. WAL 재생이 계속 실패하면 WAL 파일이 쌓여 디스크가 가득 찰 수 있습니다. 4.1.4 버전부터 BE 설정 group_commit_max_wal_num_per_table로 테이블별 WAL 파일 수를 제한할 수 있습니다.
| 설정 | 위치 | 기본값 | 설명 |
|---|---|---|---|
group_commit_max_wal_num_per_table | BE | 10 | 단일 테이블에 허용되는 Group Commit WAL 파일의 최대 수입니다. 0은 제한 없음을 의미합니다. 동적 변경을 지원합니다 |
제한을 초과하면 해당 테이블에 대한 async_mode Group Commit 데이터 적재가 다음과 같은 EXCEEDED_LIMIT 오류로 거부됩니다.
Too many group commit async WALs for table <table_name>
이 오류는 WAL 재생에 문제가 발생했음을 의미합니다(예: 스키마 변경 또는 디스크 장애). 단순히 제한을 높이기보다는 원인을 조사하여 WAL 재생을 복구하세요.
제한 사항
Group Commit 폴백 시나리오
| 데이터 적재 방식 | Group Commit을 사용하지 않는 방식으로 폴백하는 조건 |
|---|---|
INSERT INTO VALUES | 트랜잭션 쓰기 사용(Begin; INSERT INTO VALUES; COMMIT)레이블 지정( INSERT INTO dt WITH LABEL {label} VALUES)VALUES에 표현식 포함( INSERT INTO dt VALUES (1 + 100))열 업데이트 쓰기 경량 스키마 변경을 지원하지 않는 테이블 |
Stream Load | 두 단계 커밋 사용 레이블 지정( -H "label:my_label")열 업데이트 쓰기 경량 스키마 변경을 지원하지 않는 테이블 |
Unique 모델
- Group Commit은 커밋 순서를 보장하지 않습니다. 데이터 일관성을 보장하려면 Sequence 열을 사용하세요.
WAL 제한 사항
4.1.5부터 WAL 재생 시 파일 끝부분의 길이 또는 페이로드가 불완전하면 해당 지점을 파일의 끝으로 처리합니다. 완전한 데이터 블록은 끝의 체크섬 필드가 완전히 기록되지 않았더라도 재생할 수 있습니다. 끝부분의 미완성 레코드는 완전한 레코드로 복구되지 않습니다. WAL 파일이 없거나 손상된 경우에는 여전히 데이터 무결성을 보장할 수 없습니다.
async_mode는 데이터를 WAL에 기록하고, 성공 시 WAL을 삭제하며, 실패 시 WAL에서 복구합니다.- WAL 파일은 단일 복제본으로 저장됩니다. 해당 디스크가 손상되거나 파일이 실수로 삭제되면 데이터가 손실될 수 있습니다.
- BE 노드를 오프라인으로 전환할 때는 데이터 손실을 방지하기 위해
DECOMMISSION명령을 사용하세요. - 다음 경우에는
async_mode가 자동으로sync_mode로 전환됩니다.- 단일 데이터 적재의 데이터 양이 너무 많은 경우(단일 WAL 디렉터리 공간의 80% 초과)
- 데이터 크기를 알 수 없는 청크 방식 Stream Load
- 사용 가능한 디스크 공간 부족
- 중량 Schema Change 중에는 Group Commit 쓰기가 거부되므로 클라이언트가 재시도해야 합니다.
성능
동시성이 높고 데이터 양이 적은 환경에서 group commit(async_mode 사용)의 쓰기 성능을 Stream Load와 JDBC로 테스트했습니다.
Stream Load 로그 시나리오 테스트
머신 구성:
- 1 FE: Alibaba Cloud, 8코어 CPU, 16 GB 메모리, 1 x 100 GB ESSD PL1 클라우드 디스크
- 3 BE: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 1 TB ESSD PL1 클라우드 디스크
- 1 테스트 클라이언트: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 100 GB ESSD PL1 클라우드 디스크
- 테스트 버전: Doris-3.0.1
데이터셋:
httplogs데이터셋, 총 31 GB 및 247백만 행
테스트 도구:
테스트 방법:
non-group_commit모드와group_commitasync_mode를 비교합니다. 동시 실행 작업당 데이터 크기와 동시 실행 수를 달리하며247249096개 행을 적재합니다.
테스트 결과:
| 데이터 적재 방식 | 동시 실행 작업당 데이터 크기 | 동시 실행 수 | 시간(초) | 데이터 적재 속도(행/초) | 데이터 적재 처리량(MB/초) |
|---|---|---|---|---|---|
group_commit | 10 KB | 10 | 2204 | 112,181 | 14.8 |
group_commit | 10 KB | 30 | 2176 | 113,625 | 15.0 |
group_commit | 100 KB | 10 | 283 | 873,671 | 115.1 |
group_commit | 100 KB | 30 | 244 | 1,013,315 | 133.5 |
group_commit | 500 KB | 10 | 125 | 1,977,992 | 260.6 |
group_commit | 500 KB | 30 | 122 | 2,026,631 | 267.1 |
group_commit | 1 MB | 10 | 119 | 2,077,723 | 273.8 |
group_commit | 1 MB | 30 | 119 | 2,077,723 | 273.8 |
group_commit | 10 MB | 10 | 118 | 2,095,331 | 276.1 |
non-group_commit | 1 MB | 10 | 1883 | 131,305 | 17.3 |
non-group_commit | 10 MB | 10 | 294 | 840,983 | 105.4 |
non-group_commit | 10 MB | 30 | 118 | 2,095,331 | 276.1 |
위의 group_commit 테스트에서 BE CPU 사용률은 10%에서 40% 사이를 유지했습니다.
결과에서 알 수 있듯이 group_commit 모드는 소량의 데이터를 동시에 적재할 때 데이터 적재 성능을 효과적으로 개선하며, 버전 수를 줄이고 백그라운드 데이터 병합 부하를 낮춥니다.
JDBC
머신 구성:
- 1 FE: Alibaba Cloud, 8코어 CPU, 16 GB 메모리, 1 x 100 GB ESSD PL1 클라우드 디스크
- 1 BE: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 500 GB ESSD PL1 클라우드 디스크
- 1 테스트 클라이언트: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 100 GB ESSD PL1 클라우드 디스크
- 테스트 버전: Doris-3.0.1
- 성능 개선을 위해 prepared statement의 감사 로그 비활성화
데이터셋:
- TPC-H sf10
lineitem테이블 데이터셋, 30개 파일, 총 약 22 GB 및 180백만 행
테스트 도구:
테스트 방법:
txtfilereader에서mysqlwriter로 데이터를 쓰며, 동시 실행 수와INSERT당 행 수를 달리합니다.
테스트 결과:
| 삽입당 행 수 | 동시 실행 수 | 데이터 적재 속도(행/초) | 데이터 적재 처리량(MB/초) |
|---|---|---|---|
| 100 | 10 | 160,758 | 17.21 |
| 100 | 20 | 210,476 | 22.19 |
| 100 | 30 | 214,323 | 22.92 |
위 테스트에서 FE CPU 사용률은 약 60-70%, BE CPU 사용률은 약 10-20%를 유지했습니다.
INSERT INTO 동기 모드, 소규모 배치
머신 구성:
- 1 FE: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 500 GB ESSD PL1 클라우드 디스크
- 5 BE: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 1 TB ESSD PL1 클라우드 디스크
- 1 테스트 클라이언트: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 100 GB ESSD PL1 클라우드 디스크
- 테스트 버전: Doris-3.0.1
데이터셋:
-
TPC-H sf10
lineitem테이블 데이터셋. -
CREATE TABLE 문은 다음과 같습니다.
CREATE TABLE IF NOT EXISTS lineitem (
  L_ORDERKEY    INTEGER NOT NULL,
  L_PARTKEY     INTEGER NOT NULL,
  L_SUPPKEY     INTEGER NOT NULL,
  L_LINENUMBER  INTEGER NOT NULL,
  L_QUANTITY    DECIMAL(15,2) NOT NULL,
  L_EXTENDEDPRICE  DECIMAL(15,2) NOT NULL,
  L_DISCOUNT    DECIMAL(15,2) NOT NULL,
  L_TAX         DECIMAL(15,2) NOT NULL,
  L_RETURNFLAG  CHAR(1) NOT NULL,
  L_LINESTATUS  CHAR(1) NOT NULL,
  L_SHIPDATE    DATE NOT NULL,
  L_COMMITDATE  DATE NOT NULL,
  L_RECEIPTDATE DATE NOT NULL,
  L_SHIPINSTRUCT CHAR(25) NOT NULL,
  L_SHIPMODE     CHAR(10) NOT NULL,
  L_COMMENT      VARCHAR(44) NOT NULL
)
DUPLICATE KEY(L_ORDERKEY, L_PARTKEY, L_SUPPKEY, L_LINENUMBER)
DISTRIBUTED BY HASH(L_ORDERKEY) BUCKETS 32
PROPERTIES (
  "replication_num" = "3"
);
테스트 도구:
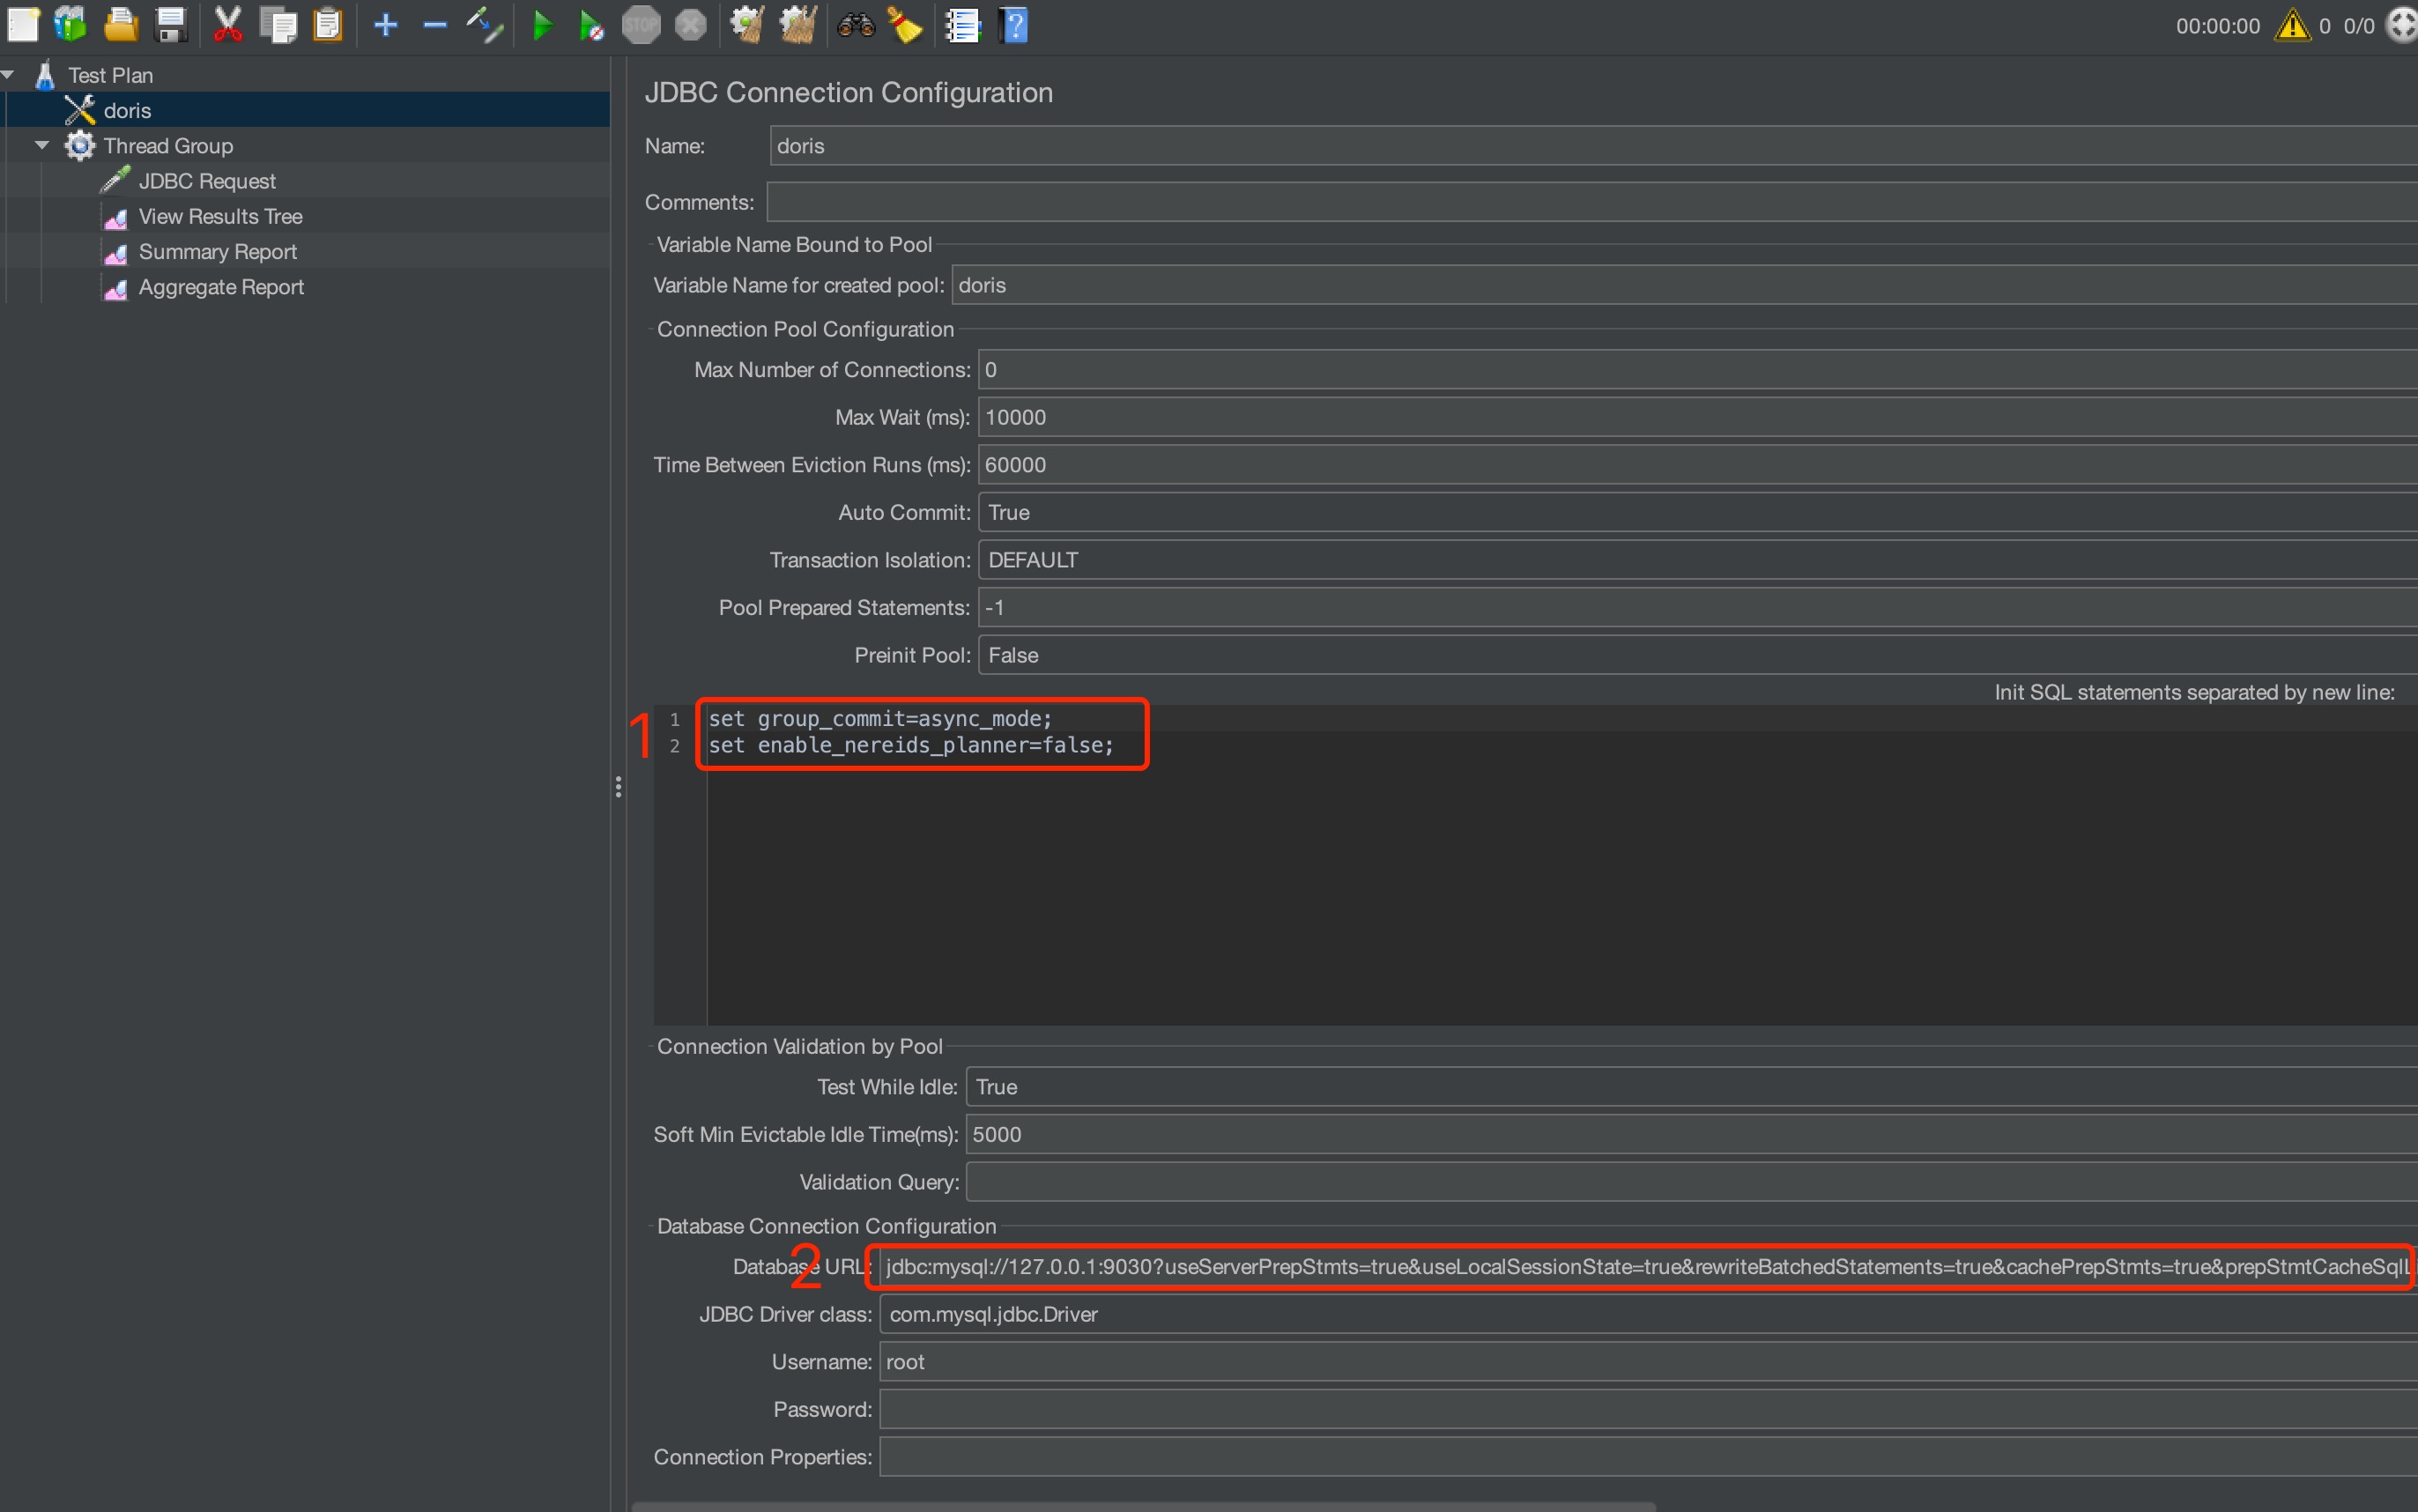
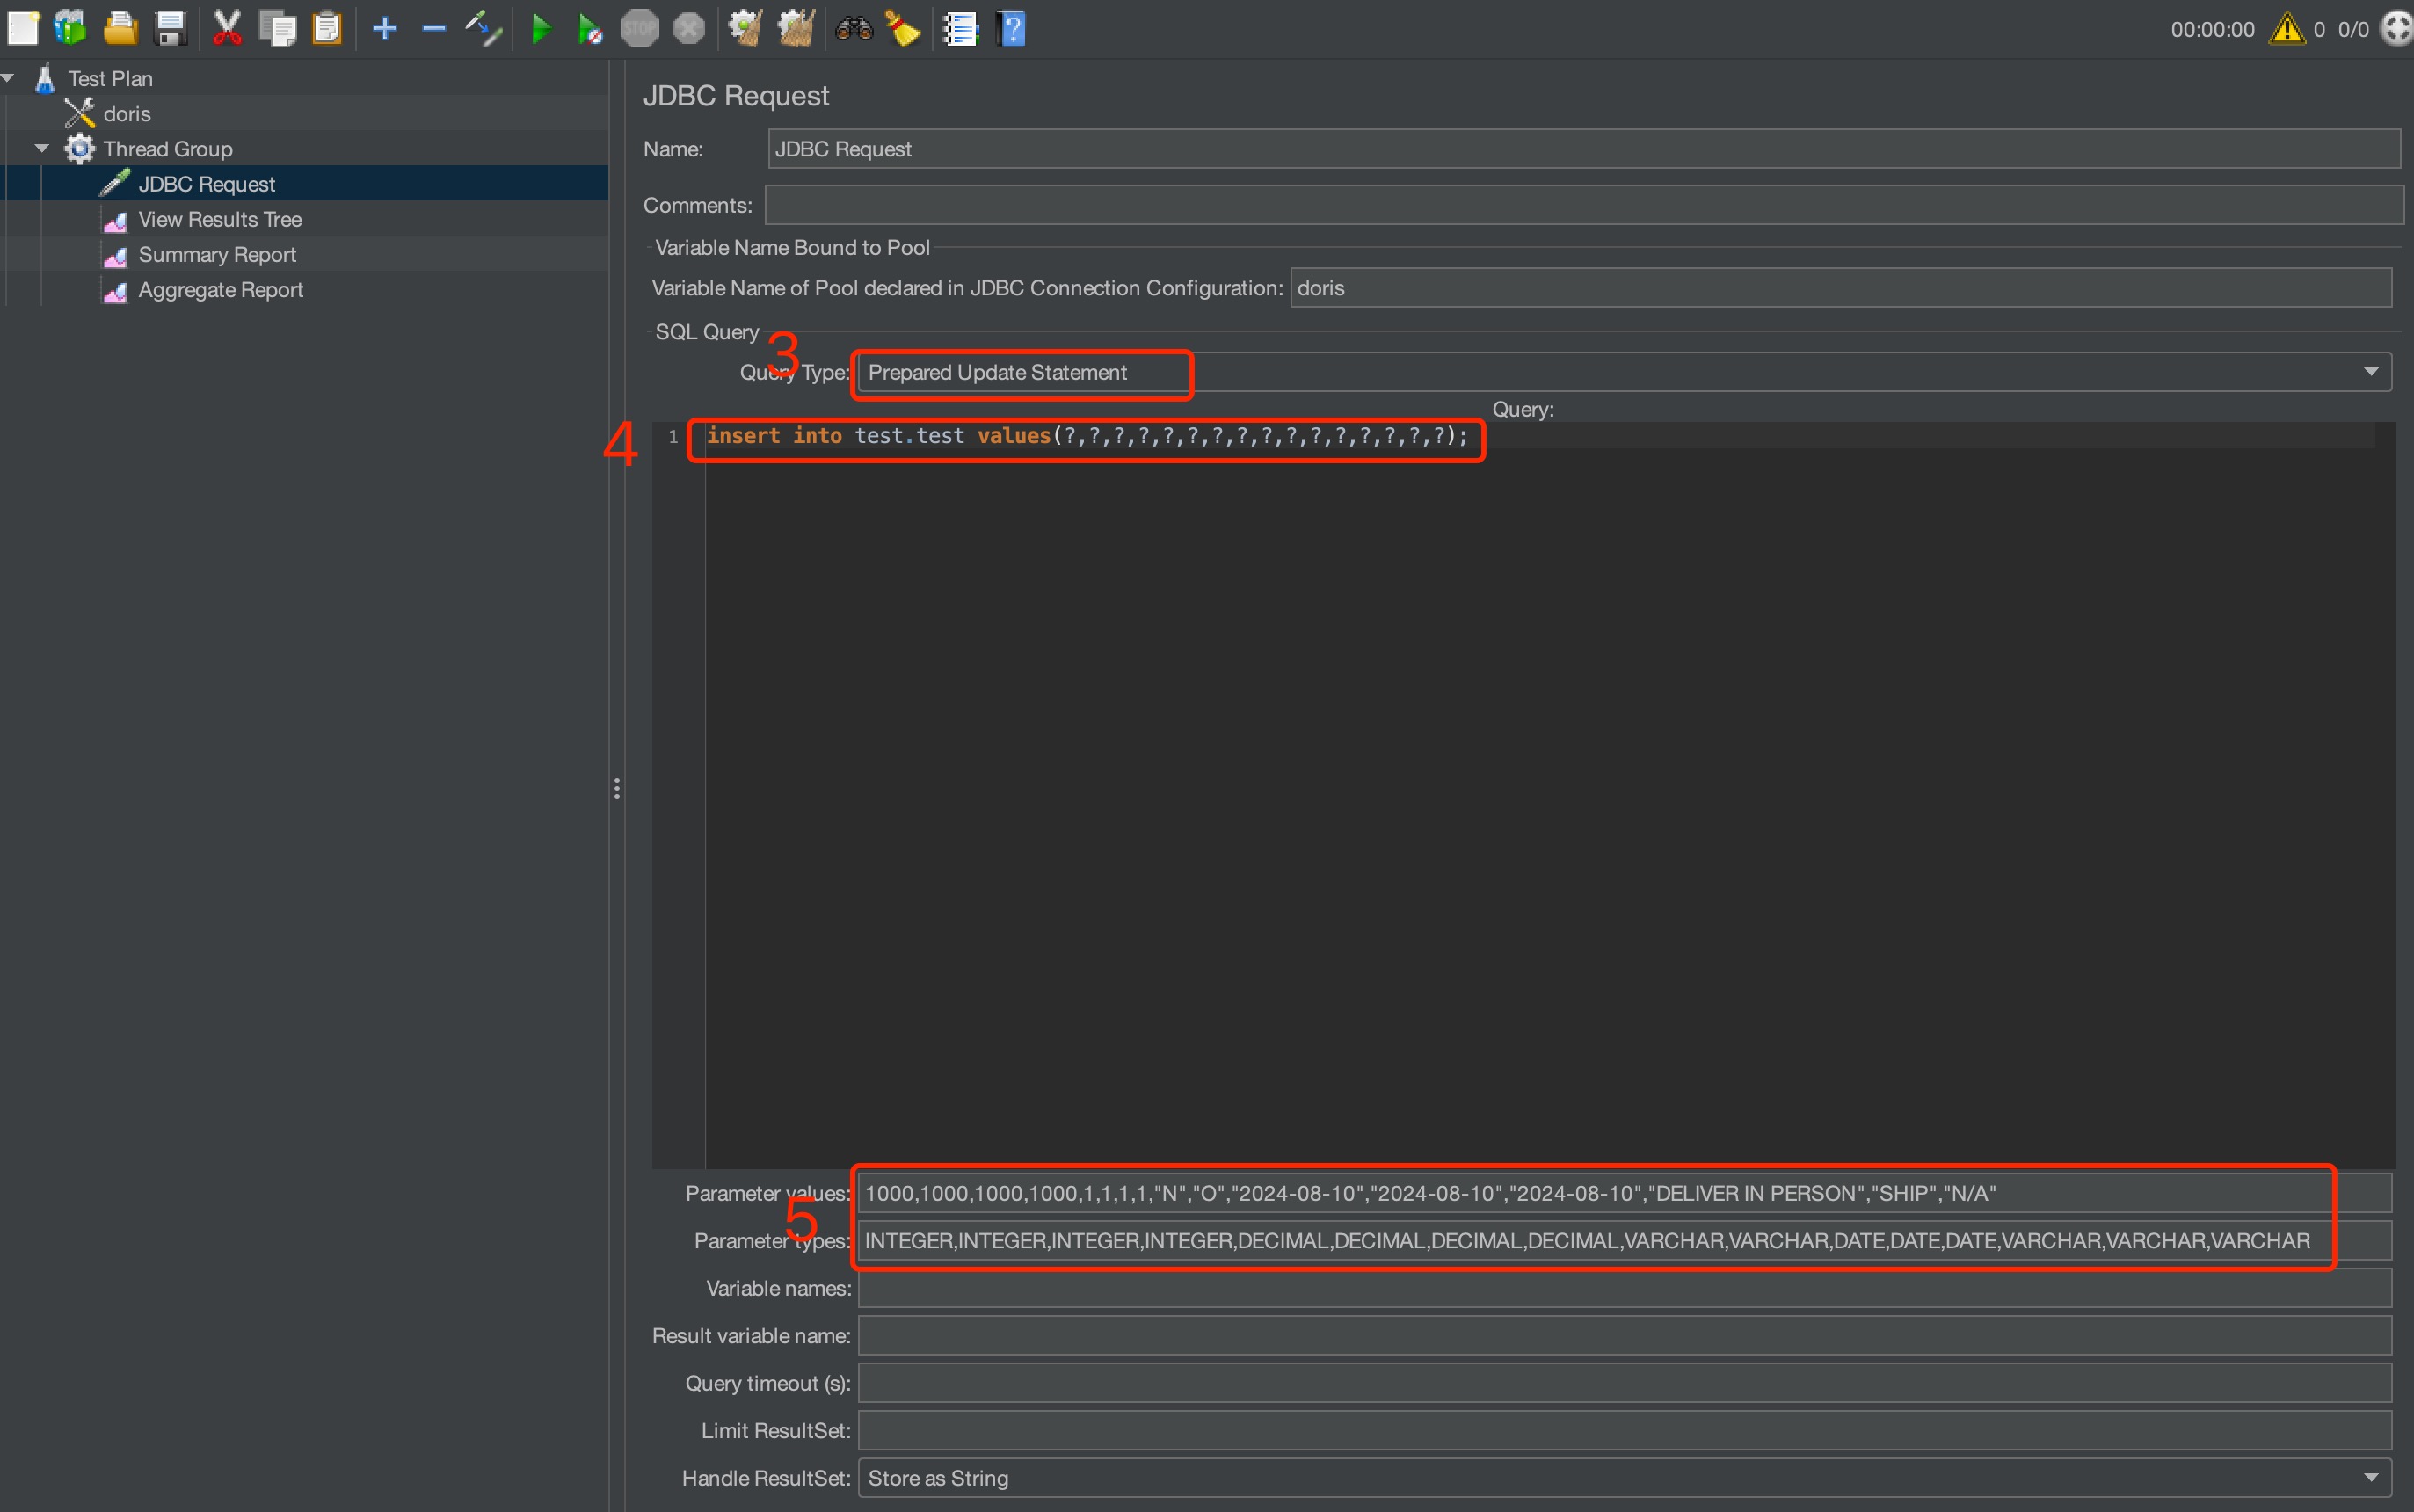
설정할 Jmeter 매개변수는 다음과 같습니다.
-
테스트 전에 초기화 문을 설정합니다:
set group_commit=async_mode및set enable_nereids_planner=false. -
JDBC PreparedStatement를 활성화합니다. 전체 URL은 다음과 같습니다.
jdbc:mysql://127.0.0.1:9030?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=50&sessionVariables=group_commit=async_mode,enable_nereids_planner=false`. -
데이터 적재 유형을 prepared update statement로 설정합니다.
-
데이터 적재 문을 설정합니다.
-
매번 적재할 값을 설정합니다. 각 값이 데이터 적재 값의 유형과 하나씩 일치하는지 확인하세요.
테스트 방법:
Doris에Jmeter를 통해 데이터를 씁니다. 각 동시 실행 작업은INSERT INTO마다 1개 행을 씁니다.
테스트 결과(단위: 행/초):
아래 테스트는 동시 실행 수 30, 100, 500을 대상으로 합니다.
동시 실행 수 30, 동기 모드, BE 5개 및 복제본 3개:
| Group Commit 간격 | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 891.8 | 701.1 | 400.0 | 237.5 |
enable_nereids_planner=false | 885.8 | 688.1 | 398.7 | 232.9 |
동시 실행 수 100, 동기 모드, BE 5개 및 복제본 3개:
| Group Commit 간격 | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 2427.8 | 2068.9 | 1259.4 | 764.9 |
enable_nereids_planner=false | 2320.4 | 1899.3 | 1206.2 | 749.7 |
동시 실행 수 500, 동기 모드, BE 5개 및 복제본 3개:
| Group Commit 간격 | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 5567.5 | 5713.2 | 4681.0 | 3131.2 |
enable_nereids_planner=false | 4471.6 | 5042.5 | 4932.2 | 3641.1 |
INSERT INTO 동기 모드, 대규모 배치
머신 구성:
- 1 FE: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 500 GB ESSD PL1 클라우드 디스크
- 5 BE: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 1 TB ESSD PL1 클라우드 디스크. 참고: 테스트에서는 각각 BE 1개, 3개, 5개를 사용했습니다.
- 1 테스트 클라이언트: Alibaba Cloud, 16코어 CPU, 64 GB 메모리, 1 x 100 GB ESSD PL1 클라우드 디스크
- 테스트 버전: Doris-3.0.1
데이터셋:
-
TPC-H sf10
lineitem테이블 데이터셋. -
CREATE TABLE 문은 다음과 같습니다.
CREATE TABLE IF NOT EXISTS lineitem (
  L_ORDERKEY    INTEGER NOT NULL,
  L_PARTKEY     INTEGER NOT NULL,
  L_SUPPKEY     INTEGER NOT NULL,
  L_LINENUMBER  INTEGER NOT NULL,
  L_QUANTITY    DECIMAL(15,2) NOT NULL,
  L_EXTENDEDPRICE  DECIMAL(15,2) NOT NULL,
  L_DISCOUNT    DECIMAL(15,2) NOT NULL,
  L_TAX         DECIMAL(15,2) NOT NULL,
  L_RETURNFLAG  CHAR(1) NOT NULL,
  L_LINESTATUS  CHAR(1) NOT NULL,
  L_SHIPDATE    DATE NOT NULL,
  L_COMMITDATE  DATE NOT NULL,
  L_RECEIPTDATE DATE NOT NULL,
  L_SHIPINSTRUCT CHAR(25) NOT NULL,
  L_SHIPMODE     CHAR(10) NOT NULL,
  L_COMMENT      VARCHAR(44) NOT NULL
)
DUPLICATE KEY(L_ORDERKEY, L_PARTKEY, L_SUPPKEY, L_LINENUMBER)
DISTRIBUTED BY HASH(L_ORDERKEY) BUCKETS 32
PROPERTIES (
  "replication_num" = "3"
);
테스트 도구:
테스트 방법:
Doris에Jmeter를 통해 데이터를 씁니다. 각 동시 실행 작업은INSERT INTO마다 1000개 행을 씁니다.
테스트 결과(단위: 행/초):
아래 테스트는 동시 실행 수 30, 100, 500을 대상으로 합니다.
동시 실행 수 30, 동기 모드, BE 5개 및 복제본 3개:
| Group Commit 간격 | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 9.1K | 11.1K | 11.4K | 11.1K |
enable_nereids_planner=false | 157.8K | 159.9K | 154.1K | 120.4K |
동시 실행 수 100, 동기 모드, BE 5개 및 복제본 3개:
| Group Commit 간격 | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 10.0K | 9.2K | 8.9K | 8.9K |
enable_nereids_planner=false | 130.4K | 131.0K | 130.4K | 124.1K |
동시 실행 수 500, 동기 모드, BE 5개 및 복제본 3개:
| Group Commit 간격 | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 2.5K | 2.5K | 2.3K | 2.1K |
enable_nereids_planner=false | 94.2K | 95.1K | 94.4K | 94.8K |
자주 묻는 질문
Q1: 데이터 적재에 Group Commit이 사용되는지 어떻게 확인하나요?
- INSERT INTO VALUES: 반환 결과의
label이group_commit_로 시작하며, 여러 데이터 적재가 동일한label과txnId를 공유할 수 있습니다. - Stream Load: 반환된 JSON에서
GroupCommit필드가true이고Label이group_commit_로 시작합니다.
Q2: async_mode를 활성화하면 언제부터 데이터를 쿼리할 수 있나요?
- 데이터 조회 가능 시점까지의 지연은 테이블 속성
group_commit_interval_ms(기본값 10초)와group_commit_data_bytes(기본값 64 MB)에 의해 함께 결정됩니다. 어느 한 조건이 충족되는 즉시 커밋합니다.
Q3: async_mode는 언제 자동으로 sync_mode로 폴백하나요?
- 단일 데이터 적재의 데이터 양이 단일 WAL 디렉터리 공간의 80%를 초과하는 경우.
- 데이터 크기를 알 수 없는 청크 방식 Stream Load.
- 사용 가능한 디스크 공간 부족.
Q4: INSERT INTO VALUES가 Group Commit을 거치지 않는 이유는 무엇인가요?
- 명시적 트랜잭션 내에서 실행 중인지, 레이블을 지정했는지, VALUES에 표현식이 포함되어 있는지, 열 업데이트 쓰기인지, 테이블이 경량 스키마 변경을 지원하지 않는지 확인하세요. 자세한 내용은 Group Commit 폴백 시나리오를 참조하세요.
Q5: async_mode를 사용할 때 데이터 손실 위험이 있나요?
- WAL 파일은 단일 복제본으로 저장됩니다. 해당 디스크가 손상되거나 파일이 실수로 삭제되면 데이터가 손실될 수 있습니다. BE 노드를 오프라인으로 전환할 때는 데이터 손실을 방지하기 위해 항상
DECOMMISSION명령을 사용하세요.
Q6: Unique 모델에서 Group Commit을 사용할 때 무엇을 주의해야 하나요?
- Group Commit은 커밋 순서를 보장하지 않습니다. 데이터 일관성을 보장하려면 Sequence 열을 사용하세요.