Doris Operator 상태 및 문제 해결
Doris Operator는 Doris 사용자 정의 리소스의 status 필드에 컴포넌트 상태를 기록합니다. Kubernetes에서 Doris 문제를 해결할 때는 먼저 CR 상태를 확인한 다음 Operator 로그, Kubernetes 리소스, Doris 컴포넌트 로그를 차례로 확인하세요.
리소스 상태 확인
컴퓨팅·스토리지 통합형 클러스터는 DorisCluster를 사용하며, 일반적으로 dcr로 줄여 표기합니다.
kubectl get dcr -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
컴퓨팅·스토리지 분리형 클러스터는 DorisDisaggregatedCluster를 사용하며, 일반적으로 ddc로 줄여 표기합니다.
kubectl get ddc -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
CR에서 컴포넌트가 준비되지 않은 것으로 표시되면 관련 하위 리소스를 확인하세요.
kubectl get pod,sts,svc,pvc -n ${namespace}
kubectl get event -n ${namespace} --sort-by=.lastTimestamp
DorisCluster 상태
DorisCluster.status는 컴포넌트별로 집계됩니다.
| 필드 | 설명 |
|---|---|
feStatus | FE 상태 |
beStatus | BE 상태 |
cnStatus | CN 상태 |
brokerStatus | Broker 상태 |
각 컴포넌트 상태에는 일반적으로 다음 항목이 포함됩니다.
| 필드 | 설명 |
|---|---|
accessService | 컴포넌트의 외부 접근용 Service |
runningInstances | 실행 중인 인스턴스 |
creatingInstances | 생성 중인 인스턴스 |
failedInstances | 장애가 발생한 인스턴스 |
componentCondition.phase | 현재 컴포넌트 단계 |
componentCondition.reason | 해당 단계에 있는 이유 |
componentCondition.message | 사람이 읽고 이해할 수 있는 상태 메시지 |
일반적인 단계는 다음과 같습니다.
| 단계 | 의미 |
|---|---|
available | 컴포넌트를 사용할 수 있음 |
reconciling | Operator가 리소스를 조정하는 중 |
waitScheduling | 스케줄링 또는 다른 리소스를 기다리는 중 |
haveMemberFailed | 하나 이상의 인스턴스에 장애가 발생함 |
initializing | 컴포넌트를 초기화하는 중 |
upgrading | 컴포넌트를 업그레이드하는 중 |
scaling | 컴포넌트 규모를 조정하는 중 |
restarting | 컴포넌트를 재시작하는 중 |
DorisDisaggregatedCluster 상태
DorisDisaggregatedCluster.status에는 컴포넌트 상태와 클러스터의 전반적인 상태가 포함됩니다.
| 필드 | 설명 |
|---|---|
metaServiceStatus | MetaService 상태 |
feStatus | FE 상태 |
computeGroupStatuses | ComputeGroup 상태 목록 |
clusterHealth | 클러스터의 전반적인 상태 |
observedGeneration | Operator가 확인한 Generation |
clusterHealth는 클러스터의 전반적인 가용성을 나타냅니다.
| 필드 | 설명 |
|---|---|
health | green, yellow, red 등으로 나타내는 전반적인 상태 |
feAvailable | FE 사용 가능 여부 |
cgCount | ComputeGroup 수 |
cgAvailableCount | 사용 가능한 ComputeGroup 수 |
cgFullAvailableCount | 모든 Pod를 사용할 수 있는 ComputeGroup 수 |
| 상태 | 의미 |
|---|---|
green | 핵심 컴포넌트를 사용할 수 있고 ComputeGroup 가용성이 예상한 수준임 |
yellow | 클러스터를 부분적으로 사용할 수 있지만 완전히 준비되지는 않음 |
red | 핵심 컴포넌트를 사용할 수 없거나 사용 가능한 ComputeGroup 수가 너무 적음 |
ComputeGroup의 단계에는 Ready, Reconciling, Scaling, Decommissioning, ScaleDownFailed, Suspended가 포함될 수 있습니다.
권장 문제 해결 순서
다음 순서로 확인하세요.
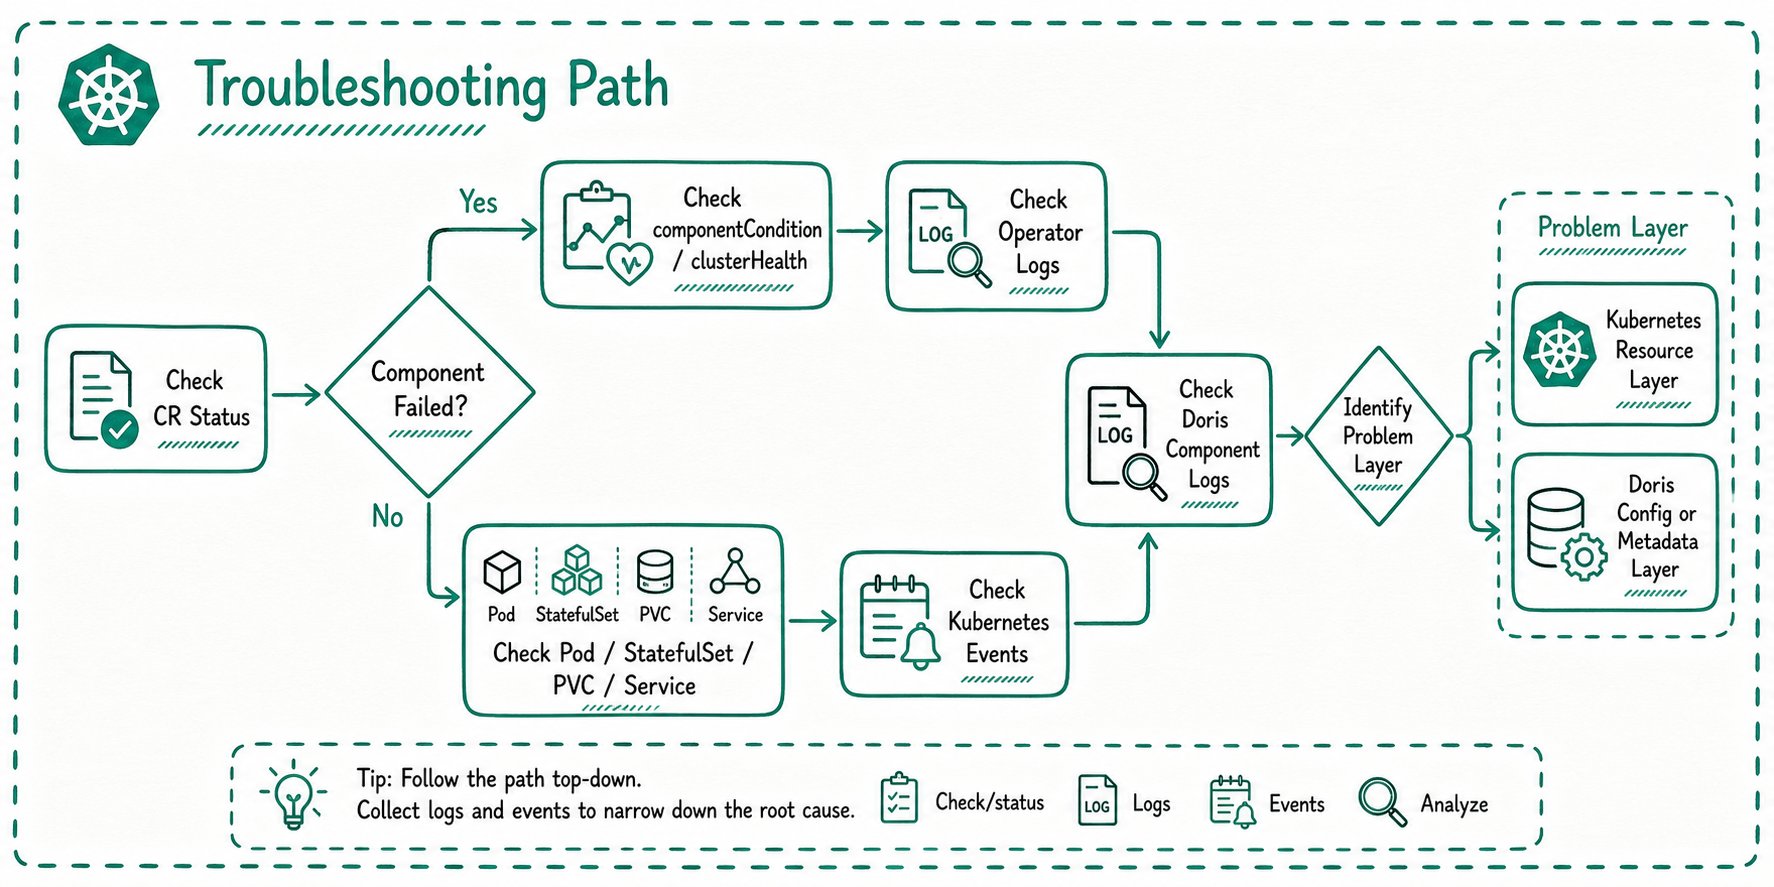
주요 문제별 확인 사항
Pod가 Pending 상태로 유지됨
일반적인 원인:
- 노드의 CPU 또는 메모리 부족.
- Node selector, affinity 또는 toleration 불일치.
- PVC 바인딩 실패.
kubectl describe pod ${pod_name} -n ${namespace}
kubectl get event -n ${namespace} --sort-by=.lastTimestamp
kubectl get pvc -n ${namespace}
PVC가 바인딩되지 않음
일반적인 원인:
- StorageClass가 존재하지 않음.
- 스토리지 용량 부족.
- 접근 모드 불일치.
kubectl get storageclass
kubectl describe pvc ${pvc_name} -n ${namespace}
컴포넌트가 계속 재시작됨
일반적인 원인:
- Doris 시작 설정이 잘못됨.
- 포트 충돌 또는 잘못된 FQDN 설정.
- 스토리지 권한 또는 마운트 경로 문제.
- JVM 또는 시스템 매개변수가 요구 사항을 충족하지 않음.
kubectl logs ${pod_name} -n ${namespace}
kubectl describe pod ${pod_name} -n ${namespace}
Pod가 CrashLoopBackOff 상태이고 로그만으로 충분한 정보를 얻을 수 없다면 클러스터 운영 문서에 설명된 Debug 절차를 사용하세요.
Service에 접근할 수 없음
일반적인 원인:
- 내부 Service를 외부 진입점으로 사용함.
- Service 유형이 접근 환경과 맞지 않음.
- Pod가 Ready 상태가 아니어서 Endpoints가 비어 있음.
- 클라우드 LoadBalancer 생성 실패.
kubectl get svc -n ${namespace}
kubectl get endpoints -n ${namespace}
kubectl describe svc ${service_name} -n ${namespace}
설정 변경 사항이 적용되지 않음
일반적인 원인:
- ConfigMap을 변경했지만 컴포넌트가 재시작되지 않음.
- ConfigMap 키가 컴포넌트 요구 사항과 맞지 않음.
- CR이 ConfigMap을 올바르게 참조하지 않음.
- 마운트 경로와 설정된 파일 경로가 일치하지 않음.
kubectl get configmap -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
컴퓨팅·스토리지 통합형 클러스터에서 핵심 ConfigMap 변경 시 롤링 재시작이 실행되도록 하려면 enableRestartWhenConfigChange가 설정되어 있는지 확인하세요.
authSecret 문제
Doris Operator는 노드 등록, scale-in, decommissioning 및 관련 작업을 위해 Doris 관리 자격 증명이 필요할 수 있습니다. authSecret 설정이 잘못되면 이러한 작업이 완료되지 않을 수 있습니다.
일반적인 원인:
- 참조된 Secret이 존재하지 않거나 잘못된 namespace에 있음.
- Secret 유형 또는 키가 잘못됨.
- 사용자 이름 또는 비밀번호가 Doris 관리 계정 정보와 일치하지 않음.
- 관리 계정에 필요한 권한이 없음.
kubectl get secret ${auth_secret_name} -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
kubectl logs deployment/${operator_deployment_name} -n ${operator_namespace}
클러스터가 기본 관리 계정이 아닌 계정을 사용하거나 이미 root 비밀번호를 설정했다면 authSecret이 실제 Doris 자격 증명과 일치하는지 확인하세요.
ComputeGroup scale-in이 완료되지 않음
컴퓨팅·스토리지 분리형 클러스터에서는 ComputeGroup scale-in이 Decommissioning 또는 ScaleDownFailed 상태에 머무를 수 있습니다.
일반적인 원인:
- Doris 메타데이터 수준의 decommission이 완료되지 않음.
- FE를 사용할 수 없음.
- 관리 자격 증명이 잘못됨.
- 대상 노드에 데이터 마이그레이션 또는 정리 작업이 아직 남아 있음.
kubectl describe ddc ${cluster_name} -n ${namespace}
kubectl logs deployment/${operator_deployment_name} -n ${operator_namespace}
Doris 측의 노드 및 ComputeGroup 상태도 살펴봐야 할 수 있습니다.
Operator 로그
CR 상태만으로 장애 원인을 파악하기 어렵다면 Doris Operator 로그를 확인하세요.
kubectl get pod -n ${operator_namespace}
kubectl logs ${operator_pod_name} -n ${operator_namespace}