분석 함수
요약 Apache Doris의 분석 함수(윈도우 함수)는
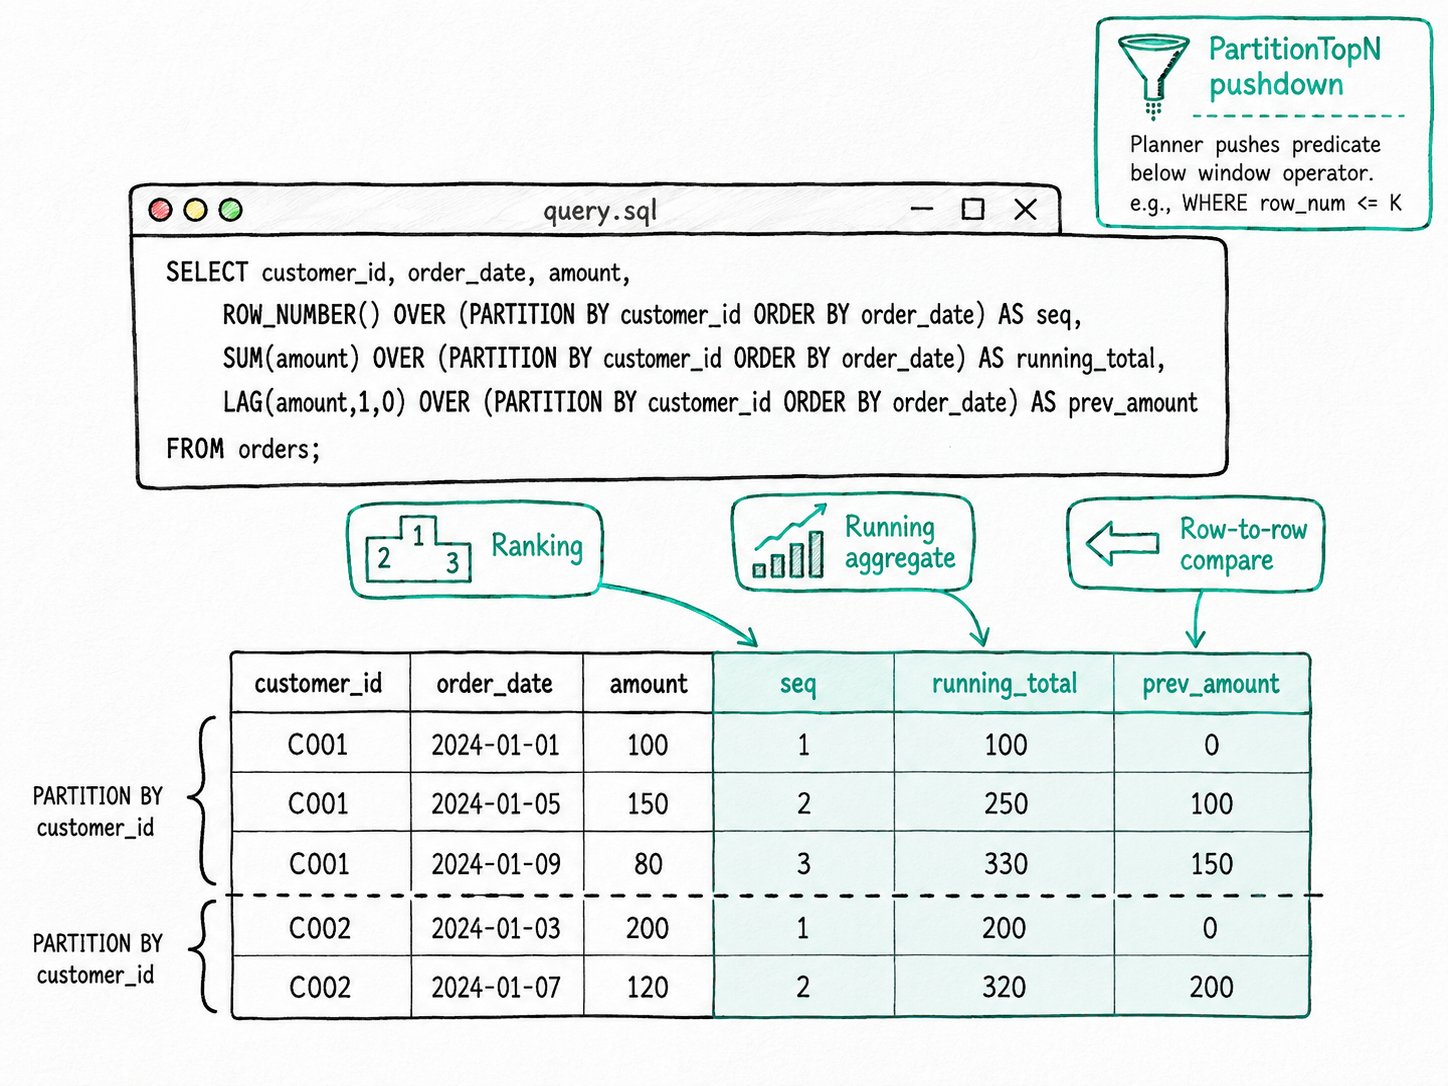
GROUP BY처럼 행을 하나로 합치지 않고 결과 집합의 각 행에 대한 값을 계산합니다. Apache Doris는 표준 함수인ROW_NUMBER,RANK,DENSE_RANK,NTILE,LAG,LEAD,FIRST_VALUE,LAST_VALUE,NTH_VALUE,PERCENT_RANK,CUME_DIST와 모든 집계 함수(SUM,AVG,COUNT,MIN,MAX)를OVER와 함께 사용할 수 있도록 지원합니다. Nereids 옵티마이저는WHERE row_num <= K를 파티션을 고려하는 윈도우 아래의 Top-N으로 재작성하므로, "범주별 상위 10개" 쿼리는 파티션 전체를 정렬하지 않습니다.
Apache Doris에서 분석 함수를 사용하는 이유는 무엇인가요?
Apache Doris의 분석 함수는 거의 모든 분석 워크로드에서 등장하며 GROUP BY만으로는 답할 수 없는 세 가지 질문에 답합니다.
- "고객별 주문에 시간순으로 번호를 매긴 다음 처음 10개만 남기려면?"
(customer_id, order_date)에 대한 셀프 조인으로 처리할 수 있지만 테이블을 두 번 읽습니다. - "일별 매출의 누적 합계와 7일 이동 평균은 얼마인가?"
GROUP BY는 계속 표시하고 싶은 행까지 하나로 합칩니다. - "각 행을 이전 행과 비교하려면?" 전년 대비, 전기 대비, 이벤트 간 간격 분석은 모두 lag/lead 패턴입니다. 윈도우 함수 없이 작성하려면 플래너가 최적화할 수 없는 오프셋 조건자를 사용한 셀프 조인이 필요합니다.
Apache Doris의 분석 함수는 셀프 조인 없이 원래 행을 유지하면서 데이터를 한 번 순회하여 세 가지 질문에 모두 답합니다.
Apache Doris 분석 함수란 무엇인가요?
Apache Doris 분석 함수는 각 입력 행에 대해 OVER 절로 정의한 관련 행의 윈도우에서 값을 계산하는 SQL 함수입니다. 윈도우는 파티션 전체일 수도 있고, 현재 행 주변의 고정된 범위일 수도 있으며, 그 사이의 어떤 범위든 될 수 있습니다. 출력 행 수는 입력 행 수와 같습니다.
function(args) OVER ( [PARTITION BY ...] [ORDER BY ...] [<frame>] )
주요 용어
OVER절: 해당 호출이 일반 집계가 아닌 윈도우 함수임을 Apache Doris에 알립니다. 필수 항목입니다.PARTITION BY: 입력을 독립적인 그룹으로 나눕니다. 각 파티션은 별도로 계산됩니다. 테이블 파티션과 달리 런타임 개념입니다.ORDER BY(OVER내부): 각 파티션 내의 행을 정렬합니다.LAG,LEAD,ROW_NUMBER,RANK와PRECEDING/FOLLOWING을 사용하는 모든 프레임에 필요합니다.- 윈도우 프레임: 함수가 현재 행을 계산할 때 읽는 파티션의 일부입니다. Apache Doris는
ROWS BETWEEN ... PRECEDING/FOLLOWING/CURRENT ROW/UNBOUNDED ...와 제한된 형태의RANGE를 지원합니다. - PartitionTopN: 플래너가
WHERE rank <= K필터에 파티션별 상위 K개 행만 필요하다고 입증할 수 있을 때 삽입하는 내부 연산자입니다. 소스:CreatePartitionTopNFromWindow.java.
Apache Doris 분석 함수는 어떻게 작동하나요?
Apache Doris의 분석 함수는 계획, 셔플, 정렬, 평가, 푸시다운이라는 다섯 단계의 파이프라인으로 실행됩니다.
- 계획. 옵티마이저는
OVER절을WindowExpression으로 파싱하고, 프레임을 정규화한 다음(CheckAndStandardizeWindowFunctionAndFrame), 동일한PARTITION BY와ORDER BY를 공유하는 윈도우 호출을 하나의 물리적 윈도우 연산자로 묶습니다. 파티션과 정렬 순서를 공유하는 호출에는 추가 정렬 비용이 들지 않습니다. - 파티션별 셔플.
PARTITION BY가 있으면 엔진은 같은 파티션의 모든 행이 동일한 백엔드에 모이도록 행을 셔플합니다.PARTITION BY가 없으면 윈도우 전체가 단일 파이프라인에서 실행되며, 이것이 병렬 처리 수준의 상한이 됩니다. - 파티션 내 정렬. 각 백엔드는
ORDER BY열을 기준으로 각자의 파티션을 정렬합니다.ORDER BY가 고유하지 않으면 동률인 행의 순서는 비결정적입니다. 따라서 문서에서는 날짜가 같은 행이 있을 때SUM() OVER (ORDER BY date_col)가 서로 다른 결과를 반환할 수 있다고 경고합니다. - 행별 평가. Apache Doris는 각 파티션을 한 번 순회하면서 윈도우 프레임을 유지합니다. 순위 함수는 행마다 정수 하나를 출력하고,
ROWS UNBOUNDED PRECEDING에 대한 집계 함수는 누적 합계를 유지합니다. 슬라이딩 윈도우 집계는 새 행을 추가하고 뒤쪽 경계를 벗어난 행을 제외합니다. - 필터와 Top-N 푸시다운.
CreatePartitionTopNFromWindow는WHERE row_number() OVER (PARTITION BY a ORDER BY b) <= K를 윈도우 아래의PartitionTopN(K)연산자로 변환하여 각 파티션에서 상위 K개 행만 윈도우 연산자로 전달되도록 합니다.PushDownFilterThroughWindow는PARTITION BY열에 대한 필터를 윈도우 앞쪽으로 이동시켜, Apache Doris가 정렬한 뒤 필터링하던 작업을 정렬 전에 수행하도록 합니다.
빠른 시작
CREATE TABLE orders (
  customer_id INT, order_date DATE, amount DECIMAL(10,2)
) DISTRIBUTED BY HASH(customer_id) BUCKETS 4
PROPERTIES ("replication_num" = "1");

INSERT INTO orders VALUES
  (1,'2026-04-30',50),(1,'2026-05-01',80),(1,'2026-05-02',30),
  (2,'2026-04-30',20),(2,'2026-05-01',90);

SELECT customer_id, order_date, amount,
       ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY order_date) AS seq,
       SUM(amount)  OVER (PARTITION BY customer_id ORDER BY order_date) AS running_total,
       LAG(amount,1,0) OVER (PARTITION BY customer_id ORDER BY order_date) AS prev_amount
FROM orders;
예상 결과
+-------------+------------+--------+-----+---------------+-------------+
| customer_id | order_date | amount | seq | running_total | prev_amount |
+-------------+------------+--------+-----+---------------+-------------+
|           1 | 2026-04-30 |     50 |   1 |            50 |           0 |
|           1 | 2026-05-01 |     80 |   2 |           130 |          50 |
|           1 | 2026-05-02 |     30 |   3 |           160 |          80 |
|           2 | 2026-04-30 |     20 |   1 |            20 |           0 |
|           2 | 2026-05-01 |     90 |   2 |           110 |          20 |
+-------------+------------+--------+-----+---------------+-------------+
한 번의 순회로 윈도우 연산을 적용한 열 세 개를 계산하며 셀프 조인은 필요하지 않습니다. 원래의 다섯 행은 그대로 유지됩니다. LAG(..., 1, 0)는 각 파티션의 첫 번째 행에 대해 0을 반환하여 NULL을 대체합니다.
Apache Doris 분석 함수는 언제 사용해야 하나요?
Apache Doris의 분석 함수는 그룹별 Top-N, 누적 합계, lag/lead 비교, 백분위수 구간화, 전체 합계 대비 비율 등 인접 행에 의존하면서 원래 행을 유지해야 하는 모든 계산에 적합합니다.
적합한 경우
- 그룹별 Top-N: "고객별 상위 10개 주문", "지역별 최다 판매 제품".
WHERE rn <= 10필터를 추가하면 Apache Doris가 파티션 Top-N을 윈도우 아래로 푸시다운합니다. ROWS BETWEEN n PRECEDING AND m FOLLOWING을 사용하는 누적 합계, 이동 평균, 중심 이동 평균.LAG와LEAD를 사용하는 전년 대비, 전일 대비, 이벤트 간 간격 분석. 테이블을 한 번 순회하여 셀프 조인을 대체합니다.NTILE을 사용하는 백분위수 또는 사분위수 보고서용 구간화.- 행별 값과 파티션 전체 합계를 함께 사용하는 보고서 쿼리. 예:
amount / SUM(amount) OVER (PARTITION BY region) AS share_of_region.
적합하지 않은 경우
- 행을 하나로 합치는 순수 집계.
SELECT category, SUM(amount) FROM t GROUP BY category는 정렬 없이, 모든 행을 메모리에 유지할 필요 없이 동일한 작업을 수행합니다. 우선GROUP BY를 사용하고, 집계되지 않은 열도 필요할 때만OVER로 전환하세요. - 숫자 오프셋을 사용하는
RANGE프레임(예:RANGE BETWEEN 5 PRECEDING AND CURRENT ROW). Apache Doris의RANGE프레임은UNBOUNDED경계 또는CURRENT ROW로 제한되며, 임의의RANGE n PRECEDING/FOLLOWING은 지원하지 않습니다. 숫자 오프셋이 필요하면ROWS를 사용하세요. PARTITION BY가 없는 윈도우. 결과 집합 전체가 하나의 파이프라인에 모이므로, 입력이 크면 해당 파이프라인이 병목이 됩니다. 워크로드에서 허용하는 한 파티션 키를 추가하세요.- 결정적인 출력이 필요한데 고유하지 않은 열에
ORDER BY를 사용하는 경우. 여러 행이 같은 날짜를 공유하면SUM(x) OVER (ORDER BY day)의 누적 합계가 실행할 때마다 달라질 수 있습니다. 동률을 구분할 추가 정렬 기준을 지정하세요. 윈도우 함수 개요를 참조하세요. - 새로 고칠 때마다 동일한 윈도우 결과를 다시 계산하는 경우. 변경이 드문 테이블에 동일한
ROW_NUMBER()쿼리를 매분 실행한다면, 매번 윈도우 연산을 다시 수행하는 것보다 부분 새로 고침을 사용하는 비동기 구체화된 뷰가 비용이 적게 듭니다.
더 읽어보기
- 분석 함수(윈도우 함수): 예제 풀이를 포함한 전체 가이드
- 윈도우 함수 개요: 구문, 프레임 절, 정렬 순서의 고유성에 관한 주의 사항
LAG,LEAD,ROW_NUMBER,RANK,NTILE: 함수별 참조 페이지- 파이프라인 실행 엔진: 파티션으로 나눈 윈도우를 여러 BE에서 병렬 처리하는 방식
- 벡터화 실행: 각 윈도우의 배치를 SIMD로 가속된 연산자를 통해 실행하는 엔진.
- 비동기 구체화된 뷰: 매분 다시 실행되는 윈도우 결과를 미리 계산하기
- MPP 아키텍처: 윈도우/분석 연산자를 여러 BE에 걸쳐 셔플하고 파티션으로 나누는 방식.