배치 데이터 적재
요약 Apache Doris의 배치 데이터 적재는 S3, HDFS 또는 다른 데이터 웨어하우스의 대용량 파일을 Doris로 한 번에 옮깁니다.
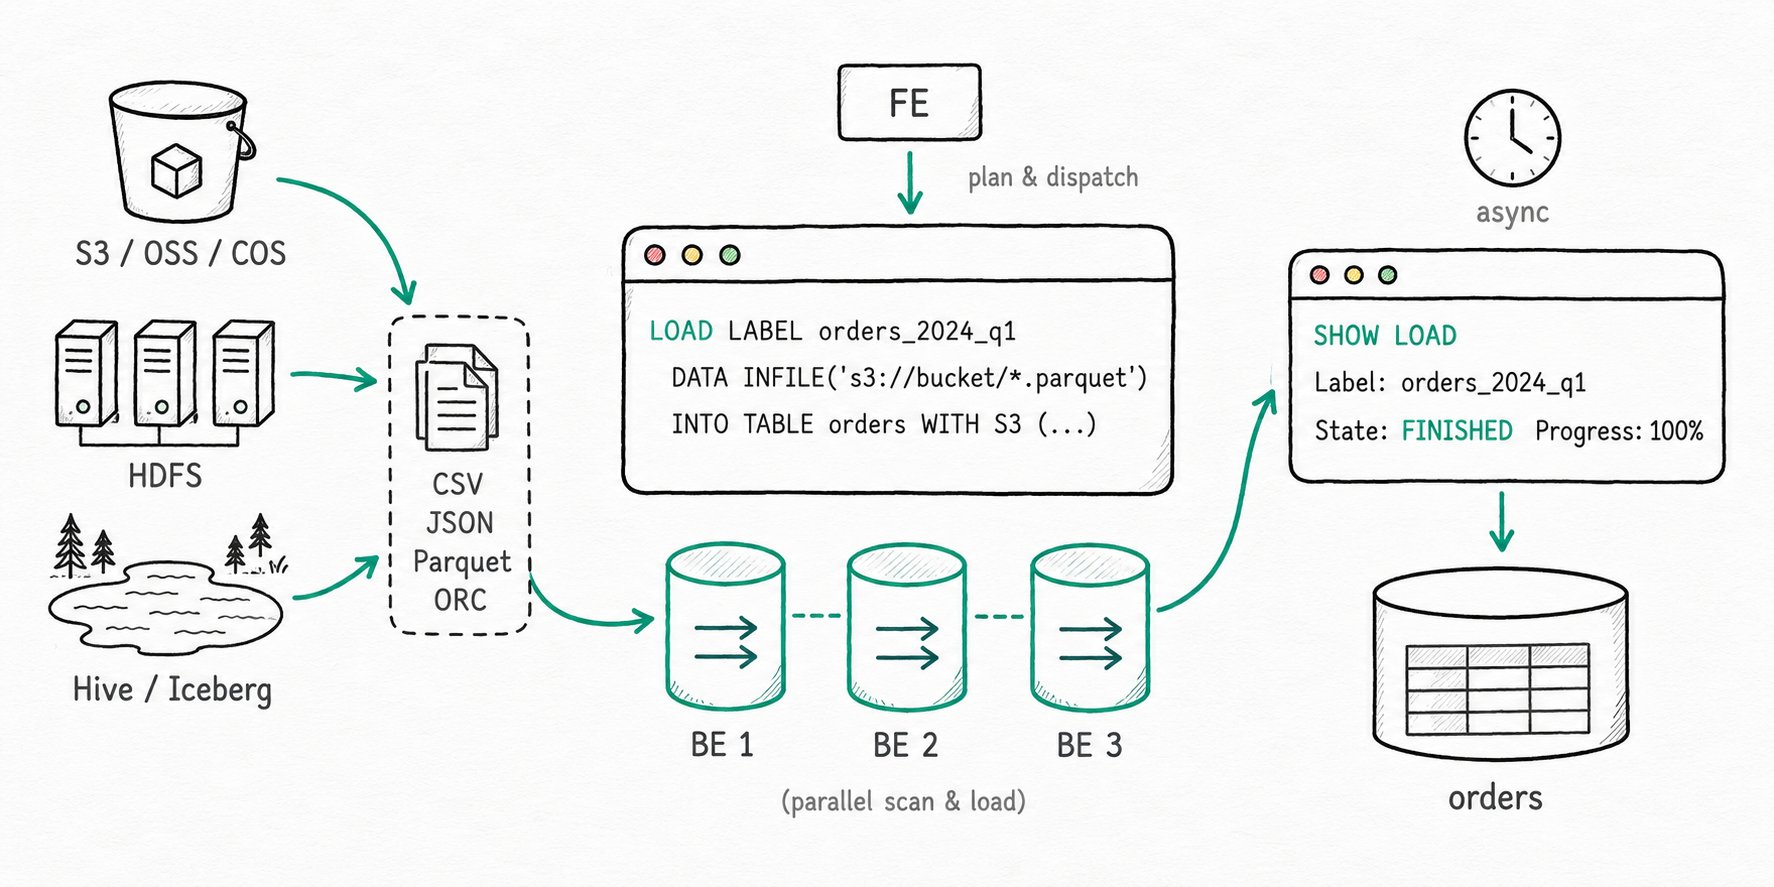
LOAD LABEL문을 제출하면 FE가 작업을 계획하고 여러 BE에 분산하며,SHOW LOAD로 진행 상황을 확인할 수 있습니다. 작업은 비동기로 실행되므로 클라이언트 연결을 종료해도 됩니다. 레이블을 사용해 결과를 찾고 재시도로 인한 중복을 방지할 수 있습니다. 외부 Catalog와 TVF를 통해 데이터를 읽는 경우에는 동기식INSERT INTO ... SELECT형식으로 같은 데이터 적재 요구를 충족하면서 ETL을 더 간단하게 구성할 수 있습니다.
Apache Doris에서 배치 데이터 적재를 사용하는 이유는 무엇인가요?
Apache Doris의 배치 데이터 적재는 단일 데이터 적재 작업에 몇 시간씩 걸리고, 클라이언트 대신 데이터 웨어하우스가 작업의 수명 주기를 관리해야 할 때 적합합니다. 이벤트가 조금씩 유입될 때는 실시간 데이터 적재 도구가 적합하지만, TB 규모의 과거 데이터를 옮기거나, Hive 스냅샷으로 팩트 테이블을 다시 구축하거나, S3의 Parquet 파일로 지난 분기 데이터를 백필해야 할 때는 한계에 부딪힙니다. HTTP를 사용하는 Stream Load는 시간 초과가 발생합니다. 행마다 INSERT를 실행하면 며칠이 걸릴 수 있습니다. 작업은 서버에서 실행되고 자체적으로 재시도할 수 있어야 하며, 클라이언트 연결이 끊겨도 계속 실행되어야 합니다.
- 야간 ETL은 아침 대시보드가 새로 고쳐지기 전에 S3의 수백 GB에 달하는 Parquet 데이터를 적재해야 합니다.
- Snowflake 또는 Hive에서 마이그레이션할 때는 열별 필터와 타입 캐스팅을 적용하면서 파티션 전체를 복사해야 합니다.
- 누락된 하루치 데이터를 백필하는 작업 때문에 작업을 제출한 연결이 계속 대기해야 해서는 안 됩니다.
배치 데이터 적재는 대량 데이터 적재를 데이터 웨어하우스가 처음부터 끝까지 관리하고 레이블로 추적하는 장기 실행 작업으로 처리하여 이 세 가지 요구를 모두 충족합니다.
Apache Doris의 배치 데이터 적재란 무엇인가요?
Apache Doris의 배치 데이터 적재는 Doris에서 제공하는 비동기 대량 데이터 적재 방식의 집합입니다. 주요 진입점은 LOAD LABEL ... WITH S3|HDFS|BROKER 문으로, 과거에는 Broker Load라고 불렸으며 현재는 S3, HDFS 및 Broker 프로세스를 통해 접근할 수 있는 모든 스토리지 시스템을 지원합니다. 동기식 INSERT INTO ... SELECT 방식은 소스가 외부 Catalog(Hive, Iceberg, JDBC)이거나 S3() 또는 HDFS() 같은 TVF로 접근하는 파일일 때 동일한 데이터 적재 요구를 충족합니다. 두 방식 모두 Doris의 다른 데이터 적재 방식과 동일한 트랜잭션 모델을 사용합니다. 작업마다 레이블 하나를 사용하며, 원자적으로 커밋하고 복제본 단위로 버전을 게시합니다.
주요 용어
LOAD LABEL: 비동기 Broker Load를 실행하는 SQL 진입점입니다. 레이블은 데이터베이스 단위로 관리되며 재시도로 인한 중복을 제거합니다.WITH S3/WITH HDFS/WITH BROKER: 스토리지 백엔드를 선택하는 접근 절입니다.S3와HDFS는 BE에 내장되어 있으며,BROKER broker_name은 그 외 스토리지에 접근할 때 외부 Broker 프로세스를 거치도록 합니다.SHOW LOAD: 상태, 진행 상황, 오류 URL, 파싱된EtlInfo를 제공하는 FE 측 뷰입니다.- TVF(Table-Valued Function):
S3(...),HDFS(...),LOCAL(...),iceberg_meta(...)등이 해당합니다. 파일이나 외부 메타데이터를 테이블로 노출하므로SELECT로 조회한 뒤INSERT INTO ... SELECT에 전달하여 동기식 데이터 적재를 수행할 수 있습니다. max_filter_ratio: 작업별로 형식이 잘못된 행을 허용하는 비율입니다. 기본적으로 잘못된 행을 하나도 허용하지 않으므로, 잘못된 행이 하나만 있어도 데이터 적재가 취소됩니다.
Apache Doris의 배치 데이터 적재는 어떻게 동작하나요?
Apache Doris의 배치 데이터 적재는 FE에 레이블이 지정된 작업을 등록하고, 여러 BE에서 파일을 병렬로 스캔하며, 모든 복제본이 새 버전을 게시하면 결과를 원자적으로 커밋합니다.
- 제출 및 레이블 등록.
LOAD LABEL my_db.daily_orders ...요청이 FE에 도착합니다. FE는 레이블을 등록하고 트랜잭션을 시작하며, 데이터 적재 작업은PENDING상태가 됩니다. 보존 기간 내에 같은 레이블을 다시 제출하면 기존 작업으로 바로 처리됩니다. - 계획 및 작업 분산. FE는 파일 크기를 추정하고(BE 하나가 처리하는 크기는
min_bytes_per_broker_scanner와max_bytes_per_broker_scanner사이이며, 기본값은 64 MB에서 500 GB), 작업을 나눈 뒤 BE에 스캐너 작업을 배분합니다. 작업은LOADING상태로 진행됩니다. - 병렬 읽기 및 쓰기. 각 BE는 자신에게 할당된 소스 데이터를 S3, HDFS 또는 Broker를 통해 가져오고, CSV/JSON/Parquet/ORC를 파싱하며,
SET표현식,WHERE필터 또는COLUMNS FROM PATH추출을 적용한 뒤 대상 태블릿에 세그먼트를 씁니다. 형식이 잘못된 행은max_filter_ratio계산에 포함되며, 오류 행 샘플은 URL 필드에서 확인할 수 있습니다. - 커밋 및 게시. 모든 BE가 응답하면 FE가 트랜잭션을 커밋합니다. 각 복제본에
PublishVersion작업이 전송됩니다. 모든 복제본이 확인하면 작업은FINISHED상태가 되고 해당 행을 쿼리할 수 있습니다. 이 과정의 어느 단계에서든 실패하면 작업은CANCELLED상태가 되고 데이터는 폐기됩니다. - SHOW LOAD로 확인.
SHOW LOAD WHERE LABEL = ...는State,Progress,EtlInfo(스캔한 행 수, 필터링된 행 수, 오류가 발생한 행 수)를 제공하며, 문제가 발생한 경우 오류 URL도 제공합니다.
INSERT INTO target SELECT * FROM s3(...) 형식은 동일한 형태의 실행 계획을 사용하지만 동기식으로 실행됩니다. 데이터 적재가 끝날 때까지 연결을 유지해야 하며, 그 대신 결과를 즉시 확인하고 SQL 수준에서 작업을 조합할 수 있습니다(조인, 타입 캐스팅, 소스로 조건자 푸시다운).
빠른 시작
LOAD LABEL testdb.orders_2024_q1
(
  DATA INFILE("s3://my-bucket/orders/2024-q1/*.parquet")
  INTO TABLE orders
  FORMAT AS "parquet"
  (order_id, customer_id, amount, order_date)
)
WITH S3 (
  "provider"      = "S3",
  "AWS_ENDPOINT"  = "https://s3.us-west-2.amazonaws.com",
  "AWS_REGION"    = "us-west-2",
  "AWS_ACCESS_KEY" = "<ak>",
  "AWS_SECRET_KEY" = "<sk>"
)
PROPERTIES ("timeout" = "3600", "max_filter_ratio" = "0.01");
예상 결과
+----------+--------------------+----------+------------------+--------+
| JobId    | Label              | State    | Progress         | Type   |
+----------+--------------------+----------+------------------+--------+
| 41326624 | orders_2024_q1     | FINISHED | ETL:100%;LOAD:100% | BROKER |
+----------+--------------------+----------+------------------+--------+
SHOW LOAD ORDER BY CreateTime DESC LIMIT 1은 작업이 FINISHED 상태가 되면 결과를 반환합니다. 형식이 잘못된 행은 최대 1%까지 허용됩니다. 이 비율을 초과하면 작업이 취소되며, URL 필드에서 문제가 있는 행의 샘플을 확인할 수 있습니다.
Apache Doris의 배치 데이터 적재는 언제 사용해야 하나요?
객체 스토리지, 외부 데이터 웨어하우스 또는 Hive 파티션 디렉터리에서 한 번에 수십 GB 이상의 데이터를 적재할 때 Apache Doris의 배치 데이터 적재를 사용하세요.
적합한 경우
- S3, HDFS, OSS, COS, OBS 또는 S3 호환 스토리지에서 대용량 CSV, JSON, Parquet, ORC 파일을 주기적으로 적재하는 경우.
- Hive, Iceberg, Snowflake 또는 BigQuery에서 일회성 마이그레이션을 수행하는 경우. Catalog와
INSERT INTO ... SELECT를 함께 사용하면 소스 측 프로젝션과 푸시다운을 적용할 수 있습니다. - 작업당 수십 GB에서 수백 GB에 달하는 데이터를 백필해야 하며, 클라이언트가 몇 시간씩 연결을 유지할 수 없는 경우.
- 서버 측
WHERE필터링,SET을 통한 열 변환 또는COLUMNS FROM PATH AS를 사용한 파일 경로의 파티션 필드 추출이 필요한 데이터 적재. - 단일 문에서 와일드카드(
*,?,{1..10})로 Hive 파티션 디렉터리를 매칭하는 경우.
적합하지 않은 경우
- Kafka에서 데이터를 지속적으로 적재하는 경우. Routine Load를 사용하면 FE가 컨슈머와 오프셋을 관리합니다.
- 마이크로서비스에서 이벤트마다 JDBC로 데이터를 쓰는 경우. 작은 페이로드에 작업별 커밋 오버헤드가 낭비됩니다. 이 경우 Group Commit을 사용하세요.
- 클라이언트 컴퓨터의 로컬 파일에서 데이터를 적재하는 경우. Broker Load는 원격 스토리지에서만 데이터를 읽으므로,
Stream Load또는 Doris Streamloader가 적합합니다. - 단일 작업의 크기가 수 TB를 초과하는 경우. 4시간의 기본 제한 시간이 문제가 될 수 있고, 재시도 비용이 크며, 일부만 실패해도 배치 전체를 다시 처리합니다. 입력을 날짜나 디렉터리별로 나눠 여러 작업으로 제출하세요.
- S3에서 새로 추가된 파일을 지속적으로 가져오는 경우. 매일 밤 Broker Load를 실행하는 방식은 적합하지만, 매분 폴링하는 방식은 적합하지 않습니다. Streaming Job 연속 데이터 적재를 사용하면 FE가 이미 적재한 파일을 추적합니다.
추가 자료
- Stream Load: 규모가 작은 실시간 배치를 위한 동기식 HTTP 데이터 적재 경로입니다.
- Group Commit: 빈도가 높은 소규모 배치를 서버에서 병합하는 방식입니다.
- Broker Load 참조: 전체 SQL 기능, Kerberos 및 HDFS HA 구성, 시나리오별 예제를 다룹니다.
- INSERT INTO Select: TVF와 Catalog를 활용하는 흐름을 포함한 동기식 데이터 적재 방식입니다.
- 데이터 적재 개요의 선택 기준표: 실시간, 스트리밍, 배치 시나리오별로 적합한 방식을 안내합니다.
- Catalog 및 TVF 시작하기:
S3(),HDFS()등이 파일을 쿼리 가능한 테이블로 노출하는 방식을 설명합니다. - 데이터 적재 트랜잭션: 배치 데이터 적재가 Doris의 다른 데이터 적재 방식과 공유하는 레이블, 수명 주기 상태, 원자적 커밋 모델을 설명합니다.
- BROKER LOAD SQL 참조: 공식 구문과 모든 옵션을 설명합니다.