BM25 관련도 점수 산정
요약 Apache Doris는 Lucene과 Elasticsearch가 사용하는 점수 산정 알고리즘인 BM25로 전문 검색 결과의 순위를 매깁니다. SELECT에
score()를 추가하고, WHERE 절에MATCH_*조건식을 유지한 다음,ORDER BY로 점수를 기준으로 정렬하고LIMIT로 결과 수를 제한하면 됩니다. Apache Doris 플래너는 top-K 계산을 역색인으로 푸시다운하여 관련도가 가장 높은 행부터 반환합니다.
Apache Doris에서 BM25 점수 산정을 사용하는 이유는 무엇인가요?
Apache Doris의 BM25 점수 산정은 SQL 내에서 전문 검색의 일치 결과를 순위가 매겨진 top-K 결과로 변환합니다. 따라서 백만 행 규모의 문서 집합에서도 별도의 검색 엔진 없이 가장 적합한 검색 결과 열 개를 반환할 수 있습니다. 동등 조건 필터는 어떤 행이 일치하는지 알려줍니다. 하지만 어떤 행이 잘 일치하는지는 알려주지 않습니다. 백만 행 규모의 로그 테이블에서 WHERE content MATCH_ANY 'apache doris real-time analytics'와 같은 쿼리를 실행하면 일치 결과가 50,000개나 나올 수 있지만, 사용자는 가장 적합한 열 개만 원합니다. 관련도 점수가 없으면 데이터베이스가 그 열 개를 적절히 선택하기 어렵습니다.
- 날짜순으로 정렬하면 작년에 작성된 완벽한 일치 결과가 뒤로 밀립니다.
- 임의의 컬럼으로 정렬하면 무작위 결과를 제공하게 됩니다.
- 애플리케이션에서 관련도를 계산하면 데이터 웨어하우스 위에 검색 엔진의 절반을 직접 구현하는 셈입니다.
BM25는 SQL 내에서 이 문제를 해결합니다. Apache Doris는 쿼리 용어가 해당 행에 얼마나 자주 등장하는지, 테이블 전체에서 해당 용어가 얼마나 드문지, 행의 텍스트가 얼마나 긴지를 기준으로 일치하는 각 행에 점수를 부여합니다. 이 점수로 정렬하면 SELECT만으로 검색 엔진 방식의 순위가 매겨진 결과를 얻을 수 있습니다.
Apache Doris의 BM25 점수 산정이란 무엇인가요?
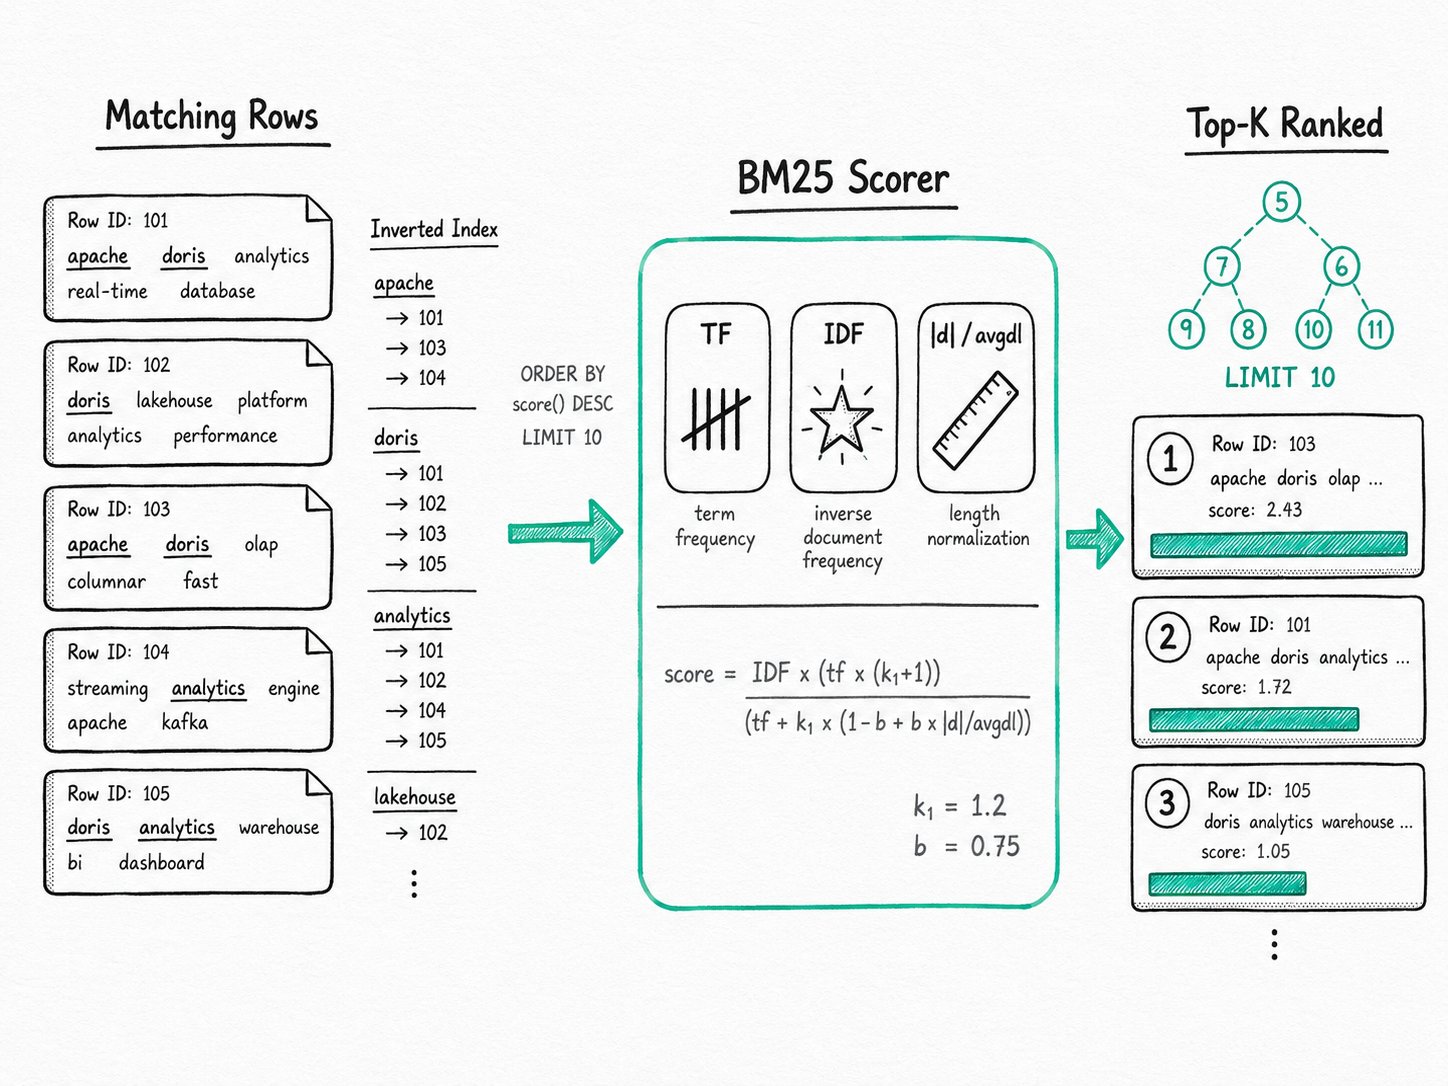
Apache Doris의 BM25 점수 산정은 TF-IDF 계열의 관련도 순위 함수인 BM25(Best Matching 25)를 SQL에서 사용할 수 있도록 구현한 기능입니다. 이 함수는 쿼리 용어와 문서를 받아 양수를 반환하며, 값이 클수록 관련도가 높습니다. 점수는 세 가지 요소로 결정됩니다. 해당 용어가 더 자주 등장하는 행은 더 높은 점수를 받습니다. 드문 용어에는 흔한 용어보다 더 높은 가중치가 부여됩니다. 또한 긴 행의 점수는 낮아지도록 정규화되므로, 같은 내용을 담고 있을 때 200단어로 된 행이 20단어로 된 행보다 무조건 높은 점수를 받지는 않습니다.
Apache Doris는 score() SQL 함수를 통해 BM25를 제공합니다. 역색인에는 수식에 필요한 용어 빈도, 문서 빈도, 필드 길이가 이미 저장되어 있으므로, 인덱스가 있으면 점수 산정을 위해 추가로 스캔할 필요가 없습니다.
주요 용어
score(): 쿼리의MATCH_*조건식에 대한 현재 행의 BM25 관련도 점수를 반환하는 Apache Doris 스칼라 함수입니다.FLOAT를 반환합니다.- TF(용어 빈도): 쿼리 용어가 해당 행에 등장하는 횟수입니다.
- IDF(역문서 빈도): 테이블 전체에서 해당 용어가 얼마나 드문지를 나타내는 척도입니다. 흔한 단어는 낮은 점수를, 드문 단어는 높은 점수를 받습니다.
k1과b: BM25의 조정 상수입니다. Apache Doris는 Lucene 기본값인k1 = 1.2와b = 0.75를 사용합니다. 현재는 세션 변수로 제공되지 않습니다.
Apache Doris의 BM25 점수 산정은 어떻게 동작하나요?
Apache Doris는 역색인 리더 내부에서 BM25를 계산합니다. 플래너가 score() + MATCH_* + ORDER BY + LIMIT 형태를 인식하면 BE는 포스팅을 스캔하면서 행의 점수를 계산하고, 크기가 LIMIT로 제한된 최소 힙이 top-K만 유지합니다.
- 역색인이 통계를 기록합니다. 토큰화된 역색인이 있는 컬럼에 데이터를 적재하면(
english,standard,chinese등의 파서 사용), Apache Doris는 용어 사전, 행별 용어 빈도, 필드 길이를 저장합니다.MATCH_*필터링에 사용되는 통계가 BM25 계산에도 사용됩니다. - 플래너가 점수 산정 형태를 인식합니다. 쿼리의 SELECT에
score()가 있고, WHERE에MATCH_*조건식이 있으며,ORDER BY score()와LIMIT가 있으면 Nereids는 실행 계획을 재작성하여 top-K 점수 산정을 스토리지 계층으로 푸시다운합니다. 이 형태를 벗어나score()를 사용하면 Apache Doris는score() function requires WHERE clause with MATCH function, ORDER BY and LIMIT for optimization오류와 함께 쿼리를 실패 처리합니다. 이 제약은 십억 행 규모의 테이블에서 실수로 모든 행의 점수를 계산하는 일을 방지하기 위한 것입니다. - BE가 스캔하면서 점수를 계산합니다. 역색인 리더는 각 쿼리 용어의 포스팅을 순회합니다. 각 후보 행에 대해
IDF * (tf * (k1 + 1)) / (tf + k1 * (1 - b + b * |d| / avgdl))를 계산합니다. 여기서|d|는 토큰화된 행의 길이이고,avgdl은 테이블의 평균 길이입니다. 여러 용어가 포함된 쿼리에서는 용어별 점수를 합산합니다. - 힙이 top-K를 유지합니다. BE는 크기가
LIMIT로 제한된 최소 힙을 유지하므로, 일치 결과 전체를 메모리에 보관할 필요가 없습니다. 이는 50,000개 행의 점수를 모두 계산한 후 정렬하는 방식과, 스트리밍으로 점수를 계산하면서 가장 적합한 열 개만 유지하는 방식의 차이입니다. - Apache Doris가 순위가 매겨진 행을 반환합니다. FE는 각 태블릿에서 이미 정렬된 top-K를 병합하여 결과를 반환합니다.
빠른 시작
CREATE TABLE articles (
  id BIGINT,
  content TEXT,
  INDEX idx_content(content) USING INVERTED PROPERTIES("parser" = "english")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'apache doris is a real-time analytics database'),
  (2, 'real-time analytics on streaming data'),
  (3, 'a guide to apache kafka');

SELECT id, content, score() AS relevance
FROM articles
WHERE content MATCH_ANY 'apache doris analytics'
ORDER BY relevance DESC
LIMIT 3;
예상 결과
+----+----------------------------------------------------+-----------+
| id | content                                            | relevance |
+----+----------------------------------------------------+-----------+
|  1 | apache doris is a real-time analytics database     |  1.871290 |
|  2 | real-time analytics on streaming data              |  0.575364 |
|  3 | a guide to apache kafka                            |  0.287682 |
+----+----------------------------------------------------+-----------+
1번 행은 쿼리 용어 세 개 모두와 일치하므로 가장 높은 점수를 받습니다. 2번 행은 드문 용어 하나(analytics)와 일치합니다. 3번 행은 이 문서 집합에서 가장 흔한 용어인 apache와만 일치하므로 가장 낮은 점수를 받습니다. 절대적인 점숫값 자체에는 의미가 없습니다. 중요한 것은 이 결과 집합 안에서의 순서입니다.
Apache Doris의 BM25 점수 산정은 언제 사용해야 하나요?
Apache Doris의 BM25 점수 산정은 top-K 전문 검색 순위 산정과 하이브리드 검색의 텍스트 검색 부분에 적합합니다. 정확히 일치하는 값 조회, 관련도에 대한 집계, 서로 다른 쿼리 간 점수 비교에는 적합하지 않습니다.
적합한 경우
- 로그, 문서, 기사, 상품 설명 등 토큰화된 역색인이 있는 텍스트 컬럼에서 top-K 전문 검색을 수행하는 경우.
- 하이브리드 검색 쿼리의 텍스트 관련도 검색 결과를 SQL
ORDER BY또는 RRF를 통해 벡터 유사도와 결합하는 경우. - Doris에 이미 저장된 데이터에서 일치 결과의 순위만 매기기 위해 운영하던 별도의 Elasticsearch 클러스터를 대체하려는 경우.
- 여러 용어가 포함된 쿼리에서 사용자가 단순히 일치하는 결과가 아니라 가장 적합한 결과를 원하는 경우.
적합하지 않은 경우
- 정확히 일치하는 값 조회. 토큰화되지 않은 역색인은 점수를 계산하지 않습니다.
=또는IN을 사용하고score()는 사용하지 마세요. - 점수가 산정된 결과에 대한 집계. Apache Doris는
score()를GROUP BY내부나 집계 함수 내부에서 사용하거나,ORDER BY score() LIMIT가 없는 실행 계획에서 사용하는 것을 허용하지 않습니다. 관련도에 대한 분석이 필요하면 먼저 top-K 결과를 구체화한 다음 해당 결과 집합을 집계하세요. - 쿼리 간 점수 비교. BM25는 문서 집합과 쿼리에 따라 달라집니다. 한 쿼리의 점수 3.0과 다른 쿼리의 점수 3.0은 서로 다른 의미를 가집니다. 대신 RRF와 같은 순위 기반 융합 방식을 사용하세요. Reciprocal Rank Fusion을 참고하세요.
- 쿼리별
k1과b조정. Apache Doris는 Lucene의 기본값을 사용하며, 현재는 이를 런타임 매개변수로 제공하지 않습니다. 워크로드에 사용자 지정 조정이 꼭 필요하다면 직접 만든 점수 산정 방식으로 우회하기보다는 이슈를 등록하세요. - 순수 벡터 순위 산정. 쿼리가 "키워드 제약 없이 가장 가까운 임베딩 10개 찾기"라면 ANN 거리 함수를 사용하고 BM25는 사용하지 마세요.