컬럼형 스토리지
핵심 요약 모든 Apache Doris OLAP 테이블은 데이터를 컬럼 지향 Segment 파일에 기록합니다. 각 컬럼에는 개별 인코딩(PLAIN, dictionary, RLE, bit-shuffle, frame-of-reference)이 적용되고, 각 페이지는 독립적으로 압축됩니다(기본값은 LZ4이며 ZSTD도 선택 가능). 페이지별 zone map과 bloom filter를 사용하면 쿼리가 페이지를 디코딩하지 않고도 건너뛸 수 있으며, 4.1에서 추가된 V3 푸터는 컬럼 수가 많은 테이블의 세그먼트 열기 지연 시간을 16배 단축합니다.
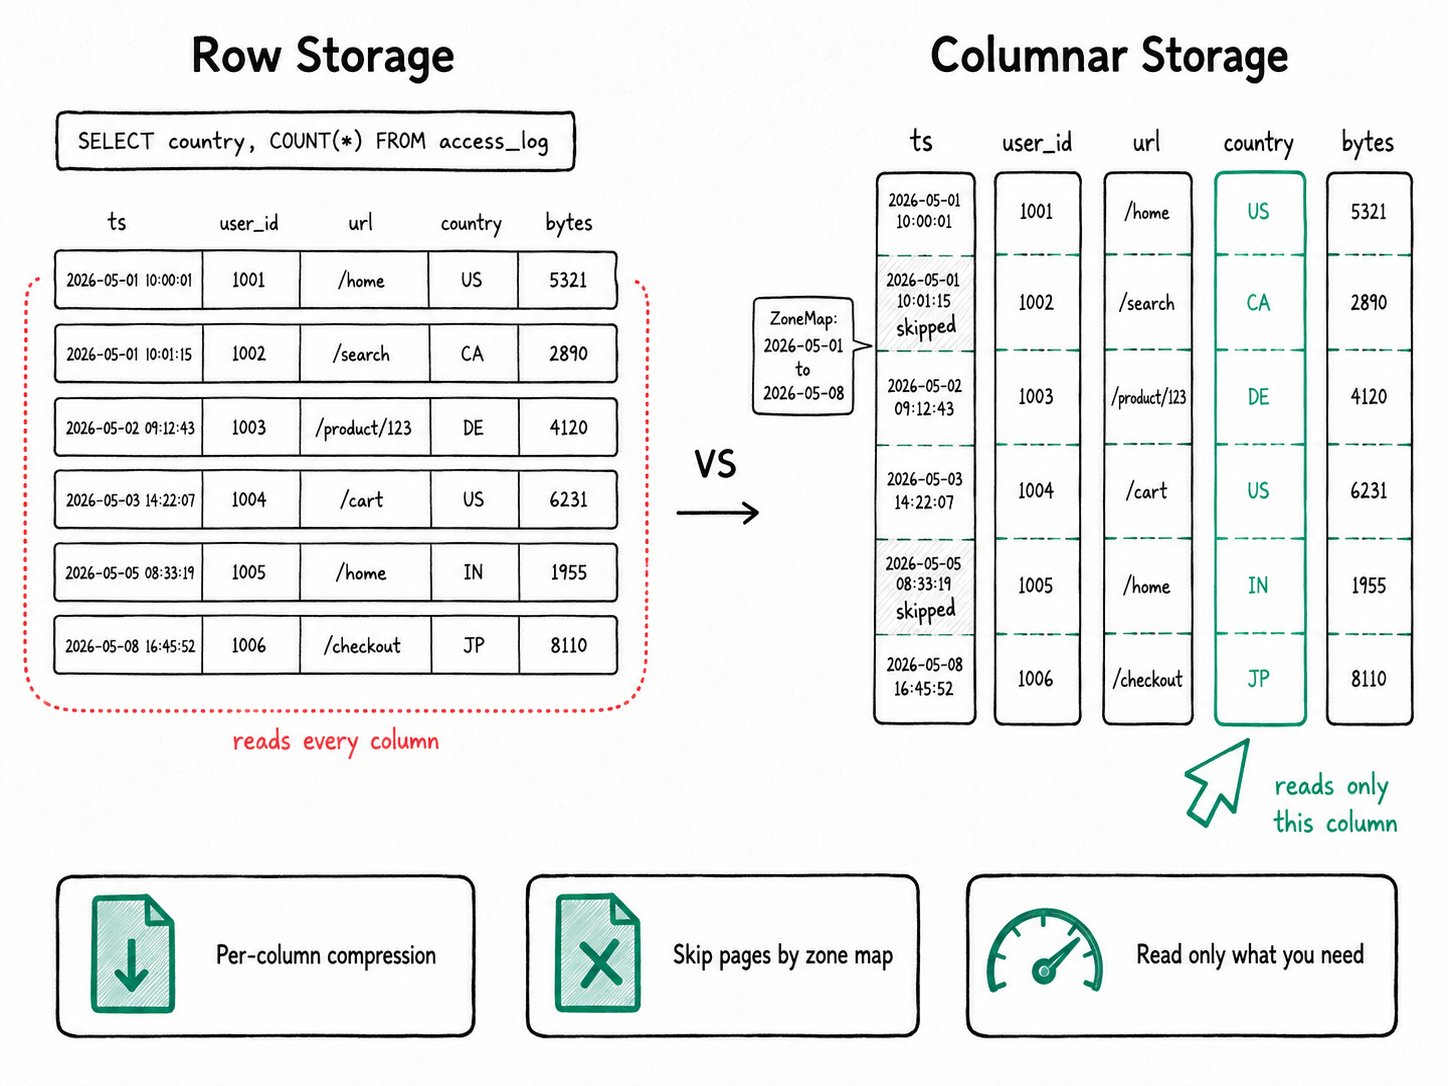
Apache Doris에서 컬럼형 스토리지를 사용하는 이유는 무엇인가요?
Apache Doris는 모든 OLAP 테이블을 컬럼 지향 Segment 파일에 저장합니다. 컬럼형 구조는 쿼리가 참조하는 컬럼만 읽도록 I/O를 줄이고, 각 컬럼에 가장 효과적인 코덱을 적용할 수 있게 하며, 스킵 인덱스를 저장하기에도 적합하기 때문입니다. 행 지향 스토리지에서 분석 작업을 실행하면 곧바로 세 가지 문제가 드러납니다.
- 컬럼이 50개인 테이블에서
GROUP BY country를 실행해도 나머지 49개 컬럼의 바이트까지 읽습니다. I/O 비용은 쿼리가 참조하는 컬럼의 폭이 아니라 행 전체의 폭에 비례합니다. - 압축 효율이 낮습니다. 인접한 행에 서로 관련 없는 데이터 타입이 섞여 있어 dictionary, run-length, delta 코덱이 활용할 만한 패턴이 없습니다.
- 데이터를 건너뛰기 어렵습니다. "이 64 KB 블록에는
ts >= '2026-05-01'조건을 만족하는 행이 없다"는 것을 알려면 컬럼별 통계가 필요하지만, 행 지향 구조에는 이를 저장할 적절한 위치가 없습니다.
컬럼 지향 구조는 이 세 가지 문제를 모두 해결합니다. 같은 컬럼의 값이 디스크에 모여 있으므로 코덱이 데이터 타입에 맞는 변환을 선택할 수 있습니다. 또한 페이지 인덱스가 있어 읽기 프로세스는 압축을 해제하기 전에 조건자를 검사할 수 있습니다.
Apache Doris 컬럼형 스토리지란 무엇인가요?
Apache Doris 컬럼형 스토리지는 모든 OLAP 테이블(Duplicate, Unique, Aggregate)이 공통으로 사용하는 디스크상의 세그먼트 파일 형식입니다. 데이터 적재 작업마다 하나 이상의 Segment 파일이 생성됩니다. 세그먼트 안에서 쓰기 프로세스는 각 컬럼을 독립적으로 처리합니다. 값을 약 64 KB 크기의 페이지에 순차적으로 채우고, 각 페이지를 인코딩하고 압축한 뒤 스킵 인덱스도 함께 기록합니다. 파일 끝의 푸터는 이 모든 요소의 위치를 가리킵니다.
주요 용어
Segment: 디스크에 저장되는 불변 데이터 단위로, 매직 바이트D0R1로 식별합니다. 기본값은 페이지 64 KB, 딕셔너리 페이지 256 KB, 세그먼트 크기 상한 256 MB입니다.be/src/storage/segment/segment.h에 정의되어 있습니다.Page: 한 컬럼의 값 일부를 담는 단위입니다. 압축과 zone map 통계가 모두 이 단위로 적용됩니다.Encoding: 압축 전에 컬럼별로 적용하는 변환입니다. PLAIN은 일반 수치형 데이터, DICT는 카디널리티가 낮은 문자열, RLE은 불리언, BIT_SHUFFLE은 정수 컬럼, FOR (frame-of-reference)는 날짜, BINARY_PLAIN_V2는 V3의 문자열에 사용합니다.Page indexes: ordinal index, short key index, zone map(페이지별 min/max와 has-null), bloom filter를 말합니다. 모두 데이터와 함께 세그먼트에 기록됩니다.Footer: 파일 끝에 있는 protobuf 레코드로, 모든 컬럼과 인코딩, 페이지 포인터, 인덱스 위치를 기술합니다. V3 (4.1+)는 컬럼 메타데이터를 외부로 분리하여 컬럼 수가 많은 세그먼트를 열 때 모든 메타데이터를 읽을 필요가 없게 합니다.
Apache Doris 컬럼형 스토리지는 어떻게 동작하나요?
Apache Doris는 세그먼트 안에서 각 컬럼을 독립적으로 기록합니다. 인코딩하고, 약 64 KB 크기의 페이지로 나누고, 압축하고, 인덱스를 만든 뒤 푸터를 기록합니다. 한 컬럼이 디스크에 기록되고 읽히는 과정은 다음과 같습니다.
- 인코딩. 쓰기 프로세스는 컬럼의 데이터 타입과 값 분포를 바탕으로 인코딩을 선택합니다. 카디널리티가 낮은
INT컬럼에는 bit-shuffle을 적용하고, 고유 값이 적은 문자열 컬럼에는 별도의 dict 페이지에 딕셔너리를 만듭니다. - 페이지 구성 및 압축. 인코딩된 값을 각각 약 64 KB 크기의 페이지에 순차적으로 채웁니다. 각 페이지에는 기본적으로 LZ4F를 적용하며, 테이블의
compression설정에 따라 ZSTD / Snappy / Zlib를 적용할 수도 있습니다. 절감률이 10% 미만이면 압축을 건너뜁니다. - 인덱스 생성. 페이지를 기록하면서 세그먼트에는 ordinal index(행 번호로 이진 검색), 페이지별 zone map(min, max, has-null), 그리고
bloom_filter_columns에 지정된 컬럼의 bloom filter도 기록합니다. short key index는 테이블 정렬 키의 접두부를 요약합니다. - 푸터 기록. 쓰기 프로세스는 모든 컬럼과 페이지 포인터, 인덱스를 기술하는
SegmentFooterPB를 끝에 추가합니다. V3는 이를 둘로 나눕니다. 하나는 간결한 푸터이고, 다른 하나는 쿼리가 실제로 참조하는 컬럼에 대해서만 읽어 들이는column_meta_entries영역입니다. - 읽기. 스캔은 푸터를 열고, ordinal / short key / zone map / bloom으로 읽을 범위를 좁힌 다음, 남은 페이지의 압축만 해제합니다. 이어서 페이지를 디코딩하고 컬럼 단위 배치를 벡터화 엔진에 바로 전달합니다.
세그먼트를 포함한 계층 구조는 Tablet → Rowset → Segment → Column → Page입니다. 컴팩션은 rowset을 병합하지만 그보다 작은 단위로 다시 쓰지는 않습니다. 모든 쿼리는 그 아래의 컬럼과 페이지 구조에서 데이터를 읽습니다.
빠른 시작
CREATE TABLE access_log (
  ts DATETIME,
  user_id BIGINT,
  url VARCHAR(512),
  country CHAR(2)
)
DUPLICATE KEY(ts, user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "compression" = "zstd",
  "bloom_filter_columns" = "url",
  "storage_format" = "V3"
);

SELECT country, COUNT(*) AS hits
FROM access_log
WHERE ts >= '2026-05-01'
GROUP BY country
ORDER BY hits DESC;
예상 결과
+---------+--------+
| country | hits   |
+---------+--------+
| US      | 184320 |
| DE      |  62018 |
| ...     |        |
+---------+--------+
이 쿼리는 ts와 country 컬럼만 읽습니다. 읽기 프로세스는 압축을 해제하기 전에 zone map이 max(ts) < 2026-05-01임을 나타내는 페이지를 건너뜁니다. ZSTD를 사용하면 일반적으로 테이블 크기가 5배에서 10배 줄어들며, V3 푸터는 컬럼 수가 늘어나도 세그먼트를 여는 비용을 일정하게 유지합니다.
Apache Doris 컬럼형 스토리지는 언제 사용해야 하나요?
Apache Doris 컬럼형 스토리지는 기본이자 유일한 OLAP 형식이므로 모든 분석용 테이블에서 사용합니다. 장단점을 따져야 하는 경우는 높은 QPS의 단건 조회나 코덱 조정 같은 특수한 상황뿐입니다.
적합한 경우
- Apache Doris에서 사용하는 모든 분석용 테이블. 컬럼형 스토리지는 선택 사항이 아니라 기본이자 유일한 OLAP 형식입니다.
- 컬럼 수가 많은 테이블과 대시보드 쿼리. 테이블의 컬럼 수가 많고 쿼리가 참조하는 컬럼이 적을수록 행 지향 스토리지보다 더 큰 절감 효과를 얻습니다.
- 데이터 적재가 잦은 테이블. 같은 스키마에 행이 더 많이 쌓일수록 컬럼별 압축과 페이지별 zone map의 효과가 모두 좋아집니다.
- 수천 개의 컬럼이 있는 테이블.
"storage_format" = "V3"(4.1+)를 설정하면 세그먼트 열기 지연 시간과 메모리 사용량이 과도하게 늘어나는 것을 막을 수 있습니다.
적합하지 않은 경우
- 수천 QPS로 실행하는 기본 키 기반
SELECT *조회. 각 컬럼을 별도로 읽으므로 컬럼 수가 많은 행의 단건 쿼리는 N배의 I/O 비용을 치릅니다. 고동시성 포인트 쿼리 경로를 사용하세요. 이 경로는 Unique-Key Merge-on-Write 테이블에"store_row_column" = "true"를 설정하여 행 캐시 컬럼을 추가합니다. - 프로파일링 없이
compression이나storage_page_size를 조정하는 경우. 기본값(LZ4F, 64 KB)은 대부분의 워크로드에 적합합니다. CPU보다 스토리지 비용이 더 중요할 때만 ZSTD로 전환하고, 작은 컬럼 때문에 불필요한 압축 해제 작업이 발생할 때만 페이지 크기를 줄이세요. - "원시 컬럼을 보기 위해" 인코딩을 비활성화하는 경우. 원시 모드는 없습니다. 코덱은 벗겨 낼 수 있는 계층이 아니라 파일 형식의 일부입니다.
- 행 지향 스키마에서 적은 컬럼을 읽는 단건 조회의 해결책으로 컬럼형 스토리지를 사용하는 경우. 모든 쿼리가
WHERE id = ?이고 행 하나를 반환한다면, 다른 압축 코덱이 아니라 다른 시스템이나 행 스토리지 확장이 필요합니다.
성능 / 수치
- 컬럼 수가 많은 테이블의 V3 푸터: 컬럼 7,000개와 세그먼트 10,000개가 있는 테이블에서 세그먼트를 여는 시간이 65초에서 4초로 줄었고(16배 빨라짐), 열 때 사용하는 메모리는 60 GB에서 1 GB 미만으로 줄었습니다(60배 감소). 출처: 스토리지 형식 V3.
- ZSTD와 이전 기본값 비교: 25 GB / 110백만 줄 규모의 텍스트 로그 데이터 세트에서 압축률이 거의 10배에 달했습니다. 이전 기본값보다 53% 개선되었으며, 읽기와 압축 해제를 합친 전체 처리 속도는 30% 빨라졌습니다. 출처: Apache Doris 1.1.0 릴리스 노트.
더 읽어보기
- 스토리지 형식 V3: 컬럼 수가 많은 테이블의 푸터 최적화와 컬럼별 메타데이터의 외부 분리.
- 데이터 프루닝: 세그먼트 내부의 ZoneMap, BloomFilter, 페이지별 인덱스가 스캔 시 데이터를 건너뛰는 데 활용되는 방식.
- 벡터화 실행: 컬럼 읽기 프로세스가 디코딩한 배치를 전달하는 엔진.
- VARIANT 데이터 타입: JSON 경로가 이 문서에서 설명한 것처럼 컬럼별로 인코딩되고 페이지로 나뉘며 인덱스가 생성되는 하위 컬럼으로 승격되는 방식.
- Apache Doris 1.1.0 릴리스 노트: 최초의 ZSTD 압축 벤치마크와 도입 관련 안내.