컴퓨트 그룹
요약 Apache Doris 컴퓨트 그룹은 스토리지-컴퓨트 분리 모드에서 Resource Group에 해당하는 기능입니다. BE 노드를 이름이 있는 그룹으로 나누고 사용자에게 접근 권한을 부여한 다음 각 세션을 그룹에 바인딩하면, 해당 그룹의 BE만 쿼리를 처리합니다. 스토리지(S3, OSS, COS, HDFS)를 공유하므로 그룹을 추가할 때 복제본 비용 없이 컴퓨트 비용만 발생합니다. 한 그룹 내의 BE 장애는 다른 그룹에 영향을 주지 않으며, 그룹 전체를 해제해도 데이터는 그대로 유지됩니다.
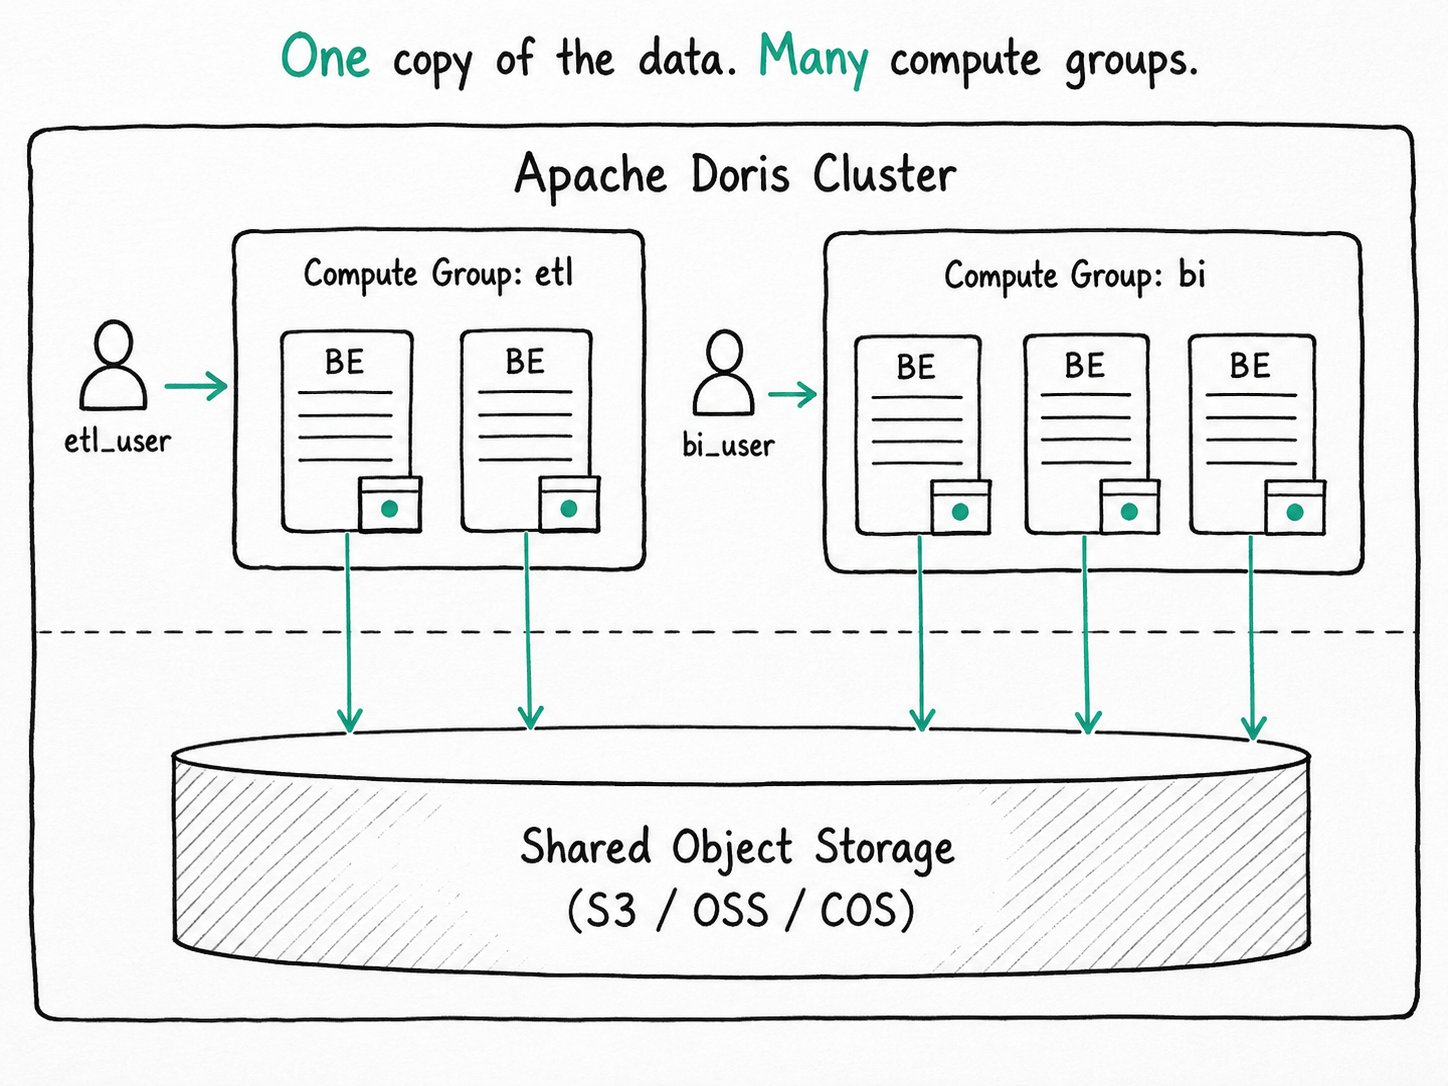
Apache Doris 컴퓨트 그룹을 사용하는 이유는 무엇인가요?
Apache Doris 컴퓨트 그룹은 모든 그룹이 동일한 공유 오브젝트 스토리지에서 데이터를 읽기 때문에 스토리지 용량을 늘리지 않고도 BE 수준에서 워크로드를 격리할 수 있습니다. Resource Group은 컴퓨트-스토리지 통합 모드에서 BE 수준의 격리를 제공하지만, 그만큼 스토리지 비용이 듭니다. 다섯 그룹이 모두 같은 테이블을 읽어야 한다면 해당 테이블의 복제본도 다섯 개가 필요합니다. 새 테넌트 두 개가 추가되면 복제본 할당을 다시 구성해야 합니다. 내일 배치 작업을 실행할 임시 풀을 만들려 해도 먼저 데이터를 이동해야 합니다.
스토리지-컴퓨트 분리 배포에서 BE는 무상태입니다. 성능을 높이기 위해 자주 사용하는 태블릿을 로컬에 캐시하지만, 원본 데이터는 공유 오브젝트 스토리지에 있습니다. 따라서 BE 집합을 추가할 때는 컴퓨트 비용과 콜드 캐시로 인한 초기 비용만 발생합니다. 데이터를 읽는 컴퓨트 그룹이 아무리 많아도 데이터의 논리적 사본은 하나뿐입니다.
컴퓨트 그룹은 이러한 구조를 워크로드 격리에 활용하는 기능입니다. Resource Group과 같은 방식으로 BE를 그룹으로 나누지만, 그룹 수가 늘어나도 스토리지 예산은 그에 비례해 늘어나지 않습니다. 데이터 적재 시간대에 ETL 풀을 가동하고, 데이터 적재의 영향을 받지 않는 별도 풀에서 BI를 실행한 뒤, 자정에 그룹을 해제할 수 있습니다. 이 과정에서 데이터는 이동하지 않습니다.
Apache Doris 컴퓨트 그룹이란 무엇인가요?
Apache Doris 컴퓨트 그룹은 스토리지-컴퓨트 분리(클라우드) 모드의 노드 수준 격리 단위입니다. 각 BE는 이름으로 식별되는 하나의 컴퓨트 그룹에만 속합니다. 모든 그룹이 동일한 오브젝트 스토리지 매니페스트를 기반으로 하므로, 그룹을 추가한다는 것은 복제본을 추가하는 것이 아니라 컴퓨트와 워밍업이 필요한 캐시를 추가하는 것입니다. Workload Group은 컴퓨트 그룹 내부에서 동작하며, 그 안에서 실행되는 쿼리 간에 CPU와 메모리를 나눕니다.
주요 용어
tag.compute_group_name: 백엔드를 추가할 때 설정하는 BE 측 속성입니다. 생략하면 기본값은default_compute_group입니다.default_compute_group: 새 세션에서 사용할 컴퓨트 그룹을 지정하는 사용자별 속성입니다.SET PROPERTY FOR '<user>' 'default_compute_group' = '<name>'으로 설정합니다.USE @<group>: 현재 연결에서 활성 그룹을 변경하는 세션별 전환 명령입니다. 데이터베이스 이름과 함께 사용할 수도 있습니다(USE my_db@<group>).USAGE_PRIV ON COMPUTE GROUP: 접근 권한입니다.GRANT USAGE_PRIV ON COMPUTE GROUP <name> TO <user>로 부여합니다. 이 권한이 없으면 사용자는 해당 그룹을 선택할 수 없습니다.- 파일 캐시: 자주 사용하는 태블릿 블록을 BE 로컬에 저장하는 캐시입니다. 새 그룹은 캐시가 비어 있는 상태로 시작하며, 캐시가 충분히 채워질 때까지 캐시 미스가 발생할 때마다 오브젝트 스토리지와의 왕복 통신 비용을 치릅니다.
Apache Doris 컴퓨트 그룹은 어떻게 동작하나요?
Apache Doris 컴퓨트 그룹은 등록 시 각 BE에 태그를 지정하고, 특정 사용자에게 USAGE_PRIV를 부여하며, 기본 속성 또는 USE @<group>을 통해 세션을 그룹에 바인딩합니다. 모든 그룹이 공유 오브젝트 스토리지를 사용하는 가운데, 쿼리 프래그먼트는 해당 그룹의 BE에만 배치됩니다.
- 등록 시 BE에 태그를 지정합니다.
ALTER SYSTEM ADD BACKEND 'host:9050' PROPERTIES ("tag.compute_group_name" = "etl")은 백엔드를etl그룹에 추가합니다. 이 속성을 생략하면 BE는default_compute_group에 속합니다. MetaService는 이 할당 정보를 영구 저장하며,SHOW COMPUTE GROUPS로 그룹 구성을 확인할 수 있습니다. - 접근 권한을 부여합니다. 일반 사용자는 기본적으로 어떤 컴퓨트 그룹에도 접근할 수 없습니다.
GRANT USAGE_PRIV ON COMPUTE GROUP etl TO 'etl_user'를 실행해야 해당 그룹을 선택할 수 있습니다. 관리자 사용자는 모든 그룹을 볼 수 있습니다. - 기본 그룹을 바인딩합니다.
SET PROPERTY FOR 'etl_user' 'default_compute_group' = 'etl'을 설정하면 새 세션이 자동으로 지정된 그룹을 사용합니다. 변경 사항을 적용하려면 사용자가 다시 연결해야 합니다. - 필요에 따라 전환합니다.
USE @bi는 현재 세션의 활성 컴퓨트 그룹을 변경합니다. 여러 그룹에 대한 접근 권한이 있는 DBA나 사용자 기본 그룹과 다른 풀이 필요한 임시 쿼리에 유용합니다. - 계획을 수립하고 실행합니다. 쿼리 플래너는 선택한 그룹의 BE에만 프래그먼트를 배치합니다. 각 BE는 공유 스토리지에서 데이터를 읽으며, 반복되는 읽기 요청은 로컬 파일 캐시가 처리합니다. 캐시 미스가 발생하면 네트워크 요청을 수행하며, 쿼리 실패로 이어지지는 않습니다.
- 자유롭게 확장하거나 축소합니다.
ALTER SYSTEM ADD BACKEND ...로 그룹을 확장하고,ALTER SYSTEM DECOMMISSION BACKEND ...로 축소합니다. 이동할 복제본이 없으므로 태블릿 리밸런싱을 기다릴 필요가 없습니다.
빠른 시작
-- Add stateless BEs into two compute groups
ALTER SYSTEM ADD BACKEND 'be1:9050' PROPERTIES ("tag.compute_group_name" = "etl");
ALTER SYSTEM ADD BACKEND 'be2:9050' PROPERTIES ("tag.compute_group_name" = "bi");
ALTER SYSTEM ADD BACKEND 'be3:9050' PROPERTIES ("tag.compute_group_name" = "bi");

-- Grant access
GRANT USAGE_PRIV ON COMPUTE GROUP etl TO 'etl_user';
GRANT USAGE_PRIV ON COMPUTE GROUP bi  TO 'bi_user';

-- Set defaults (the user has to reconnect for new defaults to apply)
SET PROPERTY FOR 'etl_user' 'default_compute_group' = 'etl';
SET PROPERTY FOR 'bi_user'  'default_compute_group' = 'bi';

-- One-off switch for the current session
USE my_db@bi;
SELECT region, SUM(amount) FROM orders WHERE dt = CURRENT_DATE() GROUP BY region;
예상 결과
+------+-----------+-------+----------+
| Name | IsCurrent | Users | Backends |
+------+-----------+-------+----------+
| etl  | false     | 1     | 1        |
| bi   | true      | 1     | 2        |
+------+-----------+-------+----------+
SHOW COMPUTE GROUPS로 구성을 확인할 수 있습니다. 집계는 be2와 be3에서만 실행됩니다. ETL과 BI는 오브젝트 스토리지의 동일한 orders 데이터를 공유하지만, BE와 로컬 캐시는 공유하지 않습니다. be1을 해제하면 etl 그룹은 비게 되지만 데이터는 그대로 유지됩니다.
Apache Doris 컴퓨트 그룹은 언제 사용해야 하나요?
Apache Doris 컴퓨트 그룹은 워크로드 격리, 읽기/쓰기 분리 또는 피크/비피크 시간대에 따른 탄력적인 컴퓨트 조정이 필요한 스토리지-컴퓨트 분리 클러스터에 적합합니다. 통합 배포나 그룹 간 쿼리에는 적합하지 않습니다.
적합한 경우
- 추가 복제본 비용 없이 워크로드를 격리해야 하는 스토리지-컴퓨트 분리 클러스터.
- 읽기/쓰기 분리: 공유 오브젝트 스토리지의 단일 사본을 사용하면서 쓰기 그룹을 통해 데이터를 적재하고 읽기 그룹에서 쿼리합니다. 읽기 성능을 유지하는 워밍업 방법은 파일 캐시 모범 사례를 참조하세요.
- 피크/비피크 시간대에 따른 탄력적인 컴퓨트 조정: 업무 시간에 그룹을 추가하고 야간에 해제하며, 어느 쪽도 데이터 이동이 필요하지 않습니다.
- 각 테넌트가 전용 컴퓨트 풀을 사용하면서 스토리지 비용은 일정하게 유지해야 하는 멀티테넌트 클러스터.
- 각 컴퓨트 그룹 내부의 CPU와 메모리를 Workload Group으로 세분화하는 경우. 생성 시 적용되는 범위 지정은 Workload Group 바인딩을 참조하세요.
적합하지 않은 경우
- 컴퓨트-스토리지 통합 배포. 공유 오브젝트 스토리지가 없으므로 이에 해당하는 기능은 Resource Group입니다.
- 그룹 간 쿼리. Resource Group과 마찬가지로, 하나의 쿼리가 두 컴퓨트 그룹의 BE를 함께 사용할 수는 없습니다. 세션마다 적절한 그룹을 선택하세요.
- 콜드 캐시로 인한 성능 저하를 감당할 수 없는 워크로드. 새로 만든 그룹은 파일 캐시가 비어 있어 첫 쿼리에서 모든 데이터를 오브젝트 스토리지로부터 읽습니다. 트래픽이 유입되기 전에
WARM UP COMPUTE GROUP <target> WITH COMPUTE GROUP <source>를 사용해 캐시를 미리 채우세요. - 생성 후 Workload Group을 다른 컴퓨트 그룹에 다시 바인딩해야 하는 경우. Workload Group은 하나의 컴퓨트 그룹 안에 생성되며 이동할 수 없습니다. 바인딩을 변경하려면 삭제한 후 다시 생성해야 합니다.
- 데이터 쓰기까지 부수적으로 격리되기를 기대하는 경우. 읽기는 선택한 그룹의 BE로 제한되지만, 쓰기 경로는 최종적으로 공유 스토리지 계층에 데이터를 영구 저장하므로 과도한 데이터 적재는 여전히 스토리지 대역폭에 부담을 줄 수 있습니다.
추가 자료
- 컴퓨트 그룹 참조: 전체 SQL 기능, 권한 모델 및
USE @group전환 규칙. - 컴퓨트 그룹 관리: 읽기-읽기, 읽기-쓰기, 쓰기-쓰기 격리 패턴의 운영 절차와 기존 "compute cluster" 명칭에 대한 참고 사항.
- Workload Group 바인딩: Workload Group의 범위를 하나의 컴퓨트 그룹으로 지정하는 방법과 자동 생성되는
normal그룹 관련 규칙. - Resource Group: 통합 모드에서 이에 해당하는 기능으로, 복제본이 늘어나는 데 따른 비용이 있습니다.
- Workload Group: 일반적으로 컴퓨트 그룹과 함께 사용하는 프로세스 내부 계층.
- 읽기/쓰기 분리를 위한 파일 캐시 모범 사례: 쓰기가 다른 곳에서 이루어져도 쿼리 그룹의 성능을 유지하는 워밍업 전략.
- MPP 아키텍처: shared-nothing 실행 모델로, BE를 추가할 때마다 프래그먼트 인스턴스 슬롯도 하나씩 늘어납니다.