Condition Cache
요약 Apache Doris Condition Cache는 각 세그먼트에서
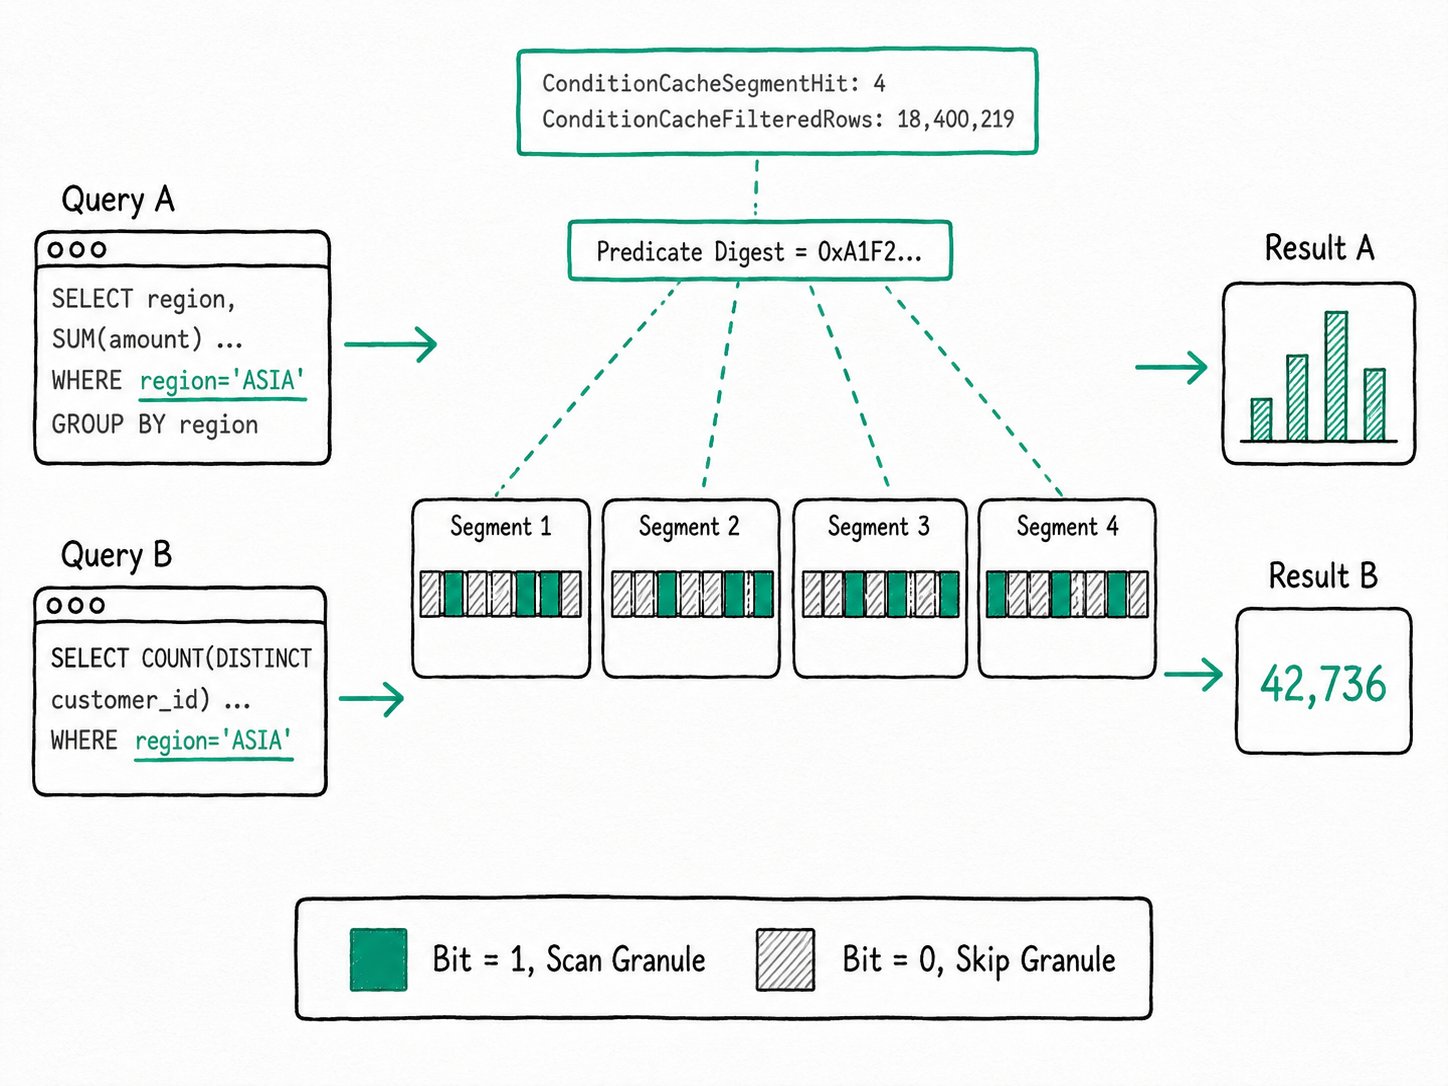
WHERE절을 평가한 결과를(predicate digest, key range)를 키로 하는 압축 비트 벡터로 저장합니다. 다음 쿼리가 같은 세그먼트에 같은 필터를 사용하면, SELECT 목록, GROUP BY 또는 집계가 달라도 비트 벡터에서 일치하는 행이 없다고 이미 확인된 그래뉼을 건너뜁니다. 다섯 개의 대시보드 패널이 모두WHERE region = 'ASIA' AND order_date >= '2023-01-01'을 공유하면, 해당 필터를 세그먼트마다 한 번만 평가하고 모든 패널에서 결과를 재사용합니다.
Apache Doris Condition Cache를 사용하는 이유는 무엇인가요?
Apache Doris Condition Cache는 WHERE 절은 같지만 나머지는 서로 다른 쿼리 간에 프레디케이트 평가 결과를 재사용하여 SQL Cache와 Query Cache 사이의 공백을 메웁니다. 대부분의 분석 워크로드에서는 집계보다 필터링 작업이 훨씬 많습니다. 단일 orders 테이블을 기반으로 만든 대시보드에는 WHERE region = ? AND order_date >= ?을 공유하면서 SELECT 목록만 다른 패널이 열 개 있을 수 있습니다. 애플리케이션 백엔드는 몇 초마다 집계를 바꾸면서 같은 프레디케이트를 다시 실행합니다. T+1 보고서는 어젯밤 이후 변경되지 않은 파티션에 대해 서로 다른 집계를 실행합니다.
클러스터는 이러한 쿼리 각각에 대해 프레디케이트 평가 비용을 지불합니다. 컬럼을 읽고, 디코딩하고, 비교를 수행하고, 행 마스크를 만든 다음 실행 계획의 나머지 작업을 진행합니다.
SQL Cache는 SQL 텍스트가 바이트 단위로 동일할 때 유용하지만, SELECT 목록이 바뀌는 순간 사용할 수 없습니다. Query Cache는 태블릿 전체를 공유하는 집계 쿼리에 유용합니다. 하지만 WHERE는 공유하면서 SELECT 목록은 다른 경우에는 어느 쪽도 도움이 되지 않습니다.
Apache Doris Condition Cache는 이 둘 사이에서 프레디케이트 평가 단계를 세그먼트 수준으로 캐싱합니다. 쿼리가 해당 행으로 어떤 작업을 수행하는지와는 별개로 동작합니다.
Apache Doris Condition Cache란 무엇인가요?
Apache Doris Condition Cache는 프레디케이트 평가 결과를 세그먼트별로 그래뉼 수준의 비트 벡터에 저장하는 BE 측 캐시입니다. 세그먼트 스캔이 시작되면 BE는 프레디케이트 표현식과 세그먼트의 키 범위에서 64비트 다이제스트를 계산한 뒤 캐시를 조회합니다. 캐시에 적중하면 비트가 0인 모든 그래뉼을 건너뛰고 비트가 1인 그래뉼만 스캔합니다. 캐시 미스가 발생하면 평소처럼 프레디케이트를 평가하고 결과 비트 벡터를 캐시에 저장합니다.
이 캐시는 프로젝션, 집계, 조인, 정렬과 독립적으로 동작합니다. WHERE 절이 동일한 두 쿼리는 한쪽이 SELECT *를 실행하고 다른 쪽이 SELECT COUNT(DISTINCT customer_id)를 실행하더라도 캐시 항목을 공유합니다.
주요 용어
enable_condition_cache: 세션 변수입니다. 기본적으로 활성화되어 있으며, 특정 쿼리나 세션에서 사용하지 않으려면false로 설정합니다.- 세그먼트(Segment): 태블릿 내부의 쓰기가 완료된 파일입니다. 세그먼트는 한 번 기록되면 변경되지 않으며, 컴팩션은 기존 세그먼트를 수정하는 대신 새 세그먼트를 생성합니다. 이러한 불변성 덕분에 캐시를 안전하게 사용할 수 있습니다.
- 그래뉼(Granule): 세그먼트 내부의 2048행 블록입니다. 비트 벡터는 행마다 하나가 아니라 그래뉼마다 하나의 비트를 저장합니다.
- 프레디케이트 다이제스트(Predicate digest): AND로 결합된 프레디케이트와 세그먼트의 키 범위를 함께 해싱한 64비트 해시입니다. 의미가 같은 프레디케이트는 동일한 다이제스트를 생성합니다.
condition_cache_limit: BE별 캐시 메모리 상한이며, 단위는 MB입니다. 기본값은1024입니다.be.conf에서 설정합니다.
Apache Doris Condition Cache는 어떻게 동작하나요?
Apache Doris Condition Cache는 AND로 결합된 각 프레디케이트와 세그먼트의 키 범위를 함께 해싱하여 64비트 다이제스트를 생성합니다. 그런 다음 BE별 LRU 캐시에서 다이제스트를 조회하고, 저장된 비트가 0인 모든 그래뉼을 건너뜁니다.
- 다이제스트 생성(BE). 스캔 연산자가 세그먼트에서 시작되면 AND로 결합된 프레디케이트와 세그먼트의 키 범위를 정규화하여 64비트 다이제스트를 생성합니다. SELECT 목록, GROUP BY, 집계는 프레디케이트에 영향을 주지 않으므로 이들이 달라도 동일한 다이제스트가 생성됩니다.
- 세그먼트별 조회. BE는 샤딩된 LRU 캐시에서
(digest, segment_id)를 조회합니다. 세그먼트에 삭제 마커가 있거나 실행 시점에 TopN 런타임 필터가 프레디케이트를 구성한 경우, BE는 캐시 조회를 건너뛰고 일반 스캔을 수행합니다. - 캐시 적중 시. 스캔은 비트 벡터를 읽고, 비트가
0인 모든 그래뉼을 건너뛰며, 비트가1인 그래뉼에 대해서만 컬럼을 디코딩합니다. 해당 그래뉼에 행 수준 필터를 적용하여 실제로 일치하는 행을 확인합니다. - 캐시 미스 시. 스캔은 평소처럼 프레디케이트를 평가하면서 비트 벡터를 만들고,
(digest, segment_id)를 키로 결과를 캐시에 저장합니다. 이후 동일한 다이제스트를 사용하는 쿼리는 캐시에 적중합니다. - 불변성을 통한 무효화. 세그먼트는 변경되지 않습니다. 새로운 INSERT나 컴팩션은 새 ID를 가진 새 세그먼트를 생성하고, 기존 캐시 항목은 시간이 지나면서 LRU에서 자연스럽게 제거됩니다. Apache Doris에는 별도의 명시적 무효화 단계가 필요하지 않습니다.
빠른 시작
SET enable_condition_cache = true;

-- Run 1: misses every segment, builds bit vectors, writes them back
SELECT region, country, SUM(amount)
FROM orders
WHERE region = 'ASIA' AND order_date >= '2023-01-01'
GROUP BY region, country;

-- Run 2: different SELECT, same WHERE; hits the cache on every segment
SELECT COUNT(DISTINCT customer_id)
FROM orders
WHERE region = 'ASIA' AND order_date >= '2023-01-01';
예상 결과(EXPLAIN PROFILE의 실행 2 결과에서 발췌)
ConditionCacheSegmentHit:    42
ConditionCacheFilteredRows:  18,400,219
첫 번째 실행은 모든 세그먼트를 스캔하고 프레디케이트를 평가한 뒤 세그먼트마다 하나의 비트 벡터를 저장합니다. 두 번째 실행은 WHERE가 같으므로 다이제스트도 일치합니다. 모든 세그먼트에서 캐시에 적중하고, BE는 region = 'ASIA' AND order_date >= '2023-01-01'에 일치하는 행이 없다고 이미 확인된 그래뉼을 건너뜁니다.
Apache Doris Condition Cache는 언제 사용해야 하나요?
여러 쿼리가 같은 WHERE 절을 재사용하고 테이블에 쓰기 작업이 지속적으로 몰리지 않는, 읽기 비중이 높은 워크로드에서 Apache Doris Condition Cache를 활성화하세요.
적합한 경우
- 여러 패널이 같은
WHERE를 공유하면서 SELECT 목록이나 집계만 다른 대시보드. - 쓰기가 드물게 발생하는 테이블에 동일한 프레디케이트를 자주 실행하는 애플리케이션 트래픽.
- 어제 데이터 적재가 완료된 파티션에 대해 서로 다른 집계를 실행하는 T+1 보고서.
- 대부분의 그래뉼이
0비트로 표시되어 캐시를 통해 각 세그먼트의 상당 부분을 건너뛸 수 있는, 선택도가 높은 필터.
적합하지 않은 경우
- 쓰기 작업이 지속적으로 많이 발생하는 테이블. 새 세그먼트는 새 다이제스트를 의미하며, 기존 캐시 항목은 재사용되기도 전에 LRU에서 제거됩니다. 집계 형태가 일정한 쿼리에서 결과를 재사용하려면 Query Cache를 사용하세요.
- 삭제 마커가 있는 세그먼트에 접근하는 쿼리. BE는 삭제 동작의 정확성을 유지하기 위해 캐시를 건너뛰므로,
DELETE가 자주 발생하는 워크로드에서는 캐시가 거의 활용되지 않습니다. - 실행 시점에 TopN 런타임 필터가 프레디케이트를 구성하는 쿼리. 아직 지원되지 않습니다.
- 대부분의 행과 일치하는, 선택도가 낮은 필터. 일치하는 그래뉼을 스캔하는 비용은 여전히 발생합니다. 캐시는 일치하는 행이 없다고 이미 확인된 그래뉼에 대한 작업만 줄여 줍니다.
- 다른 쿼리가 재사용하지 않는 일회성 WHERE 절을 사용하는 임시 쿼리. 캐시는 한 번만 읽힌 뒤 서로를 밀어내는 항목으로 채워집니다. 켜 두어도 문제는 없지만 적중률은 계속 낮을 수 있습니다.
- 기본 키를 이용한 조회. 고동시성 포인트 쿼리를 사용하세요.
추가 자료
- Condition Cache 사용자 가이드
- Query Cache: 파이프라인 수준의 부분 집계 캐시
- SQL Cache: 바이트 단위로 동일한 SQL을 위한 결과 수준 캐시
- Doris의 캐싱: 적합한 전략 선택
- Data Cache 및 Page Cache: Condition Cache 아래에서 바이트와 디코딩된 페이지 자체를 캐싱하는 스토리지 계층 캐시입니다.
- Metadata Cache: 데이터 측 캐시를 보완하는 외부 Catalog 메타데이터 캐시입니다.
- MPP 아키텍처: Condition Cache가 실행 계획에 연동되어 이미 평가한 프레디케이트를 건너뛸 수 있도록 하는 실행 모델입니다.