Data Cache 및 Page Cache
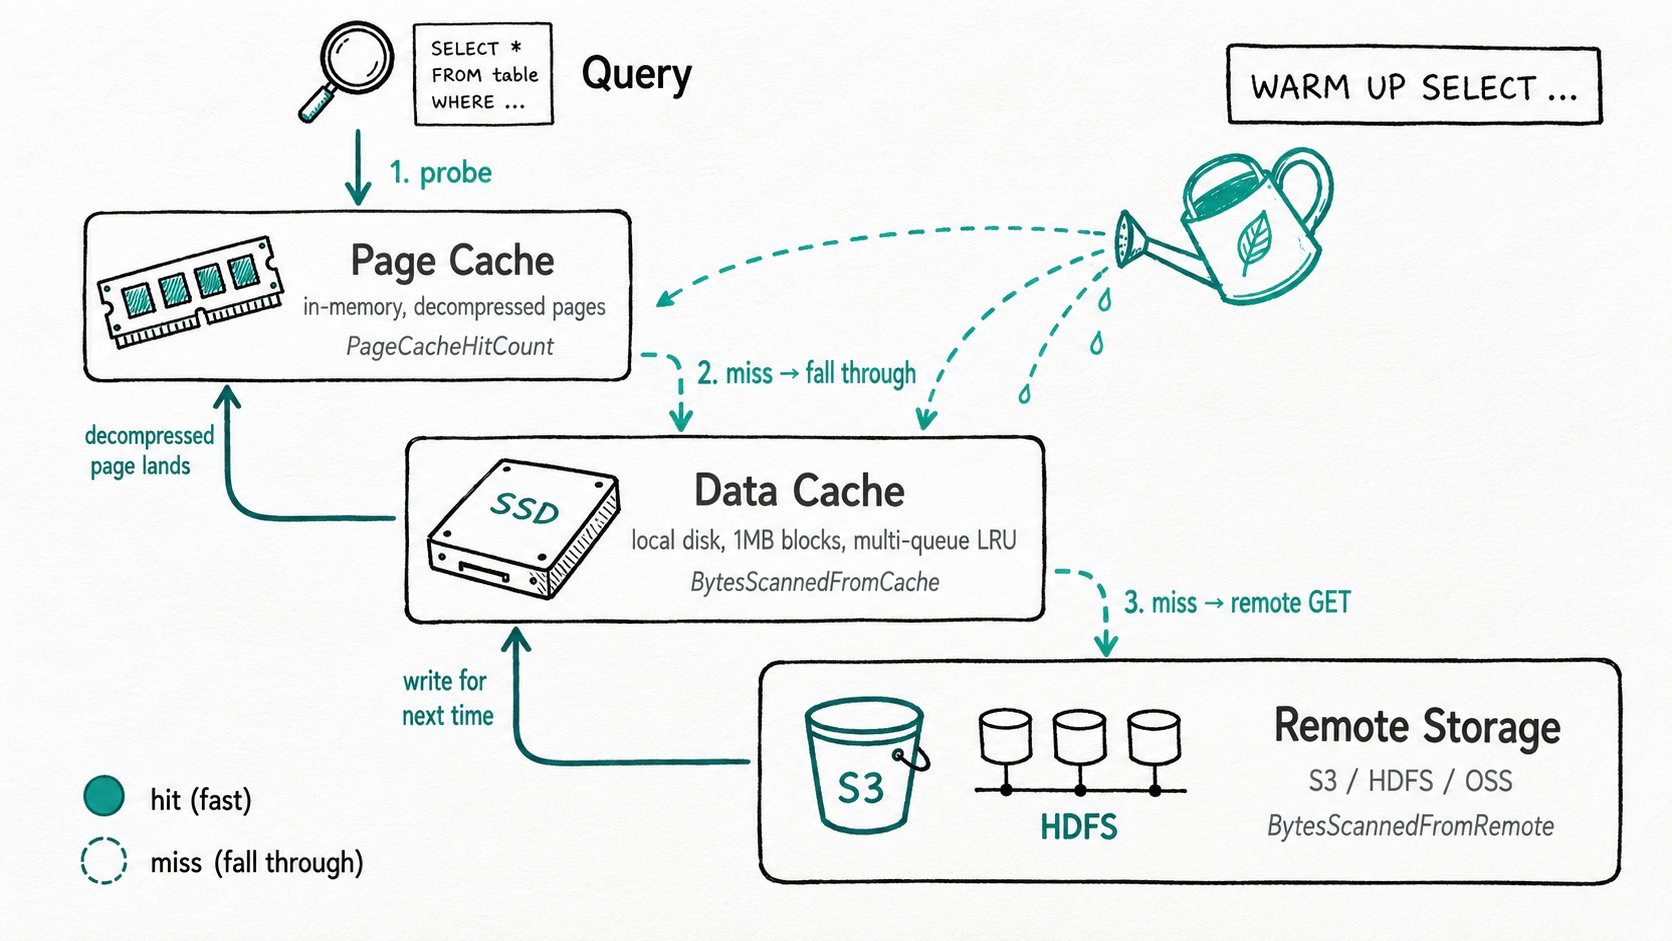
요약 Apache Doris는 두 계층에서 레이크하우스 스토리지를 캐싱합니다. Data Cache는 S3 또는 HDFS에서 읽은 바이트를 BE의 로컬 디스크에 저장하여(1 MB 블록 단위) 반복 스캔 시 네트워크 접근을 생략합니다. Page Cache는 압축 해제된 컬럼 페이지를 메모리에 저장하여 반복 스캔 시 압축 해제와 디코딩도 생략합니다.
WARM UP은 두 캐시를 미리 채워, 캐시가 비어 있는 배포 환경에서도 두 번째 실행은 로컬 디스크 속도로, 세 번째 실행은 RAM 속도로 처리되게 합니다.
Apache Doris에서 Data Cache와 Page Cache를 사용하는 이유는 무엇인가요?
Apache Doris Data Cache와 Page Cache는 자주 사용하는 데이터에 대한 반복적인 네트워크 가져오기와 압축 해제를 없애 레이크하우스 쿼리 지연 시간을 줄입니다. S3에 있는 Hive 또는 Iceberg 테이블을 쿼리하면 모든 바이트에 대해 세 번의 처리 비용이 발생합니다. 가져올 때 한 번(범위 지정 GET마다 발생하는 HTTP 왕복), 압축을 해제할 때 한 번(snappy, zstd, gzip), 디코딩할 때 한 번(RLE, dictionary, plain)입니다. 대개 가장 큰 부담은 가져오기 작업입니다. S3 GET의 꼬리 지연 시간은 30 ms에서 500 ms에 이릅니다. 수천 번의 범위 읽기를 수행하는 Parquet 스캔은 CPU 작업을 시작하기도 전에 전체 경과 시간의 대부분을 HTTP 응답을 기다리는 데 쓸 수 있습니다.
다음과 같은 일반적인 패턴에서 이 문제가 두드러집니다.
- 같은 대시보드가 오 분마다 실행되면서 최근 파티션의 동일한 100 GB 데이터에 접근하고, 실행할 때마다 해당 데이터를 다시 다운로드합니다.
- 클러스터에 BE가 막 추가되면(자동 확장, 교체, 배포), 나머지 클러스터는 밀리초 단위로 응답하는 반면 해당 BE에 도착한 첫 쿼리는 모든 파일을 새로 가져와야 합니다.
- 동시 실행이 많은 보고서가 수십 개의 BE로 분산되어 모두 동일한 핫 파티션을 쿼리하면, CPU보다 객체 스토어의 egress가 클러스터의 병목이 됩니다.
두 캐시는 서로 다른 계층에 위치합니다. Data Cache에 적중하면 네트워크 접근을 생략합니다. Page Cache에 적중하면 네트워크 접근과 압축 해제를 생략하지만, 이전 읽기에서 해당 페이지가 캐시에 채워져 있어야 합니다.
Apache Doris Data Cache와 Page Cache란 무엇인가요?
Apache Doris Data Cache와 Page Cache는 서로 보완하는 두 가지 스토리지 캐시입니다. 하나는 원격 파일의 바이트를 저장하는 BE별 로컬 디스크 캐시이고, 다른 하나는 컬럼 페이지를 저장하는 메모리 캐시입니다.
Data Cache는 원격 파일의 바이트를 저장하는 BE별 로컬 디스크 캐시입니다. Apache Doris BE가 Hive, Iceberg, Hudi 또는 Paimon 테이블에서 Parquet 또는 ORC 파일을 읽으면, 바이트를 1 MB 블록 단위로 가져와 설정된 로컬 디렉터리에 기록합니다. 이후 동일한 오프셋을 읽을 때는 S3 대신 디스크에서 읽습니다.
Page Cache는 컬럼 페이지를 저장하는 메모리 캐시입니다. 두 가지 유형이 있습니다. Storage Page Cache는 Doris 내부 세그먼트에서 압축 해제된 페이지를 캐싱합니다. Parquet Page Cache(4.1+)는 외부 Parquet 파일에 대해 같은 역할을 하며, 압축률에 따라 페이지를 압축된 상태로 보관할지 압축 해제된 상태로 보관할지 판단합니다.
주요 용어
Block: Data Cache의 저장 단위입니다. 기본 크기는 1 MB이며, 디스크의 각(file, offset)쌍에 하나의 블록이 대응합니다.Multi-queue LRU: Data Cache의 퇴거 전략입니다. 일반 데이터, TTL이 설정된 데이터, 인덱스 데이터, 일회성 읽기 데이터를 별도 큐로 관리하므로, 한 번만 수행하는 스캔이 대시보드의 핫 블록을 밀어내지 않습니다.Page: 컬럼 청크 내부의 디코딩 단위입니다. 일반적으로 64 KB에서 1 MB 크기의 값으로 구성되며, RLE/dictionary/plain 방식으로 인코딩됩니다.WARM UP: 백그라운드에서 준비용 스캔을 실행하여 두 캐시 중 하나를 미리 채우는 SQL 구문입니다.Admission control: 특정 쿼리가 Data Cache에 데이터를 기록하도록 허용할지 결정하는 정책으로, 일회성 스캔이 캐시를 오염시키지 않도록 하는 데 사용됩니다.
Apache Doris Data Cache와 Page Cache는 어떻게 작동하나요?
Apache Doris는 모든 레이크하우스 스캔에서 먼저 Page Cache를 확인하고, 그다음 Data Cache를 확인하며, 캐시에 없는 경우에만 S3/HDFS에 접근합니다. 스캔은 아래 순서대로 캐시 계층을 거칩니다.
- Page Cache 조회(메모리). 읽기 작업은 IO를 수행하기 전에 파일 경로, 파일 크기, 오프셋을 키로 사용하여 필요한 컬럼 페이지가 Page Cache에 이미 있는지 확인합니다. 적중하면 바로 디코딩할 수 있는(또는 이미 디코딩된) 바이트를 반환하며, IO와 압축 해제를 모두 생략합니다.
- Data Cache 조회(로컬 디스크). Page Cache에 없으면 파일 리더가 요청한 바이트 범위를 포함하는 1 MB 블록이 Data Cache에 있는지 확인합니다. 적중하면 로컬 NVMe에서 GB/s 속도로 읽습니다. 압축 해제와 디코딩은 여전히 필요하지만, 네트워크 접근은 생략합니다.
- 원격 읽기(S3/HDFS). Data Cache에도 없으면 BE가 객체 스토리지에 범위 지정 GET을 요청하고, 다음에 사용할 수 있도록 1 MB 블록을 로컬 캐시에 기록합니다. 쿼리가 일회성으로 표시되어 있으면 Admission control이 기록을 거부할 수 있습니다.
- 디코딩 + Page Cache 기록. 압축 해제된 페이지는 Page Cache에 저장됩니다. Parquet Page Cache는 각 페이지의
decompressed_size / compressed_size를parquet_page_cache_decompress_threshold(기본값 1.5)와 비교합니다. 임계값보다 낮으면 비용이 적게 드는 압축된 형태로 저장하고, 높으면 압축 해제된 형태로 저장합니다. - 퇴거. 두 캐시 모두 샤딩된 LRU를 사용합니다. Data Cache는 백그라운드 퇴거 루프(
enable_evict_file_cache_in_advance)도 실행하여, 디스크 사용량이 기준선을 넘으면 쿼리가 대기해야 하는 상황이 발생하기 전에 공간을 확보합니다.
WARM UP은 필요할 때 동일한 경로를 거칩니다. 스캔을 실행하고 캐시 적중과 미적중을 기록하며, 행을 반환하지 않고 두 캐시를 미리 채웁니다.
빠른 시작
-- One-time setup on each BE: configure a cache directory.
-- be.conf (enable_file_cache is enabled by default since Doris 4.2):
--   enable_file_cache = true
--   file_cache_path = [{"path":"/data/file_cache","total_size":107374182400}]

-- Per-session toggles (defaults shown):
SET enable_file_cache = true;

-- Pre-populate the Data Cache for today's hot partition.
WARM UP SELECT l_orderkey, l_shipmode
FROM hive_catalog.tpch.lineitem
WHERE l_shipdate = '2026-05-01';

-- Now run the real query: it should hit cache on retries.
SELECT l_shipmode, count(*)
FROM hive_catalog.tpch.lineitem
WHERE l_shipdate = '2026-05-01'
GROUP BY l_shipmode;
예상 결과(프로파일 발췌)
VFileScanNode
  BytesScannedFromCache:   2.02 GB
  BytesScannedFromRemote:  0 B
  PageCacheHitCount:       18432
  PageCacheMissCount:      0
첫 번째 실행은 S3에서 데이터를 가져와 Data Cache를 채웠습니다. 두 번째 실행은 BE의 로컬 디스크를 벗어나지 않고 쿼리에 응답했으며, 압축 해제된 페이지는 RAM에서 제공되었습니다.
Apache Doris Data Cache와 Page Cache는 언제 사용해야 하나요?
레이크하우스의 핫 파티션에 대한 반복 쿼리, 동시 실행이 많은 대시보드, 컴퓨팅 그룹의 탄력적 확장에 Apache Doris Data Cache와 Page Cache를 사용하세요. 작업 데이터 집합이 캐시보다 크거나, 일회성 ETL을 수행하거나, 로컬 IO가 원격 소스보다 빠르지 않은 기계식 디스크를 사용하는 경우에는 사용하지 않는 편이 좋습니다.
적합한 경우
- 핫 파티션에 대한 반복 쿼리(이동 시간 창을 사용하는 대시보드, 일일 보고서).
- 네트워크 또는 egress가 비용의 대부분을 차지하는 S3 또는 HDFS의 레이크하우스 테이블.
- 수십 개의 BE가 동일한 파일에 접근하는 동시 실행이 많은 워크로드. 캐시는 쿼리 처리량이 객체 스토어 처리량에 종속되지 않도록 합니다.
- 컴퓨팅 그룹의 탄력적 확장: 새 컴퓨팅 그룹으로 트래픽을 보내기 전에 기존 그룹의 데이터를 사용하여 캐시를 예열합니다.
- 접근이 편중된 워크로드(파레토 법칙: 파티션의 10%가 쿼리의 90%를 처리).
적합하지 않은 경우
- 캐시보다 큰 작업 데이터 집합. 모든 쿼리가 새로운 데이터에 접근하면 캐시 스래싱이 발생하며, 매번 읽을 때마다 캐시 미적중에 따른 비용을 전부 부담하면서 퇴거에도 CPU를 사용하게 됩니다. 캐시를 늘리거나, 조건식으로 읽기 범위를 좁히거나, 해당 워크로드에서 캐시를 비활성화하세요.
- 일회성 ETL과 백필. 다시 읽지 않을 데이터가 실제로 자주 사용하는 블록을 밀어냅니다. Admission control을 사용하여 이러한 스캔이 캐시에 들어오지 않도록 하거나,
enable_file_cache = false로 실행하세요. - Data Cache의 효과를 기대하며 Doris 내부 테이블을 쿼리하는 경우. Data Cache는 Hive, Iceberg, Hudi, Paimon 파일에만 적용됩니다. 내부 테이블은 이미 Storage Page Cache와 OS 페이지 캐시의 이점을 누리고 있습니다.
- 기계식 디스크. Data Cache는 로컬 IO가 원격 소스보다 확실히 빠르다는 전제하에 동작합니다. HDD에서는 로컬 왕복 시간이 병렬 S3 GET보다 길 수 있습니다. SSD 또는 NVMe를 사용하세요.
- Page Cache에 지나치게 많은 메모리를 할당하는 경우. 메모리의 30–40%를 넘게 할당하면 쿼리 버퍼 풀에 사용할 메모리가 부족해지고 스필이 발생하여, 캐시로 절약하는 비용보다 더 큰 비용이 들 수 있습니다. 기본값인
storage_page_cache_limit = 20%는 대부분의 워크로드에 적절합니다.
더 읽어보기
- Data Cache 레퍼런스:
WARM UP SELECT, 쿼리별 제한, Admission control을 포함한 전체 기능을 설명합니다. - File Cache(컴퓨팅과 스토리지 분리): 클라우드 모드에서 동일한 메커니즘을 내부 태블릿에 적용합니다.
- Parquet Page Cache 및 기타 레이크하우스 튜닝: 외부 Parquet 파일을 위한 압축 해제된 페이지의 메모리 캐시를 설명합니다.
- Parquet 리더 최적화: 처음부터 어떤 바이트를 요청할지 결정하는 리더를 설명합니다. 캐시와 프루닝은 함께 사용할 수 있습니다.
- Query Cache 및 Condition Cache: 스토리지 캐시 위에 위치하는 결과 수준 및 조건식 수준의 캐시입니다.
- WARM UP 문: 여러 컴퓨팅 그룹에 걸쳐 캐시를 미리 채우는 SQL 구문을 설명합니다.
- Iceberg: 페이지 캐시의 주요 활용 대상입니다. Iceberg 스캔은 S3 방식의 객체 스토리지를 통해 원격 Parquet 파일을 읽습니다.