데이터 Compaction
핵심 요약 Apache Doris에서는 데이터를 적재할 때마다 새로운 불변 rowset이 생성됩니다. Apache Doris compaction은 이러한 rowset을 백그라운드에서 병합하여 쿼리가 수백 개의 버전을 확인할 필요가 없도록 합니다. 두 가지 정책(
size_based와time_series)에 vertical compaction과 segment compaction을 함께 활용하면 테이블별로 쓰기 증폭과 읽기 증폭 사이의 균형을 조정할 수 있습니다.
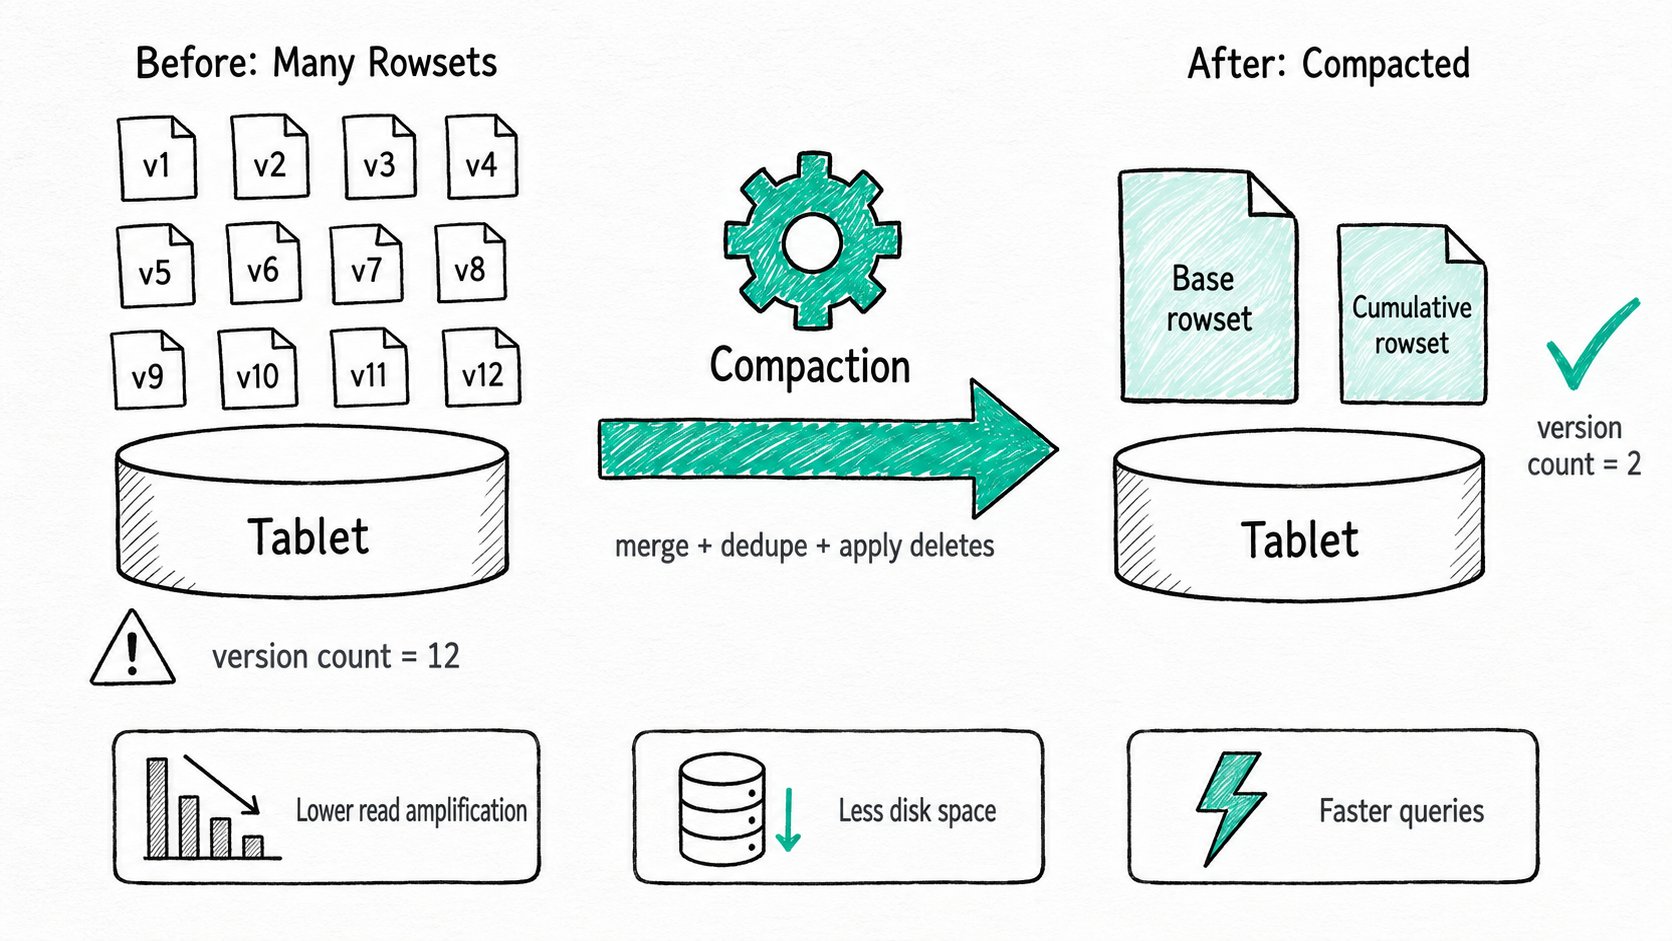
Apache Doris compaction을 사용하는 이유는 무엇인가요?
Apache Doris compaction은 쓰기 작업마다 생성되는 불변 rowset을 병합하여, 데이터 적재가 빈번한 환경에서도 빠른 쿼리 성능을 유지합니다. 버전이 누적되어 골치 아픈 -235 데이터 적재 오류로 이어지기 전에 이를 처리합니다. Apache Doris는 LSM tree와 같은 방식으로 데이터를 저장합니다. 쓰기 작업은 기존 파일을 직접 갱신하지 않고, 완전히 새로운 rowset으로 저장됩니다. 따라서 정리 작업이 수행될 때까지 tablet의 rowset 수는 계속 늘어납니다. Stream Load와 Group Commit처럼 데이터 적재가 빈번한 경로에서는 특히 빠르게 증가합니다. Compaction이 없으면 다음과 같은 문제가 발생합니다.
- tablet의 버전 수가
max_tablet_version_num(기본값 500)을 초과하면 데이터 적재가 -235 오류와 함께 실패합니다. 이는 Doris 사용자 메일링 리스트에 가장 자주 보고되는 운영 환경 장애 중 하나입니다. - 모든 쿼리가 실행 중에 tablet의 모든 rowset을 병합해야 합니다. rowset이 5개에서 50개로 늘어나면, 상자 하나만 살펴보던 조회가 상자 쉰 개를 살펴보는 조회로 바뀌는 셈입니다.
- 삭제된 행이 tombstone으로 남고, 작은 파일은 저장한 데이터보다 메타데이터에 더 많은 공간을 사용합니다.
Apache Doris compaction은 이 세 가지 문제를 모두 처리하는 백그라운드 프로세스입니다. 제공되는 정책들은 이 작업을 효율적으로 수행하면서도 CPU를 지나치게 소모하여 데이터 수집 속도가 떨어지는 일을 방지하기 위해 마련되었습니다.
Apache Doris compaction이란 무엇인가요?
Apache Doris compaction은 개별 tablet에서 일정 범위의 rowset을 선택하고, 행을 병합하고, 삭제를 적용한 뒤, 이를 대체할 단일 rowset을 기록하는 절차입니다. Backend(BE)는 스레드 풀에서 이 작업을 실행하며, tablet의 정리 필요성을 점수로 매겨 가장 시급한 tablet부터 처리합니다.
주요 용어
Rowset: 한 번의 데이터 적재로 생성되는 불변 파일 그룹입니다. rowset에는 버전이 있으며, 쿼리는 읽기 시점에 여러 rowset을 병합합니다.Cumulative compaction: 빠르고 빈번하게 수행되는 유형입니다. cumulative point 위에 있는 최근의 작은 rowset을 병합합니다.Base compaction: 느리지만 간헐적으로 수행되는 유형입니다. cumulative point 아래의 모든 데이터를 단일 base rowset으로 병합합니다.Compaction score: 쿼리가 해당 tablet에서 거쳐야 하는 병합 경로의 수를 대략적으로 나타냅니다. 점수가 높을수록 우선순위도 높습니다.Compaction policy: 테이블별로size_based(기본값) 또는time_series를 선택합니다. 어떤 rowset을 언제 병합할지 결정합니다.Vertical compaction: 넓은 테이블을 위한 열 그룹 단위 병합입니다. 행 단위 병합에 비해 메모리 사용량을 약 10배 줄입니다.
Apache Doris compaction은 어떻게 작동하나요?
Apache Doris compaction은 버전 누적 정도에 따라 모든 tablet에 점수를 매기고, 적용된 정책에 따라 rowset을 선택한 뒤, BE 스레드 풀에서 병합합니다. 이 과정에서도 실행 중인 쿼리는 원본 파일을 계속 읽을 수 있습니다.
- 모든 tablet에 점수를 매깁니다. BE는 cumulative point 위에 있는 rowset 수를 기준으로 각 tablet의 compaction score를 지속적으로 관리합니다. 점수가 높은 tablet부터 작업이 예약됩니다.
- rowset을 선택합니다. 적용된 정책이 병합 범위를 결정합니다.
size_based는 크기가 두 배씩 증가하는 구간별로 rowset을 묶습니다.time_series는 파티션 내 rowset이 목표 크기, 파일 수 또는 경과 시간 임계값을 넘을 때까지 기다렸다가 한 번에 병합합니다. - 병합하고 기록합니다. 작업은 입력에서 행을 읽고, 중복을 제거하고, 대기 중인 삭제를 적용한 뒤, 결과를 새로운 rowset에 기록합니다. 넓은 테이블은 열을 그룹 단위로 처리하는 vertical compaction을 거치므로 메모리 사용량이 일정 범위 내로 유지됩니다.
- base로 승격합니다. cumulative compaction 결과의 크기가
compaction_promotion_size_mbytes(기본값 1 GB)를 초과하면 다음 주기에 base compaction 대상이 될 수 있습니다. - 교체하고 정리합니다. 출력 rowset이 tablet 메타데이터에서 입력 rowset을 대체합니다. 기존 파일은 아직 읽고 있는 쿼리가 있을 수 있으므로 유예 기간 동안 유지된 후 삭제됩니다.
빠른 시작
CREATE TABLE access_log (
  ts DATETIME, user_id BIGINT, url VARCHAR(512)
)
DUPLICATE KEY(ts, user_id)
PARTITION BY RANGE(ts) (
  PARTITION p202605 VALUES LESS THAN ("2026-06-01")
)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "compaction_policy" = "time_series",
  "time_series_compaction_goal_size_mbytes" = "1024",
  "time_series_compaction_file_count_threshold" = "2000",
  "time_series_compaction_time_threshold_seconds" = "3600"
);

ADMIN COMPACT TABLE access_log PARTITION (p202605) WHERE TYPE = "cumulative";
예상 결과
Query OK, 0 rows affected
시계열 정책을 사용하는 파티션 로그 테이블을 생성했습니다. 작은 rowset은 총 크기가 1 GB를 초과하거나, 파일 수가 2000개에 도달하거나, 한 시간이 지나면 병합됩니다. ADMIN COMPACT 구문은 활성 파티션에서 cumulative compaction을 수동으로 실행하며, 벤치마크나 데이터 적재 후 정리에 유용합니다. SELECT * FROM information_schema.doris_be_compaction_tasks WHERE TABLE_ID = ...로 진행 상황을 확인할 수 있습니다.
Apache Doris compaction은 언제 사용해야 하나요?
Apache Doris compaction은 기본적으로 모든 테이블에서 실행됩니다. 실제로 선택해야 할 것은 어떤 정책을 설정하고 언제 기본값을 변경할지입니다.
적합한 경우
- 데이터 적재가 빈번한 모든 테이블. 기본 설정만으로도 잘 작동하므로 정책을 전환할지만 판단하면 됩니다.
- 추가 전용 로그와 메트릭.
time_series에서는 각 rowset이 여러 크기 계층에서 반복적으로 병합되지 않고 한 번만 compaction에 참여하므로 쓰기 증폭이 줄어듭니다. - 넓은 테이블(열이 수십 개 이상인 테이블). 대규모 병합 시 메모리 사용량이 급증하지 않도록
enable_vertical_compaction = true를 유지하세요.
적합하지 않은 경우
- "compaction 부하 테스트"를 위해 행을 하나씩 빈번하게 삽입하는 경우. 연구하려던 버전 누적 문제를 직접 만들게 됩니다. 대신 데이터 적재 측에서 Group Commit을 사용하세요.
- "CPU를 절약"하려고 운영 환경에서 자동 compaction을 비활성화하는 경우. tablet에 버전이 조용히 쌓이다가 데이터 적재가 -235 오류로 실패하기 시작합니다. 대신 스레드 수(
max_cumu_compaction_threads,max_base_compaction_threads)를 조정하세요. - 기본 키로 행을 갱신하거나 삭제하는 워크로드에
time_series정책을 사용하는 경우. 이 정책은 추가 전용 동작을 전제로 합니다. 갱신이 빈번한 Unique Key 테이블에는size_based를 사용하세요. - 잘못된 버킷 구성을 compaction으로 해결하려는 경우. 특정 tablet에 부하가 집중되어 늘어나는 버전을 계속 처리하지 못한다면, compaction 스레드보다 버킷 수를 늘려야 합니다.
성능 / 수치
- Vertical compaction: 메모리 사용량이 행 단위 compaction의 약 1/10이며, 넓은 테이블에서는 약 15% 더 빠릅니다. 출처: Doris compaction 튜닝 문서.
- Compaction 처리량: 기본 설정에서 작업당 초당 약 300,000개 행을 처리하며, 지속적인 데이터 적재 상황에서도 cumulative score를 50 근처로 유지합니다. 출처: 3분 만에 이해하는 데이터 Compaction.
더 읽어보기
- Vertical Compaction: compaction 메모리 사용량을 약 10배 줄이고 넓은 테이블의 병합 속도를 약 15% 높이는 열 그룹 단위 병합입니다.
- Compaction 원리, 유형 및 스케줄링
- Compaction 튜닝: vertical, segment, single-replica, time-series
ADMIN COMPACT TABLE구문 참조- 3분 만에 이해하는 데이터 Compaction(블로그)
- Unique Key: compaction이 rowset별 delete bitmap에 표시된 행을 정리하는 테이블 모델입니다.