데이터 모델
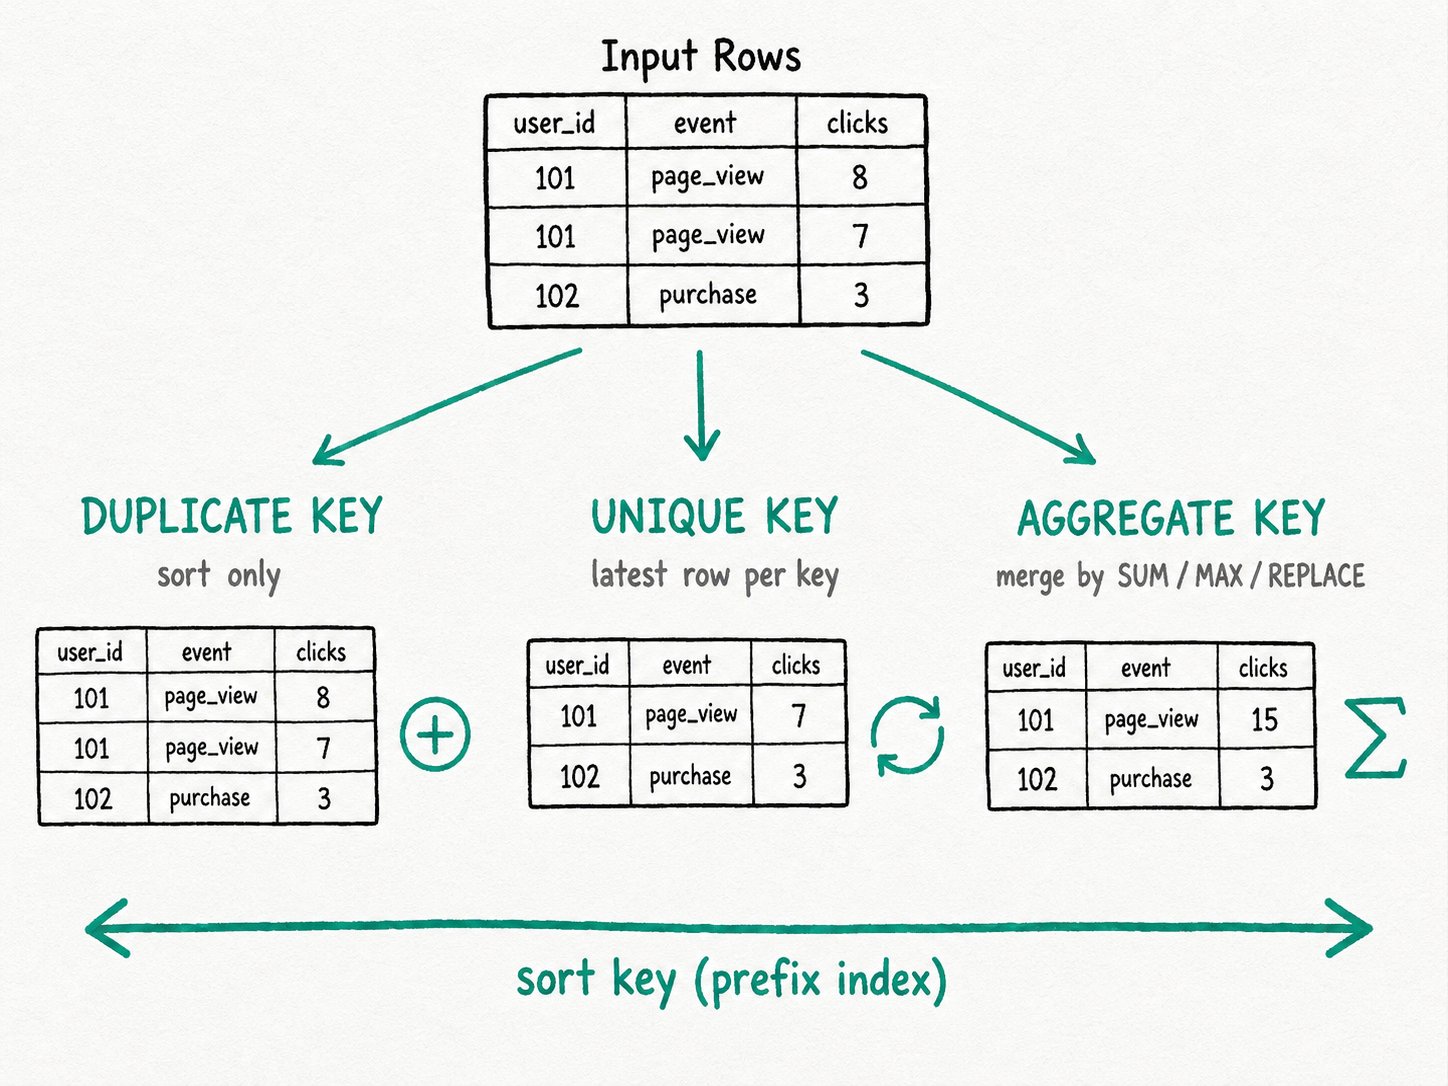
요약 모든 Apache Doris OLAP 테이블은 생성할 때 세 가지 모델 중 하나를 선택합니다. Duplicate Key는 모든 행을 유지하고, Unique Key는 기본 키별로 최신 행을 유지하며, Aggregate Key는
SUM과 같은 열별 함수를 사용해 행을 합칩니다.KEY(...)절은 Apache Doris가 정렬에 사용할 열을 지정하며, Unique 및 Aggregate 모델에서는 같은 열이 유일성도 보장합니다. 모델은CREATE TABLE시점에 고정되므로, 처음 선택한 모델에 따라 테이블을 사용하는 내내 실행할 수 있는 쓰기, 업데이트, 쿼리가 결정됩니다.
Apache Doris 데이터 모델을 사용해야 하는 이유는 무엇인가요?
Apache Doris 데이터 모델은 모든 스키마 설계에서 가장 먼저 결정해야 하며, 한 번 정하면 되돌릴 수 없는 선택입니다. ALTER TABLE로 열을 추가하거나 삭제하고, 파티션을 재구성하고, 인코딩을 교체할 수 있습니다. 하지만 Duplicate 테이블을 Unique 테이블로 바꿀 수는 없습니다. 모델을 잘못 선택했다면 CREATE TABLE로 테이블을 만들고 전체 데이터를 다시 적재해야 합니다.
- 로그 테이블을 Aggregate로 생성하면 원시 행이 사라져 상세 쿼리에 응답할 수 없습니다.
- 주문 테이블을 Duplicate로 생성하면
UPDATE가 거부되므로 CDC 파이프라인에서 행 변경 사항을 반영할 수 없습니다. - 보고용 테이블을 Unique로 생성하면 모든 쿼리가
SUM(clicks) GROUP BY day이더라도 데이터를 적재할 때마다 merge-on-write 인덱스 비용이 발생합니다.
모델은 중복 키의 허용 여부, UPDATE와 DELETE의 의미, 같은 키를 가진 행을 스토리지 엔진이 처리하는 방식을 결정합니다. 이번 주에 만드는 대시보드의 형태가 아니라 데이터의 성격(원시 이벤트, 현재 상태, 사전 집계된 팩트)에 따라 선택하세요.
Apache Doris 데이터 모델이란 무엇인가요?
Apache Doris 데이터 모델은 같은 키 열을 공유하는 행에 대해 스토리지 엔진이 적용하는 규칙입니다. Apache Doris는 DUPLICATE KEY, UNIQUE KEY, AGGREGATE KEY의 세 가지 모델을 제공합니다. FE Catalog에서는 이를 DUP_KEYS, UNIQUE_KEYS, AGG_KEYS라고 부릅니다(KeysType.java 참조). 해당 절은 CREATE TABLE의 열 목록 바로 뒤에 위치하며 키 열을 지정합니다.
... DUPLICATE KEY(log_time, log_type)
... UNIQUE KEY(order_id)
... AGGREGATE KEY(dt, ad_id, user_id)
주요 용어
- 키 열:
KEY(...)절에 지정된 열입니다. 디스크상의 정렬 순서를 정의하고, 접두사 인덱스의 기준이 되며, Unique 및 Aggregate 모델에서는 유일성도 보장합니다. - 값 열: 키 열을 제외한 모든 열입니다. Duplicate 및 Unique 모델에서는 기록된 데이터를 그대로 저장합니다. Aggregate 모델에서는 각 값 열에 집계 함수(
SUM,MAX,REPLACE,BITMAP_UNION등)가 지정됩니다. - 정렬 키: 저장 구조를 설명할 때 키 열을 가리키는 다른 표현입니다. 어떤 모델을 선택하든 tablet 내부의 데이터는 키 열을 기준으로 정렬됩니다.
- Duplicate Key 모델: 키가 중복될 수 있습니다. 행은 기록된 그대로 추가됩니다.
KEY(...)절은 정렬에만 사용됩니다. - Unique Key 모델: 키마다 하나의 행을 유지합니다. 새로 기록하는 행이 같은 키를 가진 이전 행을 덮어씁니다. SQL
UPDATE,DELETE와 Merge-on-Write를 통한 일부 열 upsert를 지원합니다. - Aggregate Key 모델: 같은 키를 공유하는 행을 각 값 열에 선언된 함수로 병합합니다. 읽을 때는 병합된 행이 반환됩니다.
Apache Doris 데이터 모델은 어떻게 동작하나요?
Apache Doris 데이터 모델은 동일한 DDL 구조를 사용하면서, 데이터를 적재할 때와 compaction을 수행할 때 세 가지 행 처리 규칙 중 하나를 적용합니다.
- 모델 선택.
DUPLICATE KEY,UNIQUE KEY,AGGREGATE KEY절이 테이블의KeysType을 설정합니다. Apache Doris는 이를 기준으로 나머지 DDL을 검증합니다. Aggregate의 값 열은 함수를 선언해야 하고, Unique 테이블에는 merge-on-write 속성이 적용되며, Duplicate 테이블에서는 집계 함수가 허용되지 않습니다. - 열 순서 지정. 열 목록에서 모든 키 열은 값 열보다 앞에 와야 합니다. Apache Doris는 각 tablet 내부의 데이터를 키 열로 정렬하고, 정렬 키의 처음 36바이트에 대해 희소 접두사 인덱스를 구축합니다. 이 인덱스 덕분에 선두 키 열에 대한 범위 조건과 동등 조건을 빠르게 처리할 수 있습니다.
- 데이터 적재 시 규칙 적용. Duplicate는 행을 추가합니다. Unique는 키로 기존 행을 찾아 rowset별 삭제 비트맵에 표시하고 새 행을 기록합니다. Aggregate는 각 값 열의 함수(
SUM,MAX,REPLACE등)를 사용해 들어오는 행을 기존 행과 병합합니다. - compaction 시 규칙 재적용. 백그라운드 compaction은 같은 규칙으로 rowset을 병합합니다. Duplicate는 행을 이어 붙입니다. Unique는 삭제 비트맵에 표시된 행을 제거합니다. Aggregate는 값 열의 함수로 중복 행을 다시 합칩니다.
- 읽기. 쿼리는 모델이 정의한 형태로 데이터를 읽습니다. Duplicate에서는 추가된 모든 행을, Unique에서는 키별 최신 행을, Aggregate에서는 키별로 병합된 하나의 행을 읽습니다.
모델은 tablet 메타데이터에 기록되며 모든 복제본에 복제됩니다. ALTER TABLE ... CHANGE MODEL은 지원되지 않습니다. 모델을 변경하려면 새 테이블을 생성하고 데이터를 다시 적재해야 합니다.
빠른 시작
-- Duplicate: keep every event, sort by (log_time, log_type)
CREATE TABLE logs (
  log_time DATETIME, log_type INT, msg VARCHAR(1024)
) DUPLICATE KEY(log_time, log_type)
DISTRIBUTED BY HASH(log_type) BUCKETS 4;

-- Unique: one row per order_id, with UPDATE / DELETE support
CREATE TABLE orders (
  order_id BIGINT, status VARCHAR(20), amount DECIMAL(10,2)
) UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4;

-- Aggregate: pre-sum clicks per (dt, ad_id) at load time
CREATE TABLE ad_stats (
  dt DATE, ad_id INT, clicks BIGINT SUM
) AGGREGATE KEY(dt, ad_id)
DISTRIBUTED BY HASH(ad_id) BUCKETS 4;
예상 결과
SHOW CREATE TABLE logs\G     -- prints "DUPLICATE KEY(`log_time`, `log_type`)"
SHOW CREATE TABLE orders\G   -- prints "UNIQUE KEY(`order_id`)"
SHOW CREATE TABLE ad_stats\G -- prints "AGGREGATE KEY(`dt`, `ad_id`)"
열 목록이 같더라도 스토리지 엔진의 쓰기 처리 방식은 크게 다릅니다. 같은 행을 logs에 두 번 삽입하면 두 행이 저장됩니다. orders에서 같은 작업을 수행하면 하나의 행만 남습니다. ad_stats에 (dt, ad_id)가 같은 두 행을 삽입하면 clicks 열의 값이 합산됩니다.
Apache Doris 데이터 모델은 언제 사용해야 하나요?
Apache Doris 데이터 모델은 이번 주에 만드는 대시보드의 형태가 아니라 데이터의 성격(원시 이벤트, 현재 상태, 사전 집계된 팩트)에 따라 선택하세요.
적합한 경우
- Duplicate는 원시 행을 쿼리하는 추가 전용 데이터에 적합합니다. 액세스 로그, 클릭 스트림, IoT 측정값, 트랜잭션 상세 내역 등이 여기에 해당합니다. 중복 제거를 수행하지 않으며, 조건식에 사용할 수 있는 열에도 제약이 없습니다.
- Unique는 기본 키로 업데이트하는 데이터에 적합합니다. MySQL 또는 Postgres의 CDC 싱크, 주문 상태 테이블, 사용자 프로필, 실시간 차원 테이블 등이 여기에 해당합니다. 데이터 업데이트 및 삭제에서
UPDATE, 일부 열 upsert, Merge-on-Write의 내부 동작을 살펴보세요. - Aggregate는 데이터 추가가 주로 이루어지는 팩트 테이블에서 형태가 고정된 롤업 쿼리에 적합합니다. 일별 지출, 광고별 클릭 수,
BITMAP_UNION을 통한 중복 없는 시청자 수 등이 여기에 해당합니다. 사전 집계 및 롤업에서 전체 집계 함수 목록과ROLLUP을 통한 확장 방식을 살펴보세요. - 모든 모델에 공통으로, 선두 키 열은 세 개 이하로 선택하고 문자열보다 정수를 우선하며 데이터를 담을 수 있는 가장 작은 타입을 사용하세요. 접두사 인덱스는 정렬 키의 처음 36바이트만 사용합니다.
적합하지 않은 경우
- 원시 행별 조회도 필요한 워크로드에 Aggregate를 사용하는 경우입니다. 원시 행은 병합 단계에 들어가는 순간 사라집니다. Duplicate를 사용하고, 필요하면 롤업을 위한 비동기 구체화된 뷰를 추가하세요.
count(*)를 지속적으로 실행하는 경우에 Aggregate를 사용하는 것입니다. 행 수를 계산하려면 모든 키 열을 읽고 병합해야 하므로 키 너비에 비례해 비용이 증가합니다. 널리 쓰이는 우회 방법은 값이 항상1이고 집계 함수가SUM인 값 열을 두는 것입니다. 그러면SUM(count)를 쿼리해 같은 결과를 얻을 수 있으며, 키가 넓은 Aggregate 테이블에서count(*)를 실행할 때보다 약 10배 빠릅니다.- 데이터를 추가하기만 하고 업데이트하지 않는데 Unique를 사용하는 경우입니다. 사용하지 않는 기능을 위해 merge-on-write 키 인덱스 비용을 지불하게 됩니다. Duplicate를 선택하세요.
- 기본 키를 파티션 키로 사용하는 Unique입니다. 파티션 키는 유니크 키의 부분집합이어야 하며, 그 반대가 되어서는 안 됩니다.
UPDATE가 필요한 테이블에 Duplicate를 사용하는 경우입니다. 해당 문은 거부됩니다. 데이터 수집을 통해 다시 적재하거나 Unique를 선택하세요.- 값 열에 대한
UPDATE또는DELETE가 필요한 테이블에 Aggregate를 사용하는 경우입니다. 엔진은 집계 전에 값 열의 조건을 평가할 수 없으므로 Aggregate의DELETE조건식은 키 열에만 사용할 수 있습니다.
더 읽어보기
- 테이블 모델 개요: 기능 비교표와 의사결정표
- Duplicate Key 모델: 추가 전용 저장 방식과 정렬 키 튜닝
- Unique Key 모델: Merge-on-Write와 Merge-on-Read 비교, 일부 열 업데이트
- Aggregate 모델: 집계 함수와 사용자 정의 병합을 위한
AGG_STATE - 테이블 모델 모범 사례: 열 순서, 타입 선택,
count(*)튜닝 - 접두사 인덱스와 정렬 키: 키 열을 활용한 쿼리 프루닝 방식
- 데이터 업데이트 및 삭제: Unique Key 모델이 지원하는 SQL UPDATE, DELETE, 일부 열 upsert와 Merge-on-Write의 내부 동작입니다.
- 사전 집계 및 롤업: Aggregate Key 모델의 상세 설명과 ROLLUP, 동기 구체화된 뷰를 다룹니다.
- 파티셔닝과 버킷팅: 같은 키 열이 파티션 프루닝과 tablet 배치에 사용되는 방식을 설명합니다.
- Unique Key: Duplicate 및 Aggregate와 함께 제공되는 기본 키 모델로, 키마다 하나의 행을 유지합니다. 소스에서 upsert를 수행할 때 선택하세요.