데이터 프루닝
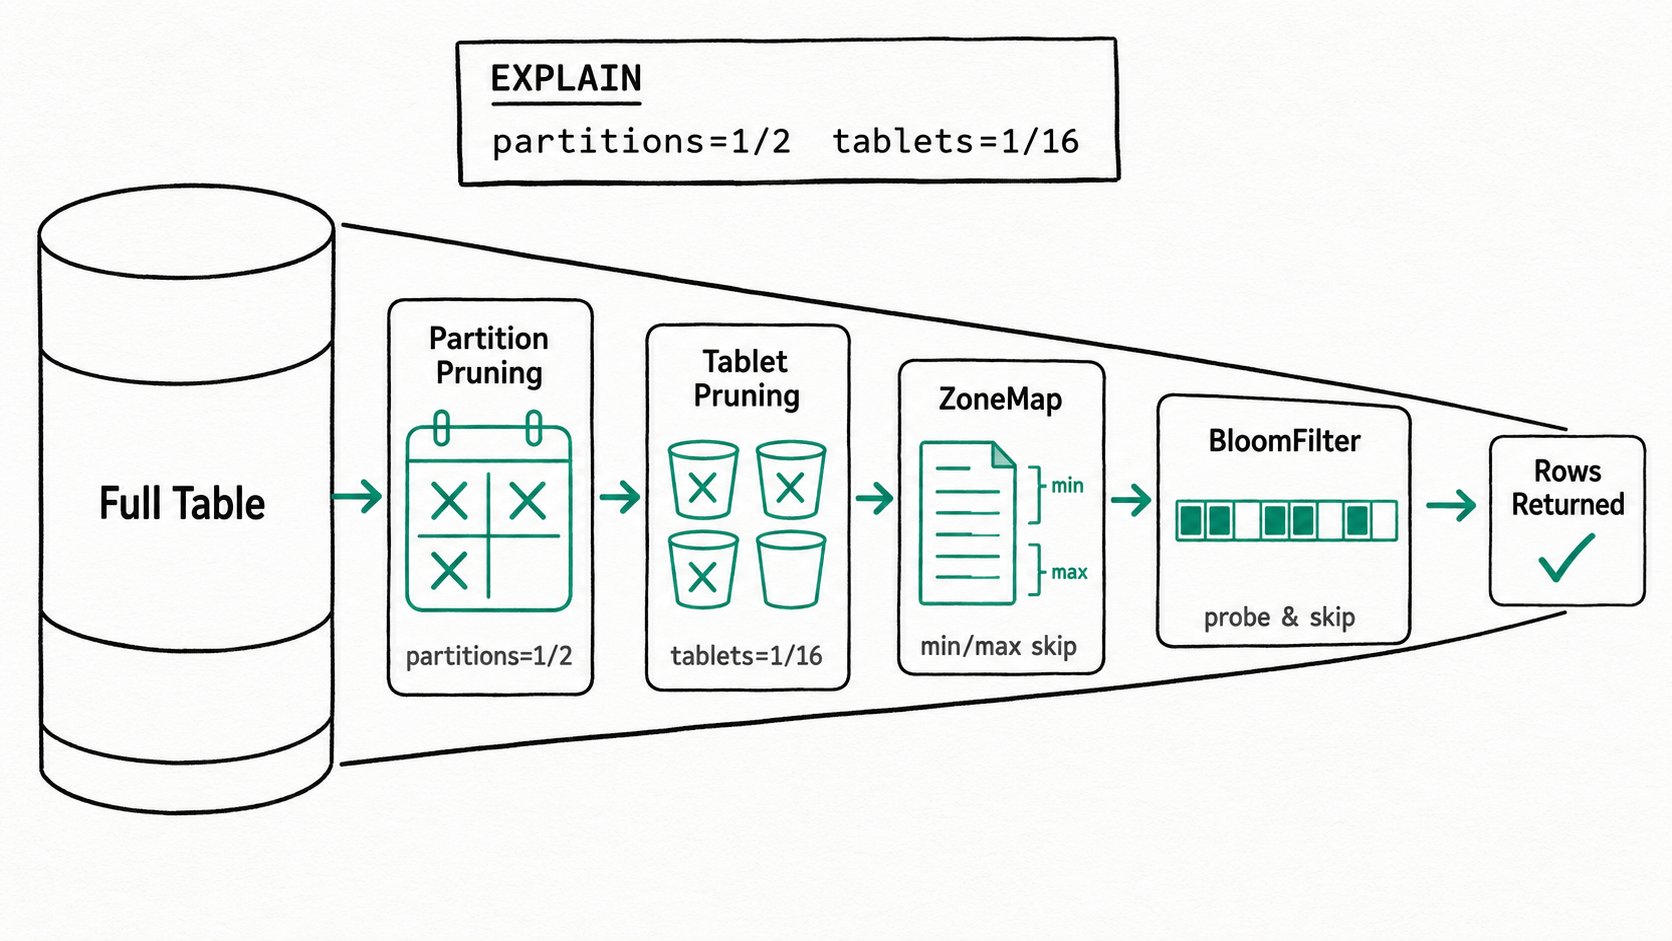
요약 Apache Doris의 데이터 프루닝은 쿼리가 실제로 테이블 전체를 스캔하는 것이 아니라, 여러 프루닝 계층을 거치고 남은 데이터만 스캔한다는 뜻입니다. 파티션 키와 분산 키, ZoneMap min/max 통계, BloomFilter 및 NGram BloomFilter 인덱스는 엔진이 읽을 필요가 없는 데이터를 계층마다 차례로 걸러 냅니다. 대부분의 성능 향상은 자동으로 이루어지며, 운영자는 DDL 설계를 통해 이를 제어하고 EXPLAIN 출력에서 확인합니다.
Apache Doris에서 데이터 프루닝을 사용하는 이유는 무엇인가요?
Apache Doris의 데이터 프루닝은 쿼리가 데이터를 읽기 전에 테이블 대부분을 건너뛸 수 있게 하여, 수 테라바이트를 스캔하는 작업을 파티션이나 태블릿 몇 개만 읽는 작업으로 줄입니다. OLAP 쿼리의 속도를 높이는 가장 빠른 방법은 읽는 데이터의 양을 줄이는 것입니다. 열이 많은 이벤트 테이블에 하루 50 GB씩 데이터가 쌓이면 일 년 동안 페타바이트 규모로 커지지만, 대부분의 쿼리는 하루, 사용자 한 명, 제품 하나처럼 극히 일부 데이터만 필요로 합니다. 프루닝이 없으면 플래너는 쿼리를 모든 파티션과 태블릿에 분산하고, 실행기는 WHERE 조건을 평가하기 위해 디스크의 모든 페이지를 읽습니다.
이로 인해 다음 세 가지 문제가 발생합니다.
WHERE date BETWEEN '2026-04-01' AND '2026-04-07'쿼리를 파티션이 365개인 테이블에 실행하면, 플래너가 파티션을 건너뛸 수 있다는 정보를 받기 전까지 모든 파티션에 접근합니다.- 해시로 분산된 테이블의 포인트 조회(
WHERE user_id = 12345)는 옵티마이저가 조건자를 버킷 키와 연결하지 못하면 태블릿 전체 스캔으로 바뀝니다. - 키가 아닌 열의 카디널리티가 높은 필터(
WHERE phone = '...')는 읽을 필요가 없는 페이지를 제외할 통계가 없어 모든 세그먼트를 읽습니다.
Apache Doris는 각 문제를 서로 다른 프루닝 계층으로 해결하며, 이 계층들은 함께 작동합니다. 플래너가 스캔 시작 전에 파티션과 태블릿을 줄이고, BE가 남은 데이터 내에서 세그먼트와 페이지를 건너뜁니다.
Apache Doris 데이터 프루닝이란 무엇인가요?
Apache Doris의 데이터 프루닝은 읽기 경로의 각 단계에서 엔진이 데이터를 읽지 않고도 건너뛸 수 있게 하는 기능이 누적된 결과이며, 파티션, 태블릿, 세그먼트, 열 페이지 전반에 적용됩니다. Frontend 플래너는 테이블 메타데이터를 사용해 파티션과 태블릿이라는 큰 단위를 처리합니다. Backend는 스캔 중에 더 세밀한 단위를 처리합니다. ZoneMap min/max, BloomFilter, NGram BloomFilter, 역 인덱스는 세그먼트, 열 페이지, 심지어 행 범위까지 건너뛸 수 있는지 결정합니다.
주요 용어
Partition pruning: 플래너가 파티션 키의 범위 또는 목록 조건자를 사용해 태블릿 실행이 예약되기 전에 관련 없는 파티션을 제외합니다.Bucket (tablet) pruning:DISTRIBUTED BY HASH키의 동등 조건자를 통해 플래너가 해당 행을 포함할 가능성이 있는 버킷만 선택할 수 있습니다.ZoneMap index: 모든 열에 자동으로 생성되는 세그먼트별, 페이지별 min/max/null 통계입니다. 범위 조건자는 이 통계를 사용해 페이지를 건너뜁니다.BloomFilter index: 열별로 선택적으로 설정하는 확률적 필터로, 카디널리티가 높은 값에 대한 동등 조건자와IN조건자에 유용합니다.NGram BloomFilter: 부분 문자열LIKE '%abc%'조건자를 n-gram에 대한 Bloom 탐색으로 바꾸는 선택적 인덱스입니다.Runtime filter: 조인의 한쪽에서 생성되어 다른 쪽의 데이터를 프루닝하도록 푸시다운되는 조인 시점의 필터입니다.
Apache Doris 데이터 프루닝은 어떻게 작동하나요?
Apache Doris의 데이터 프루닝은 파티션, 태블릿, 세그먼트/페이지, 인덱스 탐색, 런타임 필터의 다섯 계층을 위에서 아래로 적용합니다. 각 계층은 다음 계층이 처리해야 할 입력을 줄입니다.
- 파티션 프루닝(FE). Nereids 플래너는
PruneOlapScanPartition을 실행하여WHERE조건자를 테이블의 범위 또는 목록 파티션 트리와 대조하고, 남는 파티션 집합을 생성합니다. EXPLAIN에는partitions=2/4 (p2,p3)로 표시됩니다. - 태블릿 프루닝(FE).
PruneOlapScanTablet은 버킷 분할 열의 동등 조건자를 추출하고,HashDistributionPruner를 통해 해당 값이 해시되는 버킷을 확인합니다. EXPLAIN에는tablets=1/32로 표시됩니다. - 세그먼트/페이지 프루닝(BE). 남은 각 태블릿에 대해 세그먼트 이터레이터가 열 리더를 열고 ZoneMap 인덱스를 확인합니다.
[min, max]범위가 조건자와 겹치지 않으면 압축을 해제하지 않고 해당 페이지를 제외합니다. - 인덱스 탐색(BE). 행을 디코딩하기 전에 BloomFilter, NGram BloomFilter, 역 인덱스를 탐색합니다. 일치 가능성이 없으면 페이지를 건너뜁니다. 일치 가능성이 있더라도 실제로 조건에 맞는 행이 있다는 보장은 없으며, 그런 행이 있을 수 있다는 뜻일 뿐입니다.
- 런타임 필터(FE/BE). 조인은 빌드 측에서 필터(예:
IN (A.id_set))를 생성하고 이를 브로드캐스트하여, 프로브 측 스캔이 실행 중에 같은 프루닝 메커니즘을 재사용하도록 합니다.
조건자 평가기가 실행될 때는 테이블 대부분이 이미 읽히지 않은 채로 제외된 상태입니다.
빠른 시작
CREATE TABLE events (
  ts DATETIME, user_id BIGINT, action VARCHAR(64)
)
DUPLICATE KEY(ts, user_id)
PARTITION BY RANGE(ts) (
  PARTITION p202604 VALUES LESS THAN ("2026-05-01"),
  PARTITION p202605 VALUES LESS THAN ("2026-06-01")
)
DISTRIBUTED BY HASH(user_id) BUCKETS 16
PROPERTIES ("bloom_filter_columns" = "action");

EXPLAIN
SELECT count(*) FROM events
WHERE ts >= '2026-05-08' AND user_id = 42 AND action = 'click';
예상 결과(발췌)
0:VOlapScanNode
  TABLE: events
  PREDICATES: ts >= '2026-05-08', user_id = 42, action = 'click'
  partitions=1/2 (p202605)
  tablets=1/16
플래너는 날짜 범위를 기준으로 두 파티션 중 하나를 남기고, user_id의 해시값을 기준으로 열여섯 태블릿 중 하나를 남겼습니다. 데이터를 읽을 때 BE는 ts의 ZoneMap과 action의 BloomFilter를 사용해 남은 태블릿 내부의 페이지를 건너뜁니다. 별도의 수동 조정 없이 네 프루닝 계층이 세 조건자를 처리합니다.
Apache Doris 데이터 프루닝은 언제 사용해야 하나요?
Apache Doris의 데이터 프루닝은 항상 활성화되어 있습니다. 관건은 DDL과 조건자가 실제로 어느 계층을 활성화하느냐입니다. 기간이 제한된 분석 쿼리, 동시성이 높은 포인트 조회, 긴 텍스트 열의 부분 문자열 검색, 스타 스키마 조인에서 가장 큰 효과를 볼 수 있습니다. 부적절한 BloomFilter 사용과 모든 데이터를 담는 파티션이 흔한 안티패턴입니다.
적합한 경우
- 파티션 테이블에서 실행하는 기간이 제한된 분석 쿼리. 날짜 조건자가 플래너에 전달되면 지연 시간 곡선이 완만해집니다.
- 해시로 분산된 테이블에서 실행하는 동시성이 높은 포인트 조회. 버킷 키를 가장 자주 사용하는 동등 조건자에 맞추세요.
- 긴 텍스트 열의 부분 문자열 검색. NGram BloomFilter를 추가하면
LIKE '%...%'가 열 스캔 대신 Bloom 탐색으로 처리됩니다. - 스타 스키마 조인. 런타임 필터는 크기가 작은 쪽의 키를 팩트 테이블 스캔으로 전달합니다.
적합하지 않은 경우
- 카디널리티가 낮은 열(상태 플래그, 성별)의 BloomFilter. 필터가 거의 모든 페이지를 통과시키므로 실익 없이 저장 공간만 소비합니다. 기본 제공되는 ZoneMap을 사용하거나 인덱스를 아예 생략하세요.
- 범위 조건자에 사용하는 BloomFilter. Bloom은 "X가 집합에 포함되는가?"에 답할 뿐, "X가 Y보다 작은가?"에는 답하지 않습니다. 범위 필터는 ZoneMap을 사용합니다.
- 필터링에 사용하지 않는 열을 기준으로 버킷을 나누는 경우. 쓰기 시 해시 분산 비용이 발생하지만 읽기 시 프루닝 이점은 얻지 못합니다. 선택도가 가장 높은 동등 조건자에 맞는 버킷 키를 선택하세요.
- 모든 데이터를 담는 거대한 단일 파티션. 플래너가 제외할 파티션이 없으므로 태블릿/세그먼트 프루닝만으로 이를 보완해야 합니다. 쿼리가 실제로 필터링하는 열을 기준으로 파티션을 나누세요. 보통 시간 열이 여기에 해당합니다.
- BloomFilter를 전문 검색의 대체 수단으로 사용하는 경우. 구문 또는 토큰 검색에는 역 인덱스를 사용하세요. BloomFilter는 동등 조건만 처리합니다.
더 읽어보기
- 파티션 프루닝 최적화
- 인덱스 개요: 스킵 인덱스
- BloomFilter 인덱스
- NGram BloomFilter 인덱스
- 파티셔닝과 버킷팅: 플래너가 어떤 파티션과 태블릿을 프루닝할 수 있는지를 결정하는 DDL 설계를 설명합니다.
- 역 인덱스: 텍스트 조건자와 카디널리티가 높은 동등 조건자를 포스팅 목록 조회로 바꾸는 인덱스 탐색 계층입니다.
- 심층 분석: Apache Doris의 데이터 프루닝(블로그)
- MPP 아키텍처: 프루닝이 실행되는 위치를 설명합니다. 프래그먼트가 전송되기 전에 Nereids 플래너에서 파티션/버킷 프루닝이 수행됩니다.