임베딩
요약 Apache Doris는 텍스트(또는 이미지, 비디오, 오디오 파일)를 외부 임베딩 모델로 보내고, 컬럼에 저장하거나 거리 함수에 바로 사용할 수 있는 벡터를 반환하는 내장
EMBED()SQL 함수를 제공합니다. 반환 형식은ARRAY<FLOAT>입니다. 모델을 AIRESOURCE로 한 번 설정하면 값을 사용할 수 있는 곳 어디서든EMBED('your text')를 호출할 수 있습니다. UDF나 클라이언트 측 연결 코드, 별도로 운영할 추가 서비스가 필요하지 않습니다.
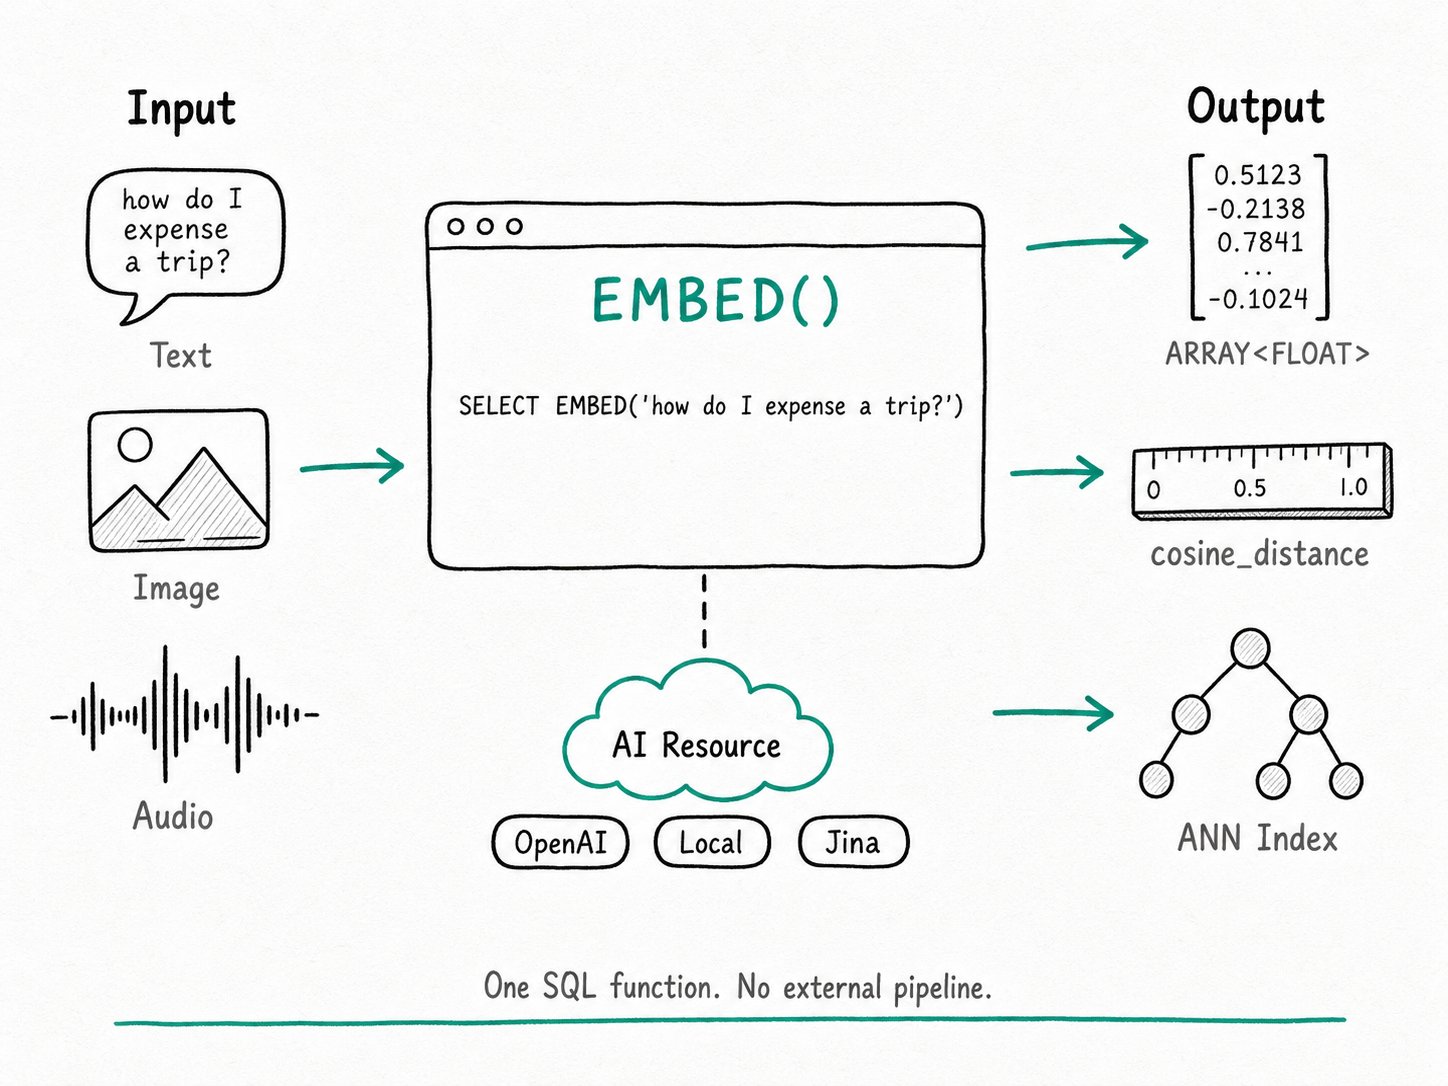
Apache Doris에서 EMBED 함수를 사용하는 이유는 무엇인가요?
Apache Doris의 EMBED() 함수는 일반적으로 애플리케이션에서 처리하던 임베딩 파이프라인을 SQL 호출 하나로 통합합니다. 따라서 별도의 ETL 서비스 없이 데이터베이스 안에서 벡터를 생성하고 저장하며 쿼리할 수 있습니다. 벡터 검색에는 벡터가 필요하고, 벡터는 임베딩 모델에서 만들어집니다. 일반적인 구성에서는 애플리케이션 서버가 데이터베이스에서 행을 가져와 OpenAI나 로컬 모델에 보내고, 반환된 벡터를 벡터 테이블에 기록합니다. 쿼리 시점에도 검색 문자열에 대해 같은 왕복 과정이 반복됩니다. 결국 HTTP API를 호출하고 결과를 어딘가에 저장하는 일만 하는 작은 ETL 서비스를 유지보수하게 됩니다.
이 과정에서는 다음과 같은 문제가 자주 발생합니다.
- 파이프라인이 원본 테이블과 동기화되지 않습니다. 새 행이 들어와도 다음 배치 실행 전까지는 임베딩이 없습니다.
- 백필 자체가 별도의 작업이 되며, 처음 데이터를 수집할 때보다 더 느리고 비용도 더 많이 드는 경우가 많습니다.
- 하나의 논리적 단계를 두 팀이 나누어 담당합니다. 데이터 팀은 행을, 애플리케이션 팀은 벡터를 담당하지만, 그 사이의 공백은 아무도 책임지지 않습니다.
EMBED()는 이 전체 과정을 SQL 안으로 가져옵니다. 모델은 Apache Doris 리소스로, 호출은 함수로 표현되며, 결과는 INSERT로 저장하거나 필요할 때 계산할 수 있는 컬럼이 됩니다.
Apache Doris EMBED 함수란 무엇인가요?
Apache Doris의 EMBED() 함수는 내장 AI 함수로, 텍스트나 멀티모달 파일 참조를 받아 외부 임베딩 제공자에게 벡터를 요청한 뒤 ARRAY<FLOAT>를 반환합니다. Apache Doris는 CREATE RESOURCE로 한 번 설정한 AI 리소스를 통해 제공자에 연결합니다. 같은 함수 호출을 데이터 적재 시점에 사용해 임베딩을 컬럼에 저장할 수도 있고, 쿼리 시점에 사용해 SQL 안에서 사용자의 검색 문자열을 즉시 임베딩할 수도 있습니다.
주요 용어
- AI 리소스: 임베딩 제공자에 대한 이름 있는 연결입니다.
EMBED()는openai,gemini,voyageai,jina,qwen,minimax전용 어댑터와 사내 모델 서버용local옵션을 제공합니다. 엔드포인트, 모델 이름, API 키, 선택적 차원 수를 저장합니다. EMBED([resource_name], input): SQL 함수입니다. 인수가 하나이면 Apache Doris는 세션 기본값을 사용하고, 두 개이면 첫 번째 인수로 리소스 이름을 명시합니다.default_ai_resource: 해당 세션에서 이후 사용할 리소스를 선택하는 세션 변수입니다.- 멀티모달 입력: 파일을 설명하는 JSON 값입니다(URI, 콘텐츠 유형, 선택적 S3 자격 증명). Apache Doris는 S3 URL에 미리 서명한 뒤 이미지, 비디오 또는 오디오 임베딩을 지원하는 제공자에게 전달합니다.
Apache Doris EMBED 함수는 어떻게 작동하나요?
Apache Doris의 EMBED() 함수는 AI 리소스 등록, FE에서 호출 계획 수립, BE에서 행 일괄 처리, 실패 시 재시도, 행마다 하나의 ARRAY<FLOAT> 반환이라는 다섯 단계로 작동합니다.
- 모델을 등록합니다.
CREATE RESOURCE는 제공자 유형, 엔드포인트, 모델 이름, 자격 증명을 저장합니다. Apache Doris는 제공자에 시험 호출을 보내 리소스를 검증합니다. 단,provider_type = "local"이면 이 검사를 생략합니다. - 호출 계획을 수립합니다. 플래너가
EMBED()를 발견하면 작업을 BE로 보냅니다. 함수는 입력 컬럼을 행별로 처리하지만, 제공자를 행마다 호출하지는 않습니다. - BE에서 일괄 처리합니다. BE는 행을 배치로 모읍니다. 배치 크기는
embed_max_batch_size(기본값: 입력 5개)와ai_context_window_size(기본값: 누적 텍스트 128 KB)로 제한됩니다. 각 배치는 하나의 HTTP 요청이 되어 왕복 호출 횟수와 분당 요청 제한을 관리하는 데 도움이 됩니다. - 재시도하고 오류를 명확히 알립니다. 제공자 호출은 리소스의
ai.max_retries와ai.retry_delay_second설정을 따릅니다. API가 반환한 벡터 수가 맞지 않으면, Apache Doris는 행과 벡터가 잘못 연결될 위험을 감수하지 않고 쿼리를 실패 처리합니다. - 컬럼을 반환합니다. 각 행에는 해당 행의
ARRAY<FLOAT>가 반환됩니다. 이를 저장하거나,cosine_distance에 전달하거나, 벡터 검색을 위해 ANN 인덱스에 데이터 적재할 수 있습니다.
빠른 시작
CREATE RESOURCE "openai_embed" PROPERTIES (
  "type" = "ai", "ai.provider_type" = "openai",
  "ai.endpoint"   = "https://api.openai.com/v1/embeddings",
  "ai.model_name" = "text-embedding-3-small",
  "ai.api_key"    = "sk-xxx", "ai.dimensions" = "8"
);

SET default_ai_resource = "openai_embed";

CREATE TABLE notes (id INT, body STRING, vec ARRAY<FLOAT>)
  DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO notes VALUES
  (1, 'travel reimbursement policy', EMBED('travel reimbursement policy')),
  (2, 'VPN setup guide',             EMBED('VPN setup guide'));

SELECT id, body, cosine_distance(vec, EMBED('how do I expense a trip?')) AS d
FROM notes ORDER BY d ASC LIMIT 1;
예상 결과
+----+-----------------------------+--------+
| id | body                        | d      |
+----+-----------------------------+--------+
|  1 | travel reimbursement policy | 0.4463 |
+----+-----------------------------+--------+
INSERT는 행마다 하나의 벡터를 미리 계산합니다. SELECT는 실행 시점에 쿼리 문자열을 한 번 임베딩한 뒤 코사인 거리에 따라 행의 순위를 매깁니다. API 호출은 총 두 번이며, 모두 SQL 내부에서 처리됩니다.
멀티모달 빠른 시작
멀티모달 임베딩을 생성하려면 텍스트 문자열 대신 JSON 객체를 전달합니다. 객체에는 파일의 uri와 MIME 유형인 content_type이 포함되어야 합니다. URI는 HTTP 또는 HTTPS URL이나 S3 호환 URI일 수 있습니다. 설정한 제공자와 모델이 입력 미디어 유형을 지원하는지 확인하세요.
다음 예시는 S3 호환 객체 스토리지에 저장된 비디오를 임베딩합니다.
SELECT ARRAY_SIZE(
  EMBED(
    'multimodal_embed_resource',
    CAST('{
      "uri": "s3://example-bucket/videos/demo.mp4",
      "content_type": "video/mp4",
      "endpoint": "s3.us-east-1.amazonaws.com",
      "region": "us-east-1",
      "ak": "<access_key>",
      "sk": "<secret_key>"
    }' AS JSON)
  )
) AS video_embedding_dimension;
결과 예시
+---------------------------+
| video_embedding_dimension |
+---------------------------+
|                      2560 |
+---------------------------+
벡터 차원 수는 설정한 제공자와 모델에 따라 달라지므로 위 결과는 예시일 뿐입니다. HTTP 또는 HTTPS URL에는 uri와 content_type만 필요합니다. S3 호환 URI의 경우 Doris는 미리 서명된 URL을 생성하며, AK/SK 자격 증명이나 role_arn 및 external_id를 사용하는 IAM 역할 인증을 지원합니다.
Apache Doris EMBED 함수는 언제 사용해야 하나요?
Apache Doris의 EMBED() 함수는 이미 Apache Doris에 저장된 문서 집합을 대상으로 하는 RAG 및 시맨틱 검색, SQL 안에서 작업을 처리하는 백필, 벡터와 키워드 필터를 결합하는 하이브리드 파이프라인, 원본 파일이 S3에 있는 멀티모달 임베딩에 적합합니다. 주요 처리 경로에서 수백만 개 행을 대상으로 행별 임베딩을 수행하거나, 지원되는 제공자 목록에 없는 모델을 사용하거나, 제공자에 접근할 수 없는 폐쇄망 클러스터를 사용하는 경우에는 적합하지 않습니다.
적합한 경우
- 문서 집합이 이미 Apache Doris에 있고, 하나의 시스템에서 수집, 임베딩, 검색을 모두 처리하려는 RAG 및 시맨틱 검색.
- 기존 테이블에 대한 백필:
UPDATE t SET vec = EMBED(body) WHERE vec IS NULL로 데이터베이스 안에서 작업을 처리할 수 있습니다. EMBED()를 저장용 ANN 인덱스 및 키워드 필터링용MATCH_*조건식과 결합하는 하이브리드 파이프라인. 하이브리드 검색을 참고하세요.- 파일이 S3에 있고, 다운로드 후 업로드하는 스크립트를 따로 작성하고 싶지 않은 경우의 멀티모달 임베딩(이미지, 비디오, 오디오).
적합하지 않은 경우
- 수백만 개 행을 대상으로 행마다 임베딩을 수행하는 실시간 쿼리. 각 행마다 제공자를 한 번 호출하므로 비용과 지연 시간이 행 수에 비례해 늘어납니다. 한 번 미리 계산한 뒤 계속 재사용하세요.
- 지원되는 제공자 목록에 없는 특정 임베딩 모델이 필요한 워크로드. 임베딩 어댑터를 제공하는 대상은 OpenAI, Gemini, VoyageAI, Jina, Qwen, MiniMax와 사내 모델 서버용
local입니다. Apache Doris의 전체 AI 리소스 목록에는 DeepSeek, MoonShot, Anthropic, Zhipu, Baichuan도 포함되지만, 이들은 LLM SQL 함수를 통해 처리되며 채팅 / 텍스트 완성만 지원하고EMBED()는 지원하지 않습니다. 임베딩 어댑터가 없는 제공자를 연결하려면 OpenAI 또는 Gemini 호환 API를 제공해야 합니다. - 제공자에 접근할 수 없는 폐쇄망 클러스터. 사내 모델 서버에
provider_type = "local"을 사용하거나 자체 파이프라인에서 벡터를 미리 계산하세요. - 임베딩 모델의 차원 수가 ANN 인덱스와 일치하지 않는 컬럼. ARRAY 길이는 모델에 의해 결정됩니다(차원 축소를 허용하는 모델에서는
ai.dimensions로 결정). 인덱스의 차원 수는 테이블 생성 시 고정됩니다. 일치하지 않으면 쓰기 시점에 실패합니다.
비용 및 처리량 관련 참고 사항
EMBED()의 처리 속도는 연동된 제공자의 속도에 좌우됩니다. EMBED()를 주요 처리 경로에 넣기 전에 다음 사항을 알아 두세요.
- 외부 API에는 요청 빈도 제한이 있습니다.
embed_max_batch_size를 높이면 왕복 호출 횟수는 줄어들지만 각 요청에 더 많은 토큰이 포함되므로, 두 요소를 함께 고려해 조정하세요. - 입력이
ai_context_window_size를 초과하는 행은 자동으로 별도 배치로 처리되므로, 지나치게 큰 문서 하나가 쿼리의 나머지 처리를 지연시키지 않습니다. - 제공자는 행 수가 아니라 입력 토큰 수에 따라 요금을 청구합니다. 같은 텍스트를 두 번 임베딩하면 비용도 두 배가 됩니다. 벡터를 여러 번 읽을 예정이라면 저장해 두세요.
local제공자는 자격 증명 검사를 생략하고 사용자 네트워크 내부에서 실행됩니다. 토큰당 요금은 없어지지만 추론 서버를 직접 운영해야 합니다.
더 읽어보기
- EMBED 함수 참조: 전체 구문, 멀티모달 JSON 입력, 거리별 예시.
- AI 함수 개요: 지원되는 모든 제공자와
CREATE RESOURCE의 전체 속성 목록. - 하이브리드 검색: 하나의 쿼리에서
EMBED()를 전문 검색 조건식 및 ANN 인덱스와 결합하는 방법. - 벡터 인덱스 개요: ANN 검색을 위해 HNSW 또는 IVF 인덱스에 임베딩을 저장하는 방법.
- 역색인: 하이브리드 쿼리에서 벡터의 순위를 매기기 전에 행을 미리 필터링하는 데 사용하는 인덱스.
- Reciprocal Rank Fusion: 임베딩이 준비된 후 BM25 순위와 벡터 순위를 결합하는 방법.
- LLM SQL 함수:
EMBED()는AI_*함수군과 AI 리소스 모델을 공유합니다. AI SQL 기능의 나머지 한 축을 살펴볼 수 있습니다. - Doris의 AI: 분류, 생성, 여러 행에 걸친 집계를 비롯한 나머지 AI 함수군.