전문 검색
요약 Apache Doris 전문 검색은 역색인을 사용해 텍스트 컬럼을 검색 가능한 용어로 변환하고, SQL에서 여섯 가지
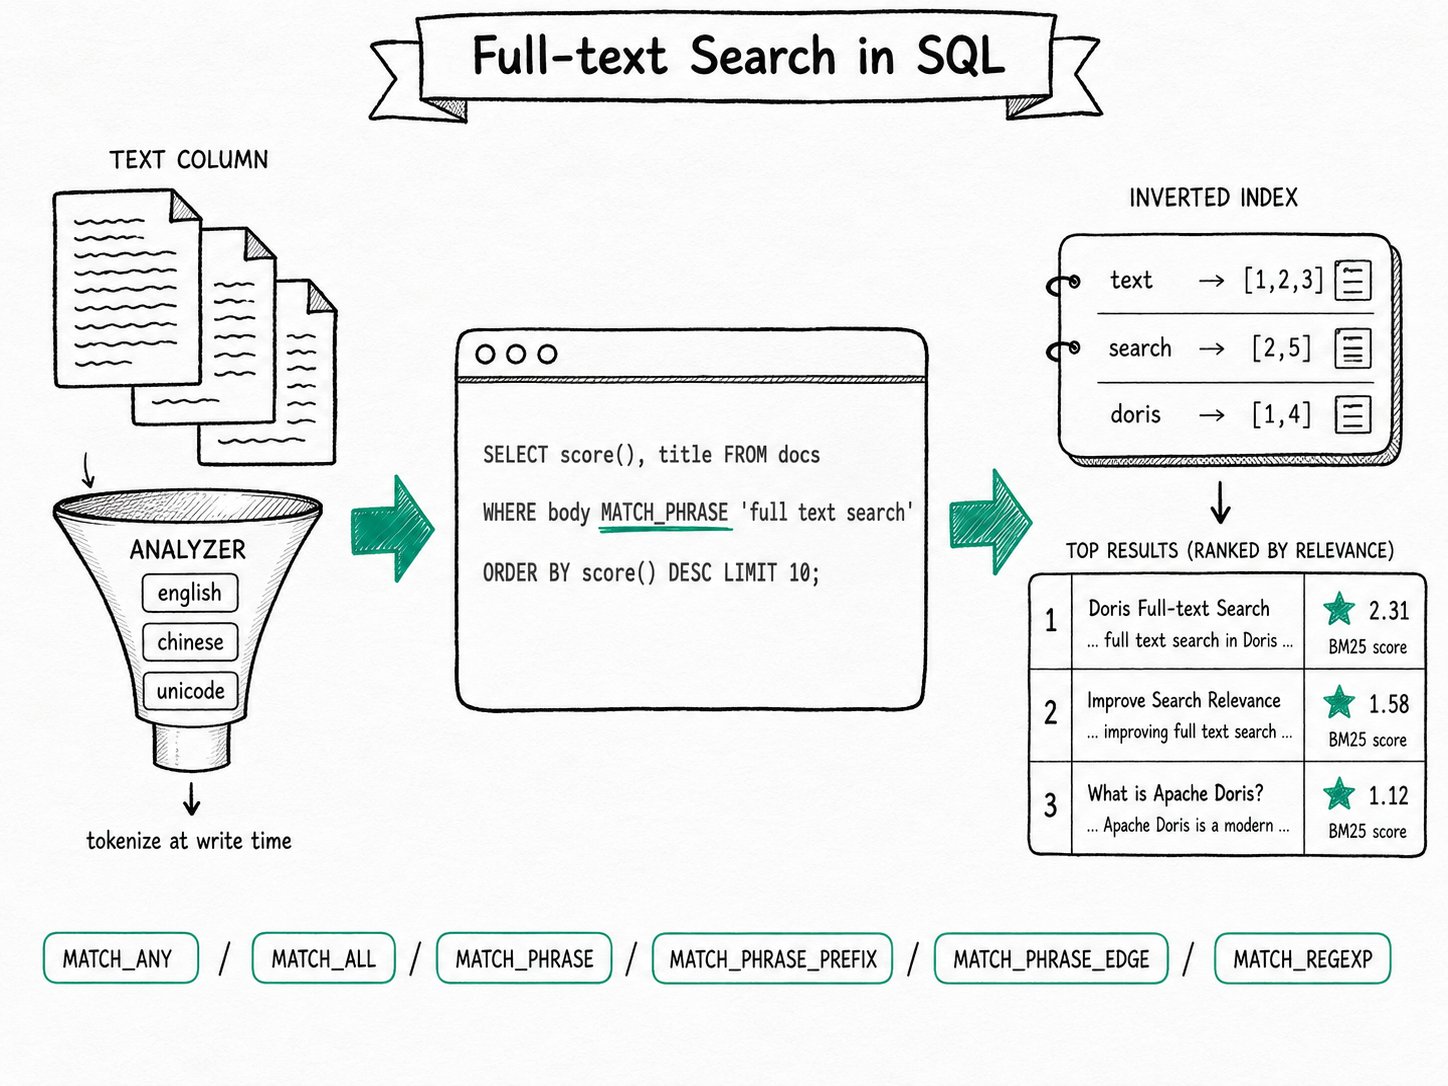
MATCH_*연산자인MATCH_ANY,MATCH_ALL,MATCH_PHRASE,MATCH_PHRASE_PREFIX,MATCH_PHRASE_EDGE,MATCH_REGEXP를 통해 검색할 수 있게 합니다. 인덱스를 생성할 때 토크나이저를 선택하고 일반적인 SQL 쿼리를 작성하면 됩니다. Apache Doris 플래너가 조건자를 인덱스로 푸시다운하므로 별도의 검색 클러스터가 필요하지 않습니다.
Apache Doris에서 전문 검색을 사용하는 이유는 무엇인가요?
Apache Doris 전문 검색은 본격적인 텍스트 검색과 데이터 웨어하우스 분석을 하나의 엔진으로 통합하며, 토큰을 인식하는 연산자로 LIKE 부분 문자열 매칭의 한계를 훨씬 뛰어넘습니다. 대부분의 데이터 웨어하우스는 LIKE '%foo%'를 제공하면서 이를 텍스트 검색이라고 부릅니다. 행 만 개 중 하나를 찾는 정도라면 괜찮습니다. 하지만 "battery" 또는 "batteries"를 언급하는 모든 주문 의견, "connection refused"라는 구문이 포함된 모든 로그 행, 설명이 "wireless"로 시작하는 모든 제품을 찾아야 하는 순간 한계에 부딪힙니다.
LIKE는 각 값을 처음부터 끝까지 바이트 단위로 읽습니다. 이 연산자는 "Running"과 "running"이 같은 단어라는 사실도, "search engine optimization"이 단순한 부분 문자열이 아니라 순서대로 나열된 세 개의 용어라는 사실도 알지 못합니다. 일반적인 우회 방법은 Elasticsearch를 별도로 붙이고, 두 번째 클러스터 비용을 부담하며, 쉽게 문제가 생기는 동기화 파이프라인을 작성하는 것입니다.
Apache Doris는 이를 하나의 엔진으로 통합합니다. 집계를 처리하는 동일한 테이블에서 텍스트 쿼리도 처리하며, 연산자 이름도 SQL에 익숙한 형태입니다.
- 부분 문자열을 찾는
LIKE는 전체 스캔으로 처리됩니다. 역색인은 텍스트 조건자를 포스팅 목록 조회로 바꿉니다. - 입력 중 검색, 구문 검색, 토큰에 대한 정규식 검색에는
LIKE로 표현할 수 없는 매칭 방식이 필요합니다. - 구조화된 조건자와 텍스트 조건자를 혼합한 경우에도(
category = 'A' AND content MATCH_ANY 'doris') 하나의 쿼리로 계획하고 실행합니다.
Apache Doris 전문 검색이란 무엇인가요?
Apache Doris 전문 검색은 역색인을 기반으로 하는 쿼리 기능입니다. INVERTED 인덱스를 STRING, TEXT, VARCHAR 또는 ARRAY<STRING> 컬럼에 선언하고 분석기를 선택하면, MATCH_* 연산자가 포함된 WHERE 절의 조건자가 인덱스로 푸시다운됩니다. 기본 테이블은 대시보드에서 이미 쿼리하고 있는 일반적인 Apache Doris 테이블 그대로입니다.
핵심 용어
- 분석기(파서): 원시 텍스트를 검색 가능한 용어로 변환하는 파이프라인입니다. 기본 제공 옵션으로는
none(정확히 일치),english,chinese,unicode,standard,icu가 있습니다. 사용자 정의 분석기는char_filter,tokenizer, 하나 이상의token_filter단계를 연결할 수 있습니다. - 용어 쿼리: 개별 토큰을 매칭합니다.
MATCH_ANY는 용어 간 OR를,MATCH_ALL은 용어 간 AND를 적용합니다. - 구문 쿼리: 순서대로 인접한 토큰을 매칭합니다. 토큰화를 수행하지 않는 파서에서는 인덱스에
"support_phrase" = "true"설정이 필요합니다. score(): BM25 관련성 점수입니다. 토큰화된 인덱스와MATCH_*조건자,ORDER BY score() LIMIT N이 있을 때 사용할 수 있습니다.
Apache Doris 전문 검색은 어떻게 동작하나요?
Apache Doris 전문 검색은 쓰기 시점에 텍스트를 토큰화하고, Nereids 옵티마이저에서 각 MATCH_* 조건자를 인식한 뒤 역색인으로 푸시다운하여 일치하지 않는 행은 디코딩하지 않는 방식으로 동작합니다. 아래의 다섯 단계는 파싱, 푸시다운, 점수 산정, 구조화된 조건자와의 결합 과정을 설명합니다.
- 쓰기 시점에 토큰화합니다. 행이 태블릿에 기록되면 분석기가 각 텍스트 값을 용어로 분리합니다. 역색인은 각 용어에 대해 해당 용어가 포함된 행과 위치를 기록합니다.
- 쿼리를 파싱합니다. Nereids는
MATCH_*연산자를Match,MatchAny,MatchAll,MatchPhrase,MatchPhrasePrefix,MatchPhraseEdge,MatchRegexp중 하나로 인식합니다. 각 연산자는 쿼리 문자열 자체의 토큰화 방식을 제어하는 분석기 힌트를 가집니다. - 인덱스로 푸시다운합니다. BE는 일치하는 포스팅 목록을 조회하고, 연산자에 따라 교집합 또는 합집합을 구한 다음 행 비트맵을 반환합니다. 일치하지 않는 행은 디코딩하지 않습니다.
- 요청이 있으면 점수를 계산합니다. 쿼리에
SELECT score() ... ORDER BY score() DESC LIMIT N이 있으면 Doris는 BM25(용어 빈도, 역문서 빈도, 길이 정규화)를 계산하고 상위 N개를 반환합니다. 이 세 요소가 없으면 조건자는 단순 필터로 동작합니다. - 자유롭게 결합합니다. 하나의 쿼리에서
MATCH_*를=,IN, 범위 필터, 조인, 집계와 함께 사용할 수 있습니다. 옵티마이저는 텍스트 조건자도 다른 조건자처럼 푸시다운합니다.
빠른 시작
CREATE TABLE articles (
  id INT,
  title  STRING,
  body   STRING,
  INDEX idx_body (body) USING INVERTED
    PROPERTIES("parser" = "english", "support_phrase" = "true")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'Doris 4.0 release', 'Apache Doris adds BM25 scoring for full-text search'),
  (2, 'Storage notes',     'Inverted indexes accelerate text and structured filters'),
  (3, 'Vector primer',     'Approximate nearest neighbor search complements text search');

SELECT id, title, score() AS rel
FROM articles
WHERE body MATCH_ANY 'text search'
ORDER BY rel DESC LIMIT 3;
예상 결과
+------+-------------------+------------+
| id   | title             | rel        |
+------+-------------------+------------+
|    3 | Vector primer     |  0.8009131 |
|    1 | Doris 4.0 release |  0.5634479 |
|    2 | Storage notes     | 0.13845673 |
+------+-------------------+------------+
MATCH_ANY 'text search'는 쿼리를 text와 search로 토큰화한 뒤, 두 포스팅 목록을 조회하여 어느 한 용어라도 포함된 행을 반환합니다. score()는 ORDER BY rel LIMIT 3으로 인해 옵티마이저가 이를 Top-N 쿼리로 처리하게 되면 BM25에 따라 순위를 매깁니다. 3번 행은 두 용어를 모두 포함하고(search는 두 번), 1번 행은 두 용어를 각각 한 번씩 포함하며, 2번 행은 text만 포함합니다.
연산자 종류 한눈에 보기
| 연산자 | 용도 |
|---|---|
MATCH / MATCH_ANY | 키워드 중 하나라도 포함된 항목 검색(OR) |
MATCH_ALL | 모든 키워드가 포함된 항목 검색(AND) |
MATCH_PHRASE 'a b' | 순서대로 인접한 용어 검색. ~slop과 엄격한 순서를 적용하는 ~slop+ 지원 |
MATCH_PHRASE_PREFIX 'a b' | 마지막 용어가 접두사인 구문 검색. 입력 자동 완성에 사용 |
MATCH_PHRASE_EDGE 'a b c' | 첫 용어는 접미사로, 중간 용어는 정확히 일치하도록, 마지막 용어는 접두사로 매칭 |
MATCH_REGEXP '^abc.*' | 원시 바이트가 아닌 토큰에 정규식 적용 |
하나의 컬럼에 서로 다른 분석기를 사용하는 역색인이 여러 개 있으면, USING ANALYZER <name>을 덧붙여 쿼리 시점에 사용할 분석기를 선택할 수 있습니다.
Apache Doris 전문 검색은 언제 사용해야 하나요?
Apache Doris 전문 검색은 로그/트레이스 검색, 전자 상거래 Catalog 검색, CJK와 라틴 문자가 혼합된 콘텐츠, 입력 중 검색, 텍스트 매칭과 벡터 유사도를 결합하는 RAG 파이프라인에 사용하세요. 토큰 내부의 부분 문자열 검색, 편집 거리 기반 유사 매칭 또는 결과 하이라이팅이 필요할 때는 LIKE나 n-gram 인덱스를 사용하세요.
적합한 용도
- 사용자가 자유 텍스트와 구조화된 필터를 함께 사용하는 로그 및 트레이스 검색(
level = 'ERROR' AND message MATCH_ANY 'timeout disconnect'). - 같은 행에 가격, 카테고리, 설명이 있는 전자 상거래 및 Catalog 검색.
- CJK와 라틴 문자가 혼합된 콘텐츠.
chinese,unicode,icu파서는 하나의 컬럼에서 두 유형을 모두 처리합니다. - 입력 중 검색.
MATCH_PHRASE_PREFIX는 별도의 자동 완성 서비스 없이 자동 완성 결과를 반환합니다. - 텍스트 매칭과 임베딩 유사도를 결합하는 RAG 파이프라인. 하이브리드 검색에서
MATCH_*와 벡터 거리를 하나의 SQL로 결합하는 방법을 확인하세요.
적합하지 않은 용도
- 단일 토큰 내부의 부분 문자열 검색(컬럼의 "year"에 포함된 "ear"를 찾아 해당하는 모든 행 검색). 토큰화하면 데이터를 이런 방식으로 볼 수 없게 됩니다.
LIKE, N-Gram BloomFilter 인덱스 또는 토큰화하지 않은 역색인을 사용하세요. - 유사 매칭 / 편집 거리 기반 매칭("다음을 찾으셨나요..."). Doris는 현재 기본 제공 유사 매칭 연산자를 제공하지 않습니다. 쓰기 시점에 발음 기반 또는 n-gram 분석기로 전처리하거나, 애플리케이션에서 유사한 쿼리를 생성하세요.
- 결과 하이라이팅(매칭된 구간에 마크업을 붙여 반환). Doris는 점수를 계산하지만 현재 하이라이트 조각을 출력하지는 않습니다. 애플리케이션에서 매칭된 용어를 바탕으로 하이라이트를 표시하세요.
- Elasticsearch의
dis_max와 같은 여러 필드 간 관련성 순위 계산.score()는 조건자별로 동작합니다. 더 정교한 점수 산정 전략이 필요하면SEARCH('title:foo OR body:foo')를 사용하고 애플리케이션 계층에서 조정하세요.
토크나이저 선택
분석기는 가장 신중하게 선택해야 할 요소입니다. 어떤 쿼리가 매칭될지 결정하며, 인덱싱된 용어는 쓰기 시점에 확정됩니다.
none: 토큰화하지 않습니다. 전체 값이 하나의 용어가 됩니다. ID, 태그, 상태 열거형, 정확히 일치하는 필터에 적합합니다.english: ASCII 단어 분리와 가벼운 정규화를 수행합니다. 영어 텍스트에 적합합니다.chinese: 중국어 단어 분할을 수행하며,parser_mode는fine_grained또는coarse_grained입니다. CJK 콘텐츠에 적합합니다.kuromoji(5.0.0+): 일본어 형태소 분석입니다. 일본어는 단어 사이에 공백이 없으므로 사전을 기반으로 텍스트를 형태소로 분할합니다.parser_mode로search(기본값이며, 검색 재현율을 높이기 위해 긴 복합 명사도 분리),normal,extended중 하나를 선택합니다. 일본어 콘텐츠에 적합합니다. 기본적으로 비활성화되어 있으므로enable_kuromoji_analyzer = true를be.conf에 설정해 활성화하세요.unicode: 언어에 종속되지 않는 방식으로 CJK와 문장 부호의 단어 경계를 구분합니다. 혼합 콘텐츠에 적절한 기본 선택입니다.standard: Unicode 텍스트 분할 토크나이저입니다. 대부분의 언어에서 사용할 수 있습니다.icu: 완전한 Unicode 분할 규칙이 필요한 언어(태국어, 크메르어, 여러 문자 체계가 혼합된 텍스트)를 위한 ICU 기반 토크나이저입니다.- 사용자 정의 분석기 (3.1+): 접두사 자동 완성용
edge_ngram, 카멜 표기법과 하이픈으로 연결된 용어 처리용word_delimiter, 대소문자와 악센트를 구분하지 않는 검색용lowercase와asciifolding등을 연결할 수 있습니다.
분석기를 변경하려면 BUILD INDEX로 인덱스를 다시 빌드해야 합니다.
더 읽어보기
- 역색인: 이러한 연산자를 지원하는 인덱스 구조와 스토리지 레이아웃, 빌드 및 컴팩션 동작.
- BM25 관련성 점수 산정:
score()의 계산 방식과 활성화 조건,k1과b를 조정하는 방법. - 하이브리드 검색: 사전 필터링 / 대체 처리 방식을 포함해
MATCH_*와 벡터 ANN 거리를 하나의 SQL로 결합하는 방법. - 검색 연산자 레퍼런스: slop 구문, 접두사 규칙,
USING ANALYZER를 포함한 전체 연산자 Catalog. - 사용자 정의 분석기 가이드: 문자 필터, 토크나이저, 토큰 필터에 대한 자세한 설명.
- SEARCH 함수: 여러 컬럼에 걸쳐 여러 연산자를 결합하는 단일 문자열 DSL.
- 상호 순위 융합: 하나의 점수 산정 방식만으로 충분하지 않을 때 BM25 순위와 벡터 순위를 융합하는 SQL 패턴.