Group Commit
요약 Apache Doris Group Commit은 여러 소규모
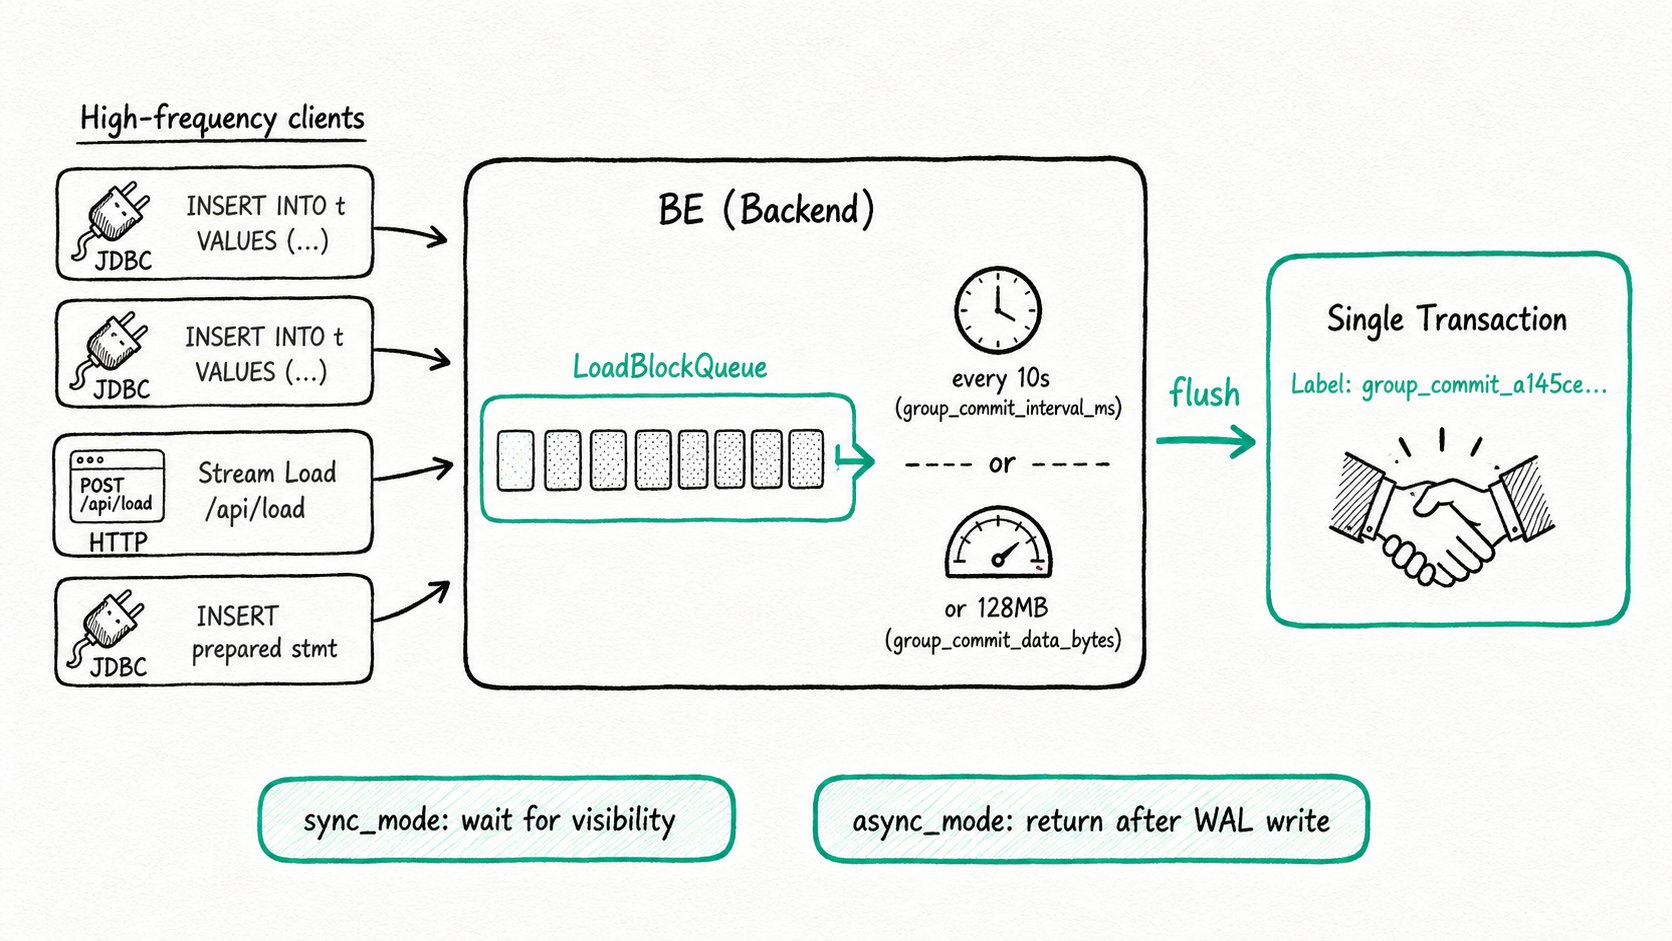
INSERT VALUES문이나 Stream Load를 서버 측에서 하나의 트랜잭션으로 묶습니다. 이를 통해 고빈도로 데이터를 쓰는 클라이언트가 FE에 과도한 구문 분석 및 실행 계획 수립 작업을 유발하거나 BE에 작은 rowset을 쌓는 문제를 해소합니다. 데이터가 조회 가능한 상태가 될 때까지 데이터 적재 요청이 대기해야 한다면sync_mode를, 행이 write-ahead log에 영구 기록되는 즉시 응답해야 한다면async_mode를 선택하세요. Group Commit을 사용하면-235백프레셔 오류가 발생하던 동일한 워크로드에서 단일 BE로 초당 100,000개 이상의 행을 처리할 수 있습니다.
Apache Doris에서 Group Commit을 사용하는 이유는 무엇인가요?
Apache Doris Group Commit은 고빈도로 데이터를 쓰는 클라이언트가 FE 플래너와 BE 스토리지 엔진에 유발하는 쓰기별 오버헤드를 없앱니다. 실제로 많은 시스템이 행별 INSERT INTO ... VALUES와 소규모 배치 Stream Load를 통해 Doris에 데이터를 씁니다. 마이크로서비스는 사용자가 무언가를 클릭할 때마다 JDBC를 통해 INSERT를 호출합니다. Kafka 컨슈머는 수백 밀리초마다 그때까지 모인 데이터를 플러시합니다. IoT 수집기는 이벤트가 도착하는 즉시 각 이벤트를 전송합니다. 아직 발생하지 않은 이벤트를 미리 모을 수는 없으므로, 이러한 클라이언트는 배치 크기를 더 키울 수 없습니다. 배치로 묶지 않으면 데이터 적재마다 별도의 트랜잭션을 열고 FE 플래너를 거쳐 새로운 tablet 버전을 생성합니다. 바로 이 조합이 Doris 스토리지 엔진에 부담을 줍니다.
- 고빈도
INSERT VALUES는 BE의 CPU가 포화되기 전에 FE의 파서와 플랜 캐시를 포화시킵니다. - 스트리밍 파이프라인의 소규모 Stream Load는 백그라운드 compaction이 따라잡을 수 없을 때까지 tablet 버전을 쌓습니다. 대표적인 증상은
-235"세그먼트가 너무 많음" 오류입니다. - 데이터 적재마다 별도의 트랜잭션이 생성되어, 실제 데이터 처리만큼이나 커밋 핸드셰이크에 시간이 소요됩니다.
Group Commit은 클라이언트가 이를 인지하거나 신경 쓸 필요 없이, 서버에서 이러한 소규모 쓰기 여러 건을 하나의 트랜잭션으로 묶습니다.
Apache Doris Group Commit이란 무엇인가요?
Apache Doris Group Commit은 소규모 쓰기를 위한 서버 측 버퍼입니다. BE는 동시에 실행되는 여러 데이터 적재에서 행을 수집하고, 수 초마다 또는 버퍼가 가득 차면 하나의 트랜잭션으로 커밋합니다. Group Commit은 INSERT INTO ... VALUES, Stream Load, JDBC prepared statement의 공개 API를 변경하지 않고 그 위에서 동작합니다. INSERT용 세션 변수, Stream Load용 HTTP 헤더, 기본값을 지정하는 테이블 속성 중 하나만 설정하면 활성화할 수 있습니다. 선택한 모드에 따라 데이터 적재 요청의 응답 시점이 결정됩니다.
주요 용어
group_commit: 모드를 선택하는 세션 변수(INSERT용)이자 HTTP 헤더(Stream Load용)입니다. 값:off_mode,sync_mode,async_mode.sync_mode: BE에서 동시에 실행되는 다른 데이터 적재의 행과 병합하며, 병합된 트랜잭션이 커밋되어 조회 가능한 상태가 될 때까지 요청이 대기합니다.async_mode: BE의 write-ahead log에 행을 기록하고, 요청은 즉시PREPARE상태로 응답하며, 병합된 트랜잭션은 나중에 커밋됩니다.WAL:async_mode에서 사용하는 BE별 write-ahead log입니다. 단일 복제본이며, 요청을 수신한 BE에 저장됩니다.group_commit_interval_ms및group_commit_data_bytes: 테이블별 플러시 트리거입니다. 기본값: 10s 및 128 MB.
Apache Doris Group Commit은 어떻게 동작하나요?
Apache Doris Group Commit은 동시에 실행되는 소규모 데이터 적재를 테이블별로 공유하는 하나의 BE 큐에 모으고, 타이머나 크기 임계값에 따라 큐를 플러시한 다음, 병합된 배치를 하나의 FE 트랜잭션으로 커밋합니다.
- 큐를 열거나 기존 큐에 합류합니다. 요청이 BE에 도착합니다. BE는 새 트랜잭션을 시작하는 대신, 테이블과 현재 열려 있는 Group Commit 트랜잭션을 키로 사용하는
LoadBlockQueue에 행을 넣습니다. - (비동기 모드만 해당) WAL에 기록합니다.
async_mode에서는 행을 로컬 WAL에도 영구 기록하므로, 기록이 완료되는 즉시 요청에 응답할 수 있습니다.sync_mode에서는 이 단계를 건너뜁니다. - 플러시 트리거를 기다립니다. BE는
group_commit_interval_ms가 경과하거나 큐에 쌓인 데이터가group_commit_data_bytes에 도달하면 큐를 플러시합니다. 두 속성 모두 테이블별로 설정합니다. - 배치를 하나의 트랜잭션으로 커밋합니다. BE는 병합된 배치를 스토리지 엔진으로 전달하고, FE는 정확히 하나의 트랜잭션을 커밋합니다. FE는
group_commit_접두사가 붙은 하나의 Label을 할당하며, 병합된 모든 데이터 적재가 이를 공유합니다. - 응답합니다.
sync_mode요청은 이 시점까지 대기하다가 응답합니다.async_mode요청은 이미 앞서 응답했으며, 이 시점에 데이터를 쿼리할 수 있게 됩니다.
요청이 폴백 조건(명시적 트랜잭션, 사용자가 지정한 Label, 일부 컬럼 업데이트, VALUES 내 표현식, async_mode에서 WAL 디스크 공간 부족)에 해당하면 Doris는 해당 요청만 별도 알림 없이 일반 데이터 적재 경로로 처리합니다. 요청의 형태만으로 처리 경로가 결정됩니다.
빠른 시작
CREATE TABLE events (
  id BIGINT, ts DATETIME, payload STRING
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 4
PROPERTIES ("group_commit_interval_ms" = "1000");

SET group_commit = async_mode;
INSERT INTO events VALUES (1, NOW(), 'a');
INSERT INTO events VALUES (2, NOW(), 'b');
-- the second insert merges into the first one's transaction
예상 결과
Query OK, 1 row affected (0.01 sec)
{'label':'group_commit_a145ce07f1c972fc-bd2c54597052a9ad', 'status':'PREPARE', 'txnId':'181508'}
두 INSERT가 동일한 label과 txnId를 반환하므로, 하나의 트랜잭션으로 병합되었음을 알 수 있습니다. 행은 BE가 플러시할 때까지 조회되지 않습니다(여기서는 테이블의 group_commit_interval_ms를 1000으로 설정했으므로 일 초 뒤에 조회할 수 있습니다). Stream Load에서는 세션 변수 대신 헤더를 사용하세요: -H "group_commit:async_mode".
Apache Doris Group Commit은 언제 사용해야 하나요?
여러 클라이언트가 동시에 소규모 배치를 쓰고, 클라이언트 측에서 배치 크기를 더 키울 수 없을 때 Apache Doris Group Commit을 사용하세요.
적합한 경우
- JDBC를 통해 수십 TPS 이상으로 이벤트마다
INSERT INTO ... VALUES를 실행하는 마이크로서비스. - 배치를 MB 미만 크기로만 묶을 수 있고 BE에서
-235오류를 유발하는 Kafka 또는 Flink sink. - 각 이벤트를 수 초 내에 적재해야 하지만 클라이언트를 통합할 수 없는 IoT 또는 클릭 스트림 파이프라인.
- 개별 데이터 적재로 인한 잦은 tablet 버전 생성이 백그라운드 compaction에 과도한 부담을 주는 테이블.
적합하지 않은 경우
- 호출 측의 상태 관리 작업과 정확히 하나의 트랜잭션으로 처리해야 하는 데이터 적재. 명시적
BEGIN ... COMMIT을 사용하면 Group Commit은 별도 알림 없이 일반 데이터 적재 경로로 전환됩니다. 트랜잭션이 필요한 sink에는 데이터 적재 트랜잭션을 직접 사용하세요. - Stream Load 2PC 및 자체 Label을 지정하는 쓰기. 둘 다 Group Commit을 우회합니다. 체크포인트를 기준으로 exactly-once 처리가 필요하다면 Stream Load 2PC를 계속 사용하세요.
- 일부 컬럼 업데이트. Group Commit은
partial_columns: true를 지원하지 않으며, 일반 데이터 적재 경로로 전환됩니다. - 엄격한 커밋 순서 보장이 필요한 Unique Key 테이블. Group Commit은 병합된 데이터 적재 간의 순서를 보장하지 않습니다.
function_column.sequence_col을 지정하여 사용자가 제공한 타임스탬프를 기준으로 최신 버전이 선택되도록 하세요. - 단일 데이터 적재의 배치가 이미 큰 경우(수백 MB 이상). 일반 데이터 적재 한 번으로 처리하는 것과 비교하면 Group Commit의 조정 작업은 불필요한 오버헤드입니다. 그대로 데이터 적재 요청을 제출하세요.
성능 / 수치
Apache Doris 2.1.0 릴리스 노트에 제시된 수치입니다.
- JDBC, FE 1개 + BE 1개, TPC-H SF10 Lineitem, 동시 실행 수 20, INSERT당 100개 미만의 행:
async_mode에서 106,900행/초. - Stream Load, BE 3개, 동시 실행 수 10, 1 MB 미만 배치: 810,000행/초, 104 MB/초. Group Commit을 사용하지 않으면 동일한 워크로드에서
-235오류가 발생하고 처리가 정체됩니다. - Stream Load, BE 3개, 동시 실행 수 30에서 1 MB 배치: 2,077,723행/초.
출처: Apache Doris 2.1.0 릴리스 노트.
더 읽어보기
- 높은 동시 실행 환경의 데이터 적재 최적화(Group Commit)
- Stream Load HTTP 헤더 참조
- INSERT INTO 데이터 적재
- 데이터 적재 트랜잭션: 명시적
BEGIN ... COMMIT또는 2PC가 필요한 경우 - Stream Load: Group Commit이 서버 측에서 배치로 묶는 동기 HTTP 데이터 적재 경로입니다.
- Apache Doris 2.1.0: Group Commit 벤치마크
- Unique Key: 단일 행 UPDATE가 빈번하게 반복되는 테이블 모델이며, Group Commit은 이러한 작업을 배치로 묶도록 설계되었습니다.