고동시성 포인트 쿼리
핵심 요약 Apache Doris는 컬럼 기반 OLAP 엔진이지만, 기본 키 동등 조회에는 다른 경로를 사용합니다. Unique Key 모델에 Merge-on-Write, 행 형식 스토리지(
store_row_column), short-circuit 쿼리 경로, 서버 측PreparedStatement를 함께 사용하면SELECT * FROM t WHERE pk = ?쿼리는 일반적인 OLAP 쿼리와 전혀 다른 방식으로 실행됩니다. BE와 한 번 왕복하여 행 하나를 반환하며, 실행 계획 파싱이나 fragment 스케줄링은 수행하지 않습니다. 이 덕분에 별도의 데이터베이스를 구축하지 않고도 동일한 데이터베이스에서 대시보드 위젯과 팩트 테이블 집계에 필요한 쿼리를 모두 처리할 수 있습니다.
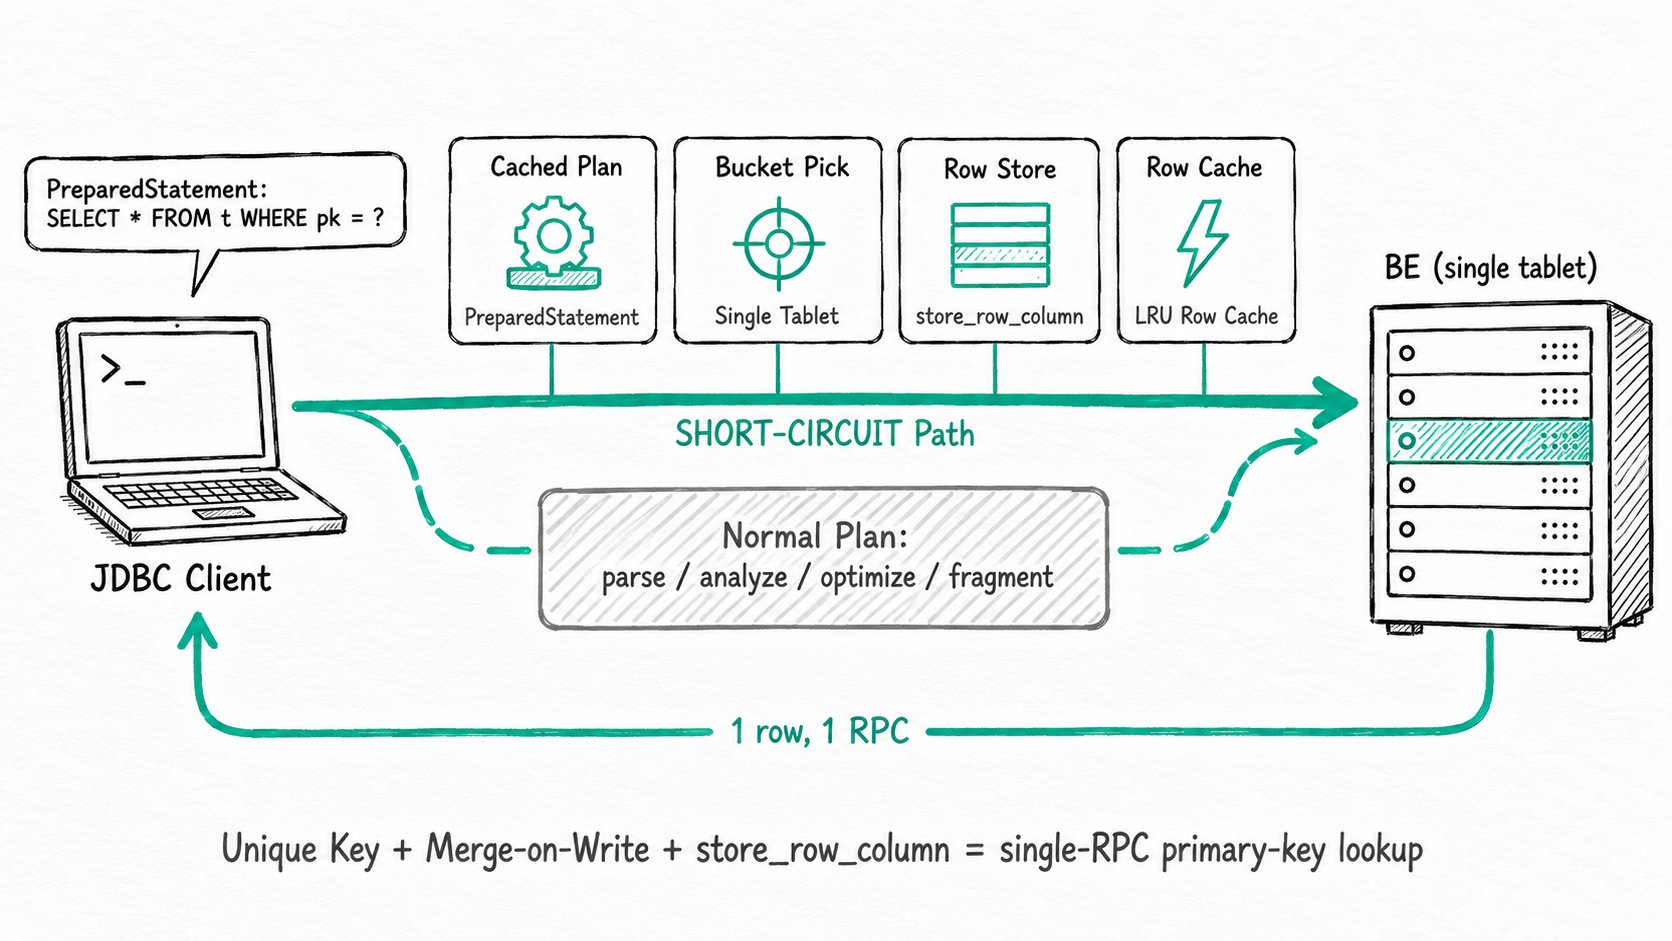
Apache Doris에서 고동시성 포인트 쿼리를 사용하는 이유는 무엇인가요?
Apache Doris의 고동시성 포인트 쿼리 경로는 대부분의 분석 워크로드 곳곳에 숨어 있는 다양한 "ID로 행 하나 조회" 쿼리를 처리하기 위해 마련되었습니다. 사용자용 대시보드는 방금 클릭한 고객의 행을 가져옵니다. 리스크 관리 서비스는 API 호출마다 엔터티 ID로 특성 벡터를 읽습니다. 추천 백엔드는 사용자별 최신 프로필을 가져옵니다. 이들 작업은 분석 작업은 아니지만, 필요한 데이터는 분석 데이터와 함께 저장되어 있으며, 이런 조회만을 위해 별도의 KV 스토어를 운영하고 싶어 하는 사람은 없습니다.
기본 구성의 Apache Doris는 이러한 트래픽에 적합하지 않으며, 그 이유는 구조에 있습니다.
- 컬럼 기반 스토리지는 행 하나를 재구성하기 위해 여러 개의 작은 컬럼 파일을 읽으므로, 컬럼이 많은 테이블에서 랜덤 IO가 증가합니다.
- Frontend 플래너는 쿼리가 행 하나를 읽든 십억 개를 읽든 동일한 파싱, 분석, 최적화, fragment 처리 파이프라인을 실행합니다. QPS가 수천에 이르면 BE가 부하를 느끼기도 전에 FE CPU가 포화 상태에 도달합니다.
- 모든 쿼리는 각각 coordinator를 생성하고, fragment를 할당하고, RPC를 전송합니다.
WHERE id = 42같은 쿼리에는 감당하기 어려운 오버헤드입니다. - Page Cache는 컬럼 중심이며, 대규모 분석 스캔이 캐시를 계속 축출하므로 포인트 쿼리는 캐시가 꼭 필요할 때 캐시 미스를 겪습니다.
Apache Doris의 고동시성 포인트 쿼리는 이러한 트래픽을 처리하기 위한 해법입니다. 스토리지, 실행 계획 수립, 실행, 캐싱 방식을 바꾸어 기본 키 조회에 필요한 비용을 한 번의 왕복 통신과 몇 마이크로초의 FE CPU 사용으로 줄입니다.
Apache Doris 고동시성 포인트 쿼리란 무엇인가요?
Apache Doris의 고동시성 포인트 쿼리는 테이블과 쿼리가 모두 엄격한 조건을 충족할 때 자동으로 활성화되는 네 계층의 최적화입니다. Merge-on-Write와 row-store가 활성화된 Unique Key 테이블을 대상으로, 전체 기본 키를 포함하는 동등 조건으로 조회해야 합니다. 조건을 충족하면 플래너는 short-circuit 경로를 사용하고, BE는 컬럼별 파일에서 행을 조합하는 대신 행 형식 컬럼에서 행을 제공합니다.
핵심 용어
Unique Key model: 기본 키로 행을 식별하는 Apache Doris 테이블 모델입니다.enable_unique_key_merge_on_write=true를 사용하면 각 행의 최신 버전을 쓰기 시점에 구체화하므로 읽을 때 버전을 즉석에서 병합하지 않습니다.store_row_column: 각 행을 행 단위로 인코딩한 blob으로 보관하는 숨겨진 컬럼을 추가하는 테이블 속성입니다. 따라서 BE는 전체 행을 반환할 때 N개 컬럼 대신 컬럼 하나를 읽습니다.SHORT-CIRCUIT:EXPLAIN출력에 표시되는 마커로, 플래너가 일반적인 분산 실행 계획을 건너뛰고 단일 tablet, 단일 RPC 경로로 쿼리를 라우팅했음을 나타냅니다.PreparedStatement: MySQL 프로토콜을 통한 서버 측 구문 캐싱입니다. Apache Doris는 파싱된 구문, 출력 표현식, descriptor 테이블을 세션별로 캐시한 뒤 여러EXECUTE호출에서 재사용합니다.Row Cache: 전체 행을 보관하는 별도의 LRU 캐시입니다. 분석 쿼리와 포인트 쿼리가 혼재하는 워크로드에서 컬럼 기반 Page Cache가 겪는 축출 압박을 견딥니다.
Apache Doris 고동시성 포인트 쿼리는 어떻게 동작하나요?
Apache Doris의 고동시성 포인트 쿼리 경로는 스토리지 레이아웃, FE 실행 계획 재작성, short-circuit 디스패치, 서버 측 PreparedStatement 재사용, 선택적으로 Row Cache를 사용하는 BE 행 조회라는 다섯 계층을 연결합니다.
- 스토리지 레이아웃. 테이블 생성 시
store_row_column=true를 설정하면 BE는 각 행을 컬럼 기반 세그먼트와 행 단위로 인코딩한 숨겨진 컬럼에 모두 기록합니다. Apache Doris 3.0부터는row_store_columns="k1,v1,v2"로 일부 컬럼에만 적용하여 스토리지 오버헤드를 제한할 수 있습니다. - 실행 계획 재작성(FE). Nereids 규칙인
LogicalResultSinkToShortCircuitPointQuery는 쿼리의 형태를 검사합니다. 단일 Unique 테이블을 사용하고, 모든 키 컬럼에 동등 조건이 있으며, 조인이나 서브쿼리, 집계가 없어야 합니다. 모든 조건이 일치하면isShortCircuitQuery플래그를StatementContext에서 활성화합니다. - Short-circuit 디스패치. FE는 fragment를 생성하여 전송하는 대신,
PartitionPruneV2ForShortCircuitPlan을 통해 버킷을 결정하고 해당 키를 포함할 수 있는 tablet 하나를 선택한 뒤, 이를 보유한 BE에 단일 RPC를 전송합니다. - 서버 측
PreparedStatement재사용.useServerPrepStmts=true를 사용하면 FE는ShortCircuitQueryContext를 세션 UUID별로 캐시합니다. 이후의EXECUTE호출은 파싱과 실행 계획 수립을 완전히 건너뛰며, 매개변수 값만 변경됩니다. - BE 행 조회.
point_query_executor는 키로 행을 찾고, 행 형식 컬럼을 읽어 바이트를 반환합니다. 선택 사항인 Row Cache에서 캐시 히트가 발생하면 세그먼트 읽기까지 건너뜁니다.
빠른 시작
CREATE TABLE tbl_point_query (
  k1 INT,
  v1 VARCHAR(64),
  v2 DECIMAL(27, 9)
)
UNIQUE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1
PROPERTIES (
  "enable_unique_key_merge_on_write" = "true",
  "light_schema_change" = "true",
  "store_row_column" = "true"
);

EXPLAIN SELECT * FROM tbl_point_query WHERE k1 = 42;
예상 결과(발췌)
0:VOlapScanNode
  TABLE: tbl_point_query, PREAGGREGATION: ON
  PREDICATES: k1 = 42 AND __DORIS_DELETE_SIGN__ = 0
  partitions=1/1, tablets=1/1
  SHORT-CIRCUIT
핵심은 SHORT-CIRCUIT 줄입니다. 이 줄이 없다면, 같은 DDL을 사용하더라도 조건을 충족하지 못하는 쿼리(조인, 누락된 키 컬럼, 비동등 조건)는 일반적인 분산 실행 계획으로 처리됩니다. FE CPU 사용량 절감 효과까지 얻으려면 클라이언트를 jdbc:mysql://host:9030/db?useServerPrepStmts=true&cachePrepStmts=true로 연결하고 PreparedStatement에 ? 자리표시자를 사용하세요. fe.audit.log에서 반복 쿼리가 원시 SQL 대신 Stmt=EXECUTE(...)로 기록되는지 확인하세요.
Apache Doris 고동시성 포인트 쿼리는 언제 사용해야 하나요?
Apache Doris의 고동시성 포인트 쿼리는 요청마다 기본 키로 행을 읽는 모든 온라인 서비스에 적합합니다. 특히 데이터가 이미 분석 워크로드와 함께 Unique Key 테이블에 저장되어 있을 때 유용합니다.
적합한 경우
- 요청마다 기본 키로 행을 읽는 온라인 서비스: 사용자 프로필, 특성 벡터, 상태 플래그, 조회 테이블.
- 별도의 KV 스토어를 사용하면 데이터와 운영 부담이 중복되는 OLAP 및 포인트 쿼리 혼합 워크로드.
- 이미 JDBC를 통해
PreparedStatement를 사용하는 고QPS 클라이언트. row_store_columns로 자주 사용하는 소수의 컬럼에만 행 저장소를 적용할 수 있는, 컬럼 수가 많은 Unique Key 테이블.
적합하지 않은 경우
- 범위 쿼리(
k1 BETWEEN 1 AND 1000). short-circuit 경로는 모든 키 컬럼에 동등 조건이 있어야 합니다. 일반 스캔으로 실행하고 데이터 프루닝을 활용하세요. - 여러 행을 대상으로 하는 집계나 조인.
GROUP BY pk만 있어도 재작성 대상에서 제외됩니다. 일반적인 OLAP 쿼리로 실행하세요. - 키가 아닌 컬럼을 통한 조회. row-store 대신 보조 인덱스 또는 역색인을 추가하세요.
- 생성 시 row-store를 활성화하지 않은 테이블.
store_row_column은CREATE TABLE에서만 설정할 수 있습니다. 기존 테이블에 필요하다면 테이블을 다시 생성한 뒤 데이터 적재를 다시 수행하세요. - 읽기는 드물고 쓰기가 대부분인 워크로드. 행 형식 스토리지는 저장 공간과 쓰기 IO를 늘립니다. 키로 읽는 일이 거의 없다면 이를 사용하지 않고 컬럼 기반 스토리지만 사용하세요.
성능 및 검증
Apache Doris에 따르면 FE CPU가 병목일 때 short-circuit 경로에 서버 측 PreparedStatement를 추가로 활성화하면 처리량이 4배 이상 향상됩니다. 이는 Prepared Statement 카드에서 prepared statement 관점으로 언급한 4배와 같은 효과이며, 서로 중첩할 수 있는 두 가지 효과가 아니라 하나의 통합된 효과입니다. 수치는 행의 폭, Row Cache 적중률, 트래픽을 처리하는 FE Observers 수에 따라 달라지므로, 벤치마크 수치가 아니라 계획을 세울 때의 하한 기준으로 보세요.
다음 두 가지를 확인하면 이 경로가 활성화되어 있는지 알 수 있습니다.
- 쿼리에 대한
EXPLAIN결과의 스캔 노드에SHORT-CIRCUIT이 표시됩니다. fe.audit.log에 반복 조회가 원시 SQL 문자열 대신Stmt=EXECUTE(...)로 표시됩니다.
FE CPU가 여전히 성능의 한계 요인이라면 Observers를 확장하고 JDBC 로드 밸런싱(jdbc:mysql:loadbalance://host1,host2,host3/db?useServerPrepStmts=true&cachePrepStmts=true)을 사용하여 연결을 분산하세요. 컴퓨팅과 스토리지가 분리된 배포 환경에서는 SET GLOBAL enable_snapshot_point_query=false와 BE 플래그 enable_file_cache_keep_base_compaction_output=1도 고려하여 Base Compaction 출력이 파일 캐시에 유지되도록 하세요.
더 읽어보기
- 고동시성 포인트 쿼리(전체 가이드)
- Row Store 스토리지 레이아웃
- 인덱스 개요: 보조 인덱스, bloom 인덱스, 역색인
- 데이터 프루닝: 포인트 쿼리 외의 쿼리 가속
- MPP 아키텍처: 포인트 쿼리의 short-circuit 경로가 건너뛰도록 설계된 전체 분산 실행 경로입니다.
- Unique Key: 포인트 쿼리와
store_row_column을 함께 사용해 KV 스토어로 동작하도록 하는 테이블 모델입니다.