Iceberg
핵심 요약 Apache Doris는 읽기뿐 아니라 쓰기까지 지원하는 완전한 Apache Iceberg 엔진입니다.
CREATE CATALOG한 번으로 Apache Doris를 일곱 가지 Iceberg 백엔드(REST, HMS, Glue, S3 Tables, JDBC, DLF, Hadoop) 중 어느 것에든 연결할 수 있습니다. 연결한 뒤에는 SQL만으로 쿼리,INSERT,UPDATE,DELETE,MERGE INTO, 브랜치 및 태그 관리, 타임 트래블, 스키마 및 파티션 변경, 유지보수(expire_snapshots,rewrite_data_files,rewrite_manifests)를 수행할 수 있습니다. Apache Doris는 V2 position delete와 equality delete를 읽고 쓰며, 4.1부터 V3 deletion vector(Puffin)를 지원합니다.
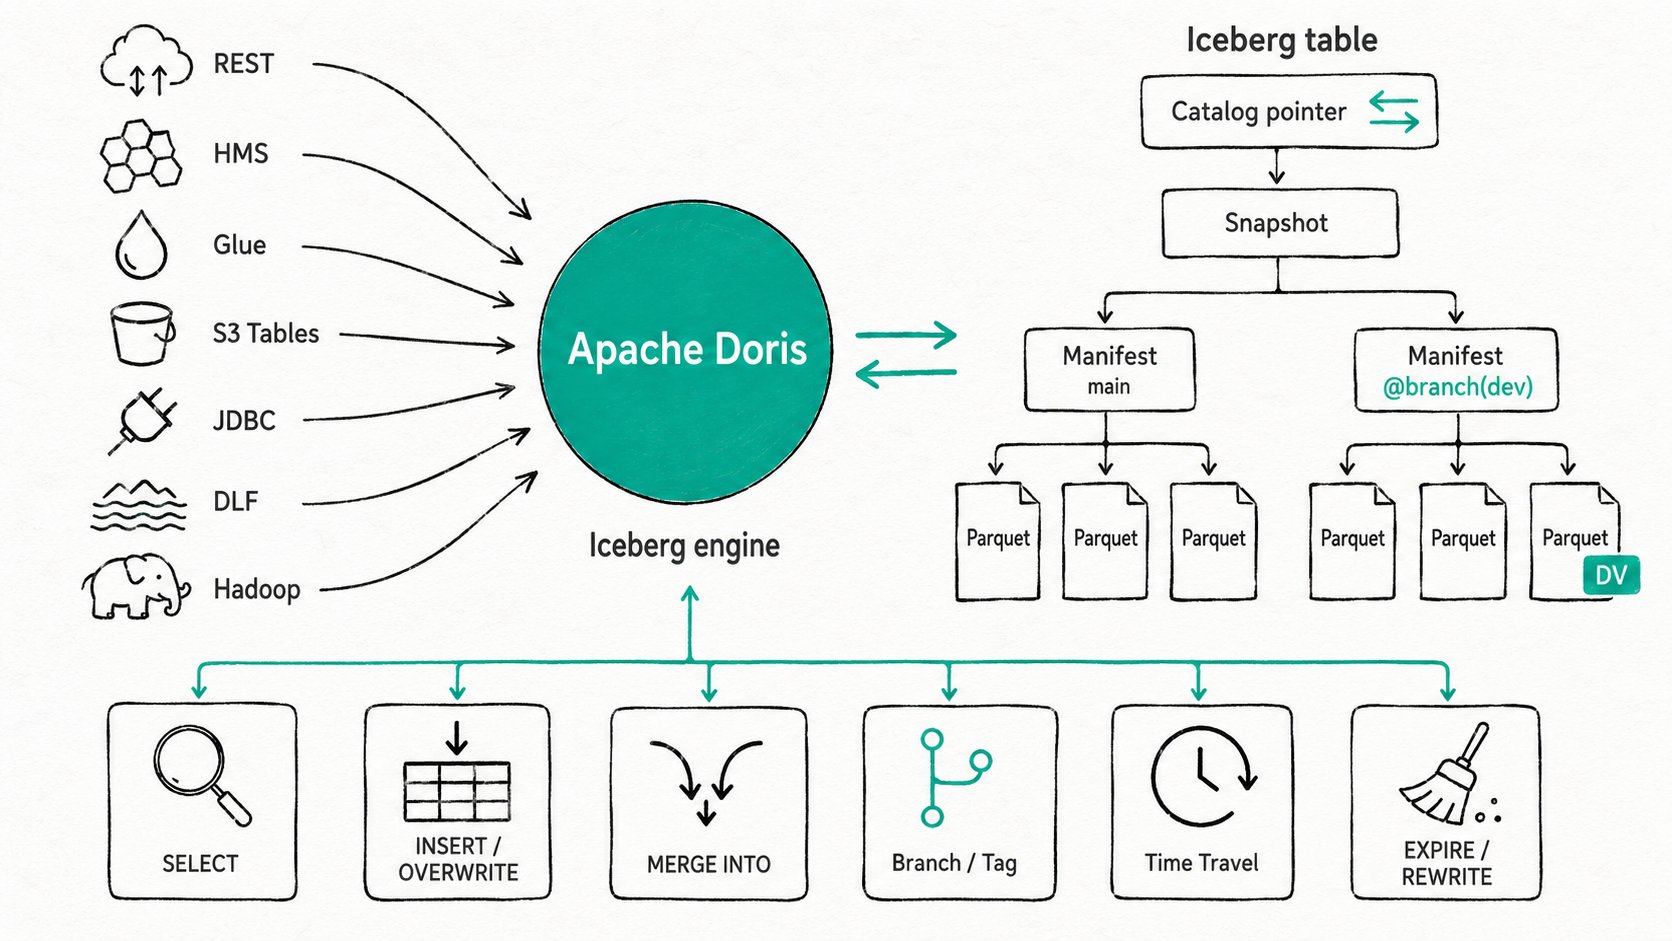
Apache Doris Iceberg Catalog를 사용하는 이유는 무엇인가요?
Apache Doris Iceberg Catalog는 읽기와 쓰기를 모두 지원하는 완전한 엔진입니다. 따라서 대시보드를 제공하는 클러스터에서 Spark나 Flink에 작업을 넘기지 않고도 Iceberg에 행을 기록하고, 유지보수를 수행하고, 브랜치를 관리할 수 있습니다. Iceberg의 매력은 특정 엔진에 종속되지 않는다는 점입니다. 데이터는 객체 스토리지에 Parquet 형식으로 저장되고, 테이블 레이아웃은 개방형 명세에 정의됩니다. 이 명세를 지원하는 엔진이라면 데이터를 복사하지 않고도 같은 테이블을 읽고 쓸 수 있습니다. 하지만 엔진이 Iceberg를 읽기 전용 접근 경로로만 취급하는 순간 이러한 장점은 사라집니다. 연결 후 SELECT 몇 개를 실행하다가도 행을 기록해야 하는 순간 쓰기 작업을 위해 다시 Spark나 Flink를 구동해야 합니다. 테이블 하나를 위해 클러스터 두 개, SQL 방언 두 가지, 자격 증명 두 세트를 관리하게 되는 것입니다.
Apache Doris는 읽기와 쓰기를 모두 처리합니다. 대시보드를 제공하는 클러스터가 그 기반이 되는 Iceberg 테이블도 유지보수합니다.
- Iceberg 팩트 데이터와 Doris 웨어하우스를 조인하는 연합 쿼리는 복사 작업이 아니라 하나의 MPP 계획으로 실행됩니다.
- ELT 파이프라인은 표준 SQL로 Iceberg에 데이터를 다시 기록하므로 다른 엔진에서도 새 스냅샷을 즉시 확인할 수 있습니다.
- 유지보수(compaction, 스냅샷 만료, manifest 재작성)는 별도의 Spark 작업이 아니라
ALTER TABLE ... EXECUTE로 수행합니다.
이 카드에서는 Iceberg에 특화된 기능을 다룹니다. 서로 다른 유형의 Catalog를 아우르는 연합 쿼리는 Multi Catalog를, Iceberg, Hive, Paimon 전반의 쓰기 기능은 레이크 테이블 관리를 참고하세요.
Apache Doris Iceberg Catalog란 무엇인가요?
Apache Doris Iceberg Catalog는 Iceberg Java 라이브러리를 기반으로 구축된 네이티브 커넥터입니다. 이 커넥터는 Iceberg의 Catalog API와 직접 통신합니다. 따라서 커밋은 Spark와 Trino가 사용하는 것과 동일한 코드 경로를 거치며, 이들 엔진이 변환 없이 읽을 수 있는 스냅샷을 생성합니다.
주요 용어
- Catalog 유형: 테이블 이름을 현재 메타데이터 포인터에 매핑하는 메타스토어 백엔드입니다. Doris는
rest,hms,glue,s3tables,dlf,jdbc,hadoop의 일곱 가지를 지원합니다. - 포맷 버전: V1(추가 전용), V2(position delete와 equality delete를 사용하는 merge-on-read), V3(Puffin 파일로 저장되는 deletion vector, 행 계보, 기본값)가 있습니다. Doris는 V1부터 V3까지 읽을 수 있으며, 기본적으로 V2로 씁니다. V3 쓰기에는 포맷 버전 4.1+가 필요합니다.
- 스냅샷: Iceberg 테이블의 변경 불가능한 버전입니다. 커밋할 때마다 새 스냅샷이 생성됩니다.
- 브랜치와 태그: 이름이 지정된 스냅샷 참조입니다. 브랜치는 새 커밋에 따라 이동하고, 태그는 고정됩니다. Doris는 읽기(
@branch(name),@tag(name))와 DDL(ALTER TABLE ... CREATE BRANCH)에서 둘 다 지원합니다. - Position delete, equality delete, deletion vector: Iceberg가 행 수준 삭제를 기록하는 세 가지 방식입니다. Position delete는 파일 경로와 행의 순번으로 행을 지정합니다. Equality delete는 열 값으로 일치하는 행을 찾습니다. Deletion vector는 데이터 파일별 Roaring 비트맵을 Puffin 보조 파일에 저장합니다.
Apache Doris Iceberg Catalog는 어떻게 작동하나요?
Apache Doris Iceberg Catalog는 일곱 가지 메타스토어 백엔드 중 하나를 통해 연결하고, 현재 스냅샷(또는 브랜치/태그/타임 트래블 대상)을 기준으로 쿼리 계획을 세웁니다. 실행 중에 행 수준 삭제를 반영하고, Iceberg의 Catalog API를 통해 쓰기를 커밋합니다.
- 한 번만 연결합니다.
CREATE CATALOG ... PROPERTIES ('type' = 'iceberg', 'iceberg.catalog.type' = '<backend>', ...)로 메타스토어와 스토리지 시스템을 등록합니다. Catalog 핸들은 FE가 재시작되어도 유지됩니다. - 스냅샷을 기준으로 계획을 세웁니다. 쿼리가 Iceberg 테이블에 접근하면 FE는 현재 스냅샷(또는 브랜치, 태그, 타임 트래블 대상)을 식별하고, manifest 목록을 읽고, 최솟값/최댓값 통계로 파티션과 데이터 파일을 가지치기하고, 필터를 푸시다운합니다. BE 워커는 필터링 후 남은 Parquet 또는 ORC 파일을 스트리밍합니다.
- 실행 중에 삭제를 반영합니다. Position delete는
<file_path, row_position>에 대한 left anti-join으로 적용됩니다. Equality delete는 삭제 스키마를 기준으로 일치 여부를 판단합니다. V3 deletion vector는 비트맵 조회 형태로 스캔에 통합되며, 삭제 대상의 카디널리티가 높을 때 조인보다 비용이 적게 듭니다. - 쓰기 시 원자적으로 커밋합니다.
INSERT,INSERT OVERWRITE,CTAS,UPDATE,DELETE,MERGE INTO는 Doris의IcebergTransaction을 거칩니다. BE 쓰기 프로세스는 Parquet를 준비합니다. V3의 새 테이블에서는 재작성 시 deletion vector를 준비할 수도 있습니다. FE는 manifest 목록을 구성하고 Catalog에 테이블 포인터 교체를 요청합니다. 충돌이 발생하면 쓰기가 일부만 반영되는 대신, 명확한 스냅샷 불일치 오류와 함께 문이 실패합니다. - 데이터 이동 없이 유지보수합니다. 스냅샷 만료, 데이터 파일 compaction, manifest 재작성, 브랜치 fast-forward, 스냅샷 cherry-pick은
ALTER TABLE <t> EXECUTE <action>(...)로 실행되며 동일한 Catalog API를 통해 커밋됩니다. 외부 스케줄러나 별도의 Spark 작업이 필요하지 않습니다.
빠른 시작
CREATE CATALOG iceberg_rest PROPERTIES (
  'type' = 'iceberg',
  'iceberg.catalog.type' = 'rest',
  'uri' = 'http://rest:8181',
  'warehouse' = 's3://lake/wh',
  's3.endpoint' = 'http://minio:9000',
  's3.access_key' = 'admin', 's3.secret_key' = 'password'
);

SWITCH iceberg_rest;
CREATE DATABASE IF NOT EXISTS sales;
CREATE TABLE sales.orders (id BIGINT, region STRING, amount DECIMAL(10,2), ts DATETIME)
  PARTITION BY LIST (region, day(ts)) ()
  PROPERTIES ('format-version' = '2');

INSERT INTO sales.orders VALUES (1, 'bj', 99.50, '2026-05-08 10:00:00');
ALTER TABLE sales.orders CREATE BRANCH dev;
INSERT INTO sales.orders@branch(dev) VALUES (2, 'sh', 12.00, '2026-05-08 11:00:00');
ALTER TABLE sales.orders EXECUTE expire_snapshots('retain_last' = '5');
예상 결과
+----------+
| count(*) |
+----------+
|        1 |  -- main branch
|        2 |  -- dev branch (SELECT ... FROM sales.orders@branch(dev))
+----------+
동일한 REST 엔드포인트에 연결된 Trino나 Spark에서도 Doris가 방금 기록한 스냅샷을 그대로 확인할 수 있습니다.
Apache Doris Iceberg Catalog는 언제 사용해야 하나요?
Apache Doris Iceberg Catalog는 연합 레이크하우스 분석, SQL만으로 Iceberg에 데이터를 기록하는 ELT, 브랜치 기반 워크플로, 데이터 이동 없는 유지보수에 적합합니다. 단일 행을 빈번하게 업데이트하거나 Hudi에 쓰는 용도로는 적합하지 않습니다.
적합한 사용 사례
- 데이터를 먼저 Apache Doris에 복사하지 않고 Iceberg와 Apache Doris 웨어하우스 전반에서 수행하는 연합 분석.
- JDBC, Kafka, Hive 소스에서 정제된 데이터를 가져와 SQL만으로 Iceberg에 기록하는 ELT 파이프라인.
- git과 같은 격리가 필요한 팀 워크플로. dev 브랜치에 기록하고 검증한 다음 main 브랜치를
fast_forward합니다. FOR VERSION AS OF또는 이름이 지정된 태그를 사용하는 재현 가능한 백필과 감사.- 정기적인 compaction이 필요한 스트리밍 작업.
rewrite_data_files와expire_snapshots로 작은 파일 문제를 관리할 수 있습니다. - Hive에서의 마이그레이션. Doris에서 Iceberg 테이블을 생성하고, 전환하는 동안 양쪽에 데이터를 기록한 뒤 Hive 사본을 제거합니다.
적합하지 않은 사용 사례
- 빈번한 행 수준 업데이트. Iceberg 커밋은 스냅샷 기반이므로 문별 오버헤드가 Doris Unique Key 테이블보다 훨씬 큽니다. 단일 행 단위의 짧은 지연 시간이 필요한 CDC 싱크에는 Doris 내부 테이블을 사용하세요.
- V1 Iceberg 테이블에 대한 DELETE 또는 UPDATE. 행 수준 DML에는 포맷 버전 2 또는 3이 필요합니다. 생성 시
'format-version' = '2'를 설정하거나 테이블을 업그레이드하세요. - Hudi 쓰기. 현재 Doris는 Hudi 읽기를 지원합니다. Hudi 쓰기에는 Spark나 Flink를 사용하세요.
- Catalog 간 트랜잭션. 두 Iceberg Catalog에 쓰거나 Iceberg 테이블과 Doris 테이블에 쓰는 문은 단일 ACID 단위가 아닙니다. 한쪽에 먼저 기록한 뒤 복제하세요.
- 유지보수 생략.
expire_snapshots를 실행하지 않으면 스토리지와 메타데이터가 제한 없이 증가하고 타임 트래블 읽기가 느려집니다. 정기적으로 실행하도록 예약하세요. - 동시 쓰기 환경에서의 파일 시스템(
hadoop) Catalog. 파일 기반 Catalog에는 잠금 서비스가 없습니다. 여러 쓰기 프로세스가 있는 환경에서는 REST, HMS, Glue, JDBC, DLF를 사용하세요.
더 읽어보기
- Iceberg Catalog 참조: DDL, DML, 브랜치/태그, 타임 트래블, 테이블 작업의 전체 구문과 각 기능의 버전별 참고 사항.
- 레이크 테이블 관리: Doris가 Iceberg, Hive, Paimon 전반에서 제공하는 쓰기 및 수명 주기 관리 기능.
- Multi Catalog: Doris가 세 부분으로 구성된 이름을 사용하여 Iceberg를 Hive, JDBC, ES, 내부 웨어하우스와 함께 연합하는 방식.
- Catalog 통합: HMS, Glue, REST, S3 Tables, DLF, JDBC, Hadoop의 백엔드별 연결 세부 정보.
- 레이크하우스 개요: Doris의 전반적인 연합 분석에서 Iceberg가 맡는 역할.
- Doris + Iceberg 모범 사례: 파티션 변환, 타임 트래블, V2 DML, PyIceberg 상호 운용성을 포함한 실행 가능한 REST + MinIO 데모.
- iceberg_meta() 테이블 함수: Iceberg Java API를 직접 사용하지 않고 스냅샷, manifest, 파일, 참조, 이력을 쿼리하는 방법.