역색인
요약 Apache Doris 역색인은 모든 컬럼에
INDEX ... USING INVERTED로 선언할 수 있는 CLucene 기반 보조 인덱스입니다. 행을 스캔하는 대신 포스팅 리스트를 읽어 동등, 범위,IN,IS NULL, 배열 포함 여부 및 전문 검색MATCH_*조건자를 빠르게 처리합니다. Apache Doris 2.0부터 사용할 수 있습니다.
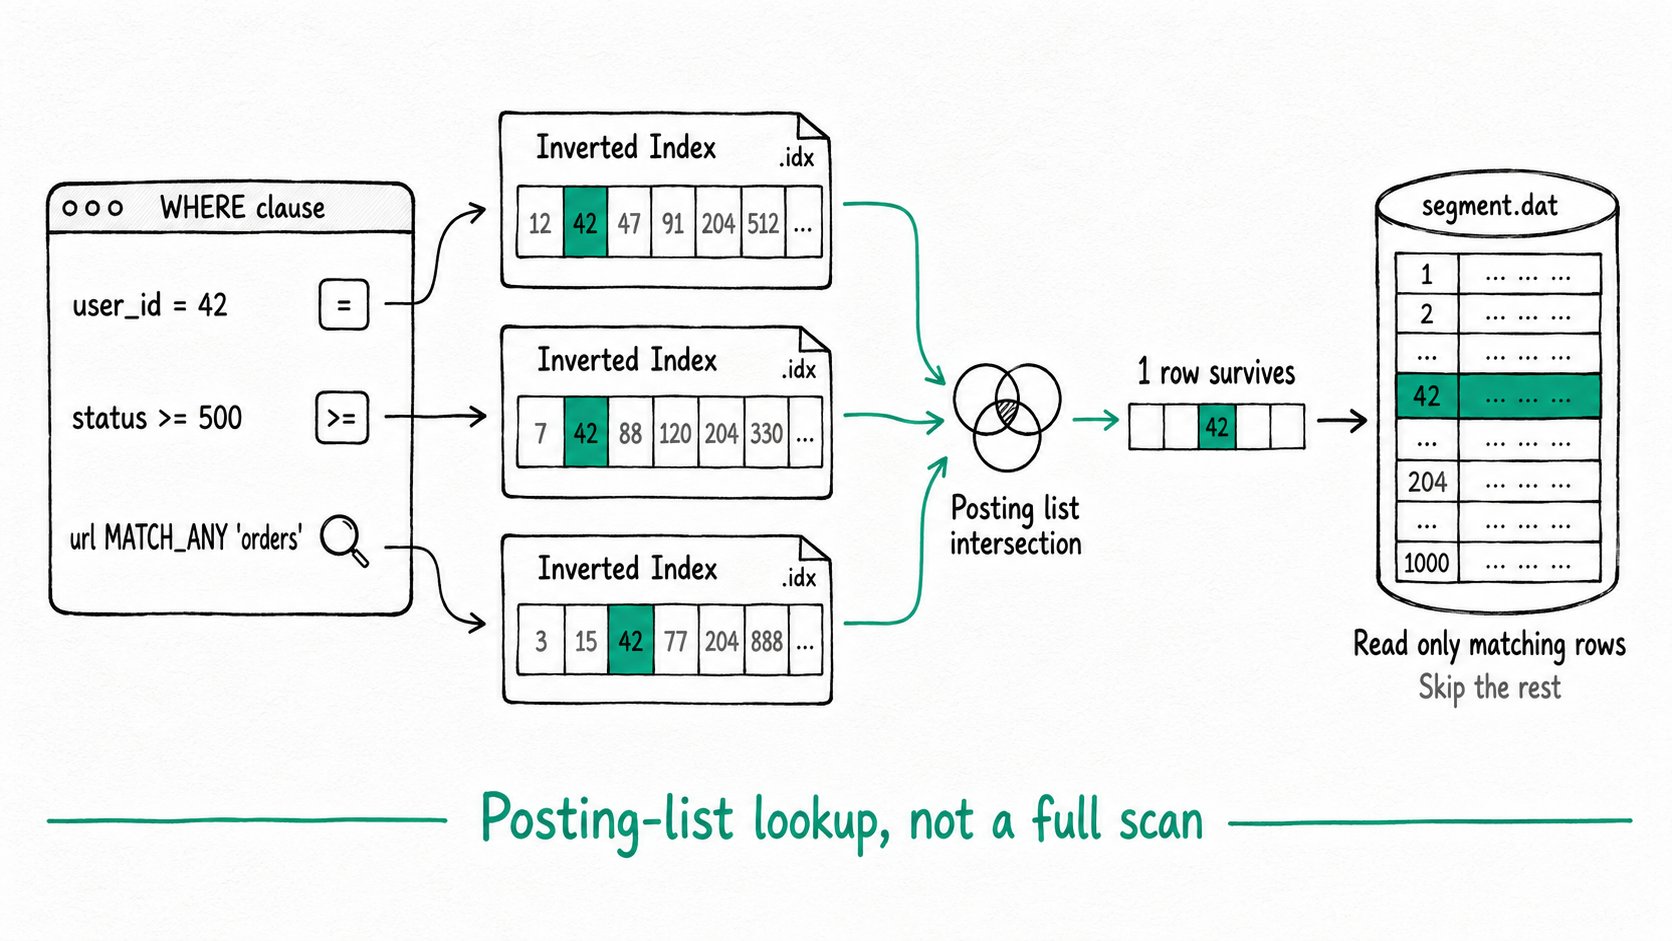
Apache Doris에서 역색인을 사용하는 이유는 무엇인가요?
Apache Doris 역색인은 OLAP 쿼리의 주된 비용 요인인 WHERE 조건자 평가를 전체 스캔에서 포스팅 리스트 조회로 전환합니다. 2 TB 크기의 이벤트 테이블에서 user_id 조건자, request_time 범위 조건, url 키워드 검색을 수행하려면, 역색인이 없는 경우 필터링 후 남은 모든 세그먼트의 모든 행에서 모든 컬럼을 디코딩해야 합니다. 일반적인 우회 방법인 증분 구체화된 뷰나 별도의 검색 클러스터는 스토리지와 운영 비용을 두 배로 늘립니다.
특히 다음과 같은 경우에 비용이 커집니다.
- 카디널리티가 높은 컬럼에 대한 동등 조회(
WHERE order_id = ?)는 적은 비용으로 세그먼트를 제외할 방법이 없어 태블릿 전체를 스캔합니다. - 숫자 또는 날짜·시간 컬럼에 대한 범위 필터(
WHERE event_time BETWEEN ...)는 ZoneMap의 최솟값과 최댓값으로만 범위를 제한하므로, 여전히 해당 범위의 모든 페이지에 접근합니다. - 기본 SQL 엔진은 텍스트 컬럼의 키워드 검색을 지원하지 않습니다.
LIKE '%term%'는 결국 스캔으로 처리되며, 데이터를 Elasticsearch로 보내려면 동기화를 유지해야 하는 별도의 파이프라인이 필요합니다.
Apache Doris 역색인은 이 세 가지를 모두 동일한 DDL로 처리합니다.
Apache Doris 역색인이란 무엇인가요?
Apache Doris 역색인은 각 값, 또는 텍스트 컬럼에서 토큰화된 각 검색어를 해당 값이나 검색어가 포함된 행 ID 집합에 매핑하는 컬럼 수준의 보조 인덱스입니다. Lucene을 C++로 포팅한 CLucene을 기반으로 구축되었으며, Apache Doris의 컬럼형 스토리지 및 벡터화 실행과 완전히 통합되어 있습니다.
역색인은 DDL에서 INDEX <name>(<col>) USING INVERTED [PROPERTIES(...)]로 선언합니다. 지원하는 컬럼 타입은 정수 계열, DECIMAL, DATE, DATETIME, TIMESTAMP_NS, IPV4, IPV6, CHAR/VARCHAR/STRING, 그리고 이들 타입을 원소로 갖는 ARRAY<T>입니다. 텍스트 컬럼에는 parser를 지정하여 토큰화를 제어할 수 있습니다.
핵심 용어
Posting list: 값이나 검색어에 대응하는 행 ID 집합입니다. 조건자 평가는 포스팅 리스트 조회와 집합 연산(AND/OR/NOT)으로 수행됩니다.Parser: 텍스트 컬럼에 사용하는 토크나이저입니다. 기본 제공 옵션은none(전체 문자열, 기본값),english,chinese,kuromoji(일본어, 5.0.0부터 지원),unicode,standard이며, 3.1부터 사용자 정의 분석기도 지원합니다.MATCH operators:MATCH_ANY(검색어 중 하나 이상),MATCH_ALL(모든 검색어),MATCH_PHRASE(인접한 검색어),MATCH_PHRASE_PREFIX,MATCH_REGEXP입니다. 이 연산자에는 파서가 설정된 역색인이 필요하며, 일반적인=와LIKE에는 이 요건이 적용되지 않습니다..idx file: 디스크에 저장되는 인덱스 데이터입니다. 태블릿 디렉터리에서 각 세그먼트 파일 옆에.idx파일이 하나씩 저장되므로, 인덱스는 세그먼트에 종속되며 compaction 과정에서도 rowset과 함께 유지됩니다.
Apache Doris 역색인은 어떻게 작동하나요?
Apache Doris 역색인은 한 번 생성한 뒤 여러 번 조회하는 방식으로 동작하며, 인덱스를 대상 세그먼트와 같은 위치에 저장합니다.
- 쓰기 시점에 생성합니다. rowset이 플러시되면 BE가 같은 디렉터리의
.idx파일에 CLucene 형식의 인덱스를 기록합니다. 세그먼트의 각 행은 CLuceneDocID와 1:1로 매핑되므로, 인덱스가 행과 문서 간의 별도 매핑 테이블을 유지할 필요가 없습니다. - 쿼리 시점에 접근 경로를 선택합니다. 플래너가 푸시다운한 조건자에 대해 BE는 먼저 역색인을 조회합니다. 인덱스 생성 시 사용한 것과 동일한 파서로 리터럴을 토큰화하고, 검색어 사전을 탐색한 다음 포스팅 리스트를 읽습니다.
- 집합 연산으로 결합합니다. 조건자 사이의
AND,OR,NOT은 포스팅 리스트의 교집합, 합집합, 여집합 연산으로 처리되며, 이 과정에서는 컬럼 데이터에 접근하지 않습니다. - 행 비트맵을 스캐너에 전달합니다. 스캐너는 컬럼형 스토리지에서 조건을 통과한 행만 읽습니다. ZoneMap, BloomFilter, 역색인의 결과를 함께 적용할 수 있으며, 각 단계가 다음 단계에서 처리할 작업을 줄여 줍니다.
- 세그먼트 단위로 유지합니다. 인덱스가 세그먼트 옆에 저장되므로 compaction 시 데이터와 함께 병합되고, 원격 스토리지로 계층화할 때도 함께 이동합니다. 재구축해야 하는 전역 인덱스는 없습니다.
빠른 시작
CREATE TABLE access_log (
  ts        DATETIME    NOT NULL,
  user_id   BIGINT      NOT NULL,
  status    INT         NOT NULL,
  url       STRING      NOT NULL,
  INDEX idx_user(user_id)  USING INVERTED,
  INDEX idx_status(status) USING INVERTED,
  INDEX idx_url(url) USING INVERTED PROPERTIES("parser"="english")
) DUPLICATE KEY(ts) DISTRIBUTED BY HASH(user_id) BUCKETS 4;

INSERT INTO access_log VALUES
  ('2026-05-01 10:00:00', 42, 200, '/api/orders/list'),
  ('2026-05-01 10:01:00', 42, 500, '/api/orders/create'),
  ('2026-05-01 10:02:00', 99, 200, '/api/users/profile');

SELECT user_id, status, url FROM access_log
WHERE user_id = 42 AND status >= 500 AND url MATCH_ANY 'orders';
예상 결과
+---------+--------+---------------------+
| user_id | status | url                 |
+---------+--------+---------------------+
|      42 |    500 | /api/orders/create  |
+---------+--------+---------------------+
각 조건자는 인덱스 조회로 처리됩니다. user_id = 42와 status >= 500은 각각 동등 조건과 범위 조건에 역색인을 사용합니다. url MATCH_ANY 'orders'는 english 파서로 컬럼을 토큰화하고 orders의 포스팅 리스트를 조회합니다. 스캐너는 세 포스팅 리스트를 AND 연산한 결과에 남은 한 행만 읽습니다.
Apache Doris 역색인은 언제 사용해야 하나요?
Apache Doris 역색인은 카디널리티가 높은 조건자, 텍스트 및 배열 검색, 그리고 ZoneMap만으로는 데이터를 충분히 세밀하게 걸러 내기 어려운 컬럼에서 효과적입니다.
적합한 경우
- 키 컬럼이 아닌 컬럼에 대한 카디널리티가 높은 동등 조건 및
IN조건:order_id,trace_id,device_id. - 범위 및
BETWEEN필터를 숫자 또는DATETIME컬럼에 적용할 때 ZoneMap만으로 충분히 세밀하게 필터링할 수 없는 경우. - 희소 컬럼에 대한
IS NULL/IS NOT NULL조건. 인덱스는 NULL을 기록하며 O(1) 시간에 조회합니다. - 로그, 문서, 콘텐츠 컬럼에 대한 키워드 및 구문 검색. 연산자 목록은 전문 검색을, 관련도 순위 산정은 BM25 점수 계산을 참조하세요.
- 배열 포함 여부를 확인하는 조건자:
array_contains(tags, 'x')와array_overlaps(tags, ['a','b']).
적합하지 않은 경우
- 패턴 앞에 와일드카드가 있는
LIKE '%abc%'. 역색인은 부분 문자열LIKE를 가속하지 않습니다. 대신 NGram BloomFilter 인덱스를 사용하세요. - 테이블에서 필터에 가장 자주 사용되는 컬럼. 접두사 인덱스가 처리할 수 있도록 Key 컬럼으로 지정하세요. 접두사 인덱스는 더 조밀하고 추가 비용이 없습니다.
- 전체 스캔이 밀리초 내에 끝나는 소규모 테이블(수백만 행 정도). 인덱스로 데이터를 건너뛰어 절감하는 비용이 인덱스 조회 비용보다 훨씬 클 때만 인덱스를 사용하는 이점이 있습니다.
- 조건자가 이미 대부분의 행과 일치하는 컬럼. 포스팅 리스트는 짧을 때 유리합니다. 행의 80%가 조건을 통과하면 인덱스 사용 여부와 관계없이 스캐너가 수행하는 작업은 동일합니다.
- 스토리지 용량이 제한된 테이블. 큰 텍스트 컬럼의 역색인은 컬럼 자체와 비슷한 크기가 될 수 있습니다. 텍스트 검색보다 저장 공간이 더 중요하다면 BloomFilter 인덱스를 사용하세요.
추가 자료
- 역색인 사용자 가이드: 전체 DDL 구문, 파서 옵션 및 관리 명령.
- 검색 연산자 참조: 모든
MATCH_*연산자와 예제. - 인덱스 개요: 역색인과 접두사 인덱스, ZoneMap, BloomFilter, NGram BloomFilter의 비교.
- 전문 검색: 토크나이저, 구문 쿼리 및 이 인덱스를 기반으로 구축된
SEARCH()DSL. - BM25 관련도 점수 계산:
score()로 검색 결과의 순위를 매기는 기능으로, 4.0부터 사용할 수 있습니다. - 하이브리드 검색: 단일 SQL 쿼리에서 역색인과 ANN 벡터 인덱스 결합.
- Apache Doris 역색인의 작동 원리: 내부 구조와 벤치마크에 대한 심층 설명.