LLM SQL 함수
요약 Apache Doris는 행의 컬럼 값을 외부 LLM으로 보내고 결과를 인라인으로 반환하는
AI_*SQL 함수군을 제공합니다. 제공업체를 AIRESOURCE로 한 번 구성한 후, 값을 사용할 수 있는 곳이면 어디든AI_CLASSIFY(...),AI_EXTRACT(...)또는AI_GENERATE(...)를 작성할 수 있습니다. Snowflake의 Cortex AISQL과 Databricks의 AI Functions도 같은 기능을 제공하며, Apache Doris의AI_*함수군은 이에 해당하는 오픈 소스 기능입니다.
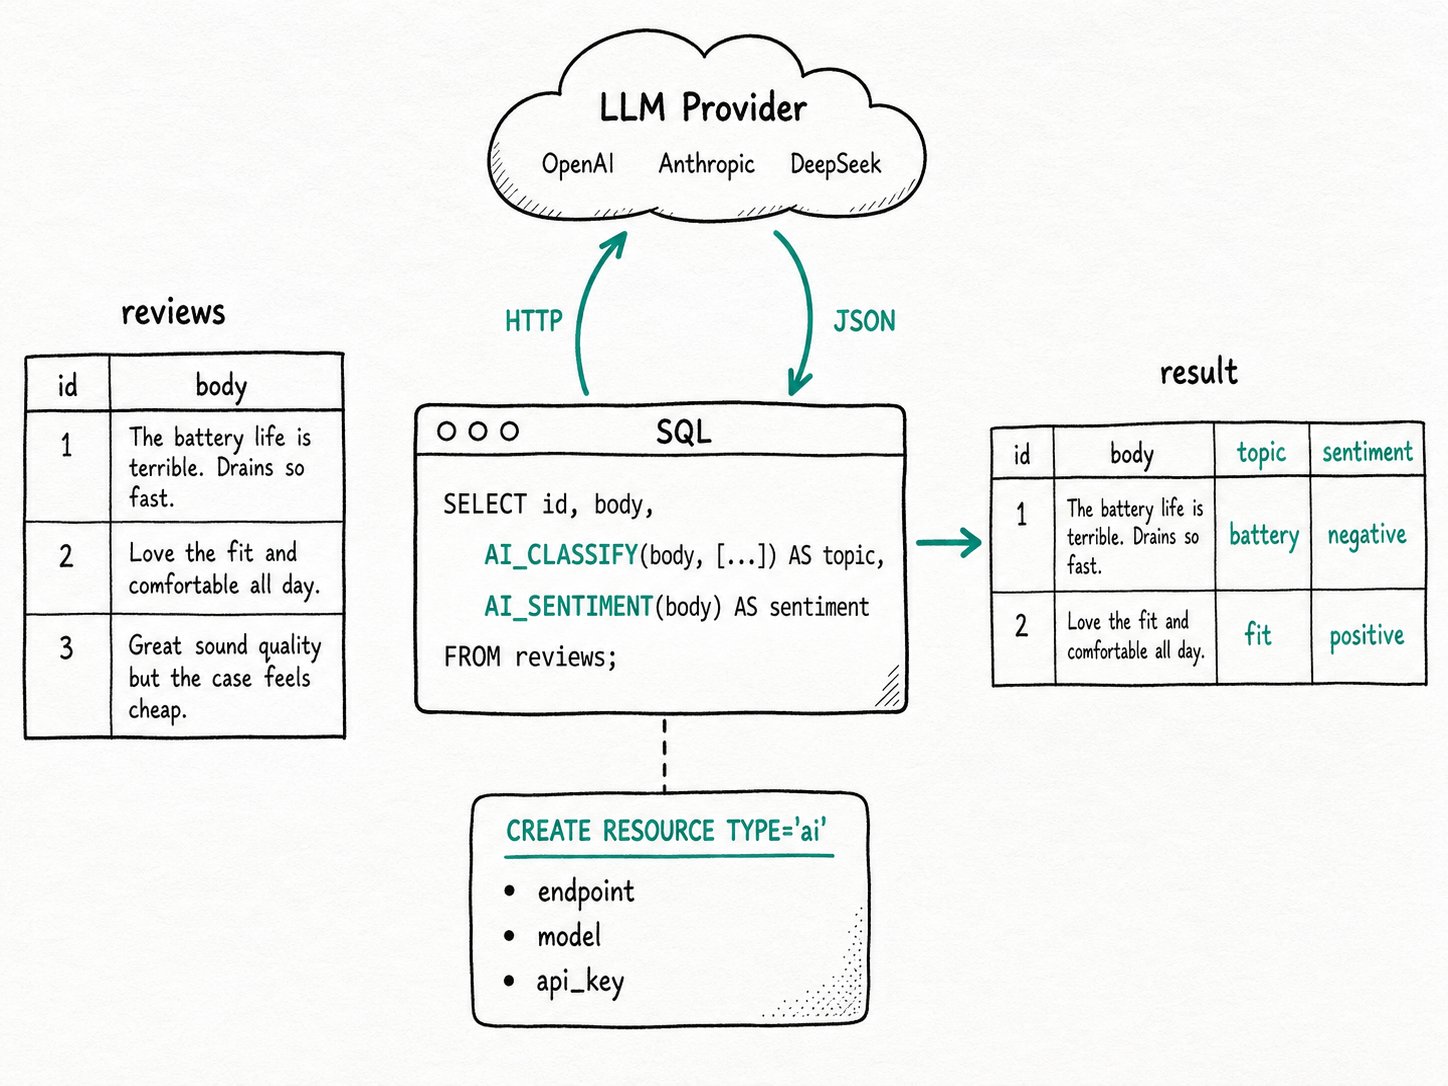
Apache Doris에서 AI_* SQL 함수를 사용하는 이유는 무엇인가요?
Apache Doris의 AI_* SQL 함수를 사용하면 텍스트 컬럼의 분류, 추출, 요약 또는 PII 마스킹을 위해 외부 Python 서비스를 따로 둘 필요가 없습니다. 텍스트 컬럼을 대상으로 하는 분석 업무 중 상당수는 실제로 분석이 아닙니다. 누군가는 지원 티켓을 주제별로 분류하고, 리뷰의 감정을 점수화하고, 자유 형식으로 작성된 불만 내용에서 제품명을 추출하고, 긴 통화 메모를 요약하거나, 내보내기 전에 PII를 가려야 합니다. 작업은 반복적이고, 컬럼은 이미 데이터 웨어하우스에 있으며, 빠진 것은 모델뿐입니다. Apache Doris는 이미 EMBED()을 통해 임베딩을 제공하고 AI 클라이언트를 위한 MCP 서버도 제공하므로, 이 기능 카드로 SQL에서 호출할 수 있는 AI 기능이 완성됩니다.
일반적인 우회 방법은 Python 서비스입니다. 이 서비스는 Doris에서 행을 가져와 OpenAI나 Anthropic을 호출하고, 응답을 파싱한 다음 결과를 다시 기록합니다. 하지만 원본 테이블과 동기화가 어긋나기 쉽고, 재시도도 직접 처리해야 하며, 데이터 웨어하우스의 권한 관리와 관측 체계 밖에서 실행됩니다.
AI_* 함수는 이 처리 과정을 SQL 안으로 옮깁니다. 모델은 등록된 리소스가 되고, 호출은 함수가 됩니다. 결과는 INSERT로 저장하거나, WHERE로 필터링하거나, 필요할 때 계산할 수 있는 컬럼이 됩니다. 하나의 언어와 하나의 트랜잭션 경계를 사용하고, 한곳에서 감사 로그를 확인합니다.
Apache Doris AI_* SQL 함수란 무엇인가요?
Apache Doris의 AI_* 함수군은 LLM 제공업체로 보내는 HTTP 호출을 래핑하며 SQL에서 호출할 수 있는 함수 모음입니다. 각 함수는 고정된 프롬프트 템플릿에 입력 컬럼을 넣어 전달하고 타입이 지정된 결과를 반환하므로, 플래너는 이 함수를 다른 스칼라 함수와 동일하게 취급합니다. Apache Doris는 CREATE RESOURCE ... TYPE='ai'로 한 번 생성해 두는 AI 리소스를 통해 제공업체에 접근합니다. 스칼라 함수 열 개가 가장 흔한 작업을 처리하고, 집계 함수 하나인 AI_AGG는 여러 행을 LLM이 생성한 단일 답변으로 통합합니다.
주요 용어
- AI 리소스: LLM 제공업체에 대한 이름이 지정된 연결입니다.
provider_type, 엔드포인트, 모델 이름, API 키, 조정 매개변수(temperature,max_token,max_retries,retry_delay_second)를 저장합니다. OpenAI, Anthropic, Gemini, DeepSeek, MoonShot, QWen, MiniMax, Zhipu, Baichuan, VoyageAI, Jina와 자체 호스팅 엔드포인트용local까지 열두 가지 제공업체 유형을 지원합니다. AI_*스칼라 함수:AI_GENERATE,AI_TRANSLATE,AI_SUMMARIZE,AI_SENTIMENT,AI_CLASSIFY,AI_EXTRACT,AI_FIXGRAMMAR,AI_MASK,AI_FILTER,AI_SIMILARITY. 각각 첫 번째 인수로 리소스 이름을, 두 번째 인수로 컬럼을 받으며, 레이블 집합이나 대상 언어 등 작업별 인수 몇 개를 추가로 받습니다.AI_AGG: 그룹 내 모든 행을 결합하고 사용자 지정 프롬프트와 함께 LLM으로 보내 그룹별 요약 하나를 반환하는 집계 함수입니다.AI_SUMMARIZE를 그룹 단위로 적용하는 기능에 해당합니다.default_ai_resource: 세션의 나머지 기간에 사용할 리소스를 선택하는 세션 변수로, 첫 번째 인수를 명시하지 않아도 됩니다.
Apache Doris AI_* SQL 함수는 어떻게 작동하나요?
Apache Doris의 AI_* SQL 함수는 BE에서 스칼라 UDF로 실행됩니다. 플래너가 각 호출을 라우팅하고 BE가 행을 배치로 묶으며, 배치당 HTTP 요청 하나를 제공업체에 보낸 뒤 타입이 지정된 값을 SQL에 반환합니다.
- 모델 등록.
CREATE RESOURCE는 확인용 호출로 엔드포인트의 유효성을 검사하고(provider_type = 'local'이거나ai.validity_check = 'false'이면 생략),SHOW RESOURCES출력에서 API 키를 마스킹하며, 구성을 FE의 메타데이터에 저장합니다. - 호출 계획 수립. 플래너는
AI_*함수를 만나면 다른 스칼라 UDF와 같은 방식으로 작업을 BE에 라우팅합니다. 함수의 첫 번째 인수는 리소스 이름 리터럴이어야 하며, 이 위치에 표현식이 오면 플래너가 분석 단계에서 거부합니다. - BE에서 배치 처리. BE는
embed_max_batch_size(기본값 5)와ai_context_window_size(기본값은 누적 텍스트 128 KB)의 제한에 맞춰 입력 행을 배치로 모은 다음, 배치마다 HTTP 요청 하나를 보냅니다. 크기 제한을 넘는 행은 별도 배치로 처리하므로, 긴 문서 하나가 나머지 쿼리 처리를 지연시키지 않습니다. - 재시도 및 타임아웃. HTTP 호출은 리소스의
ai.max_retries와ai.retry_delay_second설정을 따릅니다. 각 요청은 세션의query_timeout에서 남은 시간을 상속받으므로, 제공업체의 응답이 느려도 쿼리가 허용 시간을 넘겨 실행되지는 않습니다. - 타입이 지정된 값 반환. 스칼라 함수는
STRING을 반환하며,BOOLEAN을 반환하는 함수는AI_FILTER,DOUBLE을 반환하는 함수는AI_SIMILARITY입니다. SQL 안에서 값을 저장하거나, 필터링하거나, 다음 연산자에 전달할 수 있습니다.
빠른 시작
CREATE RESOURCE "deepseek_chat" PROPERTIES (
  "type" = "ai",                     "ai.provider_type" = "deepseek",
  "ai.endpoint"   = "https://api.deepseek.com/chat/completions",
  "ai.model_name" = "deepseek-chat", "ai.api_key" = "sk-xxx"
);
SET default_ai_resource = "deepseek_chat";

CREATE TABLE reviews (id INT, body STRING)
  DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;
INSERT INTO reviews VALUES
  (1, 'Battery dies in 4 hours. Returning it.'),
  (2, 'Fits perfectly, color is exactly as pictured. Love it.');

SELECT id, body, AI_SENTIMENT(body) AS sentiment,
       AI_CLASSIFY(body, ['battery', 'fit', 'price', 'shipping']) AS topic
FROM reviews;
예상 결과
+----+--------------------------------+-----------+---------+
| id | body                           | sentiment | topic   |
+----+--------------------------------+-----------+---------+
|  1 | Battery dies in 4 hours...     | negative  | battery |
|  2 | Fits perfectly, color is...    | positive  | fit     |
+----+--------------------------------+-----------+---------+
이 쿼리는 함수마다 한 번씩 총 두 번 LLM과 요청과 응답을 주고받으며, 매번 두 행을 하나의 배치로 묶어 보냅니다. 출력 컬럼은 문자열 타입이므로, 후속 GROUP BY topic이나 조인에서 별도 파싱 없이 사용할 수 있습니다.
Apache Doris AI_* SQL 함수는 언제 사용해야 하나요?
Apache Doris의 AI_* 함수는 일괄 데이터 보강, ETL 백필, 여러 행에 걸친 집계에 적합하지만, 초 미만의 응답 시간이 필요한 대화형 쿼리나 엄격한 재현성을 요구하는 워크로드에는 적합하지 않습니다.
적합한 경우
- 텍스트 컬럼 일괄 보강: 매일 밤 지원 티켓을 분류하거나, 새 리뷰의 감정을 점수화하거나, 수집 시점에 송장에서 구조화된 필드를 한 번 추출하는 작업입니다.
- 데이터베이스 내 백필:
UPDATE t SET topic = AI_CLASSIFY(body, [...]) WHERE topic IS NULL을 사용하면 작업을 한곳에서 처리하고 Doris 트랜잭션의 이점을 활용할 수 있습니다. AI_AGG를 통한 여러 행 집계: 제품별 주간 불만 요약, 경영진용 회의 메모 요약, 뉴스 기사의 주제별 요약입니다.WHERE에서 의미 기반 필터링:AI_FILTER('Is this a security incident?', body)는 미세 조정한 분류기를 만들기에는 과도한 일회성 검토 및 분류 작업에 사용할 수 있습니다.
적합하지 않은 경우
- 대시보드를 새로 고칠 때마다 행별로
AI_*호출하기. 각 행마다 제공업체를 한 번 호출하며, 요금은 행 수와 새로 고침 빈도에 비례해 증가합니다. 결과를 컬럼에 구체화하고 인덱스를 생성한 다음 해당 컬럼을 쿼리하세요. 사전 계산 방식은 증분 구체화된 뷰를 참조하세요. - 초 미만의 응답 시간이 필요한 대화형 쿼리. LLM 추론 지연 시간은 아무리 짧아도 수백 밀리초이며, 호출 빈도 제한은 꼬리 지연 시간을 더 늘립니다.
AI_*는 배치 처리와 ETL에 사용하고, 사용자가 버튼을 누른 뒤 대기하게 만드는 쿼리에는 사용하지 마세요. - 유사한 항목을 찾아야 하는 검색 문제. 임베딩 컬럼에 벡터 인덱스와
cosine_distance를 조합하면 더 빠르고 저렴하며 결과를 재현할 수 있습니다. SQL 안에서 처리하는 방식은 임베딩을 참조하세요. - 엄격한 재현성이 필요한 모든 작업.
temperature = 0으로 고정하지 않으면 제공업체의 응답은 비결정적이며, 고정하더라도 모델 측의 사소한 업데이트로 출력이 바뀔 수 있습니다. 쿼리마다 다시 계산하는 대신 결과의 스냅샷을 저장하세요. - 지원 목록에 없는 제공업체가 필요한 워크로드. 열두 가지
provider_type값 이외의 제공업체는 OpenAI, Anthropic 또는 Gemini와 호환되는 API를 제공하거나,local엔드포인트로 실행되어야 합니다.
더 읽어보기
- Doris의 AI: 전체 AI 기능을 소개하고,
AI_*함수, 임베딩, 벡터 검색, MCP 서버가 어떻게 함께 작동하는지 설명합니다. - AI 함수 개요: 모든 지원 제공업체,
CREATE RESOURCE의 전체 속성 목록, 함수별 개별 예제를 제공합니다. - 임베딩:
EMBED()는 동일한 AI 리소스 메커니즘을 공유하며, 다음 단계가 벡터 검색일 때 적합한 도구입니다. - 하이브리드 검색: LLM이 생성한 컬럼을 전문 검색 및 ANN 조건식과 같은 쿼리에서 결합하는 방법을 설명합니다.
- Snowflake Cortex AISQL 참조: 데이터 웨어하우스 간 비교 시 가장 유사한 기능을 확인할 수 있습니다.
- MCP 서버: AI 기능의 또 다른 접점으로, AI 클라이언트가 Model Context Protocol 도구를 통해 Doris를 쿼리할 수 있게 합니다.
- VARIANT 데이터 타입:
AI_EXTRACT등의 함수가 생성하는 JSON 출력을 저장하기에 적합한 타입입니다. - Databricks AI Functions: 다른 공급업체가 같은 아이디어를 구현한 방식입니다.