레이크 테이블 관리
요약 레이크 Catalog를 연결하면 Apache Doris에서 Iceberg, Hive, Paimon 테이블을 기본 객체로 다룰 수 있습니다.
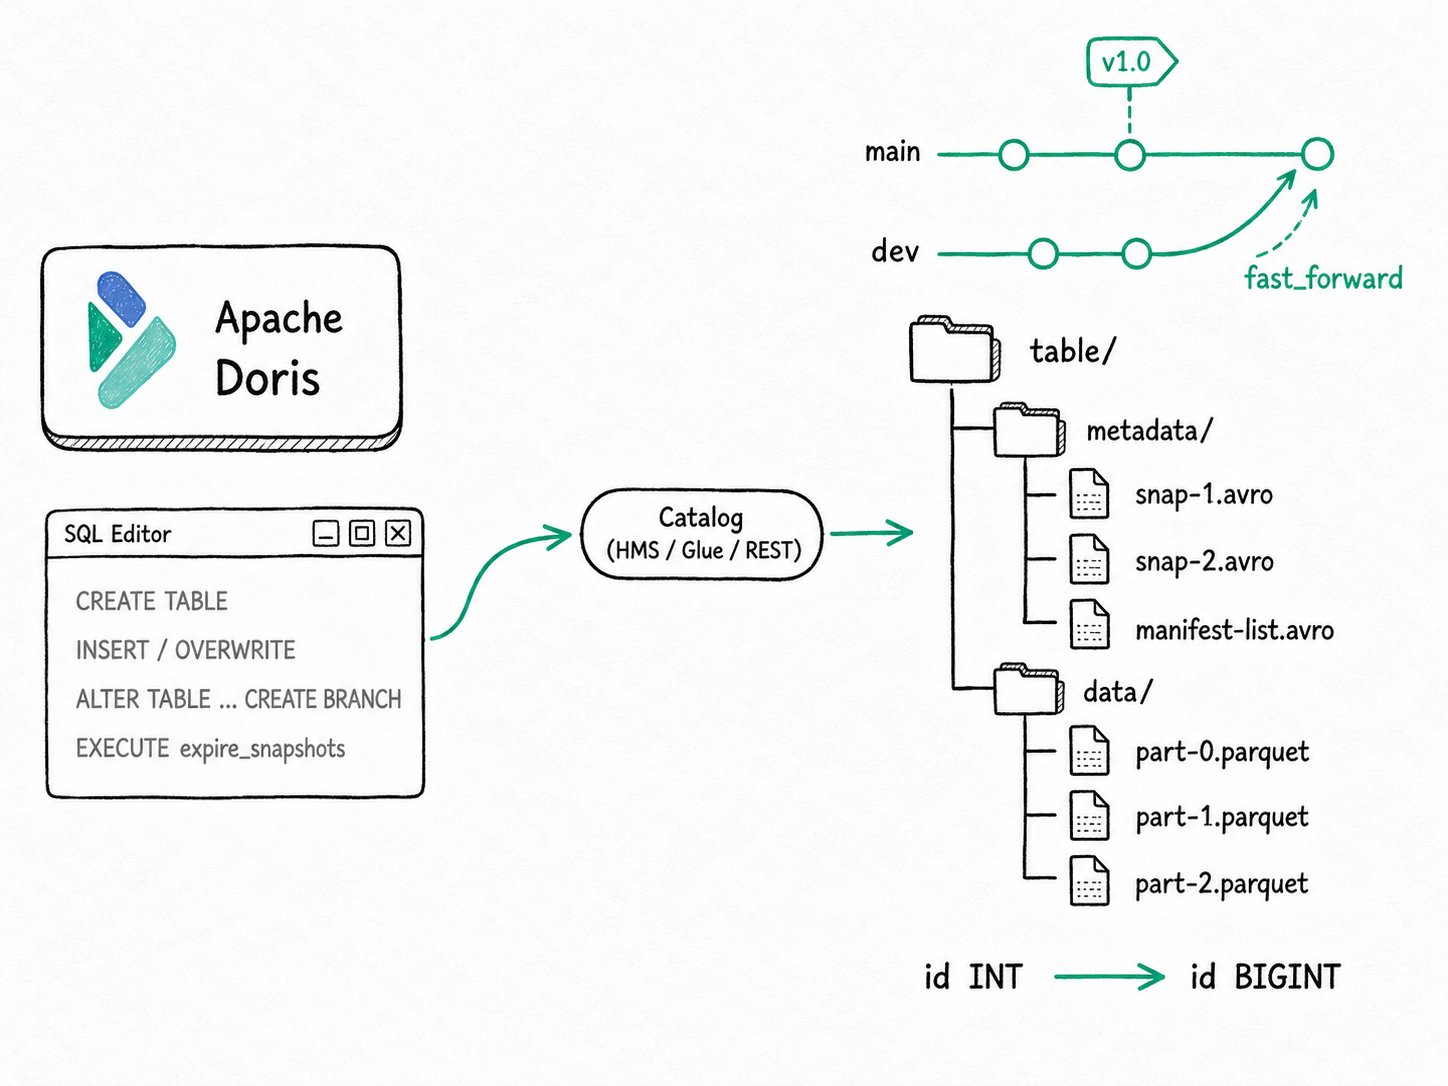
CREATE TABLE,INSERT,INSERT OVERWRITE,UPDATE,DELETE, 스키마 및 파티션 진화, Iceberg 브랜치와 태그, 스냅샷 타임 트래블,expire_snapshots와rewrite_data_files같은 유지 관리 작업을 지원합니다. 모든 메타데이터 커밋은 Catalog(HMS, Glue, REST, JDBC)를 거치므로 Trino, Spark, Flink에서도 동일한 쓰기 결과를 확인할 수 있습니다.
Apache Doris 레이크 테이블 관리를 왜 사용하나요?
Apache Doris 레이크 테이블 관리를 사용하면 하나의 클러스터에서 SQL로 연합 읽기와 레이크 쓰기를 모두 처리할 수 있습니다. 따라서 Iceberg, Hive, Paimon 테이블을 변경하기 위해 별도의 Spark 또는 Flink 클러스터를 운영할 필요가 없습니다. 대부분의 레이크하우스 엔진은 읽기 용도로 사용하기 시작합니다. Iceberg Catalog에 연결하고 몇몇 테이블을 쿼리하다 보면 같은 한계에 부딪힙니다. 쓰기 작업은 모두 Spark나 Flink를 거쳐야 한다는 점입니다. 결국 같은 데이터를 다루면서 클러스터 두 개를 운영하고, SQL 방언 두 가지를 익히고, 서로 다른 권한 체계를 조정하게 됩니다. 다중 Catalog 연합 기능은 Catalog 통합을 기반으로 읽기를 담당하며, 이 소개 문서에서는 쓰기를 다룹니다.
Apache Doris는 두 가지를 모두 처리합니다. Doris 내부 테이블을 쿼리하는 데 사용하는 SQL로 Iceberg 테이블을 생성하고, 행을 추가하고, 파티션을 덮어쓰고, 스키마를 진화시키고, 브랜치를 분기하고, 오래된 스냅샷을 만료시키고, 작은 파일을 압축할 수 있습니다. 대시보드를 구동하는 클러스터가 레이크 유지 관리도 담당합니다.
- ETL 단계마다 Spark 작업을 붙일 필요 없이 하나의 엔진으로 연합 읽기와 레이크 쓰기를 처리합니다.
- Iceberg, Hive, Paimon에 표준 SQL DDL과 DML을 사용하므로 형식마다 새로운 방언을 배울 필요가 없습니다.
- Catalog를 통해 커밋합니다. Apache Doris의
INSERT로 Iceberg에 쓴 데이터는 별도의 동기화 단계 없이 Trino, Spark, Flink에 반영됩니다.
Apache Doris 레이크 테이블 관리란 무엇인가요?
Apache Doris 레이크 테이블 관리는 엔진이 외부 Catalog를 통해 제공하는 쓰기 및 수명 주기 관리 기능입니다. DDL, DML, 스키마 진화, 브랜치, 태그, 테이블 액션을 통한 유지 관리를 포괄합니다. CREATE CATALOG로 Apache Doris를 HMS, Glue, REST, JDBC, S3 Tables 또는 DLF에 연결하면 해당 Catalog는 쓰기 가능한 네임스페이스가 됩니다. Apache Doris는 CREATE TABLE, ALTER TABLE, INSERT, UPDATE, DELETE, MERGE INTO를 각 형식에 맞는 매니페스트 쓰기, 스냅샷 커밋, 메타스토어 호출로 변환합니다.
연결 계층 자체에 대해서는 다중 Catalog와 레이크하우스 개요를 참조하세요. 이 소개 문서는 Catalog를 연결한 후에 수행할 수 있는 작업을 다룹니다.
주요 용어
Catalog: Apache Doris를 메타스토어 및 스토리지 시스템에 연결하는 객체입니다. 쓰기는 Catalog의 API를 통해 커밋됩니다.Snapshot: Iceberg 또는 Paimon 테이블의 변경 불가능한 버전입니다. 쓰기 작업마다 새 스냅샷이 생성되며, 읽을 때 특정 스냅샷을 지정할 수 있습니다.Branch와Tag: Iceberg와 Paimon에서 스냅샷을 가리키는 이름 있는 참조입니다. 브랜치는 새 커밋에 따라 이동하고, 태그는 고정됩니다.Schema evolution: 데이터 파일을 다시 쓰지 않고 컬럼을 추가, 삭제, 이름 변경하거나 더 넓은 타입으로 변경하는 작업입니다.Table action:ALTER TABLE ... EXECUTE로 호출하는 유지 관리 작업입니다. 예를 들어expire_snapshots,rewrite_data_files,rewrite_manifests가 있습니다.
Apache Doris 레이크 테이블 관리는 어떻게 작동하나요?
Apache Doris 레이크 테이블 관리는 다섯 단계로 진행됩니다. Catalog 연결, 형식에 맞는 실행 계획 수립, BE에서 데이터 파일 준비, Catalog API를 통한 원자적 커밋, SQL을 통한 테이블 유지 관리입니다.
- Catalog 연결.
CREATE CATALOG iceberg_ctl PROPERTIES (...)로 메타스토어와 스토리지 백엔드를 등록합니다. Apache Doris는 메타데이터를 캐시하지만, 다른 엔진과 동기화를 유지하도록 쓰기는 항상 Catalog의 API를 통해 커밋합니다. - 형식에 맞는 실행 계획 수립. Nereids 플래너는 외부 테이블을 인식하고 해당 형식의 쓰기 구성 요소로 문을 전달합니다. Iceberg는 매니페스트 커밋, Paimon은 델타 커밋, Hive는 파티션 다시 쓰기를 수행합니다.
- 데이터 파일 준비. BE의 쓰기 구성 요소는 테이블 위치에 Parquet 데이터 파일을 생성합니다. Hive에서는 ORC도 사용합니다. Iceberg V2의 삭제 정보는 Position Delete 파일에, V3의 삭제 정보는 Puffin Deletion Vectors에 기록되며, Paimon은 LSM-tree 세그먼트를 씁니다.
- 원자적 커밋. FE가 매니페스트 목록을 구성하고 Catalog에 테이블 포인터 교체를 요청합니다. 커밋이 동시 쓰기와 충돌하면 Apache Doris가 스냅샷 불일치를 감지하고 해당 문을 안전하게 실패 처리합니다.
- 같은 환경에서 유지 관리. 유지 관리 작업도 같은 클러스터에서 SQL로 실행합니다.
EXECUTE expire_snapshots,EXECUTE rewrite_data_files,EXECUTE rewrite_manifests,ALTER TABLE ... CREATE BRANCH등이 있습니다.
지원 범위는 형식마다 다릅니다. Iceberg는 DDL과 DML 전체, V2 및 V3 삭제 전략, 브랜치, 태그, 파티션 진화, 테이블 액션을 지원하므로 가장 완전한 기능을 제공합니다. Paimon은 Apache Doris를 통한 읽기, 타임 트래블, 브랜치, 태그를 지원합니다. 기본 키가 있는 Paimon 테이블에 쓰려면 여전히 Flink를 사용해야 합니다. Hive는 CREATE, INSERT, INSERT OVERWRITE, CTAS를 지원하지만, 특정 파티션을 대상으로 하는 쓰기와 동일한 파티션에 대한 동시 INSERT OVERWRITE에는 Spark나 Hive 자체에서 작업할 때와 같은 주의가 필요합니다. 현재 Hudi는 읽기 전용입니다.
빠른 시작
SWITCH iceberg_ctl;
CREATE DATABASE IF NOT EXISTS sales;
CREATE TABLE sales.orders (
  order_id BIGINT, region STRING, amount DECIMAL(10,2), ts DATETIME
) PARTITION BY LIST (day(ts), region) ();

INSERT INTO sales.orders VALUES (1, 'bj', 99.50, '2026-05-08 10:00:00');
ALTER TABLE sales.orders CREATE BRANCH dev;
INSERT INTO sales.orders@branch(dev) VALUES (2, 'sh', 12.00, '2026-05-08 11:00:00');

SELECT COUNT(*) FROM sales.orders;             -- main branch
SELECT COUNT(*) FROM sales.orders@branch(dev); -- dev branch
ALTER TABLE sales.orders EXECUTE expire_snapshots ("retain_last" = "5");
예상 결과
+----------+
| count(*) |
+----------+
|        1 |   -- main
|        2 |   -- dev
+----------+
main 브랜치는 운영용 행을 유지하고, dev 브랜치에는 행이 하나 더 추가되며, expire_snapshots는 오래된 메타데이터를 정리합니다. 같은 REST 또는 HMS Catalog에 연결된 Trino나 Spark에서도 Doris가 방금 생성한 스냅샷을 그대로 읽을 수 있습니다.
Apache Doris 레이크 테이블 관리는 언제 사용해야 하나요?
Apache Doris 레이크 테이블 관리는 Iceberg 또는 Hive로 데이터를 쓰는 연합 ELT, 개발 워크플로를 위한 git 방식의 Iceberg 브랜치, 재현 가능한 타임 트래블 읽기, expire_snapshots와 rewrite_data_files 같은 정기 유지 관리, SQL 기반 스키마 및 파티션 진화에 적합합니다. 동시성이 높은 단일 행 OLTP 업데이트, 일반 Hive로의 실시간 CDC, Hudi에 대한 쓰기에는 적합하지 않습니다. 현재 Hudi는 읽기 전용입니다.
적합한 경우
- Apache Doris 안에서 JDBC 또는 Kafka Catalog의 데이터를 읽고 정제된 데이터를 Iceberg나 Hive에 저장하는 연합 ELT 파이프라인. 쓰기 반영 패턴은 레이크하우스 개요를 참조하세요.
- Iceberg에서 git 방식의 격리가 필요한 팀 워크플로.
ALTER TABLE ... CREATE BRANCH dev로 브랜치를 생성하고, dev 브랜치에서 검증한 다음,EXECUTE fast_forward로 게시합니다. - Iceberg, Paimon, Hudi에서
FOR VERSION AS OF또는FOR TIME AS OF를 사용하는 타임 트래블 읽기와 재현 가능한 백필. - 정기 유지 관리. 매일 밤
expire_snapshots를 실행하고, 매시간rewrite_data_files로 스트리밍 작업에서 생성된 작은 파일을 압축하며, 대규모 파티션 재구성 후 주기적으로rewrite_manifests를 실행합니다. - 익숙한 SQL을 통한 스키마 및 파티션 진화.
ADD COLUMN,MODIFY COLUMN,ADD PARTITION KEY day(ts),REPLACE PARTITION KEY ts_day WITH day(ts)를 사용할 수 있습니다.
적합하지 않은 경우
- 동시성이 높은 단일 행 OLTP 방식의 업데이트. 레이크 커밋은 스냅샷 기반이므로 문마다 발생하는 오버헤드가 너무 큽니다. 이러한 워크로드에는 Apache Doris Unique Key 테이블을 사용하세요.
- Hive에서 행 단위로 수행하는 실시간 upsert. Hive에는 삭제 파일이나 merge-on-read가 없습니다. CDC 데이터를 행 단위로 반영해야 한다면 Iceberg V2 또는 V3, 혹은 기본 키가 있는 Paimon 테이블을 사용하세요.
- Hive의 특정 파티션을 대상으로 하는
INSERT INTO. Apache Doris는PARTITION (...)절이 아니라 컬럼 값을 기준으로 파티션에 씁니다. Hive에서 명시적인 파티션 라우팅이 필요하면INSERT OVERWRITE를 사용하거나 Spark를 통해 데이터를 적재하세요. - 여러 쓰기 주체가 같은 Hive 파티션에 동시에 수행하는
INSERT OVERWRITE. Hive는 파티션 데이터를 원자적으로 교체할 수 없으므로 결과가 일부만 반영될 수 있습니다. 쓰기를 순차적으로 실행하거나 해당 테이블을 Iceberg로 옮기세요. - Hudi에 쓰기. 현재 Apache Doris는 Hudi 읽기만 지원합니다. Hudi 쓰기에는 Spark나 Flink를 사용하세요.
더 읽어보기
- 다중 Catalog: Doris가 외부 Catalog를 연합하고 Catalog 간에 쿼리를 라우팅하는 방식.
- Iceberg Catalog 참조: 버전별 참고 사항을 포함한 전체 DDL, DML, 브랜치와 태그, 테이블 액션 구문.
- Hive Catalog 참조: 쓰기 동작 방식, 트랜잭션 테이블 지원, 동시 쓰기 규칙.
- Paimon Catalog 참조: 읽기, 타임 트래블, 배치 증분, 브랜치와 태그, 시스템 테이블.
- 레이크하우스 개요: 전체 연합 분석 구성에서 관리형 레이크 테이블이 차지하는 역할.
- 데이터 업데이트 및 삭제: 빈번한 행 단위 변경을 위한 내부 테이블의 대응 기능.
- Iceberg: 일곱 가지 Catalog 백엔드, V2/V3 삭제, 브랜치, 태그, 타임 트래블 등 Iceberg 전용 기능.