MPP 아키텍처
요약 Apache Doris MPP는 하나의 SQL 쿼리를 클러스터의 모든 BE에서 병렬로 실행되는
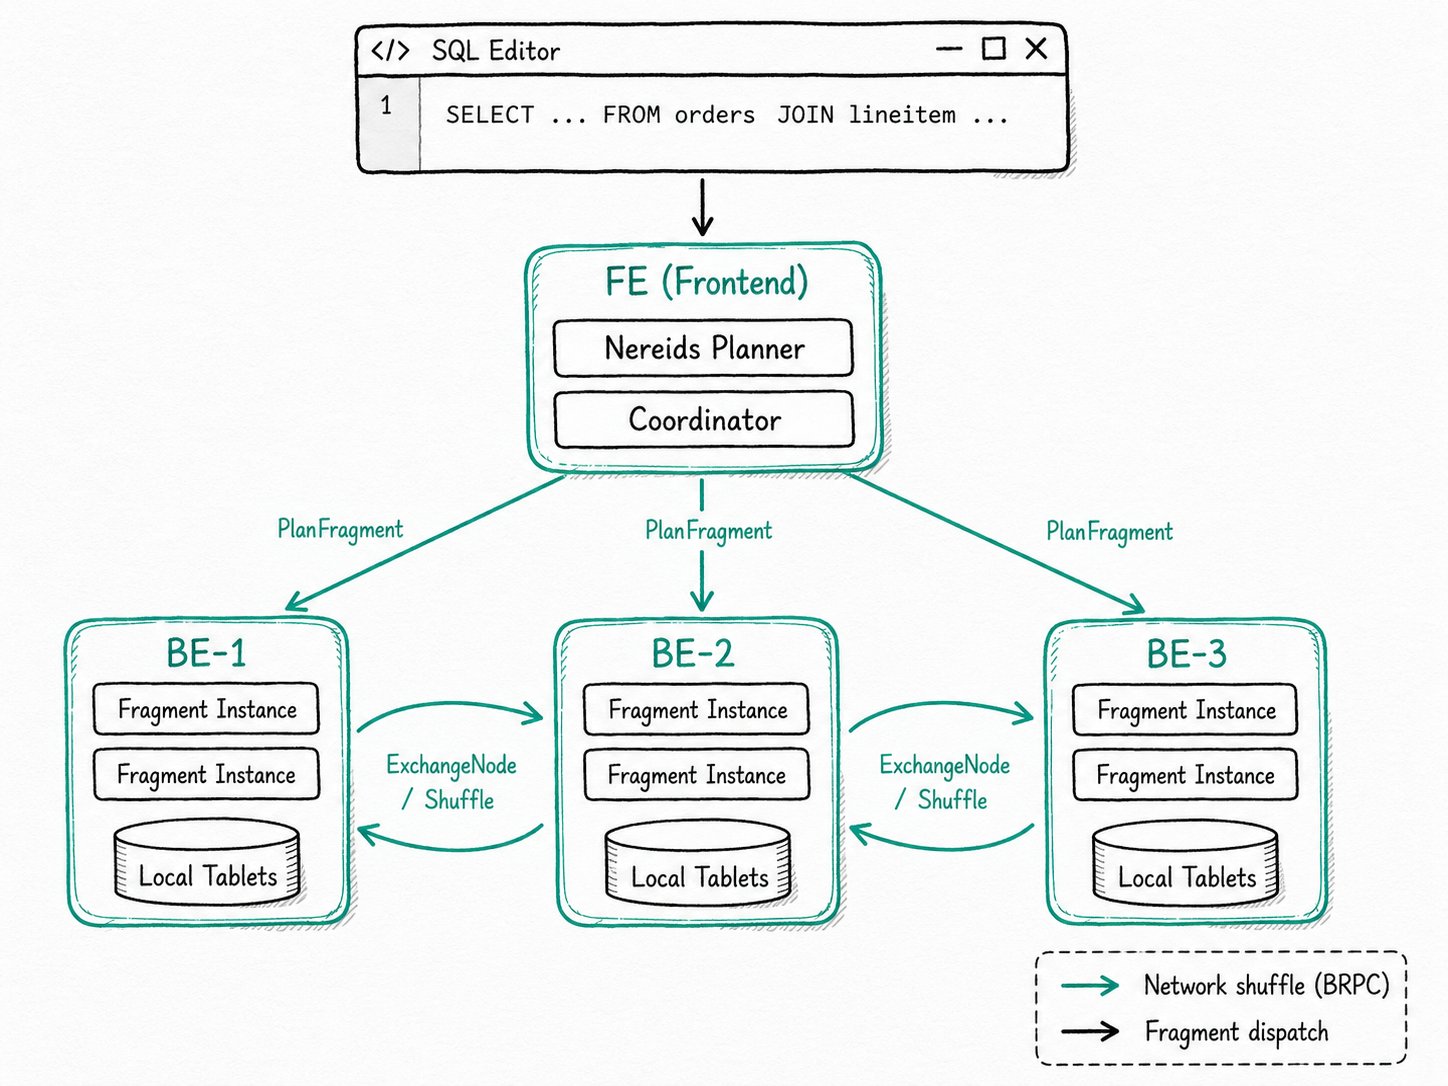
PlanFragment의 DAG로 변환합니다. FE 측Coordinator는 Nereids 옵티마이저로 DAG를 계획하고, BRPC를 통해 각 프래그먼트를 담당 BE로 전송하며,ExchangeNode+DataStreamSink셔플로 프래그먼트들을 연결합니다. Shared-nothing 스토리지와 쿼리별 메모리 예산(exec_mem_limit, 기본값 2 GB)을 통해 클러스터를 수평으로 확장할 수 있습니다. BE를 추가할 때마다 동일한 쿼리 풀에 CPU, 메모리, 로컬 태블릿이 더해집니다.
Apache Doris에서 MPP를 사용하는 이유는 무엇인가요?
Apache Doris MPP는 단일 분석 쿼리가 한 머신의 CPU에 한정되지 않고 클러스터의 모든 CPU를 활용할 수 있게 합니다. 10 × 십억 개 행을 집계하거나, 팩트 테이블 다섯 개를 조인하거나, 일 년치 로그를 여러 컬럼으로 GROUP BY하는 작업은 단일 노드에서 현실적인 시간 안에 끝내기 어렵습니다. MPP 계층은 “더 큰 서버를 구매하는 것”을 “BE를 더 추가하는 것”으로 바꿔 줍니다.
MPP가 해결하는 문제는 구체적입니다.
- 단일 노드 플래너의 처리 여력에는 한계가 있습니다. 테라바이트 규모의 컬럼형 데이터를 다루는 쿼리는 스캔, 필터, 조인, 집계 작업을 한 머신에 몰아넣는 대신 여러 머신에 분산해야 합니다.
- 수동 샤딩은 데이터 팀의 부담입니다. 샤드별 테이블에 대한 union 쿼리를 수작업으로 작성하는 방식은 조인 키가 바뀌거나 샤드가 재분산되면 문제가 생깁니다.
- 스토리지 병목으로 컴퓨팅 자원이 낭비됩니다. 계산을 위해 샤드를 한 머신으로 가져오면 클러스터가 데이터가 있는 자리에서 처리할 수 있는 작업을 네트워크가 대신 떠안게 됩니다.
Apache Doris MPP는 플래너가 쿼리를 나누고, 데이터가 있는 곳으로 연산을 보내며, 실제로 네트워크를 건너야 하는 행만 셔플할 수 있게 합니다.
Apache Doris MPP 아키텍처란 무엇인가요?
Apache Doris MPP는 Frontend(FE)가 쿼리를 PlanFragment의 DAG로 계획하고 Backend(BE)가 로컬 태블릿을 대상으로 이 프래그먼트를 병렬 실행하는 shared-nothing 분산 실행 모델입니다. Nereids 옵티마이저는 SQL을 논리 계획으로 컴파일하고 셔플 경계에서 분할하며, FE의 Coordinator는 각 PlanFragment를 실행할 BE 집합을 배정합니다. 각 BE는 프래그먼트를 하나 이상의 프래그먼트 인스턴스로 구체화하고, BE 내부의 파이프라인 스케줄러가 이를 스레드에서 실행합니다. 데이터는 ExchangeNode(소비자 측)와 DataStreamSink(생산자 측)를 통해 프래그먼트 경계를 넘으며, Block으로 직렬화되어 BRPC로 전송됩니다.
주요 용어
PlanFragment: FE가 BE로 보내는 분산 작업의 최소 단위입니다. 쿼리 하나는 프래그먼트로 이루어진 DAG 하나에 해당합니다.- 프래그먼트 인스턴스: 하나의 BE에서 실행되는
PlanFragment의 런타임 복사본입니다. 서로 다른 BE에서 동일한 프래그먼트의 여러 인스턴스를 실행하여 수평 병렬성을 확보합니다. Coordinator: 프래그먼트 DAG 구성, BE 배정, 프래그먼트 전송, 결과 수집, 실패 처리를 담당하는 FE 측 객체입니다.fe/fe-core/src/main/java/org/apache/doris/qe/Coordinator.java에 구현되어 있습니다.ExchangeNode/DataStreamSink: 네트워크를 통해 프래그먼트 사이의 데이터를 이동하는 수신자 / 송신자 쌍입니다. 플래너는 모든 셔플 경계에 이 쌍을 삽입합니다.- 분산 모드: 셔플 시 네트워크에서 행을 라우팅하는 방식으로,
UNPARTITIONED,RANDOM,HASH_PARTITIONED또는BUCKET_SHFFULE_HASH_PARTITIONED가 있습니다. - Nereids 플래너: 조인 순서, 셔플 방식, 병렬도를 선택하는 Cascades 방식의 비용 기반 옵티마이저입니다. 레거시 플래너는 삭제되었으며,
enable_nereids_planner스위치는REMOVED로 표시되어 있습니다.
Apache Doris MPP 아키텍처는 어떻게 작동하나요?
Apache Doris MPP는 다섯 단계로 작동합니다. FE가 프래그먼트를 계획하고 분할한 뒤 전송합니다. 각 BE는 전달받은 프래그먼트를 파이프라인 태스크로 변환합니다. 태블릿은 로컬에서 스캔합니다. 데이터는 계획에서 요구하는 곳에서만 ExchangeNode를 통해 셔플합니다. 마지막으로 하나의 루트 프래그먼트가 클라이언트에 결과를 반환합니다.
- 계획 및 분할. Nereids 옵티마이저는 SQL을 물리 계획으로 재작성하고, FE는 트리를 순회하며 데이터 재분산이 필요한 모든 지점에서 계획을
PlanFragment로 나눕니다. 여기에는 모든 키를 한 머신에 모아야 하는 집계, 양쪽을 동일한 방식으로 해시 파티셔닝해야 하는 해시 조인, 최종 결과 싱크가 포함됩니다. - 셔플 방식 선택. 각 프래그먼트 경계에서 플래너는 네 가지 분산 모드 중 하나를 선택하고, 해시 조인에서는 네 가지 전략 중 하나를 선택합니다. Broadcast Join(오른쪽 데이터를 모든 왼쪽 인스턴스로 복사), Shuffle Join(양쪽 데이터를 조인 키로 해시 파티셔닝), Bucket Shuffle Join(왼쪽 테이블의 버킷 레이아웃을 재사용하여 오른쪽 데이터만 전송), Colocate Join(두 테이블이 이미 동일한 BE에 있으므로 셔플을 완전히 생략)입니다. 실행할 전략은 비용에 따라 결정됩니다.
- 전송 및 인스턴스화.
Coordinator는 BRPC를 통해 각 프래그먼트를 배정된 BE로 전송합니다. 각 BE는 병렬도 슬롯마다 하나씩 프래그먼트 인스턴스를 생성하고, 스케줄링을 위해 이를 Pipeline 실행 엔진에 전달합니다. - 로컬 스캔 및 필요한 경우 셔플. 스캔 연산자는 동일한 BE에 있는 태블릿을 읽으므로 대량의 데이터가 네트워크를 건너지 않습니다. 다음 프래그먼트가 필요로 하는 행만 컬럼형
Block으로 직렬화되어DataStreamSink→ExchangeNode를 통해 네트워크를 건넙니다. - 결과 반환.
UNPARTITIONED싱크를 가진 루트 프래그먼트가 하나의 BE에서 실행되어 병합된 결과를 수집하고 FE로 돌려보냅니다. FE는 MySQL 프로토콜을 통해 클라이언트에 결과를 스트리밍합니다.
빠른 시작
별도로 활성화할 것은 없습니다. 모든 쿼리가 MPP로 실행됩니다. 운영자에게 가장 유용한 도구는 EXPLAIN으로, 옵티마이저가 선택한 프래그먼트 DAG, 분산 모드, 셔플 전략을 보여 줍니다.
EXPLAIN
SELECT o.o_orderpriority, COUNT(*) AS orders, SUM(l.l_extendedprice) AS revenue
FROM   orders o
JOIN   lineitem l ON o.o_orderkey = l.l_orderkey
WHERE  o.o_orderdate >= '2026-01-01'
GROUP BY o.o_orderpriority
ORDER BY revenue DESC
LIMIT 10;
예상 결과(일부 발췌)
PLAN FRAGMENT 2  (BUCKET_SHFFULE_HASH_PARTITIONED on o_orderkey)
  HASH JOIN   join op: INNER JOIN  ... (Bucket Shuffle)
    SCAN orders  (partitions=12, tablets=120, ...)
    EXCHANGE  HASH_PARTITIONED  <-- from FRAGMENT 1
PLAN FRAGMENT 1  (RANDOM)
  SCAN lineitem  (partitions=48, tablets=480, ...)
PLAN FRAGMENT 0  (UNPARTITIONED)
  RESULT SINK
  AGGREGATE (merge finalize)
    EXCHANGE  HASH_PARTITIONED  <-- from FRAGMENT 2
프래그먼트는 세 개입니다. 프래그먼트 1은 태블릿을 보유한 모든 BE에서 lineitem을 스캔하고, l_orderkey를 기준으로 행을 해싱한 뒤, exchange를 통해 프래그먼트 2로 보냅니다. 프래그먼트 2는 Bucket Shuffle을 사용하여 이 행들을 orders와 조인하고(orders는 o_orderkey를 기준으로 버킷팅되어 있어 태블릿이 이동하지 않습니다), o_orderpriority를 기준으로 사전 집계한 뒤, 부분 집계 그룹을 프래그먼트 0으로 보냅니다. 프래그먼트 0은 집계를 마무리하고 정렬한 뒤 결과를 기록합니다.
Apache Doris MPP 아키텍처는 언제 사용해야 하나요?
Apache Doris MPP는 모든 분석 쿼리의 기본 실행 모드입니다. 일반적인 SELECT에는 다른 실행 경로가 없습니다. MPP의 구조에 맞춰 튜닝하세요.
적합한 경우
- 수천만 개에서 수십억 개 행에 걸친 분석 스캔. 여러 컬럼을 사용하는 GROUP BY, 대규모 조인, 시간 구간 집계가 여기에 해당합니다.
- 스타 스키마 및 스노플레이크 스키마의 조인. Broadcast 대신 Bucket Shuffle이나 Colocate Join을 선택하는 것이 바로 Nereids 옵티마이저가 설계된 목적입니다.
- 쿼리가 모든 BE에서 실행되어야 하는 멀티테넌트 클러스터. MPP를 Workload Group과 함께 사용하면 테넌트별로 CPU와 메모리를 격리할 수 있습니다.
- 편향된 데이터에 대한 장시간 실행 쿼리. MPP 플래너의 셔플 결정은 BE의 Local Shuffle에 반영되며, 이를 통해 각 BE 내부의 데이터 편향을 완화합니다.
적합하지 않은 경우
- 수천 QPS 수준의 단일 행 기본 키 조회. 계획 수립, 프래그먼트 전송, BRPC 왕복에 드는 비용이 실제 작업량을 훨씬 웃돕니다. 이 경우 고동시성 포인트 쿼리를 사용하세요.
- MPP를 행 단위로 처리하는 OLTP 엔진으로 사용하는 경우. 행별 트랜잭션 계층은 없으며, 업데이트는 Unique Key 테이블과 대량 데이터 적재 경로를 통해 수행합니다.
- MPP를 Pipeline 또는 벡터화 실행과 혼동하는 경우. 세 가지는 계층을 이루며 서로 대체할 수 없습니다. Pipeline 실행 엔진은 하나의 BE 내부에서 연산자를 실행하고, 벡터화 실행은 컬럼 배치를 대상으로 내부 루프를 실행하며, MPP는 여러 BE에 걸쳐 이들을 조율합니다.
- 작은 클러스터의 작은 테이블. 전체 테이블이 하나의 프래그먼트 메모리에 들어가고 하나의 BE CPU가 일 초도 안 되어 작업을 마칠 수 있다면, 플래너는 단일 BE에서의 Broadcast Join을 선택하며 이것이 올바른 선택입니다.
더 읽어보기
- 제품 개념: Fragment, Instance, Exchange: 다른 문서의 기반이 되는 표준 사용자용 정의입니다.
- 시스템 아키텍처: FE/BE의 역할, FE 합의를 위한 BDBJE, 토폴로지에서 Coordinator가 위치하는 지점을 설명합니다.
- 조인 최적화 및 셔플 전략: Broadcast, Shuffle, Bucket Shuffle, Colocate Join 간의 비용 절충을 예제와 함께 설명합니다.
- Pipeline 실행 엔진: MPP가 프래그먼트를 전달하는 BE 내부 스케줄러입니다. 각 BE 내부의 동작을 알아보려면 이 문서를 읽어 보세요.
- 병렬도 튜닝: 워크로드별로
parallel_pipeline_task_num을 언제, 어떻게 재정의하는지 설명합니다. - Apache Doris 실행 엔진의 발전 과정: volcano에서 Pipeline을 거쳐 PipelineX로 이어지는 설계의 역사와 그 과정에서 이루어진 MPP 플래너의 변화를 설명합니다.