Parquet 리더 최적화
요약 Apache Doris는 네이티브 C++ 벡터화 Parquet 리더를 외부 Catalog와 TVF에 제공하며, Java나 Arrow를 거치는 왕복 처리가 필요하지 않습니다. 리더는 파일 자체의 통계를 기반으로 행 그룹 전체와 개별 페이지를 가지치기하고, 사전 ID에 조건식을 적용하며, 페이로드 컬럼보다 필터 컬럼을 먼저 읽습니다. 원격 읽기를 병합해 요청 수를 줄이므로, 대부분의 쿼리는 필요하지 않은 컬럼을 전혀 디코딩하지 않고 완료됩니다.
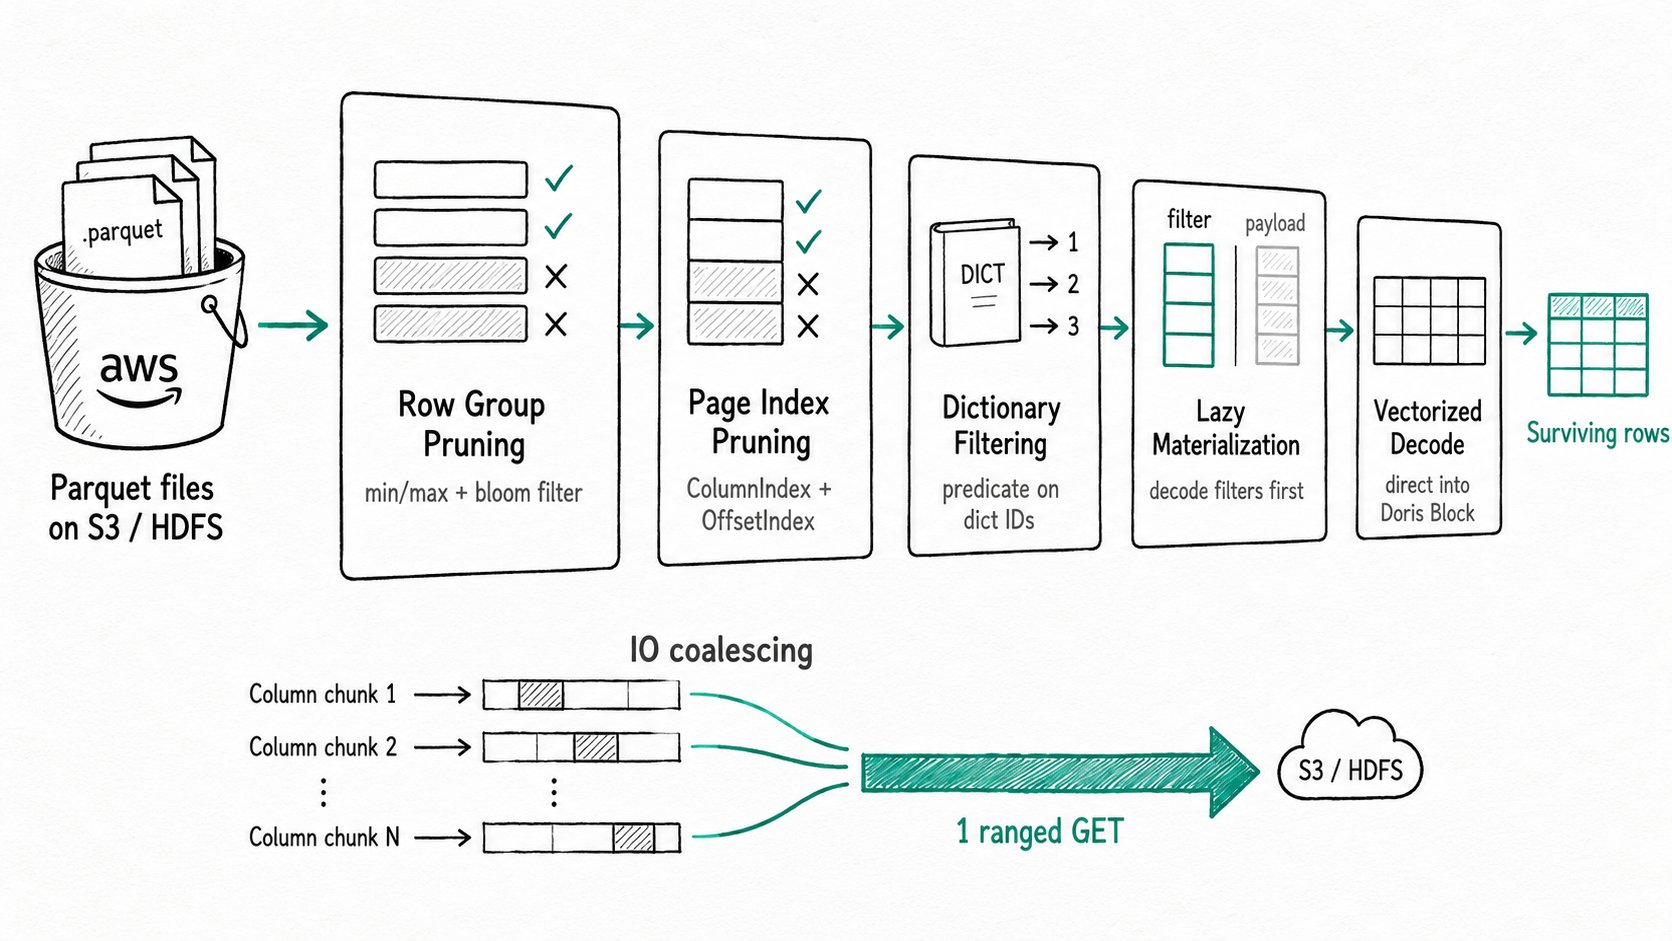
Apache Doris의 Parquet 리더를 사용하는 이유는 무엇인가요?
Apache Doris의 네이티브 Parquet 리더는 레이크하우스 스캔에서 가장 큰 비중을 차지하는 세 가지 비용, 즉 객체 스토리지에서 바이트를 가져오는 비용, 페이지를 압축 해제하고 디코딩하는 비용, 값을 엔진의 런타임 표현으로 변환하는 비용을 줄이기 위해 만들어졌습니다. S3에 있는 Hive나 Iceberg 테이블은 결국 Parquet 파일의 집합이며, 단순한 리더는 쿼리마다 이 세 가지 비용을 모두 치릅니다.
레이크하우스 쿼리를 튜닝해 본 사람이라면 다음과 같은 형태로 이러한 비용을 경험했을 것입니다.
WHERE order_date >= '2026-04-01'필터가 모든 Parquet 파일의 모든 행 그룹을 스캔합니다. 리더가 파일의 행 그룹별 min/max를 확인하지 않기 때문입니다.WHERE user_id = 12345와 같은 포인트 조회가 해당 ID를 포함할 가능성이 있는 행 그룹이 하나뿐인데도user_id컬럼 전체를 읽습니다.- S3에 있는 컬럼이 많은 이벤트 테이블에
SELECT *를 실행하면, 컬럼 청크마다 하나씩 파일당 수백 개의 작은 HTTP GET 요청이 발생합니다. country = 'JP'와 같은 조건식이 수백만 행의 UTF-8 데이터를 압축 해제하고 디코딩합니다. 컬럼이 사전 인코딩되어 있어 행마다 정수 비교 한 번으로 결과를 구할 수 있는데도 그렇습니다.
Apache Doris Parquet 리더는 스토리지에서 페이지를 가져오기 전에 이러한 불필요한 작업을 각각 피하도록 설계되었습니다.
Apache Doris Parquet 리더란 무엇인가요?
Apache Doris Parquet 리더는 Parquet 메타데이터를 읽고, 사용 가능한 모든 단위(행 그룹, 페이지, 사전, 컬럼)에서 가지치기를 수행하며, 벡터화 실행기가 사용하는 것과 동일한 Block 형식으로 값을 직접 디코딩하는 네이티브 C++ 컴포넌트입니다. 이 처리 경로에는 Java 라이브러리나 Arrow를 거치는 왕복 처리가 없습니다.
주요 용어
Row group: 병렬 읽기를 위해 Parquet 파일을 나누는 단위입니다. 각 행 그룹은 컬럼별 min/max와 NULL 개수 통계를 포함합니다.PageIndex: 선택적으로 포함되는 Parquet 구조(ColumnIndex + OffsetIndex)입니다. 동일한 통계를 페이지 단위로 제공하며, 리더가 각 페이지로 직접 이동할 수 있도록 페이지별 바이트 오프셋도 제공합니다.Lazy materialization: 필터 컬럼을 먼저 디코딩한 다음, 필터링을 통과한 행의 페이로드 컬럼만 가져오는 두 단계 읽기 방식입니다.Dictionary filtering: 컬럼 청크의 사전 페이지에 조건식을 한 번 평가한 뒤, 각 행을 그 결과로 얻은 사전 ID 집합과 비교하는 방식입니다.
Apache Doris Parquet 리더는 어떻게 동작하나요?
Apache Doris Parquet 리더는 다섯 단계의 파이프라인을 실행하며, 각 단계는 다음 단계에서 확인해야 할 데이터의 양을 줄입니다.
- 행 그룹 가지치기. 파일을 열면 리더는 각 행 그룹의 컬럼 통계를 살펴보고, 해당 min/max 범위에서 조건을 만족할 가능성이 없으면 행 그룹 전체를 제외합니다. 파일에 Parquet bloom filter가 있으면 이 단계에서 함께 확인합니다. 두 검사 모두 컬럼 페이지를 가져오기 전에 메타데이터만으로 수행됩니다.
enable_parquet_filter_by_min_max와enable_parquet_filter_by_bloom_filter로 제어합니다. - PageIndex를 통한 페이지 가지치기. 필터링을 통과한 각 행 그룹에 대해 리더는 ColumnIndex와 OffsetIndex를 파싱하여 min/max가 조건에 맞지 않는 개별 페이지를 제외합니다. OffsetIndex는 남은 각 페이지의 바이트 범위를 제공하므로, 리더는 제외된 바이트를 스캔하지 않고 다음 페이지로 바로 이동합니다. BE 설정
enable_parquet_page_index로 활성화하거나 비활성화할 수 있습니다. - 사전 필터링. 컬럼 청크가 사전 인코딩되어 있고 조건식이 단일 슬롯 표현식이면, 리더는 사전 페이지만 디코딩하고 여기에 조건식을 평가한 뒤 사전 ID에 적용되도록 조건식을 다시 작성합니다. 그러면 데이터 페이지에서는 비트 패킹된 정수 비교를 수행하게 됩니다.
- 지연 구체화. 필터링을 통과한 행은 최종적으로 구성해야 합니다. 리더는 컬럼을 필터 컬럼(조건식에서 참조하는 컬럼)과 페이로드 컬럼으로 나누고, 필터 컬럼을 디코딩하여 행 선택 비트맵을 만든 다음, 통과한 행의 페이로드 컬럼만 가져옵니다. 세션 변수
enable_parquet_lazy_mat로 제어하며, 기본적으로 활성화되어 있습니다. - IO 병합 및 직접 디코딩. 행 그룹 내에서 인접한 컬럼 청크를 하나의 범위 읽기로 병합하므로, 엔진은 여러 번이 아닌 한 번의 HTTP GET 요청을 보냅니다. 디코딩된 값은 Arrow를 거치는 왕복 처리 없이 Doris의 벡터화 컬럼에 직접 저장됩니다.
그 결과, 실행기에 전달되는 행은 이미 조건을 만족하는 것으로 확인된 상태이며, 쿼리에서 요청한 컬럼만 디코딩됩니다.
빠른 시작
SELECT region, count(*) AS orders, sum(amount) AS revenue
FROM s3(
  "uri"    = "s3://demo-bucket/orders/year=2026/*.parquet",
  "format" = "parquet",
  "s3.endpoint"   = "https://s3.us-east-1.amazonaws.com",
  "s3.access_key" = "AK...",
  "s3.secret_key" = "SK..."
)
WHERE order_date >= '2026-04-01' AND status = 'PAID'
GROUP BY region;
예상 결과(프로파일 발췌)
VFileScanNode
  FilteredRowGroups:           18 / 24
  FilteredPages:               210 / 980
  LazyReadFilteredRows:        92.1%
  RemoteIOMergedRanges:        14 (from 96 chunks)
리더는 날짜 조건식으로 24개 행 그룹 중 18개를 제외한 다음, 남은 행 그룹에서 status의 PageIndex를 사용해 페이지 210개를 제외했습니다. 지연 구체화를 통해 조건에 맞지 않는 행 92.1%에 대해서는 region과 amount의 디코딩을 건너뛰었습니다. 아흔여섯 개의 컬럼 청크는 S3에 대한 범위 GET 요청 14개로 병합되었습니다.
Apache Doris Parquet 리더는 언제 사용해야 하나요?
Apache Doris Parquet 리더는 쿼리가 Parquet를 읽을 때마다 자동으로 사용되므로, 관건은 리더가 제 역할을 할 수 있는 조건을 갖추는 것입니다.
적합한 경우
- 데이터 파일이 Parquet 형식인 Hive, Iceberg, Hudi, Paimon Catalog.
- s3() 및
hdfs()TVF를 통한 직접 파일 분석. - 컬럼이 많은 테이블에서 일부 행만 선택하는 쿼리: 조건식으로 많은 행을 걸러낼수록 지연 구체화가 건너뛸 수 있는 작업도 많아집니다.
- 파일을 쓰는 도구가 통계를 기록한 컬럼에 적용하는 동등 및 범위 조건식.
- 포인트 조건식이나
IN조건식을 적용하는 사전 인코딩된 문자열 컬럼.
적합하지 않은 경우
- 수천 개의 작은 Parquet 파일로 저장된 테이블. 각 footer를 파싱해야 하고 청크마다 최소 한 번의 범위 읽기가 필요하므로, 파일별 오버헤드가 대부분을 차지합니다. 컴팩션을 통해 파일 크기를 128 MB에서 1 GB 사이로 맞추세요.
- 컬럼 통계나 PageIndex 없이 작성된 파일. 가지치기에 사용할 정보가 없으므로 리더는 전체 스캔을 수행합니다. 파일을 쓰는 도구에서 통계를 활성화하세요(Spark 3.2+와 parquet-mr 1.11+는 모두 PageIndex를 기록합니다).
- 깊이 중첩된 struct 필드 내부에서 일부 행만 선택하는 조건식. 복합 타입에서는 일부 최적화(페이지 인덱스, 사전 필터링)가 비활성화되므로, 리더가 필터링을 통과한 행 전체를 순회합니다. 가능하면 접근 경로를 평탄화하거나 최상위 컬럼을 사용하세요.
- 이전 버전의 Hive 쓰기 도구가 INT96으로 기록한 DATETIME 컬럼. INT96 통계는 손상되는 경우가 많으므로 리더는 해당 컬럼의 min/max 가지치기를 건너뜁니다. 쓰기 방식을 제어할 수 있다면 INT64 타임스탬프로 기록하세요. INT96에 대해서는 Hive Catalog 참고 사항을 확인하세요.
추가 자료
- Parquet 파일 형식 참조: 사용자 설정 항목(
enable_parquet_lazy_mat,enable_parquet_page_index, 버퍼 크기 관련 BE 설정)과 버전별 지원 여부. - S3/HDFS의 파일 분석:
s3()및hdfs()TVF로 Parquet 파일을 직접 쿼리하는 방법. - 데이터 가지치기: Doris가 데이터 읽기를 건너뛰는 전반적인 방식과 그중 한 계층을 담당하는 Parquet 리더.
- 벡터화 실행: 리더가 디코딩한 데이터를 전달하는 엔진과 Arrow를 거치는 왕복 처리를 생략하는 것이 중요한 이유.
- 데이터 캐시: 반복 스캔 시 원격 읽기를 완전히 건너뛸 수 있도록 디코딩된 Parquet 페이지를 로컬에 캐시하는 시점.
- 메타데이터 캐시: Parquet 리더의 가지치기가 의존하는 스키마, 파티션, 파일 목록을 위한 FE 측 캐시.
- Multi-Catalog: S3, HDFS, Hive, Iceberg, Paimon의 Parquet 테이블을 Doris에 연결하는 방법.
- Catalog 통합: Parquet 파일을 보관하는 Catalog의 소스별 커넥터 참조.
- 차세대 데이터 레이크하우스 구축(Apache Doris 블로그): 네이티브 Parquet 리더를 처음으로 공개 소개한 글.
- Iceberg: 이 최적화로 Parquet 스캔이 가장 직접적으로 가속화되는 레이크하우스 테이블 형식.