파티셔닝과 버킷팅
핵심 요약 모든 Apache Doris 테이블은 두 단계로 나뉩니다.
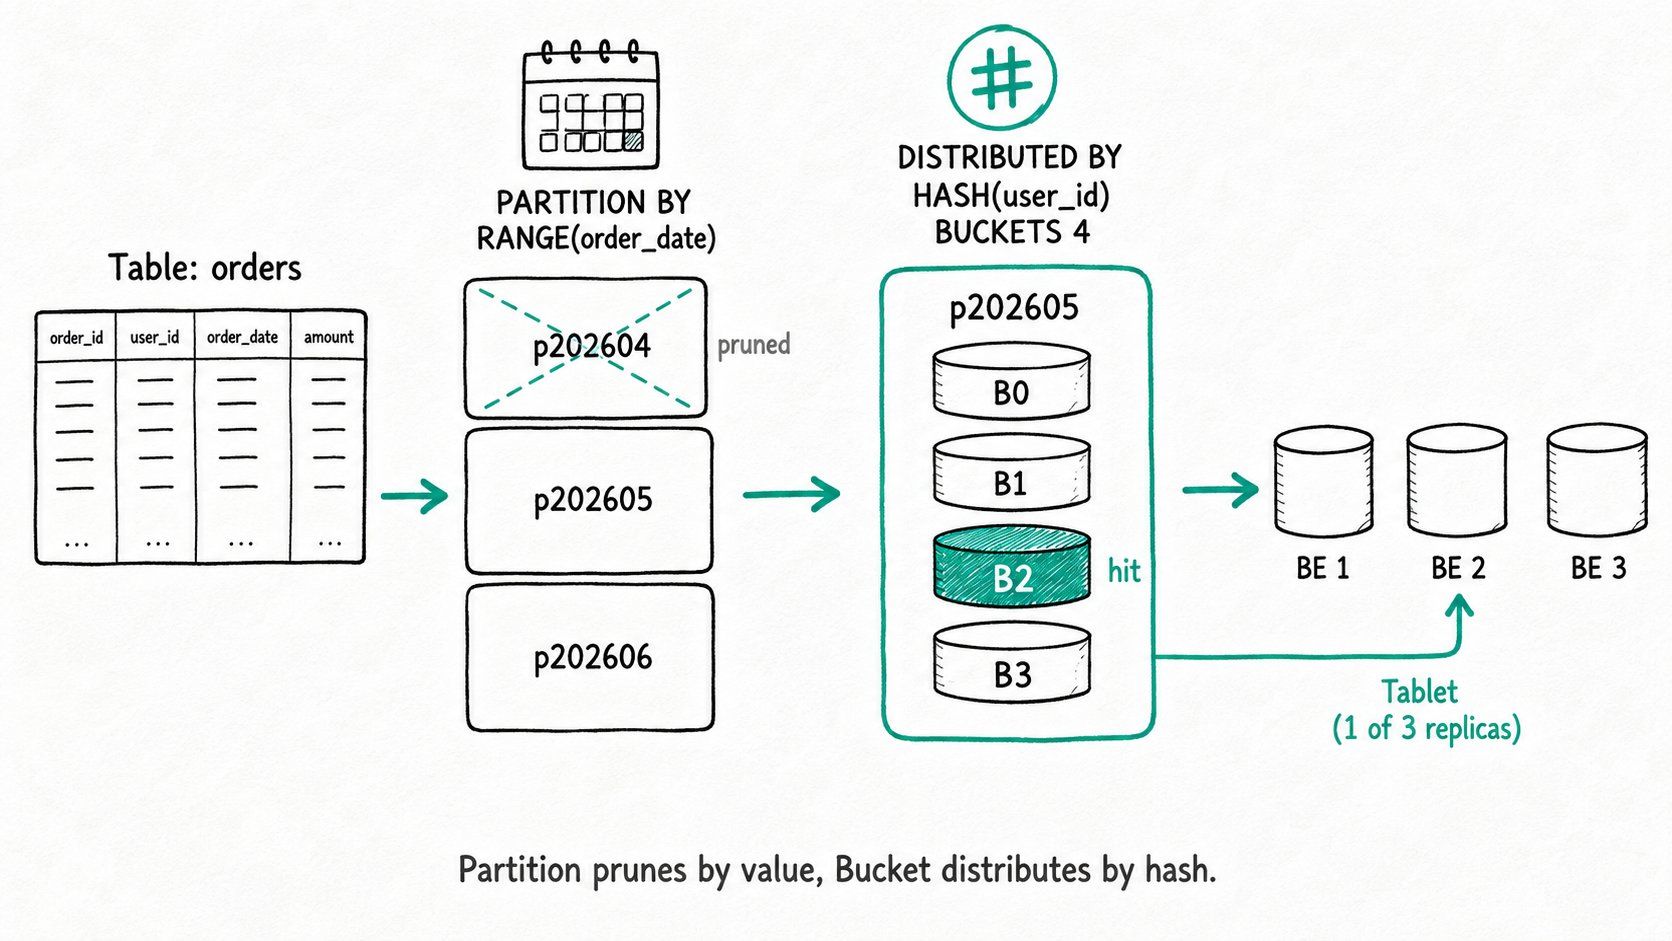
PARTITION BY절은 열 값(일반적으로 날짜)을 기준으로 행을 나누고,DISTRIBUTED BY절은 각 파티션을 N개의 태블릿으로 나눕니다. 파티션은 플래너가 큰 단위로 데이터를 제외하고 운영자가 데이터를 보관할 수 있는 단위를 제공합니다. 버킷은 클러스터가 병렬로 스캔하고 쓸 수 있는 단위를 제공합니다. 파티션 키에는 쿼리에서 필터링하는 날짜 열을, 버킷 키에는 동등 조건에 사용되는 카디널리티가 높은 열을 선택하고, 나머지 크기 조정은BUCKETS AUTO에 맡기세요.
Apache Doris에서 파티셔닝과 버킷팅을 사용하는 이유는 무엇인가요?
Apache Doris의 파티셔닝과 버킷팅은 테이블이 단일 머신의 처리 용량을 넘어설 때 나타나는 세 가지 문제를 해결합니다. 모든 데이터를 스캔하는 쿼리, 하나의 BE에 부하를 집중시키는 단일 태블릿 테이블, 그리고 몇 시간씩 걸리는 데이터 삭제입니다.
- 365일치 이벤트 테이블에서
WHERE date BETWEEN '2026-04-01' AND '2026-04-07'쿼리를 실행하면, 플래너가 나머지 358일을 건너뛸 수 있다는 정보를 얻기 전까지는 모든 날짜의 모든 행을 읽습니다. - 4 TB 테이블을 하나의 태블릿에 적재하면 하나의 BE가 CPU를 100% 사용하고 나머지 아홉 개는 유휴 상태로 남습니다. 클러스터에는 병렬 처리 능력이 있지만 테이블이 이를 활용하지 못합니다.
- 지난 분기 데이터를 제거하는 작업이 메타데이터 변경으로 끝나지 않고 몇 시간씩 걸리는
DELETE작업이 됩니다.
파티셔닝은 첫 번째와 세 번째 문제를 해결합니다. 버킷팅은 두 번째 문제를 해결합니다. 이 두 방식이 각 행의 저장 위치와 쿼리 실행 시 해당 행에 접근할 BE를 결정합니다.
Apache Doris의 파티셔닝과 버킷팅이란 무엇인가요?
Apache Doris의 파티셔닝과 버킷팅은 모든 테이블에 적용되는 두 단계 물리적 배치 구조입니다. PARTITION BY 절은 열 값(Range 또는 List)을 기준으로 테이블을 서로 겹치지 않는 부분집합으로 나누고, DISTRIBUTED BY 절은 각 파티션을 복제와 병렬 처리의 단위인 태블릿으로 다시 나눕니다. 태블릿 수는 고정됩니다. 행은 먼저 값에 따라 파티션이 결정되고, 그다음 해시 또는 무작위 할당에 따라 태블릿이 결정됩니다.
주요 용어
Partition: 하나 이상의 KEY 열에 대한 Range 또는 List로 정의되는 행의 부분집합입니다. 프루닝, 아카이빙, TTL의 단위입니다.Bucket: 해시 또는 무작위 할당으로 나뉜 파티션의 일부입니다. 각 버킷은 복제본마다 하나의 태블릿에 대응합니다.Tablet: 물리적인 데이터 샤드입니다. 복제, 스케줄링, BE 내부 병렬 처리의 단위입니다.PARTITION BY RANGE / LIST: DDL에서 명시적으로 선언하는 파티셔닝입니다. Range는 시간 및 숫자 범위에 적합하고, List는 리전이나 테넌트처럼 값이 열거되는 차원에 적합합니다.AUTO PARTITION: 데이터 쓰기 시점에 필요에 따라 생성되는 파티션입니다. 범위 파티션은date_trunc(col, 'month')을 기준으로, 목록 파티션은 열거된 값을 기준으로 생성됩니다. 정적 파티션 목록을 대체합니다.DISTRIBUTED BY HASH(col) BUCKETS N: 해시로 분산되는 샤드입니다.crc32(col) % N으로 버킷을 선택하며,col에 대한 동등 조건이 있으면 버킷 프루닝을 수행할 수 있습니다.DISTRIBUTED BY RANDOM BUCKETS N: 키 없이 행을 여러 버킷에 분산합니다. 데이터 쏠림을 방지하지만 버킷 프루닝은 지원하지 않습니다. Duplicate-Key 테이블에서만 사용할 수 있습니다.BUCKETS AUTO: FE가estimate_partition_size, BE 수, 디스크 수를 기준으로 버킷 수를 결정합니다. 파티션별로 설정합니다.
Apache Doris의 파티셔닝과 버킷팅은 어떻게 동작하나요?
Apache Doris의 파티셔닝과 버킷팅은 파티션 선택과 태블릿 선택이라는 두 단계를 통해 행이 INSERT에서 디스크까지 이동하는 경로를 결정합니다.
- 행을 파티션에 매핑합니다. 플래너가 파티션 표현식을 평가합니다. Range 파티션은 정렬된 구간 목록에서 이진 검색을 수행하고, List 파티션은 해시 맵에서 값을 조회합니다. 일치하는 파티션이 없으면 Auto Partition이 즉시 파티션을 생성합니다.
- 행을 버킷에 매핑합니다. 해시 분산은
crc32(bucket_cols) % bucket_num을 계산합니다. 무작위 분산은 라운드 로빈 방식으로 태블릿을 선택합니다. 단,load_to_single_tablet = true이면 배치 전체를 하나의 태블릿에 배치합니다. - 해당 태블릿의 복제본에 씁니다. 각 태블릿에는 서로 다른 BE에 배치된 N개의 복제본(기본값 3)이 있습니다. Coordinator는 모든 복제본으로 행을 스트리밍합니다.
- 쿼리 실행 시 프루닝을 수행합니다(FE).
PruneOlapScanPartition은WHERE조건을 파티션 트리와 대조합니다.PruneOlapScanTablet은 버킷 키에 대한 동등 조건을 추출하고,HashDistributionPruner를 통해 해당 조건의 값이 어떤 버킷으로 해시되는지 확인합니다. EXPLAIN은 남은 파티션과 태블릿을partitions=1/365와tablets=1/32로 표시합니다. - 남은 태블릿을 병렬로 스캔합니다(BE). 남은 각 태블릿은 병렬 스캔 단위입니다. 파이프라인 엔진이 이들을 BE 코어에 분산하므로, 4개의 BE에 있는 16개의 태블릿에 접근하는 쿼리는 별도의 세션 설정 없이 16개 작업을 병렬로 실행합니다.
디스크상의 계층 구조는 Table → Partition → Tablet → Rowset → Segment입니다. 컴팩션과 복제는 태블릿 수준에서 수행되므로, 파티션 수와 버킷 수는 쿼리 병렬성과 운영 비용을 모두 좌우합니다. 플래너가 남길 파티션과 태블릿을 선택한 뒤 실행되는 계층별 프루닝 과정은 데이터 프루닝을 참조하세요.
빠른 시작
CREATE TABLE orders (
  order_id   BIGINT,
  user_id    BIGINT,
  order_date DATE NOT NULL,
  amount     DECIMAL(10,2)
)
DUPLICATE KEY(order_id, user_id)
AUTO PARTITION BY RANGE (date_trunc(order_date, 'month')) ()
DISTRIBUTED BY HASH(user_id) BUCKETS 16;

INSERT INTO orders VALUES
  (1, 100, '2026-04-15', 99.00),
  (2, 200, '2026-05-02', 50.00);

EXPLAIN SELECT SUM(amount) FROM orders
WHERE order_date >= '2026-05-01' AND user_id = 200;
예상 결과(발췌)
0:VOlapScanNode
  TABLE: orders
  PREDICATES: order_date >= '2026-05-01', user_id = 200
  partitions=1/2 (p20260501000000)
  tablets=1/16
두 달치 데이터로 파티션 두 개가 자동 생성되었습니다. 플래너는 날짜 조건으로 파티션 하나를 남기고, user_id 동등 조건으로 열여섯 개 태블릿 중 하나만 남겼으므로, 쿼리는 테이블의 1/32만 읽습니다. 쓰기는 열여섯 개 태블릿 전체에 분산되므로, 한 번의 데이터 적재에서 열여섯 개 BE 작업자가 병렬로 동작합니다.
Apache Doris의 파티셔닝과 버킷팅은 언제 사용해야 하나요?
Apache Doris의 파티셔닝은 프루닝이나 아카이빙이 필요한 시계열 테이블과 열거형 차원을 가진 테이블에 적합합니다. 버킷팅은 하나의 태블릿으로는 스캔이나 쓰기를 감당할 수 없을 만큼 큰 모든 테이블에 적합합니다.
적합한 경우
- 시계열 팩트 테이블(이벤트, 주문, 로그). 타임스탬프에 Range 또는 Auto Range를 적용하면 일반적인 대시보드 쿼리에서 플래너가 거의 모든 파티션을 건너뛸 수 있으며, 한 달치 데이터도 메타데이터 변경만으로 제거할 수 있습니다.
user_id,device_id또는 카디널리티가 높은 다른 열의 동등 조건을 사용하는 고동시성 포인트 쿼리. 해당 열을 해시 버킷 키로 지정하면 쿼리 하나가 태블릿 하나에만 접근합니다.- 값이 안정적으로 유지되는 열거형 차원을 가진 멀티 테넌트 또는 리전별 테이블. 테넌트를 기준으로 List 파티셔닝을 적용하면 테넌트의 파티션을 삭제하여 해당 테넌트의 데이터를 제거할 수 있습니다.
- 증분 데이터 적재를 수행하며 값의 범위를 예측할 수 없는 테이블.
AUTO PARTITION BY RANGE(date_trunc(...))는 최초 쓰기 시 파티션을 생성하므로 파티션 관리 DDL을 전혀 작성하지 않아도 됩니다. - 같은 키로 조인하며 작업이 넓게 분산되는 두 대형 테이블. 두 테이블의 버킷 키를 일치시키고 Colocate Join을 활성화하면 셔플을 생략할 수 있습니다.
적합하지 않은 경우
- 쿼리에서 필터링하지 않는 카디널리티가 낮은 열(상태 플래그, 값이 5개인 국가 열)로 파티셔닝하는 경우. 플래너가 제외할 수 있는 파티션이 없으므로, 한 번도 건너뛰지 않는 파티션에 메타데이터 비용만 지불하게 됩니다.
- 필터링에 사용하지 않는 열로 버킷팅하는 경우. 쓰기 시 해시 계산 비용을 지불하면서도 프루닝 효과는 얻지 못합니다. 선택도가 가장 높은 동등 조건의 열을 선택하거나, 그런 열이 없다면
RANDOM을 사용하세요. - 카디널리티가 낮은 열(예:
gender)로 버킷팅하는 경우. 값이 두 개뿐이면 16개 버킷에 고르게 분산할 수 없어, 부하가 몰리는 태블릿과 부하가 거의 없는 태블릿이 생깁니다. 카디널리티가 높은 열을 선택하거나 여러 열을 조합해 버킷 키로 사용하세요. - 파티션마다 수백 개의 버킷을 두는 경우. 문서상 한도는 파티션당 128개입니다. 이를 초과하면 쓰기 처리량이 떨어지고 FE 메모리 사용량이 늘어납니다(경험적 기준: 태블릿 10백만 개당 FE 메모리 100 GB). 먼저 파티셔닝하고, 그다음 버킷팅하세요.
- 크기가 메가바이트 수준인 작은 태블릿. 각 태블릿에는 FE 메타데이터와 컴팩션 루프 비용이 듭니다. 태블릿당 압축 후 크기는 1 GB에서 10 GB를 목표로 하세요(Unique-Key 테이블은 10 GB 미만으로 유지).
- Unique 또는 Aggregate 테이블에 무작위 버킷팅을 적용하는 경우. 무작위 분산은 병합의 정확성을 깨뜨리므로 Duplicate 테이블에서만 사용할 수 있습니다.
더 읽어보기
- 기본 개념: 그림으로 살펴보는 파티션과 버킷
- 수동 파티셔닝: Range, List 및 네 가지 Range 형식
- 자동 파티셔닝: 쓰기 시점에 필요에 따라 파티션 생성
- 데이터 버킷팅: 방식, 키, 버킷 수 선택
- 데이터 프루닝: 파티션과 태블릿 선택 후 실행되는 계층별 프루닝 과정
ALTER TABLE PARTITION참조- MPP 아키텍처: Bucket Shuffle과 Colocate Join은 여기서 선택한 버킷 배치 구조를 활용해 네트워크 셔플을 방지합니다.
- Unique Key: 파티션 열이 Unique Key의 부분집합이어야 하는 테이블 모델입니다. 이 조건을 충족하지 않으면 중복 제거가 올바르게 동작하지 않습니다.