파이프라인 실행 엔진
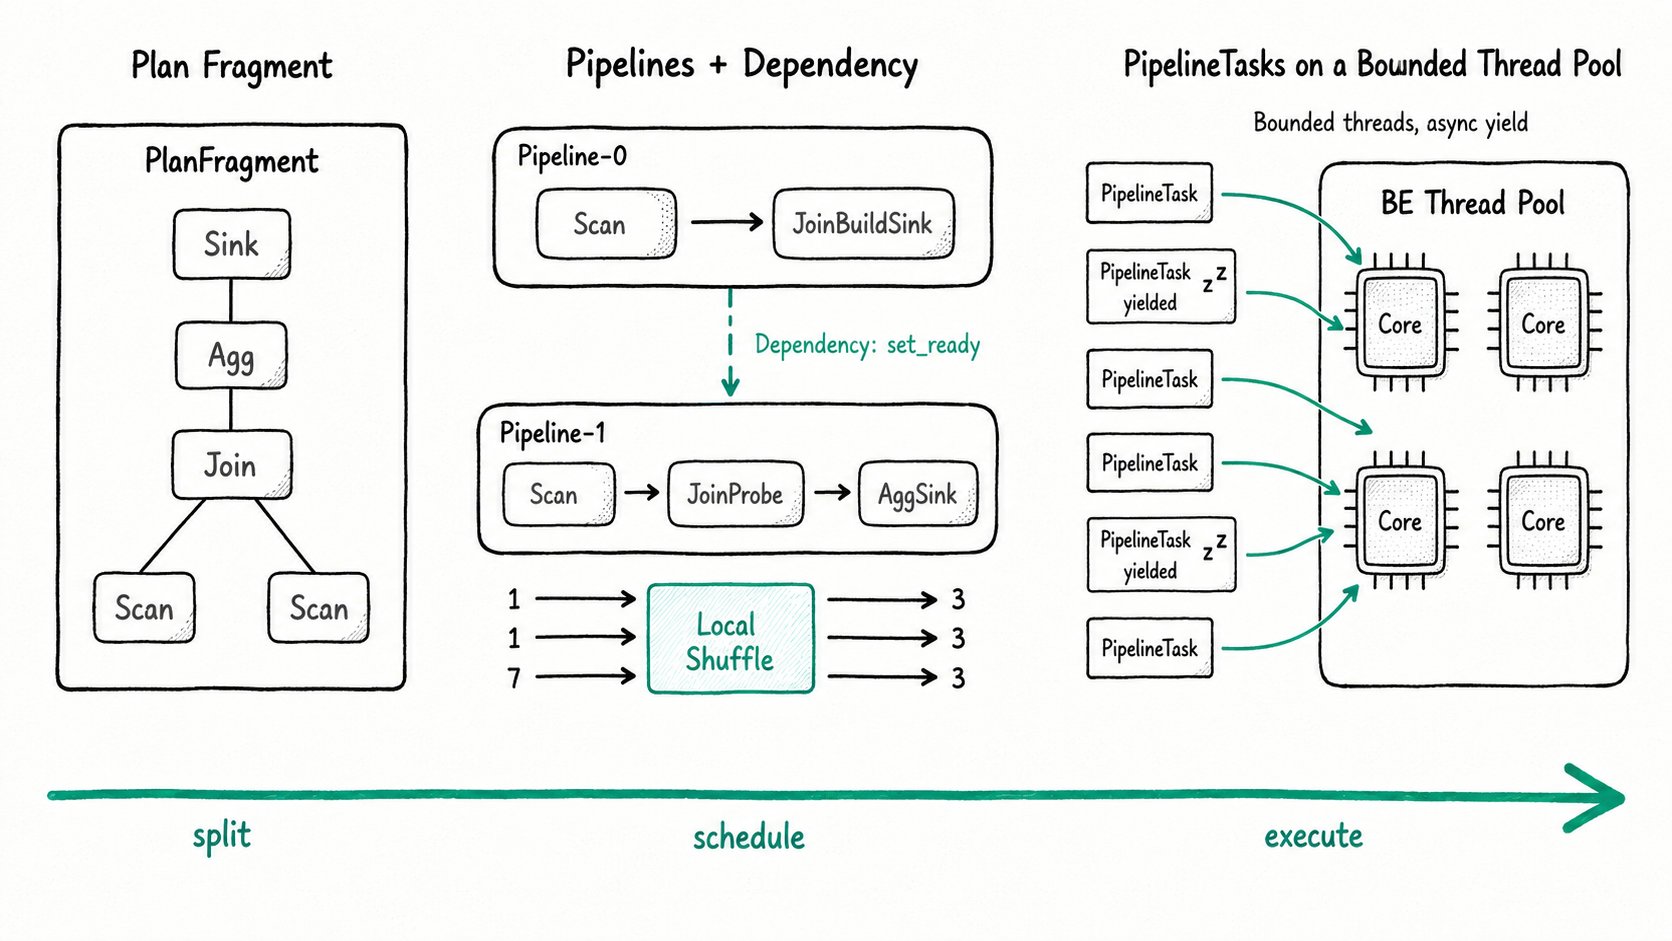
핵심 요약 Apache Doris 파이프라인 실행 엔진은 v3.0부터 기존 volcano 모델을 대체하는 유일한 실행 엔진입니다. 각 쿼리 프래그먼트는 소스에서 시작해 싱크에서 끝나는 파이프라인의 DAG로 나뉘며, BE에 할당된 CPU 자원에 맞춰 크기가 고정된 BE 스레드 풀에서 PipelineTasks로 실행됩니다. 연산자는 블로킹하는 대신 실행을 양보하고, 의존성이 DAG의 실행을 조율하며, Local Shuffle이 BE 내부에서 편향된 데이터의 분포를 고르게 조정합니다.
Apache Doris에서 파이프라인 실행 엔진을 사용하는 이유는 무엇인가요?
Apache Doris 파이프라인 실행 엔진은 기존 volcano 모델이 해결하지 못했던 세 가지 문제를 해결합니다. 동시 실행 시 스레드 수가 제한 없이 늘어나는 문제, 데이터가 편향된 조인과 집계에서 코어가 유휴 상태로 남는 문제, 그리고 추측에 의존해야 했던 프래그먼트 인스턴스별 튜닝입니다. Apache Doris가 과거에 사용하던 volcano 모델은 각 프래그먼트 인스턴스에 전용 OS 스레드를 할당했습니다. 동시 쿼리가 몇 개뿐이라면 문제가 없습니다. 하지만 백 개가 되면 문제가 생깁니다. 수천 개의 스레드가 쌓이고 대부분은 IO나 다른 스레드를 기다리며 블로킹됩니다. 결국 BE는 처리할 작업이 남아 있는데도 커널 스케줄러에 과부하를 주고 메모리를 소진하게 됩니다.
기존 엔진에는 해결하지 못한 문제가 두 가지 더 있었습니다. 와이드 테이블 집계와 편향된 데이터에 대한 조인은 코어를 충분히 활용하지 못했습니다. 버킷 하나에 행이 7개 있고 나머지 버킷에는 각각 1개씩 있다면, 행 7개를 처리하는 작업이 전체 완료 시간을 결정하는 병목이 되고 클러스터의 나머지 부분은 유휴 상태로 그 작업을 기다리게 됩니다. 또한 프래그먼트 인스턴스 수준에서 동시성을 튜닝하려면 너무 많은 설정을 놓고 추측해야 했습니다.
Pipeline은 이 세 가지 문제를 모두 해결합니다. 스레드 수는 쿼리 수와 무관하게 일정한 한도 내로 제한됩니다. 연산자는 더 이상 진행할 수 없을 때 스레드를 점유한 채 기다리는 대신 실행을 양보하여 스레드를 해제합니다. 또한 Local Shuffle이 BE 내부에서 편향된 데이터를 재분배하여 병목 작업의 처리 시간을 줄입니다.
Apache Doris 파이프라인 실행 엔진이란 무엇인가요?
Apache Doris 파이프라인 실행 엔진은 각 PlanFragment를 파이프라인의 DAG로 변환하고, 크기가 제한된 BE 스레드 풀에서 스케줄링하는 푸시 기반 비동기 쿼리 실행 모델입니다. FE는 쿼리를 Plan으로 컴파일하고 이를 PlanFragments(BE당 하나)로 나누며, 각 BE는 각 프래그먼트를 Pipelines의 DAG로 분해합니다. Pipeline은 하나의 SourceOperator(스캔 또는 exchange)에서 시작해 하나의 SinkOperator(네트워크 셔플 또는 해시 테이블 기록 연산자)에서 끝나는 체인으로, 그 사이에는 임의 개수의 연산자가 올 수 있습니다. 서로 기다려야 하는 Pipelines는 Dependencies가 조율합니다. 각 Pipeline은 병렬 처리 슬롯마다 하나씩 여러 PipelineTasks로 구체화되며, 이 작업들은 BE 전체가 공유하는 고정된 스레드 풀에서 실행됩니다.
핵심 용어
PlanFragment: FE가 하나의 BE에 보내는 작업 단위입니다. 쿼리 하나에는 보통 여러 개가 있습니다.Pipeline: 하나의 BE에서 실행되는 연산자 체인입니다. 여러 PipelineTasks로 병렬 실행됩니다.PipelineTask: 병렬 처리 슬롯에 연결된 파이프라인의 실행 인스턴스입니다. 블로킹되거나 타임 슬라이스가 만료되면 실행을 양보하여 스레드를 해제합니다.Operator: 체인을 구성하는 노드입니다. 일부 PlanNodes는 중간 결과를 구체화해야 할 때 Sink + Source 쌍으로 분리됩니다. Join은JoinBuildOperator+JoinProbeOperator로, Agg는AggSinkOperator+AggSourceOperator로, Sort는SortSinkOperator+SortSourceOperator로 나뉩니다.Dependency: 파이프라인 사이에서 준비 상태를 알리는 신호입니다. Pipeline-0이 해시 테이블 구축을 마치면set_ready를 호출하고, Pipeline-1의 probe가 깨어납니다.- Local Shuffle (Local Exchange): HASH 또는 Round Robin을 사용해 BE 내부에서 데이터를 로컬로 다시 샤딩하는 Pipeline Breaker입니다. 이를 통해 스캔 데이터의 편향이 조인 데이터의 편향으로 이어지는 것을 막습니다.
parallel_pipeline_task_num: 프래그먼트별 병렬 처리 수준을 설정하는 세션 설정입니다. 기본값0은 CPU 코어 수의 절반을 의미하며, 대개 그대로 두는 것이 좋습니다.
Apache Doris 파이프라인 실행 엔진은 어떻게 작동하나요?
Apache Doris 파이프라인 실행 엔진은 여섯 단계로 작동합니다. FE가 실행 계획을 세우고 프래그먼트를 전송하면, 각 BE가 프래그먼트를 파이프라인 DAG로 변환합니다. 이어서 PipelineTasks가 생성되어 크기가 제한된 스레드 풀에서 실행되고, Local Shuffle이 편향된 데이터의 분포를 고르게 조정하며, 병렬 스캔이 느린 버킷 때문에 쿼리가 정체되는 것을 방지합니다.
- FE가 계획하고, 분할하고, 전송합니다. FE는 쿼리를 컴파일하고, BE 간 셔플을 위해
ExchangeNode와DataSink를 삽입한 뒤 각 PlanFragment를 BE로 보냅니다. - BE가 각 프래그먼트를 파이프라인 DAG로 변환합니다. 블로킹 연산자(해시 테이블 구축, 정렬, 집계)는 한 파이프라인을 끝내는 Sink와 다음 파이프라인을 시작하는 Source로 나뉩니다. Dependencies가 DAG를 연결하며, Join의 probe는 build의
set_ready를 기다립니다. - PipelineTasks를 생성합니다. 각 Pipeline은 N개의 PipelineTasks가 됩니다. N개 모두 같은 Operator 체인을 공유하며, 작업별 LocalState만 다릅니다. LocalState에는 처리할 스캔 범위, 해시 테이블 파티션, 출력 버퍼 등이 담깁니다.
- 크기가 제한된 스레드 풀에서 실행합니다. PipelineTasks는 BE에 할당된 CPU 자원에 맞춰 크기가 고정된 풀에 제출됩니다. 이 크기는
pipeline_executor_size로 재정의할 수 있습니다. 작업은 타임 슬라이스가 만료되거나(pipeline_task_exec_time_slice, 기본값 100ms) Dependency에서 블로킹될 때까지 루프를 돌며 계속 실행됩니다. 어느 경우든 실행을 양보하고, 스레드는 다음 실행 가능한 작업을 가져옵니다. - 필요할 때 Local Shuffle을 수행합니다. 플래너는 편향될 가능성이 있는 입력에 대해 조인, 집계 또는 윈도우 함수가 수행되는 것을 감지하면 Local Exchange를 삽입합니다. 상위 작업이 배치를 밀어 넣으면 하위 작업이 재분배된 배치를 가져옵니다. 이를 통해
(1, 1, 7)을(3, 3, 3)으로 고르게 나누어 모든 코어가 비슷한 시점에 작업을 마치도록 합니다. - 병렬 스캔을 수행합니다. ScanOperator는 내부적으로 여러 Scanners를 동적으로 생성합니다. 각 Scanner는 1~2백만 개의 행을 가져와 그 자리에서 압축을 해제하고 필터링한 뒤, 결과를 ScanOperator가 소비하는 DataQueue에 넣습니다. 따라서 느린 버킷 때문에 쿼리가 정체되지 않습니다.
빠른 시작
Pipeline 엔진은 v3.0+에서 기본으로 켜져 있으므로 별도로 활성화할 필요가 없습니다. 조정이 필요할 수 있는 유일한 설정은 parallel_pipeline_task_num입니다.
-- Inspect the default (0 means "half the CPU cores")
SHOW VARIABLES LIKE 'parallel_pipeline_task_num';

-- Pin parallelism for one heavy query without touching the session
SELECT /*+ SET_VAR(parallel_pipeline_task_num=16) */
       l_orderkey, COUNT(*) AS lines, SUM(l_extendedprice) AS gross
FROM lineitem
GROUP BY l_orderkey
ORDER BY gross DESC
LIMIT 100;

-- See the resulting plan and Local Exchange placement
EXPLAIN SELECT /*+ SET_VAR(parallel_pipeline_task_num=16) */
        l_orderkey, COUNT(*) FROM lineitem GROUP BY l_orderkey;
예상 결과
+-------------+-------+----------------+
| l_orderkey  | lines | gross          |
+-------------+-------+----------------+
|     7382118 |     7 |  431295.18     |
|     ...                              |
+-------------+-------+----------------+
이 힌트는 해당 쿼리에만 적용됩니다. EXPLAIN은 파이프라인 ID, 계획에 포함된 경우 Local Exchange, 그리고 연산자 체인을 보여줍니다. 프로파일링을 활성화하면 런타임 프로파일에 PipelineTask별 ExecTime, YieldCounts, MemoryReserveFailedTimes가 표시됩니다. 실제 워크로드를 튜닝할 때는 이러한 지표를 활용합니다.
Apache Doris 파이프라인 실행 엔진은 언제 사용해야 하나요?
Apache Doris 파이프라인 실행 엔진은 v3.0+에서 기본으로 모든 쿼리를 실행합니다. 따라서 실제로 고민할 부분은 사용 여부가 아니라 언제 튜닝할지입니다. 여러 유형의 쿼리가 동시에 실행되는 워크로드, 조인 비중이 높거나 데이터가 편향된 쿼리, 오래 실행되는 스캔에는 기본값을 사용하세요. 프로파일링에서 실제 병목이 확인될 때만 parallel_pipeline_task_num을 재정의하세요.
적합한 경우
- v3.0+의 모든 Apache Doris 워크로드. 다른 실행 엔진은 없습니다.
- 공유 BE에서 여러 유형의 쿼리가 동시에 실행되는 워크로드. 크기가 제한된 스레드 풀이 쿼리 간 간섭을 방지합니다.
- 편향된 입력에 대해 조인이나 집계 비중이 높은 쿼리. Local Shuffle이 불균형을 완화하여 병목 작업 때문에 전체 실행 시간이 늘어나는 것을 막습니다.
- 버킷 간 데이터 분포가 고르지 않은 오래 실행되는 스캔. 병렬 스캔이 느린 버킷 때문에 나머지 작업이 정체되는 것을 방지합니다.
적합하지 않은 경우
- 모든 임시 쿼리에서
parallel_pipeline_task_num을 튜닝하는 것. 기본값은 이미 적절하게 조정되어 있습니다. 프로파일링 결과 오래 실행되는 프래그먼트에서 CPU가 유휴 상태인 것으로 확인될 때만 값을 높이세요. 동시성이 높거나 단순한 포인트 쿼리에서는 값을1로 낮추세요. enable_pipeline_engine또는experimental_enable_pipeline_x_engine을 활성화하라는 오래된 안내를 참고하는 것. 이 설정들은 2.x 계열의 실험적 스위치였습니다. 3.0+에서는 volcano 모델이 삭제되었으므로 아무런 효과가 없습니다.- 이 엔진을 벡터화 실행과 혼동하는 것. 둘은 서로 다른 계층입니다. 벡터화 실행은 연산자가 배치를 어떻게 처리할지 결정하고, Pipeline은 그 배치를 코어에 어떻게 스케줄링할지 결정합니다. 다른 계층에 대해서는 벡터화 실행을 참고하세요.
- 수천 QPS로 처리되는 단일 행 기본 키 조회. 이 수준에서는 여러 PipelineTasks를 생성하는 비용만큼의 이점을 얻지 못합니다. 복잡한 플래너를 거치지 않는 고동시성 포인트 쿼리 경로를 사용하세요.
더 읽어보기
- 파이프라인 실행 엔진 참조: Dependency 규칙, Local Shuffle 계획, 병렬 스캔 메커니즘을 포함한 전체 아키텍처를 설명합니다.
- 병렬 처리 튜닝: 시나리오별로
parallel_pipeline_task_num을 언제, 어떻게 설정할지 설명하며 안전한 기본값 표를 제공합니다. - 데이터 편향 처리: 플래너가 자동으로 해결하지 못한 쿼리에서 Local Shuffle을 보완하는 실용적인 방법을 설명합니다.
- 벡터화 실행: Pipeline이 스케줄링하는 연산자 계층입니다. Pipeline과 자주 혼동되지만, 두 기능은 서로 독립적입니다.
- Workload Group: CPU와 동시성 제한을 위해 파이프라인 스레드를 그룹별 cgroups에 연결하는 계층입니다.
- Apache Doris 실행 엔진의 발전 과정: Doris가 volcano에서 Pipeline을 거쳐 PipelineX로 발전해 온 설계 역사를 설명합니다.
- MPP 아키텍처: Pipeline Engine 위에서 BE 간 작업을 조정하는 계층입니다. 하나의 SQL을 프래그먼트 DAG로 나누고 각 프래그먼트를 BE에 할당합니다.