사전 집계와 롤업
핵심 요약 Apache Doris의 사전 집계는 Aggregate Key 모델과
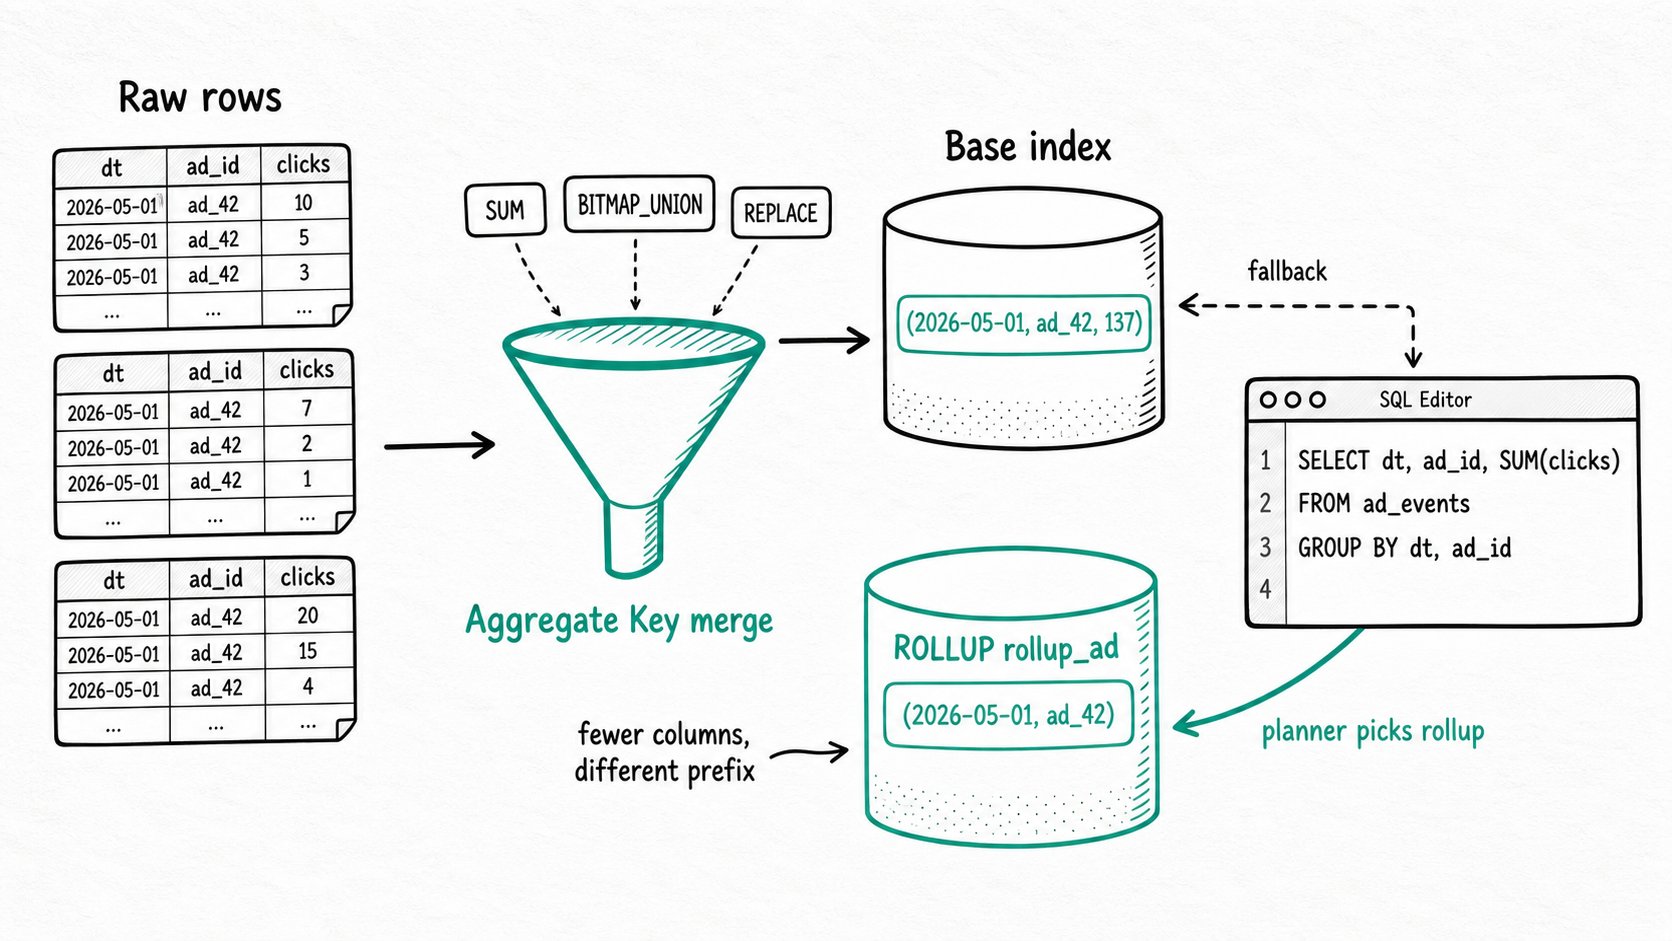
SUM,MAX,REPLACE,BITMAP_UNION같은 컬럼별 함수를 사용해 데이터 적재 시 키가 같은 행을 병합합니다.ROLLUP은 컬럼 수를 줄이거나 정렬 순서를 바꾼 두 번째 구체화된 인덱스로, 기본 테이블만으로 효율적으로 처리하기 어려운 쿼리에서 플래너가 자동으로 선택합니다. 쿼리는 요청마다 원시 행을 그룹화하는 대신 미리 계산된 수치를 읽습니다.
Apache Doris에서 사전 집계와 롤업을 사용하는 이유는 무엇인가요?
Apache Doris의 사전 집계와 롤업은 반복되는 GROUP BY 작업을 쿼리 시점에서 데이터 적재 시점으로 옮깁니다. 덕분에 대시보드는 새로 고칠 때마다 원시 팩트 테이블을 다시 스캔하는 대신 미리 계산된 합계를 읽습니다. 일반적인 팩트 테이블은 컬럼이 많고 데이터 단위가 세밀합니다. 이벤트별 광고 클릭, 요청별 API 로그, 초 단위 장치 측정값 등이 그 예입니다. 반면 같은 대시보드에서 요구하는 것은 일별 합계, top-N 사용자, 월간 고유 시청자 수입니다. 사전 집계가 없으면 모든 쿼리가 수백만 개의 행을 다시 스캔하고 어제 실행했던 것과 동일한 GROUP BY를 반복합니다.
- 반복 작업. 대시보드를 새로 고칠 때마다 같은 원시 데이터에 대해 동일한 집계를 반복합니다.
- 넓은 스캔 범위. 집계 단위가 큰 쿼리는 값 컬럼이 두 개만 필요해도 기본 테이블의 모든 값 컬럼을 읽습니다.
- 비용이 큰 카디널리티 계산. 십억 개 행이 있는 테이블에서
COUNT(DISTINCT user_id)를 실행하는 것은 쿼리라기보다 대규모 작업에 가깝습니다.
사전 집계는 처리 비용을 쿼리 시점에서 데이터 적재 시점으로 옮깁니다. ROLLUP은 기본 테이블만으로 처리하기에 적합하지 않은 쿼리를 위해 두 번째 사전 계산 뷰를 추가합니다. 여러 테이블에 걸친 재작성이나 파티션 매핑을 활용한 재작성이 필요하다면 증분 구체화된 뷰를 사용하세요.
Apache Doris의 사전 집계와 롤업이란 무엇인가요?
Apache Doris의 사전 집계는 컬럼별 집계 함수를 사용해 키가 같은 행을 병합하는 Aggregate Key 테이블 모델이며, 롤업은 플래너가 자동으로 선택하는 해당 테이블의 추가 구체화된 인덱스입니다. Aggregate Key 모델은 테이블 유형 중 하나입니다. 어떤 컬럼을 키로 사용할지 선언하고 각 값 컬럼에 집계 함수를 지정합니다. 그러면 Apache Doris는 데이터 적재 시점과 compaction 과정에서 키가 같은 행을 병합하므로, 병합 규칙이 정의된 중복 행은 테이블에 저장되지 않습니다.
ROLLUP은 동일한 기본 테이블에 생성하는 두 번째 구체화된 인덱스입니다. 일부 컬럼만 포함하며, 정렬 순서는 다를 수 있지만 컬럼별 함수는 동일하게 적용됩니다. 쿼리 플래너는 들어오는 쿼리에 대해 사용 가능한 모든 인덱스를 평가하고 가장 적합한 인덱스에서 데이터를 읽습니다.
주요 용어
- Aggregate Key 모델: 값 컬럼에 선언된 집계 함수를 사용해 키 값이 동일한 행을 병합하는 테이블 모델입니다.
- 집계 함수:
SUM,MIN,MAX,REPLACE,REPLACE_IF_NOT_NULL,HLL_UNION,BITMAP_UNION,QUANTILE_UNION. 이 함수들은ROLLUP의 값 컬럼에도 사용할 수 있습니다. - 기본 인덱스:
CREATE TABLE정의에 대응하는 디스크상의 데이터 배치입니다. 항상 존재합니다. - 롤업 인덱스: 플래너가 기본 인덱스 대신 읽을 수 있는 추가 구체화된 데이터 배치입니다.
- 동기 구체화된 뷰:
CREATE MATERIALIZED VIEW구문은ALTER TABLE ADD ROLLUP을 대체합니다. 내부 동작 방식은 같지만 더 다양한 표현식을 지원하므로 신규 설계에 권장됩니다.
Apache Doris의 사전 집계와 롤업은 어떻게 동작하나요?
Apache Doris의 사전 집계는 다섯 단계로 동작합니다. DDL에서 집계 규칙을 선언하고, 데이터 적재 및 compaction 과정에서 행을 병합하고, 특정 쿼리 형태에 맞는 롤업을 추가하고, 쿼리마다 가장 적합한 인덱스를 선택하며, 새 코드에서는 동기 구체화된 뷰를 우선 사용합니다.
- 집계 규칙을 정의합니다.
CREATE TABLE의AGGREGATE KEY(...)절에서 키 컬럼을 지정합니다. 나머지 모든 컬럼에는clicks BIGINT SUM,last_seen DATETIME REPLACE,unique_users BITMAP BITMAP_UNION과 같이 함수를 지정합니다. Apache Doris는 이 함수들을 사용해 키가 같은 두 행을 병합합니다. - 데이터 적재 시 병합합니다. 데이터가 들어오면 Backend 노드는 키가 같은 기존 행과 새로 들어온 행을 병합한 뒤 새로운 불변 rowset을 기록합니다. 이후 백그라운드 compaction이 동일한 규칙으로 이 rowset들을 병합합니다. 쿼리에는 원시 입력이 아니라 병합된 결과가 표시됩니다.
- 특정 쿼리 패턴에 맞는 롤업을 추가합니다.
ALTER TABLE ad_events ADD ROLLUP rollup_ad (dt, ad_id, clicks, cost)는(dt, ad_id)로 정렬된 두 번째 구체화된 인덱스를 생성합니다. Apache Doris는 비동기 스키마 변경으로 이 인덱스를 재구축한 뒤, 이후 데이터 적재마다 기본 테이블 쓰기와 동일한 트랜잭션 안에서 동기화를 유지합니다. - 쿼리마다 인덱스를 선택합니다. Nereids 옵티마이저는 쿼리의 조건식과 그룹화 키를 기준으로 모든 인덱스를 평가합니다. 조건식에 사용되는 컬럼이 앞부분에 있고 스캔할 컬럼 수가 적은 인덱스를 선호합니다. 선택된 인덱스는
EXPLAIN과 BE 프로파일에 표시됩니다. - 새 코드에서는 동기 MV를 사용합니다.
CREATE MATERIALIZED VIEW는ADD ROLLUP의 모든 기능에 더해bitmap_union(to_bitmap(user_id))같은 표현식도 지원합니다. Apache Doris 소스 코드의 주석에도 명확히 적혀 있습니다. "향후 기능 측면에서 구체화된 뷰는 롤업의 모든 기능을 포괄합니다." 기존 롤업도 계속 동작합니다.
빠른 시작
CREATE TABLE ad_events (
  dt DATE,
  ad_id INT,
  user_id BIGINT,
  clicks BIGINT SUM,
  cost DECIMAL(10,2) SUM
)
AGGREGATE KEY(dt, ad_id, user_id)
DISTRIBUTED BY HASH(ad_id) BUCKETS 4;

ALTER TABLE ad_events ADD ROLLUP rollup_ad (dt, ad_id, clicks, cost);

SELECT dt, ad_id, SUM(clicks) FROM ad_events
WHERE dt = '2026-05-01' GROUP BY dt, ad_id;
예상 결과
EXPLAIN ... shows OlapScanNode: rollupName=rollup_ad
PREAGGREGATION: ON
이 롤업은 user_id를 제외하므로 플래너는 (dt, ad_id)만으로 그룹화하는 모든 집계 쿼리에 이 롤업을 선택합니다. 동일한 (dt, ad_id, user_id)를 두 번 삽입하면 clicks와 cost가 합산된 행 하나가 생성되며, 롤업에는 (dt, ad_id)별로 행 하나가 남습니다.
Apache Doris의 사전 집계와 롤업은 언제 사용해야 하나요?
Apache Doris의 사전 집계는 집계 패턴이 일정하고 데이터가 주로 추가되는 팩트 테이블, BITMAP_UNION과 HLL_UNION을 이용한 고유값 개수 및 분위수 롤업, 동일한 GROUP BY를 하루에 수천 번 실행하는 대시보드에 적합합니다. 원시 데이터의 개별 행 조회, 여러 테이블의 조인, 기본 키를 기준으로 개별 행을 빈번하게 업데이트하는 용도에는 적합하지 않습니다.
적합한 경우
- 데이터가 주로 추가되며, 일정한 소수의 차원을 기준으로 집계하는 팩트 테이블.
- 고유값 개수와 분위수.
BITMAP_UNION과HLL_UNION을 사용하면 일별 또는 파티션별로 미리 계산된 스케치를 밀리초 단위로 병합할 수 있습니다. - 이벤트별 데이터를 기반으로 작성하며 동일한
GROUP BY를 하루에 수천 번 실행하는 Top-N 또는 "시간별" 보고서.
적합하지 않은 경우
- 원시 데이터의 개별 행 조회도 필요한 테이블. Aggregate Key는 이미 원시 행을 병합한 상태입니다. 대신 Duplicate Key 모델을 사용하고, 사전 집계된 뷰도 필요하다면 비동기 구체화된 뷰를 함께 사용하세요.
- 여러 테이블의 조인.
ROLLUP과 동기 MV는 모두 단일 테이블만 지원합니다. 여러 테이블에 걸친 재작성이나 파티션별 갱신이 필요하다면 비동기 구체화된 뷰를 사용하세요. - 기본 키를 기준으로 한 빈번한 개별 행 업데이트. merge-on-write를 사용하는 Unique Key 모델을 사용하세요.
ALTER TABLE ADD ROLLUP을 사용하려는 신규 설계. 대신CREATE MATERIALIZED VIEW를 사용하세요. 문법은 다르지만 런타임을 공유하며, 새로운 기능은 MV 방식에 추가됩니다.
더 읽어보기
- 데이터 모델: Aggregate Key가 세 가지 테이블 모델 중 하나인 이유와 Duplicate Key 및 Unique Key가 적합한 용도를 설명합니다.
- 집계 모델: 데이터 배치, 병합 규칙, 튜닝
- 동기 구체화된 뷰:
ADD ROLLUP을 대체하는 최신 방식 - 비동기 구체화된 뷰: 여러 테이블의 사전 집계와 갱신 모드
ALTER TABLE ROLLUP구문 참조