Query Cache
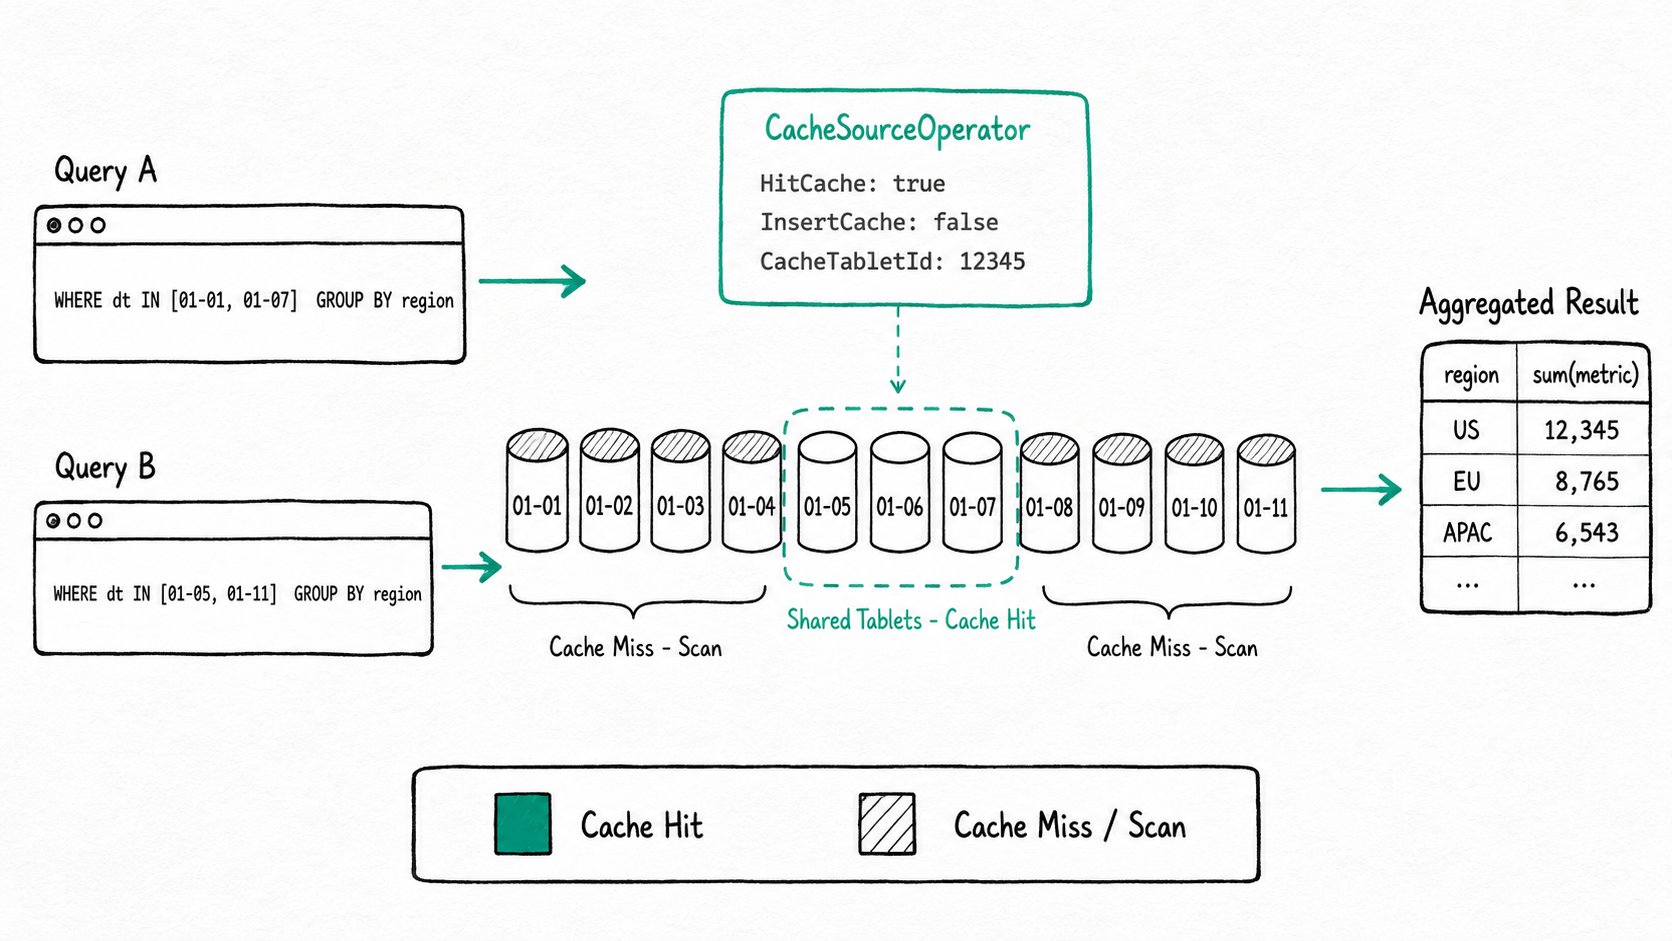
핵심 요약 Apache Doris Query Cache는 내부 OLAP 테이블의 집계 쿼리를 위한 파이프라인 엔진 캐시입니다. Query Cache는 계획의 다이제스트와 태블릿 ID 및 버전을 키로 사용하여 부분 집계 결과를 태블릿 단위로 저장합니다. 동일한 태블릿을 사용하는 두 쿼리는 날짜 범위가 일부만 겹치더라도 해당 태블릿의 캐시를 공유합니다. 따라서 같은
GROUP BY를 15초마다 실행하는 대시보드는 새로 고칠 때마다 같은 태블릿을 다시 스캔할 필요가 없어집니다.
Apache Doris Query Cache를 사용하는 이유는 무엇인가요?
Apache Doris Query Cache는 BI 대시보드가 몇 초마다 겹치는 파티션을 대상으로 같은 집계를 실행할 때 발생하는 중복 태블릿 작업을 없애 줍니다. 대부분의 BI 트래픽은 반복적인 집계입니다. 대시보드 타일은 새로 고칠 때마다 같은 SUM/COUNT/AVG를 다시 실행합니다. T+1 보고서는 지난밤의 파티션을 한 번 집계한 뒤, 오늘 누군가 페이지를 열 때마다 다시 집계합니다. 트레이더의 패널은 분당 몇 개의 태블릿만 변경되는 주문장을 대상으로 같은 GROUP BY symbol을 오 초마다 실행합니다.
동일한 태블릿이 같은 부분 집계 결과를 반복해서 제공하며, 클러스터는 매번 스캔과 집계 비용을 전부 부담합니다.
SQL Cache는 SQL 텍스트가 바이트 단위까지 같을 때 도움이 되지만, 필터 하나만 바뀌거나 태블릿 하나에 새 버전이 생겨도 더 이상 사용할 수 없습니다. 구체화된 뷰는 쿼리 형태를 고정하지만, 뷰와 새로 고침 일정을 계속 관리해야 합니다.
Query Cache는 이 두 방식보다 더 작은 단위, 즉 하나의 집계에 대한 태블릿 하나의 기여분을 캐시합니다. 필터 범위가 하루씩 앞으로 이동하고 새로 고칠 때마다 한두 개의 파티션만 새로 추가되는 대시보드에서는 바로 이 단위로 작업이 겹칩니다.
Apache Doris Query Cache란 무엇인가요?
Apache Doris Query Cache는 프래그먼트가 AggregationNode -> OlapScanNode 형태이거나, 두 단계 집계의 경우 AggregationNode -> AggregationNode -> OlapScanNode 형태일 때 활성화되는 파이프라인 엔진 최적화 기능입니다. 그 사이에 필터 노드와 프로젝션 노드가 있어도 됩니다. 조인, 정렬, 합집합, 윈도 함수, 익스체인지 노드는 허용되지 않습니다. 프래그먼트가 조건을 충족하면 BE는 스캔 전에 캐시를 확인합니다. 캐시가 적중하면 스캔 범위를 건너뛰고 캐시된 블록을 직접 출력합니다. 캐시가 적중하지 않으면 평소처럼 결과를 계산한 뒤 태블릿당 하나의 항목으로 캐시에 기록합니다.
주요 용어
enable_query_cache: 세션 변수입니다. 기본적으로 꺼져 있으며, 세션별로 켜거나 대시보드 계정에 대해 전역으로 설정할 수 있습니다.CacheSourceOperator: 집계와 스캔 사이에 삽입되는 파이프라인 연산자입니다. 프로파일의 해당 섹션에는 태블릿별HitCache,InsertCache,CacheTabletId가 표시됩니다.SQL digest: 정규화된 집계 계획(함수, 그룹 키, 파티션과 관련 없는 조건절, 프로젝션 열, 결과에 영향을 미치는 세션 변수)에 대한 SHA-256 해시입니다. 의미가 같은 SQL은 같은 다이제스트를 생성합니다.Tablet range: 파티션 조건절에서 도출됩니다. 캐시 키에 포함되므로 두 쿼리가 공통으로 접근하는 파티션의 캐시를 재사용할 수 있습니다.LRU-K (K=2): 캐시 수용 정책입니다. 새 항목은 최소 두 번 접근해야 캐시에 자리를 얻으므로, 일회성 임시 쿼리가 대시보드에 필요한 항목을 밀어낼 수 없습니다.
Apache Doris Query Cache는 어떻게 작동하나요?
Apache Doris Query Cache는 FE에서 agg-over-scan 패턴을 감지하고, 계획 다이제스트와 태블릿 ID 및 버전으로 태블릿별 캐시 키를 구성한 뒤, 각 BE가 스캔하기 전에 캐시를 조회하는 방식으로 작동합니다. 아래 다섯 단계는 계획 확인, 키 구성, 조회, 적중, 미적중 처리를 설명합니다.
- 계획 확인(FE). Nereids는 각 프래그먼트를 순회하며 agg-over-scan 패턴을 찾습니다. 조인, 정렬, 런타임 필터 대상, 외부 테이블 스캔, 비결정적 표현식이 있으면 해당 프래그먼트는 대상에서 제외됩니다.
- 캐시 키 구성(FE). 단일 열 RANGE 파티션 테이블의 경우, 플래너는 파티션 조건절을 추출하고 조건절 범위와 스캔할 각 파티션의 교집합을 계산합니다. 계획 다이제스트에는 쿼리의 나머지 부분이 포함됩니다. 태블릿별 키는
(digest, tablet_id, tablet_range)입니다. - 태블릿별 조회(BE). 할당된 각 태블릿에 대해
QueryCache::lookup(key, version)이 캐시 키와 태블릿 버전을 모두 확인합니다. 항목이 기록된 이후INSERT,DELETE,UPDATE또는 컴팩션이 발생했다면 캐시 미적중으로 처리합니다. - 적중 시. 스캔 연산자는 해당 범위를 건너뛰고, 집계 연산자는 아무것도 생성하지 않으며,
CacheSourceOperator가 캐시된 블록을 출력합니다. 프로젝션 순서가 캐시된 항목과 다르면(같은 다이제스트를 갖는SELECT a, b와SELECT b, a의 경우), 열 순서가 자동으로 조정됩니다. - 미적중 시. 프래그먼트는 부분 집계 결과를 계산하고, 평소처럼 행을 다음 연산자로 전달하면서 사본을 버퍼에 저장합니다. 프래그먼트가 완료되면
query_cache_entry_max_bytes(5 MB)와query_cache_entry_max_rows(500,000) 제한 이내의 결과를 캐시에 기록합니다.
빠른 시작
SET enable_query_cache = true;

-- Run 1: warms the cache for partitions 2024-01-01 .. 2024-01-07
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt >= '2024-01-01' AND dt < '2024-01-08'
GROUP BY region;

-- Run 2: overlapping window, three shared days
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt >= '2024-01-05' AND dt < '2024-01-12'
GROUP BY region;
예상 결과(EXPLAIN PROFILE에서 발췌)
CacheSourceOperator
  HitCache:      true
  InsertCache:   false
  CacheTabletId: 12345
첫 번째 실행에서는 모든 태블릿에서 캐시가 적중하지 않으며, 태블릿별 부분 집계 결과를 기록합니다. 두 번째 실행에서는 겹치는 사흘(2024-01-05부터 2024-01-07까지)에 대해 캐시가 적중하고, 새로 추가된 날짜(2024-01-08부터 2024-01-11까지)만 스캔합니다. 캐시 적중 여부를 확인하려면 프로파일에서 CacheSourceOperator를 살펴보세요. 태블릿별 HitCache: true는 해당 태블릿의 결과가 메모리에서 제공되었음을 뜻합니다.
Apache Doris Query Cache는 언제 사용해야 하나요?
내부 단일 열 RANGE 파티션 테이블을 대상으로 하는 BI 대시보드, T+1 보고서, 이동 시간 범위 집계에 Apache Doris Query Cache를 사용하세요. JOIN/ORDER/UNION/윈도 함수 쿼리, 외부 레이크하우스 테이블(SQL Cache 사용), 쓰기가 빈번한 핫 테이블, 기본 키 조회에는 사용하지 않는 것이 좋습니다.
적합한 경우
- 분당 여러 번 같은 집계를 반복하는 BI 대시보드와 타일 위젯.
- T+1 보고서. 하루의 데이터 적재가 끝나면 다음 날의 데이터 적재로 새 파티션의 캐시가 무효화될 때까지 반복 읽기 요청을 캐시에서 처리합니다.
- 날짜 범위가 이동하며, 새로 고침 사이에 가장 최근 파티션만 변경되는 집계 쿼리.
- 단일 열
RANGE파티션 테이블. 서로 다른 필터 범위에서도 태블릿 수준 재사용이 가능한 구조입니다.
적합하지 않은 경우
- 캐시 대상 하위 트리에
JOIN,ORDER BY,UNION또는 윈도 함수가 있는 쿼리. 먼저 집계한 뒤 조인하거나, 조인 형태에 맞는 비동기 구체화된 뷰를 만드세요. - 외부 테이블(Hive, Iceberg, Hudi, Paimon, JDBC). 캐시는 태블릿 ID와 버전을 키로 사용하는데, 외부 테이블에는 이 정보가 없습니다. 대신 SQL Cache를 사용하세요.
- 몇 초마다 쓰기가 발생하는 핫 테이블. 버전이 바뀔 때마다 해당 태블릿 항목이 무효화되므로 적중률이 낮게 유지됩니다. 필터 결과의 재사용이 필요하다면 Condition Cache를 살펴보세요.
now(),rand(),uuid()또는 비결정적 UDF가 포함된 쿼리. 계획이 비결정적인 것으로 처리되어 캐시가 비활성화됩니다.WHERE dt = date(now())처럼 날짜 단위로 묶는 표현식으로 대체하세요.- 필터 범위가 바뀌는 다중 열
RANGE또는LIST파티션 테이블. 파티션 조건절이 다이제스트에 그대로 포함되므로 범위가 다르면 키도 달라집니다. 태블릿 수준 재사용은 단일 열RANGE에서만 가능합니다. - 기본 키를 이용한 조회. Query Cache는 집계용입니다.
WHERE pk = ?패턴에는 대신 고동시성 포인트 쿼리를 사용하세요.
설정 항목
| 설정 항목 | 설정 위치 | 기본값 | 변경 시점 |
|---|---|---|---|
enable_query_cache | 세션 | false | 항상 설정합니다. 세션별로 설정하거나 대시보드 계정에 대해 전역으로 설정합니다. |
query_cache_entry_max_bytes | 세션 | 5 MB | 그룹별 집계 결과의 행 크기가 매우 클 때 늘립니다. 이 값을 초과하는 결과는 별도 알림 없이 캐시되지 않습니다. |
query_cache_entry_max_rows | 세션 | 500,000 | 카디널리티가 높은 GROUP BY에 대해 늘립니다. |
query_cache_size | be.conf | 512 MB | BE별 메모리 상한입니다. 캐시 용량에 제약을 받는 대시보드가 있으면 늘립니다. |
query_cache_force_refresh | 세션 | false | 캐시된 결과가 오래되었다고 의심되면 쿼리 한 번에 대해 true로 설정한 뒤 원래 값으로 되돌립니다. |
추가 자료
- Query Cache 사용자 가이드
- SQL Cache: 모든 쿼리를 위한 결과 수준 캐싱
- Condition Cache: 세그먼트의 필터 결과 캐싱
- 비동기 구체화된 뷰: 복잡한 파이프라인의 사전 집계
- Doris의 캐싱: 적절한 전략 선택
- Data Cache 및 Page Cache: 반복 스캔을 위해 Query Cache 아래에 위치하는 스토리지 계층 캐시입니다.
- Metadata Cache: 연합 레이크하우스 쿼리를 위한 외부 Catalog 메타데이터 캐시입니다.
- MPP 아키텍처: 결과를 재사용할 수 있을 때 Query Cache가 프래그먼트 DAG의 실행을 단축하는 실행 모델입니다.