Resource Group
요약 Apache Doris Resource Group은 BE 노드에 태그를 지정해 이름이 있는 풀로 묶고, 테이블 복제본을 여러 풀에 배치하며, 각 사용자를 하나 이상의 풀에 연결합니다. 쿼리는 사용자에게 연결된 풀의 BE에서만 실행되며, 해당 풀에 배치된 복제본만 읽습니다. 풀마다 BE 프로세스가 서로 다르므로 한 그룹에서 충돌이나 OOM이 발생해도 다른 그룹은 중단되지 않습니다. 그만큼 스토리지 비용이 듭니다. 테이블을 읽어야 하는 모든 풀에는 자체 복제본이 필요합니다.
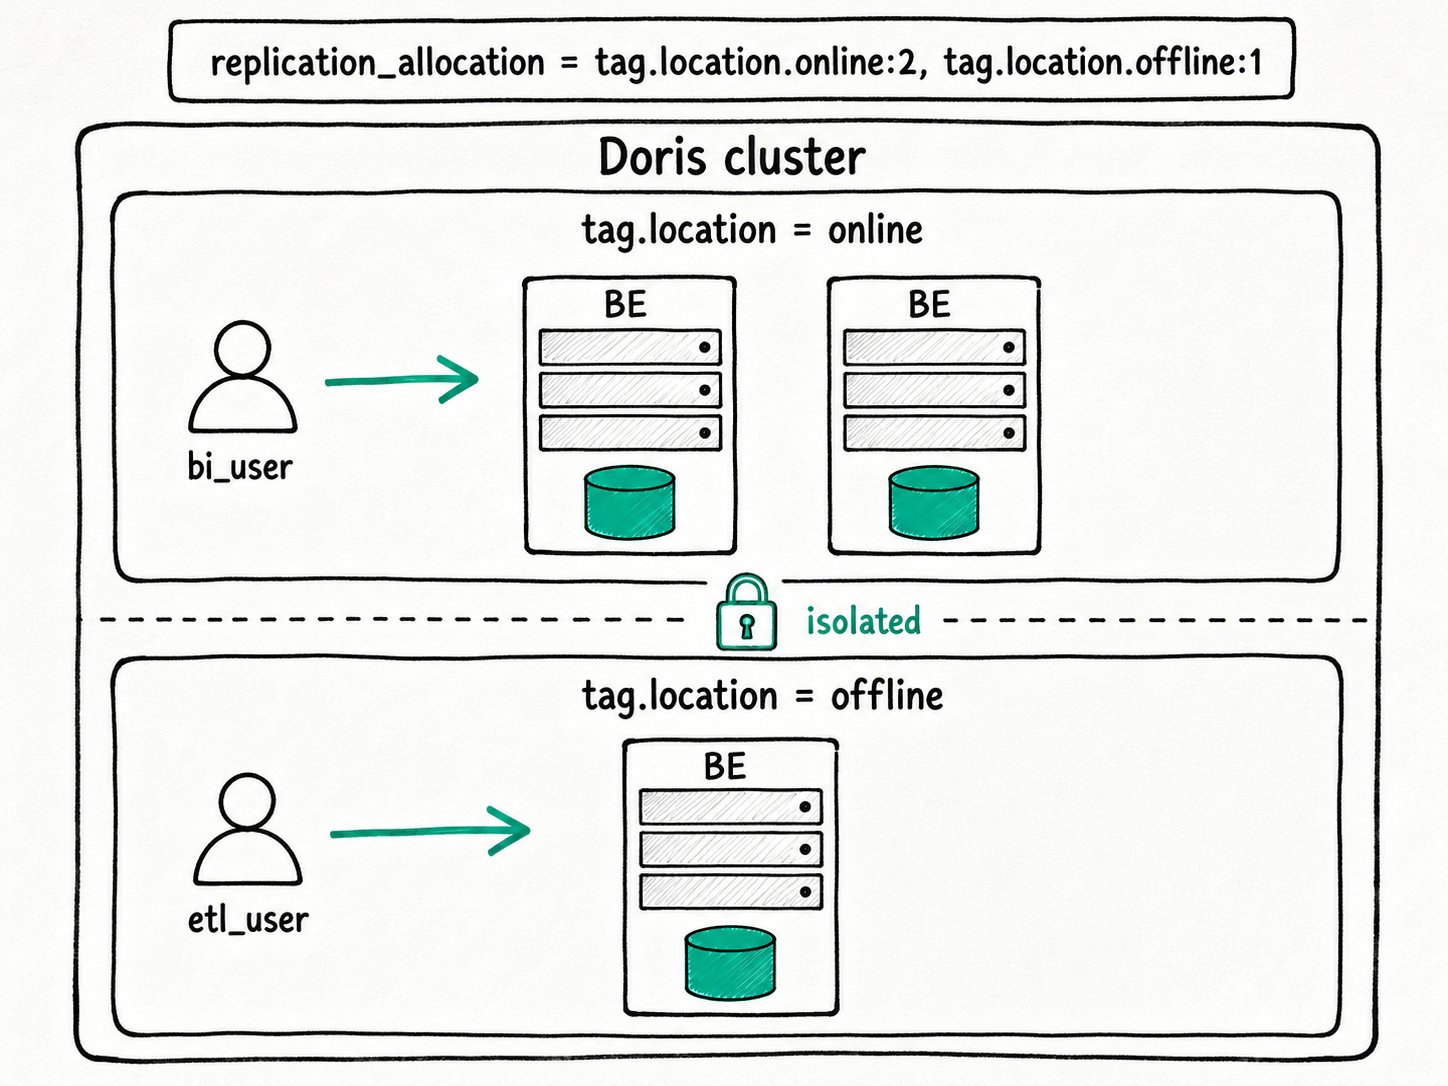
Apache Doris에서 Resource Group을 사용하는 이유는 무엇인가요?
Apache Doris Resource Group은 일반적으로 단일 클러스터가 여러 워크로드를 처리하고, 이 워크로드들이 서로를 신뢰할 수 없기 때문에 필요합니다. 새벽 2시의 ETL 작업은 낮 동안 경영진 대시보드가 십오 초마다 조회하는 바로 그 BE에서 어제의 파티션을 다시 씁니다. 오전 9시에 재무 배치 작업이 무거운 보고서를 다시 실행하는 동안, 분석가는 범위 제한 없는 SELECT * 쿼리를 시작합니다.
Workload Group은 CPU를 제어하는 cgroups, 그룹별 메모리 트래커, 그룹별 큐를 통해 이러한 문제의 상당 부분을 프로세스 내부에서 처리합니다. 비용이 적게 들고 유연합니다. 하지만 BE 충돌의 영향까지 막을 수는 없습니다. 커널이 OOM으로 BE를 강제 종료하면 해당 BE의 모든 그룹도 함께 종료됩니다. 쿼리 실행 중 BE에서 segfault가 발생하면 대시보드와 ETL 작업 모두 다시 연결해야 합니다. 프로세스 계층에서 서로 격리되어야 하는 워크로드에는 프로세스 내부 도구만으로는 충분하지 않습니다.
Apache Doris Resource Group은 별도의 클러스터를 추가로 구축하지 않고도 이 문제를 해결합니다. 각 BE에 레이블을 지정하고, 각 테이블은 태그별로 복제본을 몇 개 배치할지 선언하며, 각 사용자는 사용이 허용된 태그에 연결됩니다. 클러스터는 FE 쿼럼 하나, 스키마 Catalog 하나, 인증 정보 세트 하나를 유지하면서, BE를 실행 중에 자원을 공유하지 않는 풀로 나눕니다.
Apache Doris Resource Group이란 무엇인가요?
Apache Doris Resource Group은 리소스 태그를 기반으로 하는 배치 및 라우팅 기능입니다. 모든 BE는 정확히 하나의 location 태그에 속합니다. 모든 테이블의 각 복제본도 정확히 하나의 태그에 속하며, 이 태그는 생성 시 replication_allocation으로 결정됩니다. 각 사용자에게는 사용이 허용된 태그 집합이 있으며, 이는 resource_tags.location 속성으로 결정됩니다. 쿼리 플래너는 이 조건들의 교집합을 구합니다. 사용자의 태그 집합에 속한 BE를 선택하고, 해당 BE에 배치된 복제본만 읽습니다.
주요 용어
tag.location: BE 측 레이블입니다.ALTER SYSTEM MODIFY BACKEND ... SET ("tag.location" = "<name>")으로 설정합니다. BE에는 location 태그를 하나만 지정할 수 있으며, 기본값은default입니다.replication_allocation: 태그를 복제본 수에 매핑하는 테이블 또는 데이터베이스 속성으로,tag.location.<name>:<n>형식으로 작성합니다. 항목을 쉼표로 구분하면 여러 풀에 복제본을 분산할 수 있습니다(예:tag.location.online:2, tag.location.offline:1).resource_tags.location: 사용자가 접근할 수 있는 태그를 나열하는 사용자 속성입니다. 여러 태그를 허용하려면 쉼표로 구분합니다. 값을 비워 두면 아래에 설명된 기본 동작을 따릅니다.- 기본 태그: 기본 제공되는
default태그입니다. 모든 BE는 처음에 이 태그에 속하며, 이 태그는 삭제할 수 없습니다. 2.0.3부터는resource_tags.location이 설정되지 않은 일반 사용자는default만 볼 수 있으며,root와admin은 모든 태그를 볼 수 있습니다.
Apache Doris Resource Group은 어떻게 동작하나요?
Apache Doris Resource Group은 BE에 태그 지정, 태그별 복제본 할당, 사용자와 태그 연결, 쿼리 라우팅, 데이터 적재 경로 분리라는 다섯 단계로 동작합니다.
- BE에 태그를 지정합니다.
ALTER SYSTEM MODIFY BACKEND "host:9050" SET ("tag.location" = "online"). FE는 변경 사항을 편집 로그에 기록하므로 재시작 후에도 할당이 유지됩니다.SHOW BACKENDS는Tag열에 태그를 표시합니다. - 태그별로 복제본을 할당합니다.
replication_allocation = "tag.location.online:2, tag.location.offline:1"로 테이블을 생성하면 FE는 각 태그에 충분한 BE가 있는지 확인한 다음, tablet 스케줄러에 슬롯마다 복제본 하나를 배치하도록 요청합니다. 확인에 실패하면 "Failed to find enough host with tag(...)"가 표시되고 DDL이 중단됩니다. 데이터베이스 수준에서 이 속성을 설정하여 새 테이블이 상속하도록 할 수도 있습니다. - 사용자를 태그에 연결합니다.
SET PROPERTY FOR 'bi_user' 'resource_tags.location' = 'online'. 변경 사항은 전역으로 적용되지만, 사용자 세션에 반영되려면 사용자가 다시 연결해야 합니다. - 쿼리를 라우팅합니다. 사용자가 쿼리를 제출하면 FE는 사용이 허용된 태그를 실행 대상 BE 집합으로 변환하고, 해당 BE에 배치된 복제본만 대상으로 쿼리 플랜을 수립합니다. 사용자에게 허용된 태그 중 어느 곳에도 해당 테이블의 복제본이 없으면 "no queryable replicas" 오류로 플랜 수립에 실패합니다.
- 데이터 적재를 두 부분으로 나눕니다. 데이터 적재 작업은 연산 부분(소스 읽기, 변환, 분배)과 쓰기 부분(인코딩, 압축, 저장)으로 구성됩니다. 연산 부분은 사용자의 태그를 따릅니다. 쓰기 부분은 태그와 관계없이 테이블의 복제본을 보유한 BE에서 수행되어야 합니다. 따라서
offline에 연결된 사용자가 Stream Load를 제출하면 연산은 offline BE에서 실행되지만, 쓰기는 여전히 모든 복제본 보유 BE에서 이루어집니다.
빠른 시작
-- Tag two BEs into 'online', one into 'offline'
ALTER SYSTEM MODIFY BACKEND "be1:9050" SET ("tag.location" = "online");
ALTER SYSTEM MODIFY BACKEND "be2:9050" SET ("tag.location" = "online");
ALTER SYSTEM MODIFY BACKEND "be3:9050" SET ("tag.location" = "offline");

-- Place 2 replicas in 'online', 1 in 'offline'
CREATE TABLE orders (id BIGINT, region STRING, amount DECIMAL(18,2))
DISTRIBUTED BY HASH(id) BUCKETS 8
PROPERTIES ("replication_allocation" = "tag.location.online:2, tag.location.offline:1");

-- Bind users to their pools
SET PROPERTY FOR 'bi_user'  'resource_tags.location' = 'online';
SET PROPERTY FOR 'etl_user' 'resource_tags.location' = 'offline';
예상 결과
+----------+-------+---------+
| Host     | Alive | Tag     |
+----------+-------+---------+
| be1:9050 | true  | online  |
| be2:9050 | true  | online  |
| be3:9050 | true  | offline |
+----------+-------+---------+
SHOW BACKENDS로 할당을 확인할 수 있습니다. bi_user가 다시 연결하면 해당 사용자의 쿼리 플랜은 두 online 복제본을 대상으로 수립되며, be3에는 전혀 접근하지 않습니다. etl_user의 쿼리는 be3에서 실행되며 단일 offline 복제본을 읽습니다. be3에서 BE 충돌이 발생해도 bi_user는 영향을 받지 않습니다.
Apache Doris Resource Group은 언제 사용해야 하나요?
Apache Doris Resource Group은 단일 클러스터에서 워크로드 간 BE 프로세스 수준의 격리가 필요하고, 풀마다 복제본 하나씩을 두는 데 따른 추가 스토리지 비용을 감수할 수 있는 모든 배포 환경에 적합합니다.
적합한 경우
- 단일 클러스터에서 읽기와 쓰기를 분리하는 경우: ETL용 오프라인 풀과 대시보드용 온라인 풀을 두고, 풀마다 복제본 하나를 배치하여 단일 데이터 세트를 공유합니다.
- 한 테넌트의 BE 충돌이나 OOM 때문에 다른 테넌트에까지 장애 알림이 가서는 안 되는 멀티 테넌트 클러스터.
- 워크로드 수준의 장애 격리를 유지하면서 여러 물리적 클러스터를 하나로 통합하려는 경우.
- 각 풀 내부에 Workload Group을 함께 사용해 CPU와 메모리를 쿼리별로 세분화해 관리할 수 있습니다. Workload Group을 참조하세요.
적합하지 않은 경우
- CPU와 메모리에 소프트 제한만 필요하고, BE 충돌로 모든 워크로드가 중단되는 것을 허용할 수 있는 경우. Workload Group만 사용하세요. Workload Group은 Resource Group에서 지원하지 않는 그룹 간 쿼리도 지원합니다.
- 스토리지 비용이 가장 큰 제약인 경우. 테이블을 읽는 모든 풀에는 자체 복제본이 필요합니다. 풀이 다섯 개면 공유 테이블마다 복제본이 다섯 개 필요하며, 스토리지 비용은 그룹 수에 비례해 증가합니다.
- 스토리지와 컴퓨팅이 분리된(클라우드) 배포 환경을 사용하는 경우. 이 환경에서는 Compute Group이 같은 역할을 합니다. 스토리지를 공유하므로 복제본 수를 늘리지 않고도 동일한 노드 수준의 격리를 제공합니다.
- 여러 풀에 걸쳐 연산량이 많은 ad-hoc 분석을 수행하는 경우. 플래너는 서로 다른 태그의 BE를 하나의 쿼리에 묶을 수 없습니다. 복제본이 없으면 다른 경로로 대체하는 대신 "no queryable replicas" 오류가 발생합니다.
- 쓰기까지 격리되기를 기대하는 데이터 적재 작업. 쓰기는 항상 복제본을 보유한 BE에서 수행되며, 연산 부분만 태그를 따릅니다.
더 읽어보기
- Resource Group 참조 문서: 전체 SQL 구문, 검증 규칙, 데이터 적재 경로 분리에 대한 자세한 설명.
- 워크로드 관리 개요: Resource Group, Workload Group, Compute Group을 나란히 비교한 문서.
- Workload Group: 일반적으로 Resource Group과 함께 사용하는 프로세스 내부 격리 기능.
- Compute Group: 스토리지와 컴퓨팅이 분리된 환경에서 같은 역할을 하며, 스토리지 사용량을 배로 늘리지 않는 기능.
- Apache Doris의 멀티 테넌트 워크로드 격리: Resource Group이 Workload Group을 보완하는 방식을 포함해, 격리 방식 전반을 다루는 설계 글.