디스크 스필(Spill to Disk)
핵심 요약 Apache Doris Spill to Disk를 사용하면 쿼리가 메모리 한도를 초과하기 직전에 HashJoin, Aggregation, Sort, CTE 연산자가 중간 상태를 로컬 디스크에 기록할 수 있습니다. 쿼리 실행 속도는 느려지지만 OOM으로 실패하지 않고 완료됩니다. 세션별로
set enable_spill = true를 실행하거나 Workload Group 수준에서 활성화하고, BE에 스필 디렉터리를 지정한 다음 쿼리 프로파일에서 스필 카운터를 확인하세요.
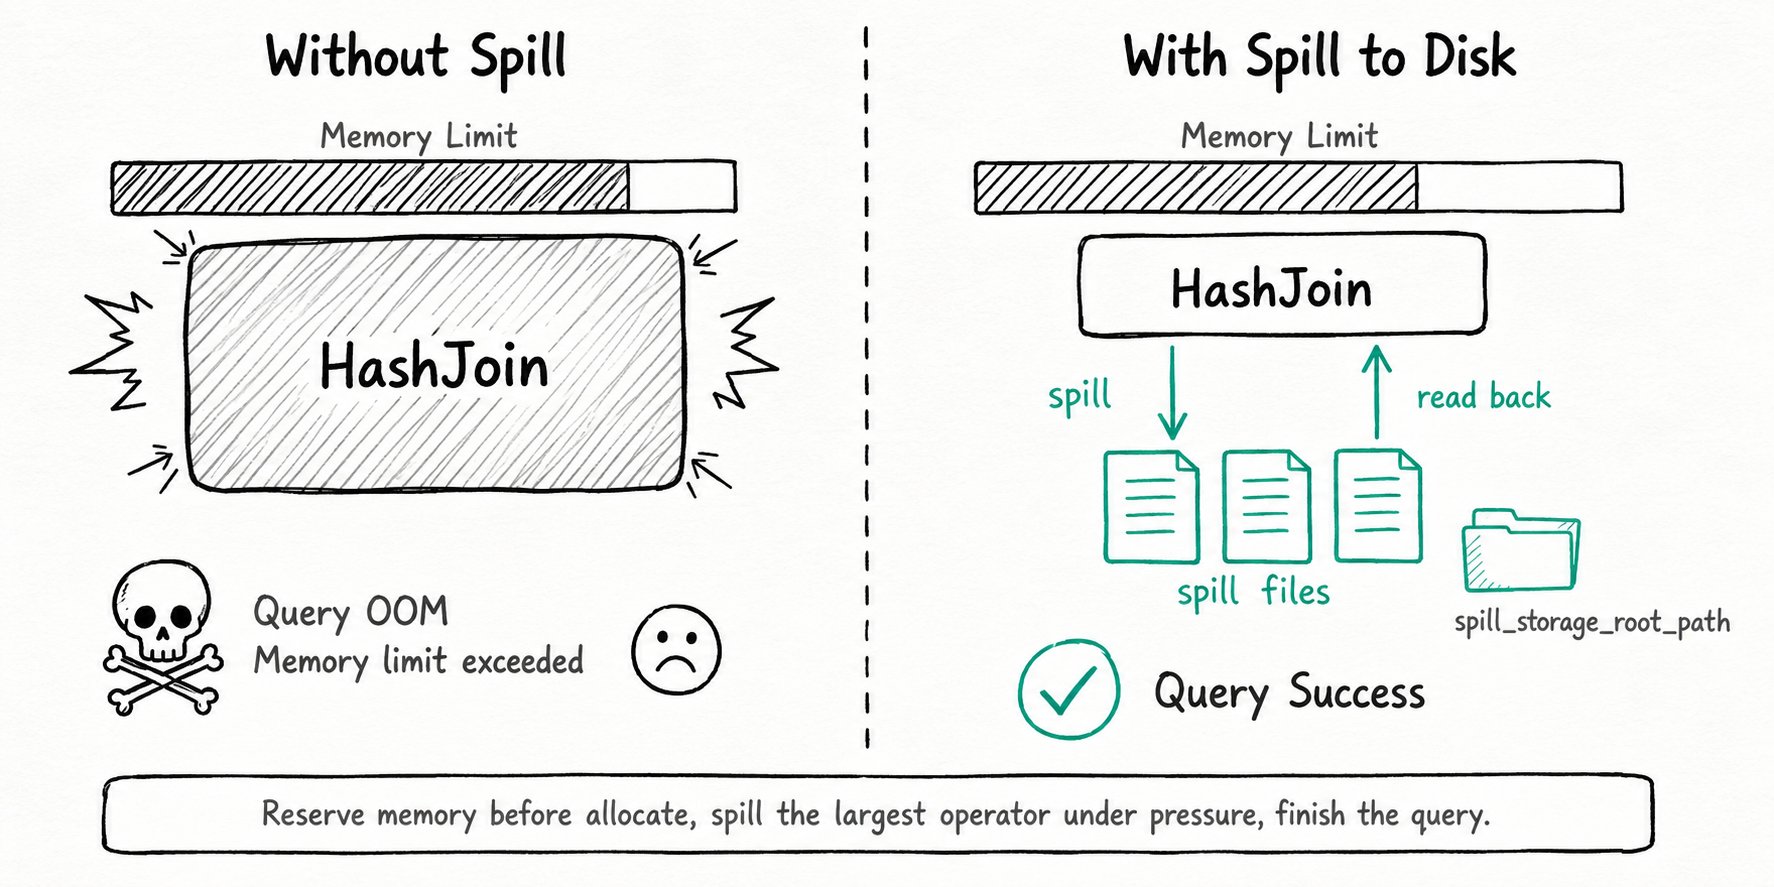
Apache Doris에서 Spill to Disk를 사용하는 이유는 무엇인가요?
Spill to Disk를 사용하면 Apache Doris에서 메모리 부족으로 실패하던 쿼리가 느리더라도 성공적으로 완료됩니다. Apache Doris는 MPP 엔진으로, 기본적으로 조인 해시 테이블, 집계 상태, 정렬 버퍼를 모두 BE 메모리에 유지합니다. 이는 지연 시간 측면에서는 유리하지만, 쿼리가 노드, 쿼리 자체 또는 Workload Group에 허용된 양보다 많은 메모리를 요구하는 순간 문제가 됩니다. 대표적인 실패 사례는 야간 ETL이나 TPC-DS 형태의 임시 쿼리가 열이 많은 팩트 테이블을 읽고, 수 기가바이트 크기의 해시 테이블을 만든 뒤 Memory limit exceeded 오류로 종료되는 경우입니다. 사용자가 재시도해도 같은 한계에 부딪히고, 결국 exec_mem_limit을 높이거나 포기하게 됩니다.
- 지나치게 큰 HashJoin이나 Aggregation 하나가 전체 쿼리를 종료시킵니다.
- RAM보다 훨씬 큰 테이블을 대상으로 하는 ETL은 불안정하거나 아예 불가능합니다.
- 쿼리별로
exec_mem_limit을 높이면 다른 쿼리에 필요한 메모리가 부족해집니다. - 메모리를 많이 사용하는 쿼리가 동시에 실행되면 BE가 전역 메모리 상한에 근접해 긴급 취소가 발생합니다.
Apache Doris Spill to Disk를 사용하면 이처럼 확실히 실패하던 쿼리도 느리더라도 성공적으로 완료됩니다. 이전에는 데이터셋 크기가 10배일 때 OOM이 발생하던 노드도 이제는 50배에서 쿼리를 완료하며, 비정상 종료되는 대신 디스크 IO 비용을 치릅니다.
Apache Doris Spill to Disk란 무엇인가요?
Apache Doris Spill to Disk는 Pipeline Execution Engine의 런타임 메커니즘입니다. 메모리 사용량이 많은 연산자는 메모리가 부족해지면 중간 상태를 로컬 디스크로 내보내고, 나중에 다시 읽어 쿼리를 완료할 수 있습니다. 이 메커니즘은 쿼리 단위가 아닌 연산자 단위로 동작합니다. 실제로 크기가 큰 연산자만 스필되므로, 쿼리는 메모리와 디스크에 저장된 상태를 함께 사용하면서 계속 실행될 수 있습니다.
주요 용어
Spillable operator: 필요할 때 메모리를 반환할 수 있는 연산자입니다. 현재 HashJoin(파티션 해시 조인), Aggregation(파티션 집계), Sort(외부 병합 정렬), CTE가 여기에 해당합니다.Reserve memory: 연산자가 블록을 처리하기 전에 필요한 메모리 양을 추정하고 메모리 트래커를 통해 예약하는 것입니다. 실제 할당이 이루어지기 전에 이 예약이 실패하면 스필이 트리거됩니다.Revocable memory: 연산자가 사용하는 메모리 중 디스크에 기록한 뒤 회수할 수 있는 부분입니다. 스케줄러는 회수 가능한 메모리가 가장 많은 연산자부터 스필합니다.Force spill: 메모리가 충분해도 스필을 수행하는 디버그 모드(enable_force_spill)입니다. 프로덕션에서 사용하기 전에 이 모드로 스필 경로에서도 쿼리 결과가 올바른지 검증하세요.- 스필 저장 경로: BE가 스필 파일을 저장하는 데 사용하는 로컬 디렉터리입니다. 테이블 저장 경로와 별도로 설정합니다.
Apache Doris Spill to Disk는 어떻게 동작하나요?
Apache Doris Spill to Disk는 할당 전에 메모리를 예약하고, 메모리 부족을 감지한 뒤, 회수 가능한 메모리가 가장 많은 연산자를 선택합니다. 그런 다음 연산자의 상태를 파티션으로 나누어 디스크에 기록하고, 메모리가 확보되면 쿼리를 재개합니다. 아래 여섯 단계는 전체 수명 주기를 보여 줍니다.
- 할당 전에 예약합니다. 각 파이프라인 작업은 다음 블록에 필요한 메모리를 추정하고 쿼리별 및 프로세스별 메모리 트래커에 예약을 요청합니다. 적은 비용으로 정확하게 확인하면 나중에 급히 쿼리를 취소하는 상황을 피할 수 있습니다.
- 메모리 부족을 감지합니다. 예약으로 인해 쿼리, Workload Group 또는 BE 프로세스의 한도를 초과하게 되면 예약이 실패합니다. 이때 작업은 취소되지 않고 일시 중지됩니다.
- 스필 대상을 선택합니다. 쿼리 스케줄러는 일시 중지된 쿼리의 연산자를 살펴보고 회수 가능한 메모리가 가장 많은 연산자를 선택합니다. 대개 빌드 측 해시 테이블이나 집계 중인 맵이 선택됩니다.
- 파티션 단위로 스필합니다. Partitioned HashJoin과 Partitioned Aggregation은 해시 함수를 사용해 상태를 N개의 파티션으로 나누고(
spill_hash_join_partition_count,spill_aggregation_partition_count), 스필 IO 스레드 풀을 통해 파티션 전체를 디스크에 기록합니다. Sort는 정렬된 런을 기록한 뒤 나중에 병합합니다. - 재개하고 완료합니다. 메모리가 충분히 확보되면 작업의 일시 중지가 해제됩니다. 프로브 측 행은 동일한 파티션 함수를 통해 전달되므로, 각 파티션은 디스크에 저장된 대응 데이터와 조인하거나 집계합니다. 결과는 올바르게 유지되며, 쿼리에 디스크 IO 시간이 추가될 뿐입니다.
- 사용량을 기록하고 정리합니다. 프로파일은 모든 스필 카운터를 기록합니다. 여기에는 기록한 바이트 수, 파일 수, IO 대기 시간, 파티션 편향이 포함됩니다. 스필 파일은
spill_storage_root_path아래에 저장되며 백그라운드 작업에서 GC 처리됩니다.
빠른 시작
-- Enable spill for this session (or set it on a workload group).
SET enable_spill = true;
-- Spill paths do real disk IO, so give the query a longer budget.
SET query_timeout = 3600;
-- Run a query that would normally OOM.
SELECT l_orderkey, SUM(l_quantity)
FROM lineitem JOIN orders ON l_orderkey = o_orderkey
WHERE o_orderdate >= '1995-01-01'
GROUP BY l_orderkey
ORDER BY 2 DESC LIMIT 100;
-- Check that spill actually happened.
SELECT query_id, spill_write_bytes_to_local_storage
FROM information_schema.backend_active_tasks;
예상 결과
쿼리는 상위 100개 행을 반환합니다. 쿼리 프로파일에서 Spilled: true가 PARTITIONED_HASH_JOIN_SINK_OPERATOR 또는 AGGREGATION_SINK_OPERATOR에 표시되는지 확인하고, SpillWriteBlockBytes, SpillWriteFileBytes, SpillWriteTime도 살펴보세요. 감사 로그에는 같은 쿼리에 대한 SpillWriteBytesToLocalStorage와 SpillReadBytesFromLocalStorage가 추가됩니다. 이 카운터들이 모두 영이면 쿼리가 메모리 안에서 처리되어 스필이 발생하지 않았다는 뜻이며, 이것이 바람직한 결과입니다.
Apache Doris Spill to Disk는 언제 사용해야 하나요?
지연 시간보다 쿼리 완료가 더 중요한 대규모 ETL, 배치 분석, 멀티테넌트 워크로드에 Apache Doris Spill to Disk를 사용하세요. 응답 시간이 일 초 미만이어야 하는 서비스 처리 경로나 과도한 리소스를 사용하는 쿼리에는 사용하지 마세요.
적합한 경우
- 노드별 메모리보다 훨씬 큰 테이블을 대상으로 하는 대규모 ETL: 데이터 편향이 아무리 심해도 밤사이에 완료되어야 하는 집계와 조인입니다.
- TPC-DS, 여러 테이블을 사용하는 구체화된 뷰 새로 고침처럼 하나의 실행 계획에 대규모 해시 조인이 여러 개 포함된 배치 작업입니다.
- 큰 파티션을 처리할 때 간헐적으로 메모리 사용량이 급증하는 쿼리입니다. 지연 시간을 감수하는 대신 메모리 급증에도 쿼리를 계속 실행할 수 있습니다.
- 각 Workload Group의 한도를 엄격하게 제한하는 멀티테넌트 클러스터에서, 한도 초과 시 쿼리를 종료하는 대신 스필하도록 하려는 경우입니다.
적합하지 않은 경우
- 지연 시간에 민감한 서비스 처리 경로입니다. 특정 값을 조회하는 쿼리나 일 초 미만의 응답 시간이 필요한 대시보드가 여기에 해당합니다. 디스크 IO는 SLA 준수를 어렵게 만들며, 애초에 이러한 쿼리는 메모리 한도를 초과해서는 안 됩니다.
exec_mem_limit을 적절하게 설정하고 스필은 비활성화해 두세요. - 메모리를 늘리는 비용이 디스크 IO 비용보다 적은 워크로드입니다. 쿼리가 메모리 한도를 10% 초과한다면
exec_mem_limit또는max_memory_percent를 높이는 편이 스필보다 빠르게 완료됩니다. - 스트리밍 집계입니다. 스트리밍 집계 경로는 설계상 스필을 수행하지 않습니다. 비스트리밍 집계로 전환하거나 메모리 비용을 감수하세요.
- 여유 로컬 디스크 공간과 SSD가 없는 클러스터입니다. 회전식 디스크에서 스필이 많이 발생하면 디스크 IO가 쿼리 시간의 대부분을 차지하고 일반 스캔에 필요한 IO 대역폭까지 부족해집니다.
- 과도한 리소스를 사용하는 쿼리의 우회책으로 사용하는 경우입니다. 스필을 사용하면 100GB 해시 테이블도 처리할 수 있습니다. 그렇다고 십억 개 행에 대한
SELECT *의 비용이 사라지는 것은 아닙니다. Workload Group의 한도 및 대기열과 함께 사용하세요.
더 읽어보기
- Spill to Disk 관리 가이드: 전체 BE 설정, FE 세션 변수, 슬롯 기반 메모리 할당, TPC-DS 10TB 검증 실행을 다룹니다.
- Workload Group: 그룹별 메모리 상한과 상위 워터마크가 쿼리 종료 전에 스필을 트리거하는 방식을 설명합니다.
- Pipeline Execution Engine: 할당 전 메모리 예약과 회수 가능한 메모리의 사용량 추적을 담당하는 런타임을 설명합니다.
- 쿼리 프로파일: 스필 발생 여부를 확인할 수 있는 연산자별
Spill*카운터를 읽는 방법을 설명합니다. backend_active_tasks시스템 테이블: 모니터링과 알림에 사용할 수 있는 쿼리별 실시간 스필 바이트 수를 제공합니다.- MPP 아키텍처: BE별로
exec_mem_limit을 할당하는 분산 실행 계층을 설명합니다. 디스크 스필은 이 메모리 한도를 준수합니다.