Stream Load
요약 Apache Doris Stream Load를 사용하면 클라이언트가
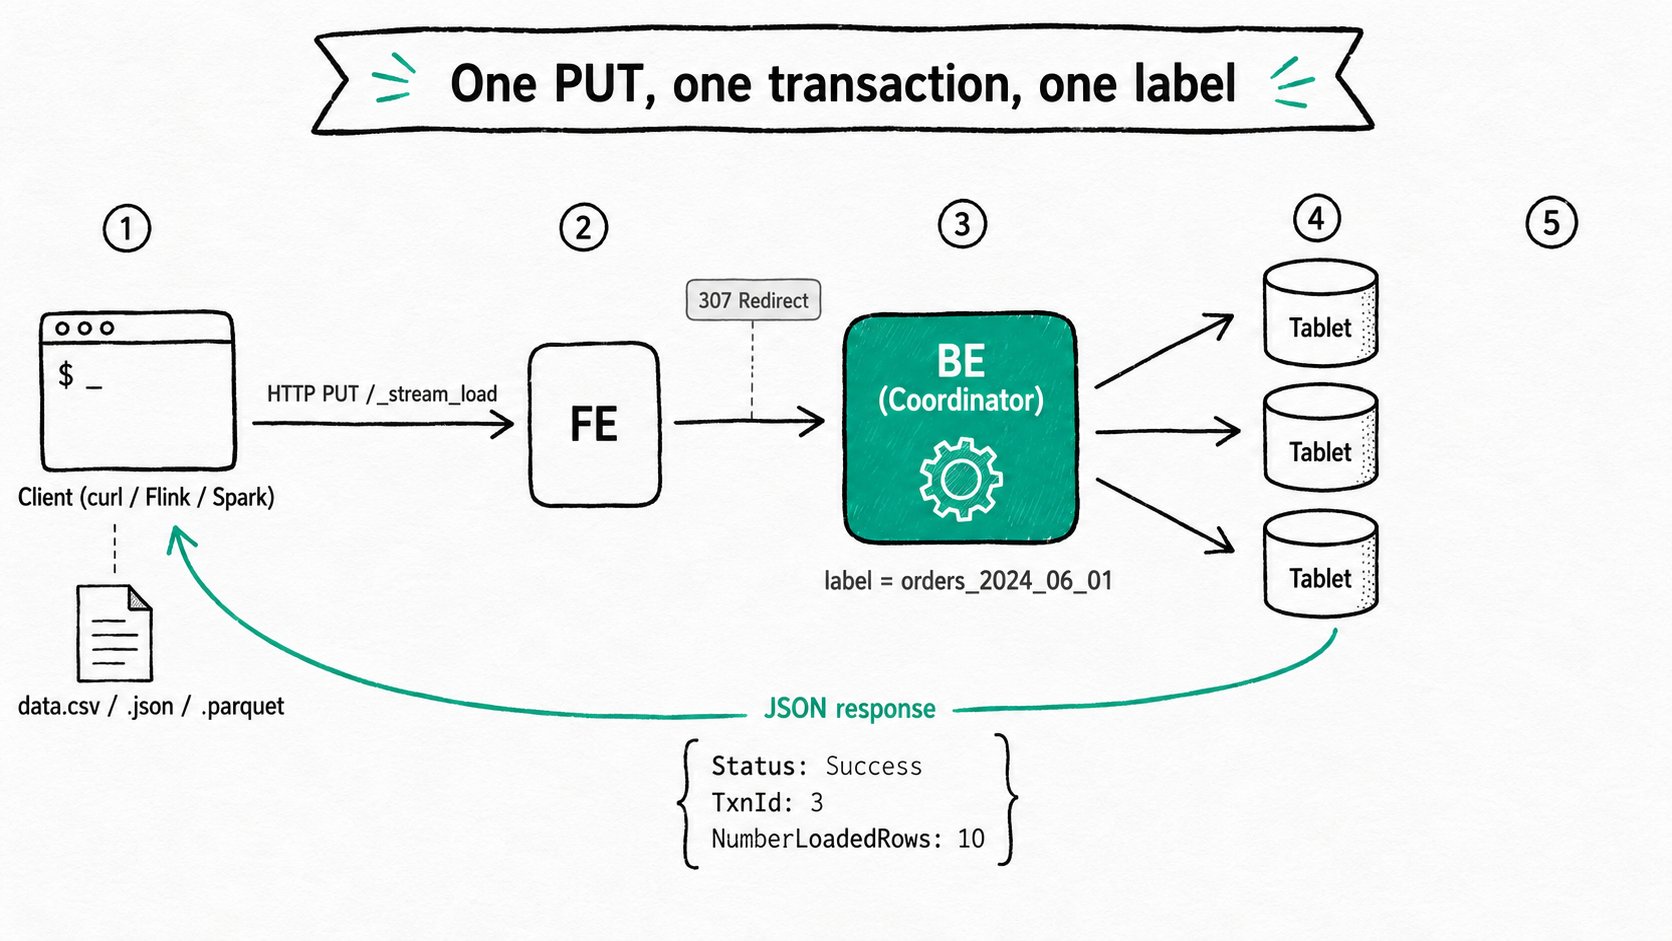
curl(또는 HTTP 라이브러리)을 통해 단일 HTTP PUT 요청으로 파일이나 바이트 스트림을 테이블에 전송할 수 있습니다. FE는 요청을 BE로 리디렉션하고, 선택된 BE는 코디네이터 역할을 맡아 CSV/JSON/Parquet/ORC를 파싱하고 대상 태블릿에 데이터를 기록한 뒤, 전체 배치의 커밋 여부를 알려 주는 JSON 본문을 호출자에게 반환합니다. 하나의 레이블로 재시도에 따른 중복을 제거하고, 하나의 트랜잭션으로 배치의 원자성을 보장하며, JSON 응답으로 행 수와 단계별 소요 시간을 제공합니다.
Apache Doris Stream Load를 사용하는 이유는 무엇인가요?
Apache Doris Stream Load는 이미 HTTP를 사용하는 클라이언트가 별도의 트랜잭션 관리자 없이 레이블 기반 재시도를 보장받으면서 배치마다 동기식 응답을 받고자 할 때 사용하는 데이터 적재 방식입니다. 데이터 웨어하우스로의 실시간 쓰기는 파일을 전송하는 스크립트에서 시작하는 경우가 많습니다. 이 스크립트는 Flink sink, Kafka 컨슈머, rsync cron 작업 또는 수천 개의 이벤트를 방금 생성한 마이크로서비스 안에서 실행됩니다. 스크립트 작성자는 바이트를 전송하고, 같은 연결에서 응답을 받으며, 안전하게 재시도할 수 있기를 원합니다.
- Flink 작업은 오프셋을 진행하기 전에 현재 체크포인트를 Apache Doris에 플러시하고 커밋 성공 여부를 확인해야 합니다.
- ETL 스크립트는 전날 내보낸 200 MB CSV 파일의 행을 아침 보고서가 실행되기 전에 조회할 수 있도록 해야 합니다.
- 보조 서비스는 몇 초마다 JSON 배치를 생성하며, 트랜잭션 관리자를 도입하지 않고 at-most-once 의미 체계를 보장해야 합니다.
Apache Doris Stream Load는 이러한 쓰기 패턴을 직접 지원합니다. 하나의 HTTP PUT, 하나의 레이블, 하나의 트랜잭션으로 처리하고, 같은 소켓에서 하나의 동기식 응답을 반환합니다.
Apache Doris Stream Load란 무엇인가요?
Apache Doris Stream Load는 클러스터의 모든 노드에서 제공하는 동기식 HTTP 데이터 적재 엔드포인트입니다. 클라이언트는 FE 또는 BE에 HTTP PUT을 전송합니다. FE는 라운드 로빈 방식으로 선택한 BE로 요청을 리디렉션하며, 선택된 BE가 해당 데이터 적재의 코디네이터가 됩니다. 코디네이터는 요청 본문을 파싱하고, 각 태블릿을 소유한 BE에 행을 분배하고, FE를 통해 하나의 트랜잭션을 시작합니다. 모든 BE가 확인 응답을 보내면 커밋하고, 같은 소켓에서 JSON 본문을 반환합니다. Apache Doris는 초기부터 CSV를 지원했으며, 현재는 JSON, Parquet, ORC와 헤더가 포함된 CSV 형식도 지원합니다.
주요 용어
- 코디네이터 BE: HTTP 본문을 수신하고 파싱하며 데이터 적재를 조율하는 백엔드입니다. FE의 리디렉션으로 선택되거나 클라이언트가 직접 지정합니다.
label: 요청에서 제공하거나 서버가 생성하는 문자열로, 트랜잭션의 이름을 지정합니다. 성공한 레이블을 재사용하면 중복 요청이 거부되며, 실패한 레이블은 재사용할 수 있습니다./api/{db}/{table}/_stream_load: 표준 엔드포인트입니다. 2PC 방식의 엔드포인트는_stream_load_2pc입니다.Expect: 100-continue: 필수 헤더입니다. 클라이언트는 먼저 헤더를 전송하여 서버가 인증을 확인하고 트랜잭션을 시작하도록 한 다음 본문을 전송합니다.max_filter_ratio: 데이터 적재별로 허용하는 잘못된 행의 비율입니다. 기본값은 0이므로 잘못된 행이 하나만 있어도 배치가 실패합니다.
Apache Doris Stream Load는 어떻게 작동하나요?
Apache Doris Stream Load는 전체 데이터 적재를 하나의 HTTP 요청으로 실행합니다. FE가 요청을 코디네이터 BE로 리디렉션하면, BE는 본문을 파싱하고 트랜잭션을 시작하며 태블릿 소유자에게 행을 분배한 뒤 같은 소켓에서 응답합니다.
- 클라이언트가 FE(또는 BE)에 PUT을 전송합니다. 헤더에는 레이블, 형식, 컬럼 매핑, 필터, 타임아웃이 포함됩니다. 본문은 파일이나 스트림입니다.
Expect: 100-continue를 사용하면 본문이 업로드되기 전에 서버가 요청을 거부할 수 있습니다. - FE가 코디네이터 BE를 선택하고 리디렉션합니다. FE는 라운드 로빈 방식으로 선택한 BE로 리디렉션하는 HTTP 307 응답을 반환합니다. 정상 상태인 BE를 이미 알고 있는 클라이언트는 이 단계를 건너뛰고 BE에 직접 PUT을 전송할 수 있습니다.
- 코디네이터 BE가 트랜잭션을 시작하고 파싱합니다. 제공된 레이블로 트랜잭션을 시작하기 위해 FE를 호출한 뒤, 형식별 리더(CSV, JSON, Parquet, ORC)를 통해 본문을 스트리밍합니다. 파싱이나 스키마 검사에 실패한 행은
max_filter_ratio의 허용 비율을 계산할 때 집계됩니다. - 분배하고, 기록하고, 커밋합니다. 코디네이터는 각 행을 해당 태블릿을 보유한 BE로 라우팅합니다. 이 BE들이 memtable을 세그먼트로 플러시하면 코디네이터가 FE에 커밋을 요청하고, FE는 모든 복제본에
PublishVersion을 전송합니다. - JSON을 반환합니다. 코디네이터는 원래 PUT 요청에 JSON 본문으로 응답합니다. 본문에는
Status,Label,TxnId,NumberLoadedRows,NumberFilteredRows, 품질 검사에 실패한 항목이 있을 때 제공되는ErrorURL, 단계별 소요 시간이 포함됩니다. 이후 연결이 종료됩니다.
클라이언트 관점에서 이 전체 과정은 하나의 HTTP 요청입니다. 커밋에 성공한 뒤 클라이언트가 같은 레이블로 재시도하면 FE는 Label Already Exists를 반환하여 재시도를 거부합니다. 이것이 at-most-once 보장입니다.
빠른 시작
대상 테이블을 생성합니다.
CREATE DATABASE IF NOT EXISTS testdb;
CREATE TABLE testdb.test_streamload (
  user_id BIGINT NOT NULL,
  name    VARCHAR(20),
  age     INT
) DUPLICATE KEY(user_id) DISTRIBUTED BY HASH(user_id) BUCKETS 1;
그런 다음 10행의 CSV 파일을 작성하고 HTTP PUT으로 Doris에 전송합니다. Doris가 다른 곳에서 실행 중이라면 127.0.0.1을 FE 호스트로 바꾸세요.
cat > streamload_example.csv <<'CSV'
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64
CSV

curl --location-trusted -u root: \
  -H "Expect:100-continue" \
  -H "label:orders_2024_06_01" \
  -H "column_separator:," \
  -H "columns:user_id,name,age" \
  -T streamload_example.csv \
  -XPUT http://127.0.0.1:8030/api/testdb/test_streamload/_stream_load
예상 결과
{
  "TxnId": 3,
  "Label": "orders_2024_06_01",
  "Status": "Success",
  "NumberTotalRows": 10,
  "NumberLoadedRows": 10,
  "NumberFilteredRows": 0,
  "LoadBytes": 118,
  "LoadTimeMs": 173
}
Status: Success는 배치가 커밋되어 행을 쿼리할 수 있다는 뜻입니다. SELECT COUNT(*) FROM testdb.test_streamload는 10을 반환합니다. 같은 curl을 다시 전송하면 Status: Label Already Exists가 반환되고 아무 데이터도 기록되지 않으므로, 일시적인 네트워크 오류로 클라이언트가 재시도하더라도 데이터가 중복 적재되지 않습니다.
Apache Doris Stream Load는 언제 사용해야 하나요?
클라이언트가 원하는 동작이 배치당 하나의 HTTP PUT, 레이블 기반 재시도 보장, 동기식 JSON 응답이라면 Apache Doris Stream Load를 사용하세요.
적합한 경우
- 이미 HTTP를 사용하며 체크포인트마다 동기식 응답을 받으려는 Flink, Spark 또는 기타 스트리밍 sink. 체크포인트 간 exactly-once를 보장하려면
two_phase_commit:true와 함께 사용하세요. - 단일 CSV, JSON, Parquet 또는 ORC 파일(일반적으로 약 10 GB 이하)을 전송하고 하나의 원자적 커밋으로 처리하려는 ETL 스크립트.
- 프로그래밍 방식으로 데이터를 생성하고
curl -T -로 파이프 전달하는 Bash 한 줄 명령이나 각 프로그래밍 언어의 HTTP 클라이언트. - 트랜잭션 관리자 없이 레이블 기반 재시도 보장이 필요한 데이터 적재.
적합하지 않은 경우
- 많은 클라이언트가 초당 수만 건의 작은 PUT 요청을 전송하는 경우. 각 데이터 적재가 자체 트랜잭션을 시작하고 자체 rowset을 생성하므로 FE 플래너에 과부하가 걸리고 BE에서
-235 Too many segments가 발생합니다. BE가 작은 쓰기를 하나의 트랜잭션으로 병합하도록 Group Commit을 사용하거나, Kafka의 경우 Routine Load로 전환하세요. - 10 GB보다 훨씬 큰 단일 파일. Apache Doris Stream Load는 하나의 동기식 요청으로 실행되므로 연결이 끊기면 처음부터 다시 시작해야 합니다. 파일을 분할하거나, 서버 측에서 실행되어 클라이언트 연결이 종료되어도 계속 동작하는 Batch Load를 사용하세요.
- Kafka 토픽에서 새 데이터를 지속적으로 읽어오는 경우. Stream Load는 오프셋을 관리하지 않습니다. 오프셋, 재시작, 일시 중지를 관리해 주는 Routine Load를 사용하세요.
- 클라우드 / 스토리지와 컴퓨팅이 분리된 배포 환경에서 Merge-on-Write Unique Key 테이블에 Stream Load 2PC를 사용하는 경우. BE는 이 조합을
Status::NotSupported로 거부합니다. 온프레미스(shared-nothing) 클러스터에서는 허용되며, 회귀 테스트 모음에서도 이 조합을 검증합니다. - 기본적으로 서버 측 기록이 필요한 데이터 적재. Apache Doris는 기본적으로 Stream Load 이력을 기록하지 않습니다.
enable_stream_load_record를be.conf에서 활성화해야SHOW STREAM LOAD가 결과를 반환합니다.
더 읽어보기
- Stream Load HTTP 레퍼런스: 모든 헤더, 리디렉션 규칙, 전체 응답 본문
- Group Commit:
-235가 발생하는 고빈도 Stream Load를 위한 서버 측 병합 - Batch Load: S3와 HDFS의 대용량 파일을 비동기로 일괄 수집
- 데이터 적재 트랜잭션과 Stream Load 2PC: 체크포인트에 두 시스템 간 exactly-once가 필요한 경우
- Routine Load: 오프셋과 일시 중지를 제어하는 관리형 Kafka 컨슈머
- Doris Streamloader: Stream Load API를 감싸는 다중 동시성 클라이언트 래퍼
- Unique Key: CDC 파이프라인의 부분 컬럼 upsert(
partial_columns: true)를 처리하는 주요 대상입니다.