Unique Key
핵심 요약 Apache Doris Unique Key 모델은 기본 키마다 하나의 행을 유지하는 기본 키 테이블 모델로, 트랜잭션 데이터베이스처럼 SQL
UPDATE와DELETE를 지원합니다. 일부 컬럼만 지정하는 upsert를 Stream Load로 테이블에 바로 반영할 수 있습니다. 버전 2.1부터 Unique Key 모델은 기본적으로 Merge-on-Write를 사용하므로, 쓰기 시점에 중복을 해결하고 쿼리의 읽기 시점에는 버전 병합을 수행하지 않습니다.
Apache Doris Unique Key 모델을 사용하는 이유는 무엇인가요?
Apache Doris Unique Key 모델은 OLAP 엔진에서 기본 키의 동작을 온전히 구현합니다. 키마다 하나의 행을 유지하고, 쓰기 즉시 유일성을 보장하며, 파티션을 다시 쓰지 않고도 SQL UPDATE/DELETE를 실행할 수 있습니다. 대부분의 분석 엔진은 테이블을 데이터 추가만 가능한 형태로 취급합니다. 하지만 CDC를 처리해야 하면 상황이 달라집니다. MySQL의 행이 업데이트되거나, 사용자가 GDPR에 따라 삭제를 요청하거나, 늦게 도착한 이벤트가 이전 이벤트를 덮어써야 할 수 있습니다. 데이터 추가만 가능한 테이블 모델에서는 이런 변경을 기록할 수는 있지만, 파티션 전체를 다시 쓰지 않고는 데이터 웨어하우스에서 이전 버전을 제거할 수 없습니다.
- Flink CDC 작업이 MySQL을 모니터링하며 모든 기본 키 업데이트를 수초 내에 반영해야 합니다.
- 주문 상태 테이블이
created,paid,shipped,delivered순서로 바뀌며, 쿼리에는 최신 상태만 보여야 합니다. - 사용자 프로필 테이블을 실시간 조인에 사용하며, 조인에서 어제의 이메일 주소가 조회되어서는 안 됩니다.
Unique Key 모델은 이런 용도를 위한 테이블 모델입니다. 기존 키로 새 데이터를 쓰면 이전 행을 대체하고, UPDATE와 DELETE를 SQL로 실행할 수 있으며, 분석 쿼리는 컬럼 기반 처리의 속도를 그대로 누릴 수 있습니다. 다른 OLAP 엔진에서 가장 비슷한 기능은 ClickHouse의 ReplacingMergeTree이지만, 즉시 유일성을 보장하지는 않습니다. 백그라운드 병합이 실행될 때까지 중복 행이 계속 노출되며, 병합 후에도 엔진이 보장하는 것은 최종적인 중복 제거뿐입니다. 쓰기 직후의 쿼리는 여전히 이전 버전을 볼 수 있으며, 이를 해결하려면 읽기 시점에 중복 제거를 강제하는 SELECT ... FINAL을 사용해야 합니다. 여기에는 상당한 비용이 듭니다. Unique Key에서는 이런 타협이 필요하지 않습니다. 쓰기 시점에 새 행이 이전 행을 대체하므로, 다음 쿼리는 키마다 하나의 행만 보게 됩니다.
Apache Doris Unique Key 모델이란 무엇인가요?
Apache Doris Unique Key 모델은 기본 키마다 정확히 하나의 행을 유지하는 테이블 모델이며, Merge-on-Write 엔진이 쓰기 시점에 이를 보장합니다. UNIQUE KEY(...) 절로 CREATE TABLE의 키 컬럼을 지정하며, 나머지는 모두 값 컬럼입니다. 키가 같은 두 행은 공존할 수 없습니다. 기존 키로 새 데이터를 쓰면 해당 행을 대체합니다.
... UNIQUE KEY(order_id) ...
... UNIQUE KEY(tenant_id, user_id) ...
FE Catalog는 이를 KeysType.UNIQUE_KEYS로 기록하며, 이후 스토리지 엔진은 이 규약을 준수합니다. 모델은 테이블 생성 시점에 고정되며 나중에 변경할 수 없습니다.
핵심 용어
- 기본 키:
UNIQUE KEY(...)에 지정된 컬럼입니다. 디스크에 저장되는 데이터의 정렬 기준이 되며 유일성을 보장합니다. - 값 컬럼: 나머지 모든 컬럼입니다. 집계 없이 입력된 그대로 저장됩니다.
- Merge-on-Write (MoW): 2.1부터 기본으로 사용하는 백엔드입니다. 새 데이터를 쓸 때 기존 행을 조회하고, rowset별 삭제 비트맵에서 해당 행 ID의 비트를 설정한 뒤, 새로운 rowset에 새 행을 추가합니다.
- Merge-on-Read (MoR): 이전에 사용하던 백엔드입니다. 쓰기는 데이터를 추가하고, 읽기는 키별로 여러 버전을 동적으로 병합합니다. 지금도
enable_unique_key_merge_on_write = false로 선택할 수 있습니다. - 삭제 비트맵:
(rowset_id, segment_id, version)을 키로 사용하며, 쿼리에서 건너뛰어야 하는 행 ID를 담은 Roaring 비트맵입니다. 읽기 시점의 병합을 대신하는 MoW의 결과물입니다. - 시퀀스 컬럼 (
function_column.sequence_col): 두 업데이트의 키가 같을 때 어느 쓰기를 적용할지 결정하는 값 컬럼입니다. 순서가 뒤바뀐 CDC 이벤트에서도 이 컬럼을 사용해 더 최신 상태를 유지합니다. - 부분 컬럼 업데이트: 일부 컬럼만 쓰는 upsert입니다. Apache Doris가 나머지 컬럼을 기존 행에서 읽어 완전한 행을 다시 씁니다.
__DORIS_DELETE_SIGN__: 숨겨진 tinyint 컬럼입니다. 어떤 데이터 적재 경로에서든 이 값을1로 설정하면 해당 행을 논리적으로 삭제할 수 있습니다.
Apache Doris Unique Key 모델은 어떻게 동작하나요?
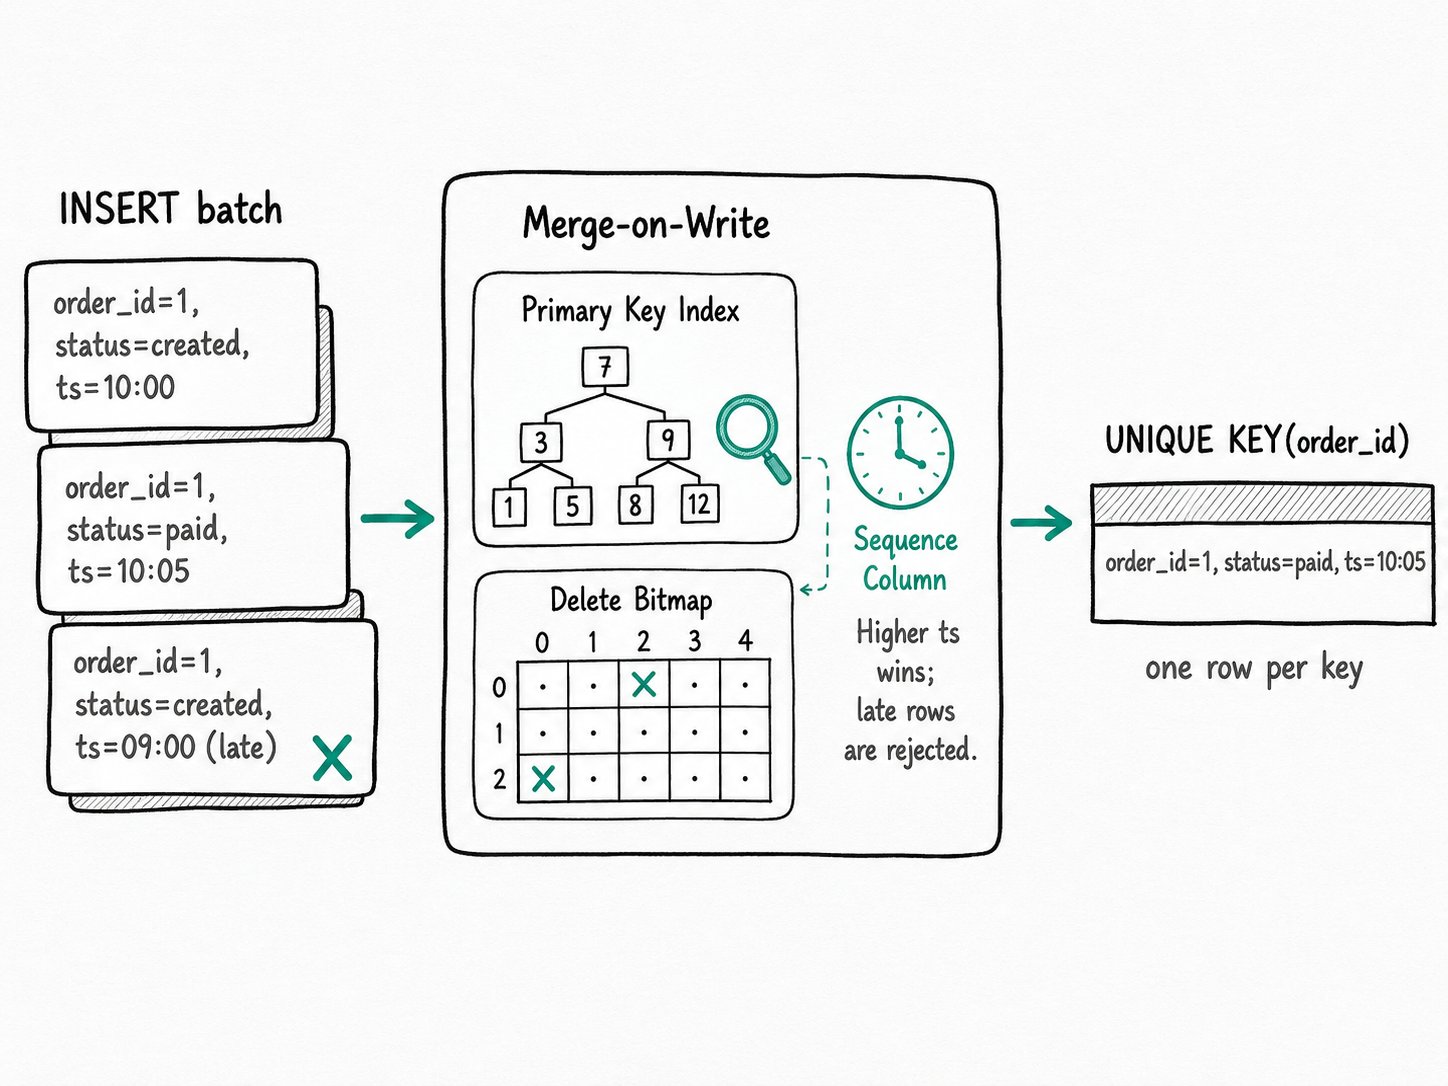
Apache Doris Unique Key 모델은 각 upsert를 다섯 단계로 처리합니다. 배치를 버퍼링하고, 세그먼트별 기본 키 인덱스에서 키를 조회하고, 이전 행의 삭제 비트맵 비트를 설정하고, 시퀀스 컬럼으로 순서를 결정한 뒤, 새 rowset을 공개합니다.
Unique Key MoW 테이블에 대한 upsert를 예로 살펴보겠습니다.
- 배치를 버퍼링합니다. BE는 들어오는 행을 memtable에 모아 키를 기준으로 정렬합니다.
- 각 키를 조회합니다. BE는 배치의 각 키에 대해 세그먼트별 기본 키 인덱스를 조회하여 기존 rowset과 행 ID를 찾습니다. 키마다 짧은 읽기를 한 번 수행합니다. 인덱스는 각 세그먼트가 flush될 때 생성되는 정렬된 페이지 구조로, 개념적으로 RocksDB의 파티션 인덱스와 비슷합니다.
- 이전 행을 표시합니다. 영향을 받는 각 rowset의 삭제 비트맵에서 이전 행 ID에 해당하는 비트를 설정합니다. 비트맵은
(rowset_id, segment_id, version)별로 존재하며, 이전 데이터는 compaction이 공간을 회수할 때까지 디스크에 남아 있습니다. - 시퀀스 컬럼으로 순서를 결정합니다.
function_column.sequence_col이 설정되어 있으면 MoW는 들어오는 행의 시퀀스 값과 현재 행의__DORIS_SEQUENCE_COL__을 비교합니다. 더 큰 값을 가진 행이 적용됩니다. 값이 같으면 데이터 적재 순서를 따릅니다. 시퀀스 타입은 정수 또는DATE/DATETIME/TIMESTAMP_NS여야 합니다. - 새 rowset을 공개합니다. 트랜잭션이 커밋되고 새 버전이 조회 가능해지며, 이후의 쿼리는 병합된 삭제 비트맵으로 행을 필터링합니다. 읽기 시점에는 버전 병합 단계가 없습니다.
DELETE FROM ... WHERE도 새 rowset을 만드는 과정 없이 같은 흐름을 따릅니다. 부분 업데이트에는 한 단계가 추가됩니다. BE는 쓰기 전에 각 키의 변경되지 않은 컬럼을 읽어 완전한 행을 저장할 수 있도록 합니다.
빠른 시작
CREATE TABLE orders (
  order_id BIGINT,
  status   VARCHAR(20),
  amount   DECIMAL(10, 2),
  updated  DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4
PROPERTIES ("function_column.sequence_col" = "updated");

INSERT INTO orders VALUES
  (1, 'created', 99.50, '2026-05-08 10:00:00'),
  (1, 'paid',    99.50, '2026-05-08 10:05:00'),
  (1, 'created', 99.50, '2026-05-08 09:00:00');  -- late event

SELECT * FROM orders;
예상 결과
+----------+--------+--------+---------------------+
| order_id | status | amount | updated             |
+----------+--------+--------+---------------------+
|        1 | paid   |  99.50 | 2026-05-08 10:05:00 |
+----------+--------+--------+---------------------+
세 번 삽입했지만 행은 하나입니다. 두 번째 INSERT는 키가 같으므로 첫 번째 행을 덮어썼습니다. 세 번째 삽입도 다시 덮어쓰려고 했지만, 해당 행의 updated 값이 현재 시퀀스보다 오래되었으므로 MoW는 기존 행을 유지했습니다. function_column.sequence_col 속성을 제거하면 데이터 적재 순서만으로 세 번째 행이 적용됩니다. 이는 CDC에서 원하는 동작이 아닙니다.
Apache Doris Unique Key 모델은 언제 사용해야 하나요?
Apache Doris Unique Key 모델은 CDC 싱크, 실시간 차원 및 조회 테이블, 자주 변경되는 주문·사용자·잔액 테이블, store_row_column과 함께 사용하는 KV 방식의 포인트 조회, GDPR에 따른 행 단위 삭제, 여러 업스트림의 데이터를 결합하는 와이드 테이블 구성에 적합합니다. 데이터 추가만 가능한 이벤트 스트림, 단일 행 업데이트를 매우 빈번하게 반복하는 작업, 무작위이거나 매우 넓은 기본 키, 이전 Merge-on-Read 백엔드에서 count(*)를 많이 사용하는 워크로드에는 적합하지 않습니다.
적합한 경우
- MySQL, Postgres 또는 기본 키가 있는 모든 소스의 CDC 싱크. 소스의 커밋 타임스탬프나 LSN을 시퀀스 컬럼으로 함께 사용하세요. Kafka CDC 통합을 참고하세요.
- 팩트 테이블 쿼리에 조인되는 실시간 차원 및 조회 테이블.
- 자주 변경되며 분석 쿼리에 사용되는 주문, 사용자, 잔액 또는 세션 상태 테이블.
- MoW를
store_row_column및 prepared statement와 함께 사용하는 KV 방식의 포인트 조회. 고동시성 포인트 쿼리를 참고하세요. - 사용자 ID를 기준으로 하는 GDPR 행 단위 삭제. 모든 데이터 적재 경로에서
__DORIS_DELETE_SIGN__을 통한 논리적 삭제도 포함됩니다. - 각 업스트림이 컬럼 그룹을 담당하고,
partial_columns: true를 지정한 Stream Load로 자신이 담당하는 컬럼만 쓰는 와이드 테이블 구성. 부분 컬럼 업데이트를 참고하세요.
적합하지 않은 경우
- 데이터 추가만 가능한 이벤트 스트림(로그, 클릭스트림, IoT 측정값). 사용하지 않는 기능을 위해 쓰기마다 키 인덱스 조회 비용을 지불하게 됩니다. 대신 Duplicate Key 모델을 선택하세요. 데이터 모델을 참고하세요.
- 단일 행
UPDATE를 매우 빈번하게 반복하는 작업. 각 문이 별도의 트랜잭션이므로 커밋 오버헤드가 대부분을 차지합니다. Stream Load에서partial_columns: true를 지정해 배치로 처리하거나 Group Commit을 사용하세요. - 무작위이거나 매우 넓은 기본 키(UUID, 긴 복합 키). 데이터 적재 배치마다 PK 인덱스를 탐색하며, 무작위 키는 캐시 지역성을 떨어뜨립니다. 정수를 우선 사용하고, 키를 좁게 유지하며, 값을 담을 수 있는 가장 작은 타입을 사용하세요. float, double 및
ARRAY,MAP,STRUCT,JSON,VARIANT같은 복합 타입은 키 컬럼으로 사용할 수 없습니다. - 파티션 키를 기본 키의 상위 집합으로 사용하는 경우. 파티션 컬럼은 고유 키의 부분 집합이어야 하며, 그 반대는 허용되지 않습니다. 그렇지 않으면 같은 키가 두 파티션에 들어갈 수 있어 중복 제거가 제대로 동작하지 않습니다.
- MoR 방식에서
count(*)를 많이 사용하는 워크로드. MoR은 쿼리 시점에 버전을 재구성하므로 개수 집계 비용이 큽니다. Merge-on-Write를 활성화하거나(2.1부터 기본값), 데이터가 실제로 추가만 된다면 Duplicate로 전환하세요.
더 읽어보기
- Unique Key 모델: SQL 구문, Merge-on-Write와 Merge-on-Read의 차이, 파티션 규칙, 생성 속성을 자세히 설명합니다.
- 데이터 업데이트 및 삭제: SQL 기능(
UPDATE,DELETE, 일부 컬럼만 지정하는 upsert, 원자적 파티션 교체)과 이를 지원하는 Merge-on-Write의 내부 동작을 설명합니다. - 데이터 모델: Unique Key를 Duplicate 및 Aggregate와 비교하고, 각 모델에 적합한 워크로드를 설명합니다.
- 시퀀스 컬럼을 사용한 동시성 제어: 허용되는 타입, null 처리, 순서가 뒤바뀐 쓰기를 해결하는 방법을 설명합니다.
- 고동시성 포인트 쿼리: Unique Key 테이블을 KV 스토어로 활용할 수 있게 하는 단축 실행 계획을 설명합니다.
- Apache Doris 2.1.0: Unique Key의 기본값이 된 Merge-on-Write