VARIANT 데이터 타입
핵심 요약 Apache Doris
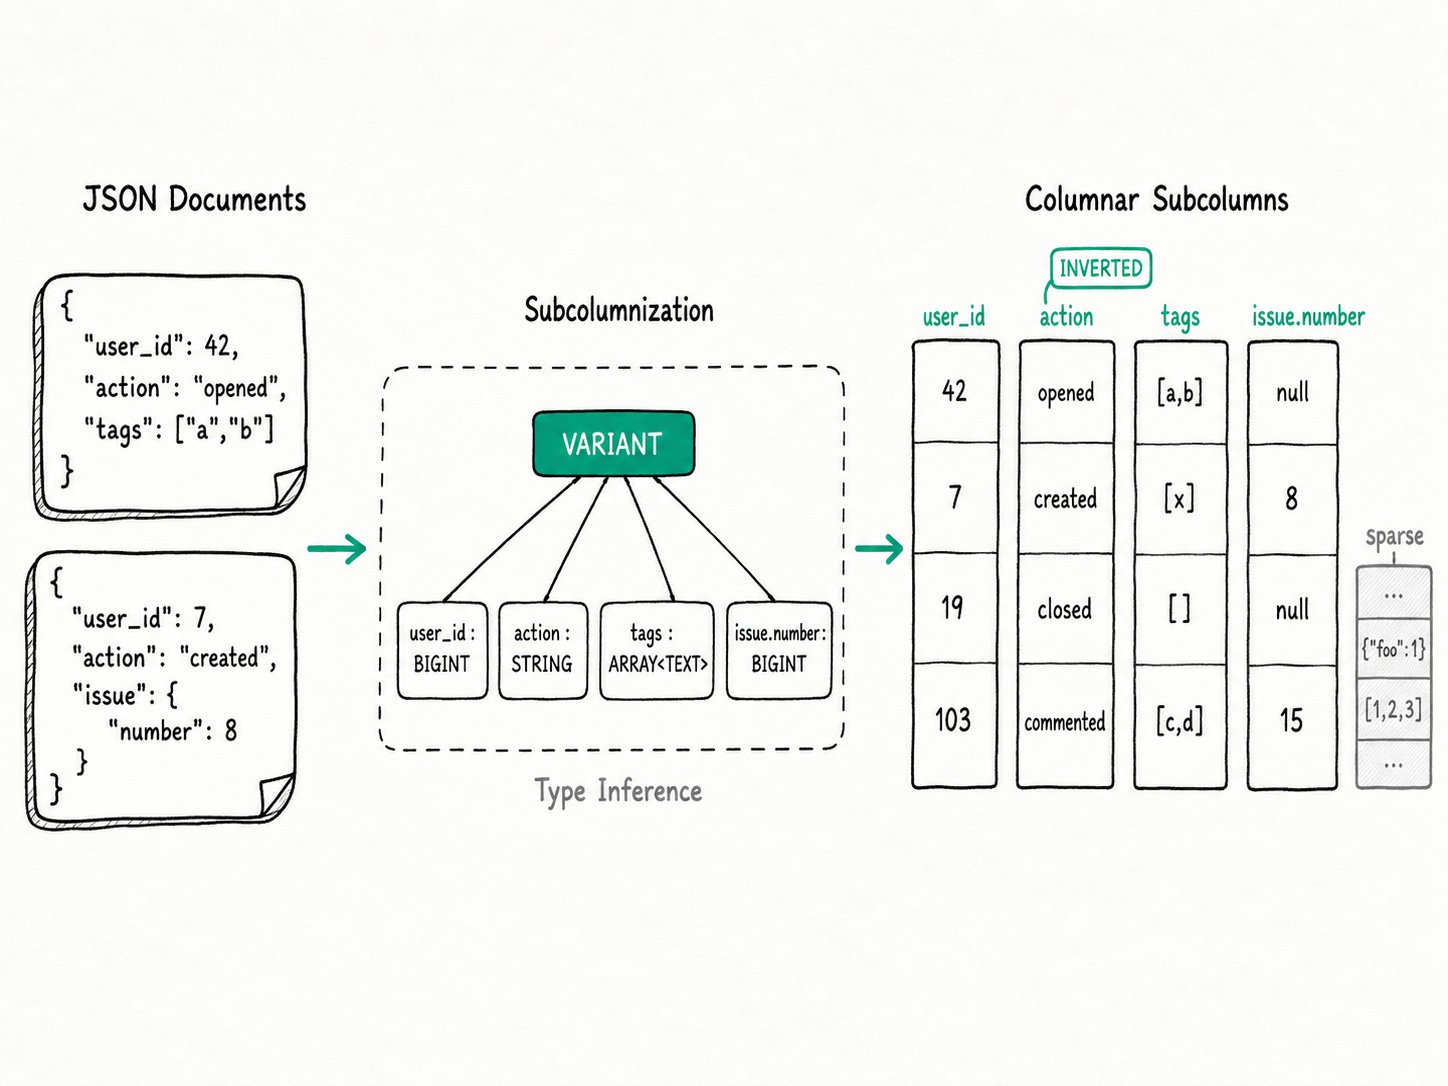
VARIANT는 시간이 지나면서 구조가 바뀌는 JSON을 위한 컬럼 타입입니다. 데이터를 기록할 때 Apache Doris는 각 문서를 파싱하고 JSON 경로별로 타입을 추론한 다음, 자주 접근하는 경로를 각각 별도의 컬럼형 서브컬럼으로 저장합니다. 기본값은 VARIANT 컬럼당 서브컬럼 2048개입니다. 그러면v['user_id']에 대한 필터와 집계는 문서 전체를 파싱하는 대신 컬럼 하나만 읽습니다. VARIANT는 Apache Doris 2.1.0(2024년 삼월)에서 GA로 출시되었으며, Snowflake와 ClickHouse에서 영감을 받았습니다.
Apache Doris에서 VARIANT 데이터 타입을 사용하는 이유는 무엇인가요?
Apache Doris VARIANT 데이터 타입은 유연한 JSON 저장과 컬럼 저장소의 빠른 쿼리 성능 사이에서 하나를 포기해야 했던 기존의 제약을 없앱니다. OLAP 시스템에 JSON을 저장할 때는 오랫동안 타협이 필요했습니다.
STRING또는JSONB컬럼은 유연하지만, 경로에 접근하는 쿼리마다 문서 전체를 파싱해야 합니다. 십억 개 행에 대해WHERE payload['action'] = 'opened'를 실행하면 모든 페이로드의 모든 바이트를 읽습니다.action이 큰 문서 안의 짧은 필드 하나에 불과하더라도 마찬가지입니다.- 정적 컬럼은 빠르지만, 스키마가 안정적일 때만 그렇습니다. 데이터를 생성하는 쪽에서 다음 스프린트에 필드를 추가하면 다시
ALTER TABLE마이그레이션을 수행하거나 보조 JSON 컬럼을 사용해야 합니다.
Apache Doris VARIANT를 사용하면 이런 선택이 필요 없습니다. 컬럼 하나를 선언하고 JSON을 기록하면 Apache Doris가 자주 접근하는 경로를 실제 컬럼형 저장소로 자동 변환합니다. 쿼리는 계속 SQL로 작성하며, 디스크의 테이블 구조는 직접 설계한 테이블과 매우 비슷해집니다.
Apache Doris VARIANT 데이터 타입이란 무엇인가요?
Apache Doris VARIANT 데이터 타입은 반정형 컬럼 타입입니다. VARIANT는 스칼라, 배열, 중첩 객체 등 유효한 모든 JSON 값을 받아들입니다. 행이 유입되면 writer가 경로의 접두사 트리를 만들고 경로별로 타입을 추론한 다음, 각 경로를 세그먼트 내부의 독립된 컬럼으로 기록합니다. 각 컬럼에는 페이지 인코딩과 페이지 인덱싱이 적용됩니다. 사용자는 JSON을 쿼리하지만 디스크에는 경로마다 서브컬럼 하나가 저장됩니다.
주요 용어
Subcolumn: JSON 경로에서 생성된 독립적인 디스크상의 컬럼입니다. 각 서브컬럼에는 정적 컬럼과 마찬가지로 자체 인코딩, 압축, zone map, bloom filter가 있습니다.Subcolumnization: 데이터를 기록할 때 JSON에서 자주 접근하는 경로를 서브컬럼으로 승격하는 과정입니다.variant_max_subcolumns_count로 제어하며 기본값은2048입니다.Schema Template: 선택한 경로의 타입을 고정하여 여러 차례의 데이터 적재에도 스토리지와 인덱스가 안정적으로 유지되게 하는 선택적VARIANT<'path' : TYPE, ...>절입니다.Sparse column: 경로 수가 서브컬럼 허용 개수를 초과할 때 롱테일 경로를 저장하는 공용 대체 스토리지입니다. 여러 논리적 경로가 하나의 물리적 컬럼을 공유하며, 희소 샤딩을 활성화하면 소수의 컬럼을 공유합니다.Type promotion: 동일한 경로가 어떤 행에서는INT로, 다른 행에서는STRING으로 들어올 때 처리 방식을 결정하는 규칙입니다. 서로 다른 너비의 정수는 더 넓은 타입으로 확장됩니다(TINYINT에서BIGINT로). 정수와 배정밀도 부동소수점 수, 숫자와 문자열 등 그 밖의 타입 충돌이 발생하면JSONB로 대체됩니다.
Apache Doris VARIANT 데이터 타입은 어떻게 동작하나요?
Apache Doris VARIANT는 데이터를 기록할 때 각 JSON 문서를 파싱하고 JSON 경로별로 타입을 추론합니다. 자주 나타나는 경로는 독립된 컬럼형 서브컬럼으로 저장하고, 롱테일 경로는 공용 희소 컬럼에 저장합니다. 경로 하나가 디스크에 저장되고 읽히는 과정은 다음과 같습니다.
- 파싱 및 추론. JSON이 memtable에 들어오면 writer가 모든 리프 경로를 접두사 트리에 추가하고 경로별로 저장 타입을 하나씩 선택합니다. 정수에는
BIGINT, 소수부가 있는 숫자에는DOUBLE, 문자열에는STRING, 불리언에는BOOLEAN, 스칼라 배열에는ARRAY<T>를 사용합니다. 중첩 객체는 더 깊은 경로가 됩니다. - 승격 또는 대체. 새 값이 현재 타입과 충돌하면 Doris는 가능한 경우 타입을 확장합니다. 서로 다른 너비의 정수는
BIGINT가 됩니다. 정수가 배정밀도 부동소수점 수나 문자열과 만나는 등 타입을 확장할 수 없는 경우에는 해당 경로를JSONB로 대체하며, 스키마를 수정할 때까지 해당 경로에 대한 쿼리에서 푸시다운을 사용할 수 없습니다. - 서브컬럼 또는 희소 컬럼에 기록. NULL이 아닌 값의 비율이 가장 높은 경로들은 독립된 서브컬럼이 되며, 정적 컬럼과 동일하게 인코딩되고 압축됩니다.
variant_max_subcolumns_count에 도달하면 나머지 저빈도 경로는 희소 컬럼에 묶어 저장됩니다. - 스키마 병합. 각 rowset은 자체 서브컬럼 스키마를 기록합니다. Compaction은 최소 공통 컬럼 스키마를 사용해 rowset을 병합하므로, 오늘 새 필드를 추가해도
ALTER TABLE이 필요하지 않습니다. - 경로별 읽기.
SELECT v['user_id']는 서브컬럼 하나로 해석되어 해당 컬럼만 읽으며, 정적 컬럼과 같은 방식으로 zone map과 bloom filter를 사용해 페이지를 건너뜁니다. 조건자도 푸시다운됩니다.CAST(v['user_id'] AS BIGINT) = 42는 JSON 텍스트가 아닌 타입이 지정된 서브컬럼을 대상으로 실행됩니다.
역색인도 하위 경로에서 같은 방식으로 동작합니다. INDEX idx_v(v) USING INVERTED PROPERTIES("parser" = "english")는 모든 텍스트 서브컬럼을 검색할 수 있게 하며, Schema Template을 사용하면 특정 경로 하나에 인덱스를 고정할 수 있습니다.
빠른 시작
CREATE TABLE github_events (
  id          BIGINT,
  type        VARCHAR(30),
  payload     VARIANT,
  created_at  DATETIME,
  INDEX idx_payload (payload) USING INVERTED PROPERTIES("parser" = "english")
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 4
PROPERTIES ("storage_format" = "V3", "replication_num" = "1");

-- INSERT keeps a plain string as a VARIANT string, so parse the JSON text.
-- Load jobs such as Stream Load parse JSON automatically.
INSERT INTO github_events VALUES
  (1, 'PushEvent', PARSE_TO_VARIANT('{"action":"opened","commits":[{"sha":"abc"}],"size":4}'), '2026-05-01'),
  (2, 'IssueCommentEvent', PARSE_TO_VARIANT('{"action":"created","issue":{"number":42}}'), '2026-05-01');

SELECT CAST(payload['action'] AS STRING) AS action, COUNT(*) AS n
FROM github_events
WHERE payload['action'] MATCH 'opened'
GROUP BY action;
예상 결과
+--------+---+
| action | n |
+--------+---+
| opened | 1 |
+--------+---+
필터는 서브컬럼 하나를 읽고 역색인을 활용하며, commits 배열에는 전혀 접근하지 않습니다. SET describe_extend_variant_column = true; DESC github_events;를 실행하면 추론된 서브컬럼(payload.action, payload.commits, payload.issue.number, ...)을 직접 선언한 컬럼처럼 확인할 수 있습니다.
Apache Doris VARIANT 데이터 타입은 언제 사용해야 하나요?
JSON 스키마가 계속 바뀌지만 대부분의 쿼리가 익숙한 몇 가지 경로에 집중될 때 Apache Doris VARIANT를 사용하세요. 구조가 고정되어 있다면 정적 컬럼이나 STRUCT를 사용하고, 기본 키, 정렬 키, 조인 키에는 타입이 명시된 컬럼을 사용하세요.
적합한 경우
- 대부분의 쿼리가 익숙한 몇 가지 경로에만 접근하고, 문서의 나머지 부분은 함께 저장하기만 하는 이벤트 로그 및 감사 페이로드.
- 데이터를 생성하는 쪽에서 필드를 계속 추가하고, 스키마 마이그레이션 때문에 수집을 중단할 수 없는 텔레메트리 및 사용자 프로필 테이블.
- 수천 개의 선택적 태그가 있는 관측성 데이터. 자주 사용하는 태그는 서브컬럼이 되고, 롱테일 태그는 compaction 부담을 늘리지 않고 희소 컬럼에 저장됩니다.
VARIANT와USING INVERTED를 결합한 JSON 내부 전문 검색.
적합하지 않은 경우
- 스키마가 안정적이고 명확하게 정의된 테이블. 일반적인 타입 지정 컬럼은 이해하기 쉽고 인덱스를 만들기도 쉬우며, 실수로
JSONB로 승격될 일도 없습니다. 스키마가 실제로 바뀔 때만VARIANT를 사용하세요. - 기본 키, 정렬 키 또는 조인 키.
VARIANT컬럼은 키 컬럼이 될 수 없습니다. VARIANT 값으로 조인과 정렬을 수행할 수는 있지만, 정적 컬럼보다 느립니다.id가 조인 키라면 정적BIGINT로 선언하세요. WHERE v LIKE '%doris%'와 같은 문서 전체 검색. 역색인은 컬럼 전체가 아니라 하위 경로에 존재합니다. 원본 JSON을 별도의STRING컬럼에 함께 보관하고 해당 컬럼에 인덱스를 생성하거나, DOC 모드를 활성화하여SELECT v를 빠르게 처리하세요.- 설계 시점에 이미 알고 있는 고정된 구조. 모든 행의 구조가 정확히
{a, b, c}이고 타입이 바뀌지 않는다면STRUCT가 더 적합한 데이터 계약입니다. 예상하지 못한 필드를 허용하지 않기 때문입니다. 반면VARIANT는 그런 필드도 별도 처리 없이 받아들입니다. - 별도 조정 없이 사용하는 매우 넓은 JSON(10k+ 경로). 기본 서브컬럼 추출은 경로 2048개로 제한됩니다. 이를 넘는다면 희소 컬럼이나 DOC 모드를 고려하고, 운영 데이터 적재 전에 VARIANT 워크로드 가이드를 읽어보세요.
성능 / 수치
- ClickBench, 쿼리 43개를 16코어 / 64 GB EC2 인스턴스에서 실행한 결과: VARIANT는 12.7 GB, JSON은 35.7 GB를 사용했으며(~65% 감소), 워밍업 후 쿼리는 JSON보다 약 8배 빨랐고 미리 정의한 정적 컬럼과의 성능 차이는 ~10% 이내였습니다. 출처: Apache Doris 2.1.0의 Variant.
- GuanceDB가 관측성 데이터를 Elasticsearch에서 VARIANT 기반 Doris로 마이그레이션한 결과: 서버 비용 70% 감소, 전체 쿼리 속도 ~2배, 단순 쿼리 속도 4배 이상 향상. 출처: 동일 게시물.
추가 자료
- VARIANT SQL 참조: 전체 구문, 타입 규칙, 인덱스, 구성
- VARIANT 워크로드 가이드: 기본 모드, 희소 모드, DOC 모드, Schema Template을 선택하는 기준
- VARIANT 데이터 적재: Stream Load, Routine Load 및 Broker Load 예제
- 컬럼형 스토리지 기능 카드: 내부에서 서브컬럼을 인코딩하고 페이지로 나누고 인덱싱하는 방식
- 역색인 개요: JSON 내부 텍스트 검색에 VARIANT가 사용하는 인덱스
- LLM SQL 함수:
AI_*함수 계열의 JSON 출력(AI_EXTRACT,AI_CLASSIFY등)은 VARIANT 컬럼에 저장하기에 적합합니다. - Apache Doris 블로그: Apache Doris 2.1.0의 Variant, 최초 발표 및 벤치마크