벡터화 실행
핵심 요약 모든 Apache Doris 쿼리는 벡터화 엔진에서 실행됩니다. 연산자는 최대 4,096개의 행을 컬럼별로 구성한
Block단위로 데이터를 전달하며, 간결한 내부 루프에서 컴파일러의 최적화와 직접 작성한 intrinsic을 통해 SIMD를 활용합니다. 행 기반 엔진은 v2.0에서 완전히 삭제되었으므로 따로 활성화할 필요가 없습니다. 대부분의 사용자가 조정할 일 있는 설정은batch_size뿐입니다.
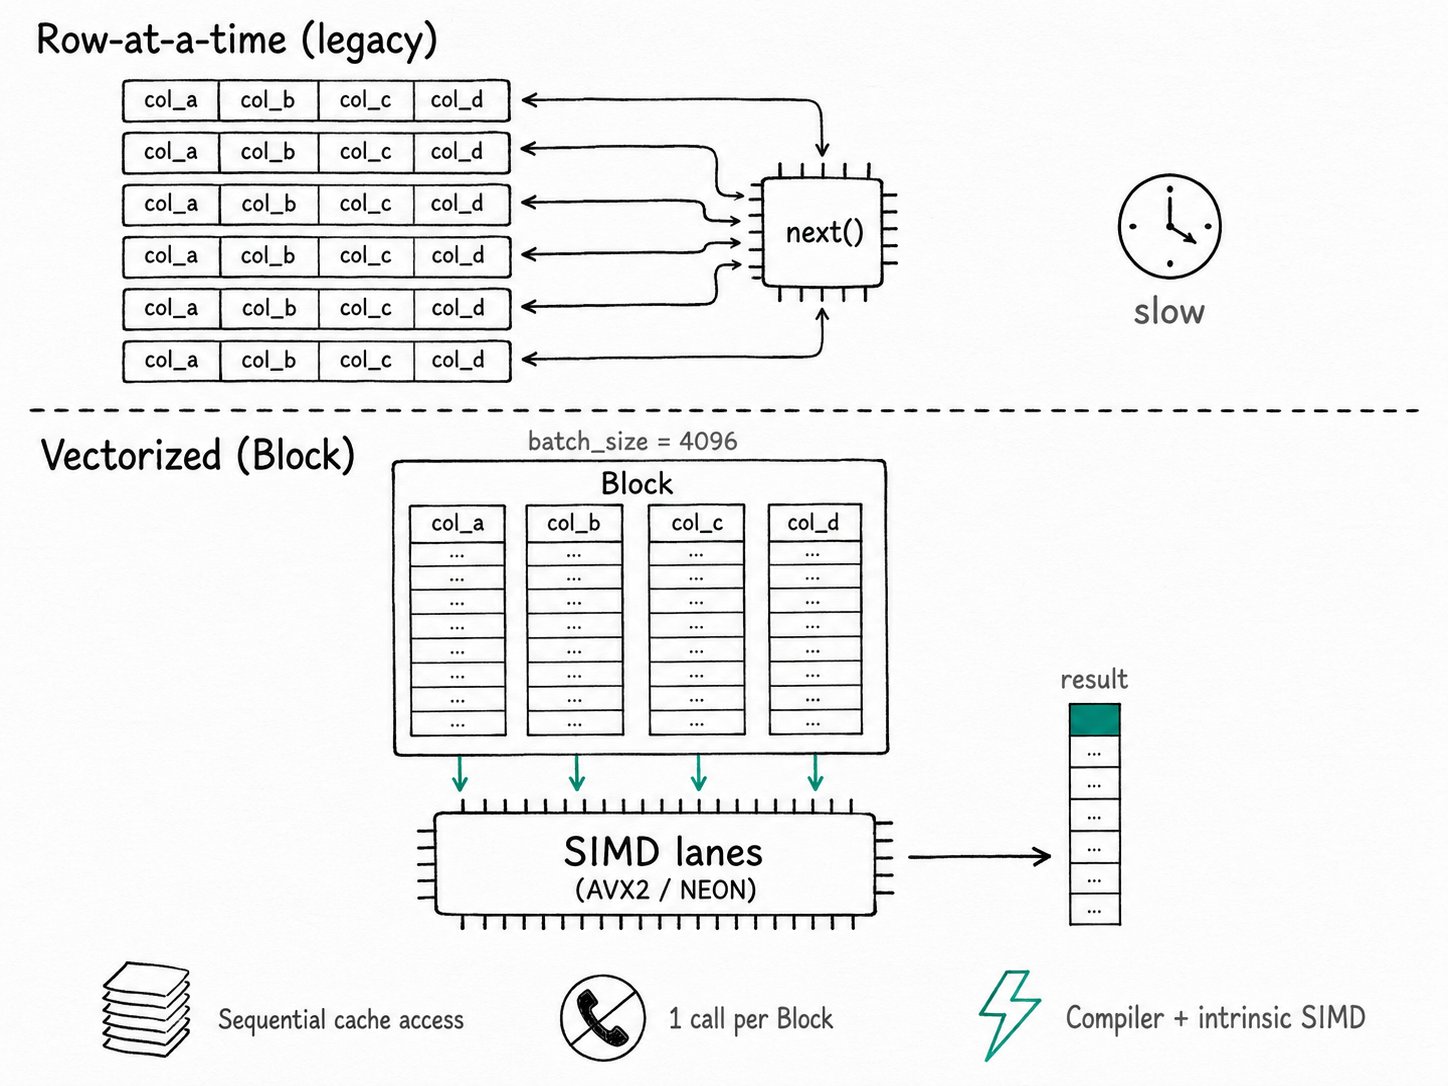
Apache Doris에서 벡터화 실행을 사용하는 이유는 무엇인가요?
Apache Doris의 벡터화 실행은 행마다 수행하는 가상 함수 호출을 컬럼 배치 단위의 내부 루프로 대체하여, CPU가 간접 호출 대신 산술 연산에 시간을 쓰도록 합니다. 전통적인 Volcano 방식 실행기는 행마다 next()를 호출하며, 튜플 하나를 생성하기 위해 가상 함수 호출 트리를 따라갑니다. 최신 CPU에서 실제 산술 연산 비용은 함수 호출, 분기 예측 실패, 캐시 미스 비용에 비하면 무시할 수 있는 수준입니다. 십억 개의 행을 하나씩 집계하면 빠른 머신도 느려집니다.
- 각 연산자가 행마다 가상 함수를 한 번씩 호출하면 수백만 번의 간접 점프가 발생하며, 분기 예측기도 이를 제대로 예측하지 못합니다.
- 행이 메모리 여기저기에 흩어져 있으면 CPU의 L1/L2 캐시에는 유용한 데이터가 거의 남지 않습니다.
- 데이터가 여러 행에 걸쳐 섞여 있으면 간결한 수치 연산 루프도 자동으로 벡터화할 수 없습니다.
벡터화 실행은 내부 루프의 처리 방식을 바꿉니다. 연산자는 컬럼 값의 배치를 받아 그 배치를 단순한 루프로 처리합니다. 그 결과 자주 실행되는 경로는 AVX2가 처리하도록 설계된 코드 형태가 됩니다.
Apache Doris 벡터화 실행이란 무엇인가요?
Apache Doris의 벡터화 실행은 컬럼 배치 기반 쿼리 엔진입니다. 모든 연산자의 get_block()은 하나의 Block을 입력받아 다른 Block을 생성하며, 여기서 Block은 1개부터 batch_size개까지의 행을 나타내는 작은 컬럼형 배열 집합입니다. SIMD intrinsic은 필터 선택, decimal 산술 연산, 문자열 비교, JSON 파싱처럼 효과가 큰 부분을 가속합니다. 이 모델은 MonetDB/X100과 Vectorwise에서 유래했습니다. ClickHouse, StarRocks, DuckDB도 같은 설계를 사용합니다.
주요 용어
Block: 연산자 사이에 전달되는 데이터의 단위입니다. 타입이 지정된 컬럼형 배열과 컬럼 메타데이터를 담습니다.be/src/vec/core/block.h에 구현되어 있습니다.Column: Block 안에 있는 타입이 지정된 배열 하나입니다. 특수화된 구현으로는ColumnVector,ColumnString,ColumnDecimal,ColumnNullable,ColumnDictionary가 있으며, 각각 데이터 형태에 맞게 최적화되어 있습니다.batch_size: Block의 최대 행 수입니다. 기본값은 4,096이며 세션별로 설정할 수 있습니다. 배치가 크면 호출당 오버헤드의 상대적 비중이 줄어들고, 배치가 작으면 메모리 사용량과 꼬리 지연 시간이 줄어듭니다.- SIMD 경로:
be/src/util/simd/에 직접 작성된 코드와 컴파일러가 자동으로 벡터화한 루프로 구성됩니다. 런타임에 x86에서는 AVX2, ARM에서는 NEON을 사용하도록 선택됩니다.
Apache Doris 벡터화 실행은 어떻게 동작하나요?
Apache Doris의 벡터화 실행은 컬럼형 Block에 최대 4,096개의 행을 담아 전달하는 연산자들을 연결합니다. 컬럼별로 단순한 루프를 실행하면서 효과가 있는 부분에 SIMD를 적용하고, Pipeline 스케줄러가 이러한 배치를 여러 코어에 걸쳐 교차 실행하도록 합니다.
- 계획을 연산자 체인으로 변환합니다. 옵티마이저가 실행 계획을 생성하면 FE가 이를 연산자 파이프라인으로 변환하고, 각 연산자는
get_block(state, block, eos)를 구현합니다. - 배치를 가져옵니다. 스캔 연산자가 태블릿의 컬럼형 스토리지에서 최대
batch_size개의 행을 읽어 Block을 제자리에서 채운 뒤 반환합니다. 행을 구조체로 구체화하는 과정은 없습니다. - 컬럼별로 실행합니다. 필터, 프로젝션, 집계, 조인 연산자는 각 컬럼을 단순한 루프로 순회합니다. 효과가 있는 경우 필터 압축을 위한
bytes32_mask_to_bits32_mask나 벡터화된 decimal 비교 같은 SIMD 프리미티브를 루프에서 호출합니다. - 다음 연산자로 전달합니다. Block은 값으로 파이프라인을 따라 이동하고, Pipeline 스케줄러는 CPU 집약적 단계와 IO 집약적 단계를 여러 코어에 걸쳐 교차 실행합니다. 여러 파이프라인 태스크가 서로 다른 Block을 병렬로 처리합니다.
- 클라이언트에 반환합니다. 마지막 연산자가 최종 Block들을 MySQL 와이어 프로토콜로 직렬화하면 쿼리가 완료됩니다.
v2.0에서 도입된 Pipeline 엔진은 이 기반 위에 구축되었습니다. 벡터화는 연산자가 배치를 어떻게 처리할지 결정하고, Pipeline은 이 배치를 여러 코어에 어떻게 스케줄링할지 결정합니다. 둘은 서로 다른 계층이지만 흔히 혼동됩니다.
빠른 시작
벡터화 실행은 유일한 실행 모드이므로 따로 활성화할 필요가 없습니다. 알아둘 만한 설정은 batch_size입니다.
-- Default; safe to leave alone for most workloads
SHOW VARIABLES LIKE 'batch_size';

-- Larger batches: better throughput on big aggregations, more memory per fragment
SET batch_size = 8192;

SELECT user_id, COUNT(*) AS events, SUM(bytes) AS total_bytes
FROM access_log
WHERE ts BETWEEN '2026-05-01' AND '2026-05-08'
GROUP BY user_id
ORDER BY total_bytes DESC
LIMIT 10;
예상 결과
+---------+--------+-------------+
| user_id | events | total_bytes |
+---------+--------+-------------+
|   42718 |  18374 |   924518127 |
|     ...                        |
+---------+--------+-------------+
집계는 8,192개 행으로 구성된 Block을 컬럼별로 처리합니다. 조건에 맞는 행이 수백만 개인 와이드 테이블 스캔에서는 배치를 키우면 BE 메모리를 조금 더 사용하는 대신 스케줄링 과정의 왕복 횟수를 줄일 수 있습니다. 따라서 대개 긴 스캔에는 유리하지만 아주 작은 포인트 쿼리에는 불리합니다.
Apache Doris 벡터화 실행은 언제 사용해야 하나요?
v2.0부터 Apache Doris의 벡터화 실행이 유일한 실행 모드이므로, 실질적인 판단 기준은 언제 batch_size를 조정하고 언제 아예 다른 쿼리 경로를 사용할지입니다.
적합한 경우
- 현재 Doris가 실행하는 모든 워크로드. 스캔 비중이 높은 집계, GROUP BY, 해시 조인, 정렬은 모두 이 엔진에서 실행됩니다. 비교할 수 있는 "비벡터화" 옵션은 없습니다.
- 와이드 테이블 분석과 대시보드 쿼리. 컬럼 단위 루프와 SIMD 필터의 효과가 가장 잘 나타나는 영역입니다.
- AVX2 또는 NEON을 지원하는 머신에서 실행하는 워크로드. Doris는 설치 체크리스트에서 AVX2를 지원하는 x86 CPU를 권장하며, NEON은 ARM의 기본 경로입니다. 구형 CPU에서도 동작하지만 SIMD 가속 경로 대신 스칼라 코드를 사용합니다.
적합하지 않은 경우
- 수천 QPS를 처리하는 단일 행 기본 키 조회. Block에 행이 하나만 들어 있으면 Block마다 발생하는 준비 비용이 부담이 됩니다. 대신 고동시성 포인트 쿼리 경로를 사용하세요.
- 애드혹 쿼리를 위해
batch_size를 조정하는 경우. 기본값 4,096에는 이유가 있으며, 값을 바꿔도 대개 효과가 없거나 오히려 성능이 조금 떨어집니다. 프로파일링 결과 배치별 오버헤드가 지배적인 것으로 나타나거나 프래그먼트의 메모리가 부족할 때만 조정하세요. enable_vectorized_engine을 언급하는 오래된 조언을 따르는 경우. 이 세션 변수는 v1.2.1부터 아무 동작도 하지 않는 no-op이 되었으며, 기반이 되는 행 기반 코드는 v2.0에서 삭제되었습니다. 문서나 블로그 글에서 이 변수를 켜라고 한다면 오래된 정보입니다.- 이 기능을 벡터 검색과 혼동하는 경우. "벡터화 실행"은 쿼리 엔진 모델입니다. ANN 방식의 벡터 검색은 별도의 인덱스 계열에 속하며,
docs/ai/vector-search/에서 다룹니다.
성능
- v1.1에서 벡터화 실행을 모든 쿼리의 기본값으로 설정하면서 이전 버전 대비 3~5배 빨라졌습니다. 출처: Apache Doris 1.1.0 릴리스 노트.
- 와이드 테이블 집계 성능이 5~10배 향상되었습니다. 컬럼형 메모리 레이아웃과 SIMD 가속을 결합한 결과입니다. 출처: Doris 제품 개념.
더 읽어보기
- 제품 개념: 벡터화 실행 엔진
- Pipeline 실행 엔진
- 시스템 아키텍처 개요
- 컬럼형 스토리지: 페이지와 인코딩이 벡터화된 컬럼에 직접 전달되는 디스크 저장 형식입니다.
- Parquet 리더 최적화: 외부 Parquet 디코딩 결과가 Arrow를 거치는 왕복 변환 없이 벡터화 엔진에 바로 전달되는 방식을 설명합니다.
- Apache Doris 2.0 릴리스 노트(행 기반 엔진 제거)
- MPP 아키텍처: 단일 BE 내부뿐 아니라 여러 BE에 걸쳐 벡터화 연산자를 스케줄링하는 계층입니다.