수직 컴팩션
핵심 요약 Apache Doris의 수직 컴팩션은 와이드 테이블의 스키마를 작은 컬럼 그룹으로 나누어 한 번에 한 그룹씩 병합합니다. 기존 행 단위 컴팩션처럼 모든 컬럼을 메모리에 유지할 필요가 없습니다. 이 알고리즘은 컴팩션 메모리 사용량을 약 1/10로 줄이고 와이드 테이블에서 약 15% 더 빠르게 실행됩니다. 키 컬럼을 바탕으로 만든 행별 순서 표시자를 사용해 출력 결과를 동일하게 유지합니다. 수직 컴팩션은 Apache Doris 1.2.2부터 기본적으로 활성화되어 있습니다.
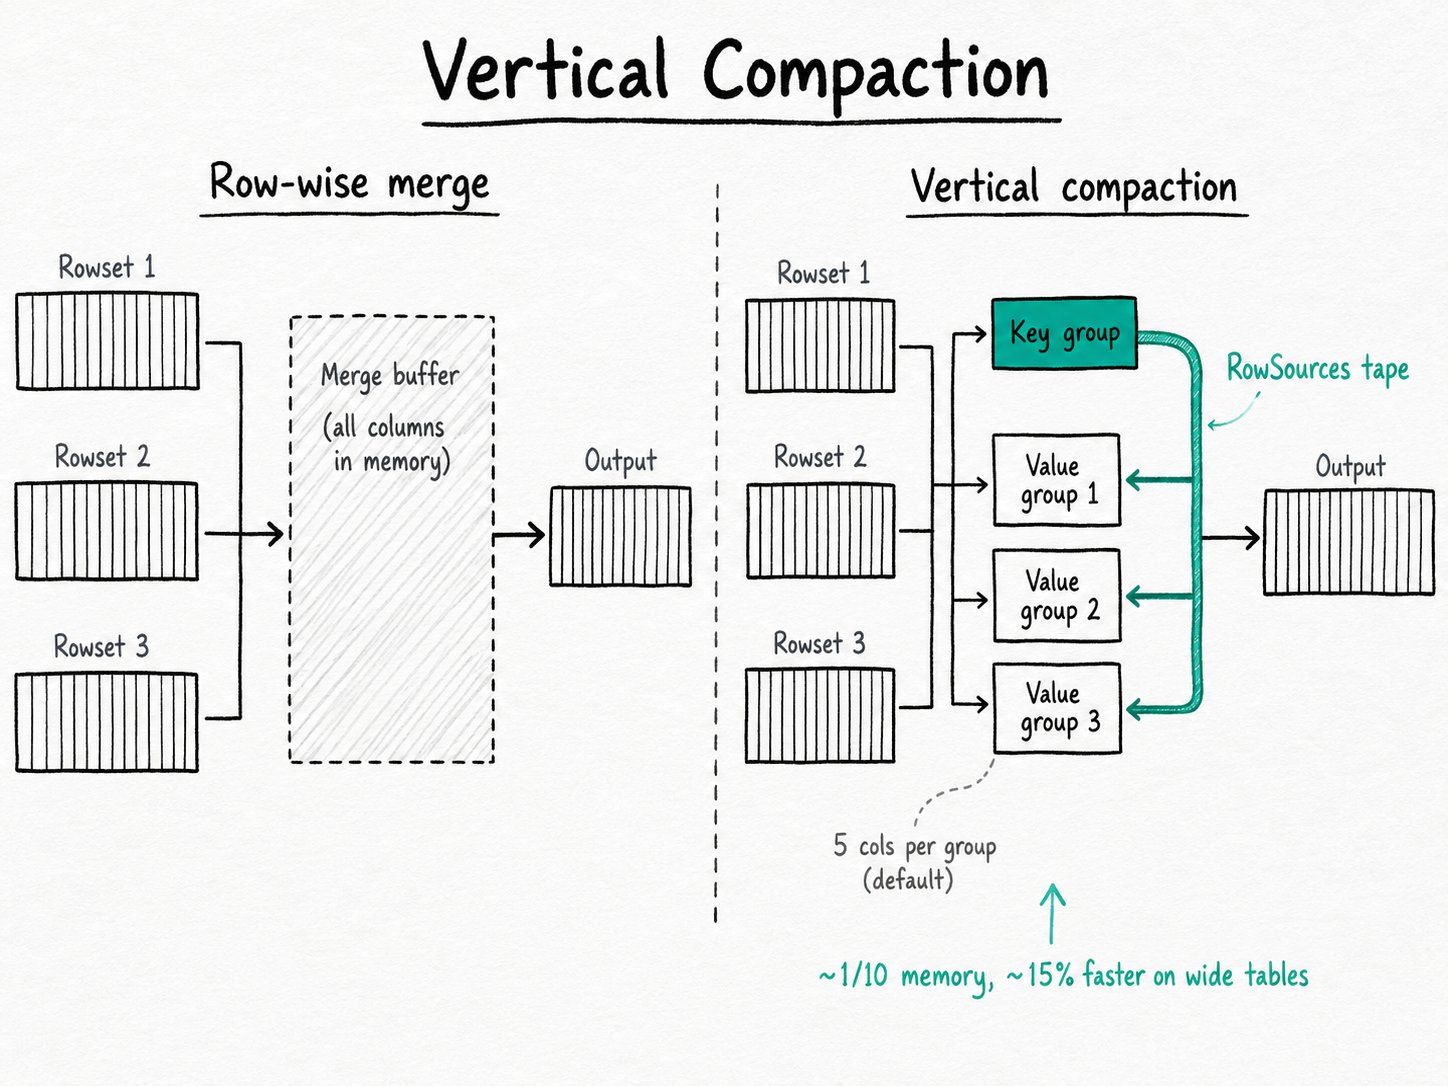
Apache Doris에서 수직 컴팩션을 사용하는 이유는 무엇인가요?
수직 컴팩션은 와이드 테이블에서 Apache Doris의 컴팩션 메모리 사용량을 일정 범위로 제한합니다. 행 단위 병합은 모든 컬럼을 한꺼번에 메모리로 가져오기 때문에 BE에서 OOM이 발생할 수 있습니다. 컴팩션은 tablet의 rowset을 더 적고 더 큰 rowset으로 병합하는 백그라운드 작업입니다. 덕분에 쿼리가 수백 개의 버전을 순회할 필요가 없습니다. 기존 알고리즘은 각 입력 rowset에서 행을 하나씩 읽고, 출력할 행을 선택해 기록한 뒤 이 과정을 반복합니다. 컬럼이 5개인 팩트 테이블에서는 잘 작동합니다. 하지만 컬럼이 200개인 사용자 테이블에서는 문제가 생깁니다. 특히 컬럼에 방대한 VARIANT JSON 페이로드가 들어 있으면 더 그렇습니다:
- 병합 블록은 배치에 포함된 모든 행의 모든 컬럼을 보관해야 합니다. 메모리 사용량은 컬럼 수와 배치 크기 모두에 비례해 증가합니다.
- Backend (BE)는 여러 컴팩션 작업을 병렬로 실행합니다. 와이드 테이블의 컴팩션 작업 몇 개만으로도 노드에서 OOM이 발생할 수 있습니다.
- 운영자는 메모리 사용량을 제어하기 위해 컴팩션 스레드 풀의 동시 실행 수를 제한합니다. 그러면 rowset이 쌓이고, tablet의 버전 수가
max_tablet_version_num을 초과하면 데이터 적재가 오류 -235로 실패하기 시작합니다.
수직 컴팩션은 이 문제를 해결합니다. 병합 단위를 "모든 컬럼에 걸친 하나의 행"에서 "모든 행에 걸친 하나의 컬럼 그룹"으로 바꿉니다. 이를 위해 행별 순서 표시자라는 구조가 하나 더 필요합니다.
Apache Doris 수직 컴팩션이란 무엇인가요?
Apache Doris 수직 컴팩션은 행을 병합하는 대신 컬럼을 그룹 단위로 병합하는 컴팩션 알고리즘입니다. Backend는 테이블 스키마를 키 컬럼 그룹과 여러 값 컬럼 그룹으로 나눕니다. 기본적으로 그룹당 컬럼은 5개입니다. 키 그룹을 먼저 병합해 전체 행의 순서를 확정한 다음, 각 값 그룹에서 그 순서를 재현하며 병합합니다. 출력 rowset은 행 단위 컴팩션으로 생성한 것과 같으며, 메모리 사용 양상만 달라집니다.
핵심 용어
Column group: 스키마를 고정 크기로 나눈 단위입니다. 기본값은 그룹당 컬럼 5개이며, 테이블별로 설정할 수 있습니다.Key group: 테이블의 키 컬럼으로 구성한 첫 번째 그룹입니다. 이 그룹을 병합하면서 출력 행의 순서가 결정됩니다.RowSourcesBuffer: 디스크를 보조 저장소로 사용하는 버퍼로, 각 출력 행이 어느 입력 rowset의 어느 행에서 왔는지 기록합니다. 기본 상한은 1 GB입니다.Vertical merge iterator: 모든 입력 rowset에서 단일 컬럼 그룹을 스캔하고 병합된 컬럼을 출력하는 BE 컴포넌트입니다.enable_vertical_compaction: BE 설정 플래그로, 기본값은true입니다. 비활성화하면 행 단위 컴팩션으로 전환됩니다.
Apache Doris 수직 컴팩션은 어떻게 작동하나요?
Apache Doris 수직 컴팩션은 스키마를 컬럼 그룹으로 나누고 키 그룹을 먼저 병합해 행 순서를 확정합니다. 그런 다음 각 값 그룹에서 그 순서를 재현하므로, 해당 그룹에 속하지 않는 컬럼을 메모리에 유지할 필요가 없습니다. 다음 다섯 단계는 분할, 병합, 재현, 결합, 스필 과정을 설명합니다.
- 스키마를 그룹으로 나눕니다. BE는 tablet 스키마를 순회하면서 키 컬럼을 그룹 0에 넣고, 나머지 컬럼은
vertical_compaction_num_columns_per_group설정값(기본값 5)에 따라 그룹으로 묶습니다.enable_vertical_compact_variant_subcolumns가 활성화되어 있으면 BE는 VARIANT 하위 컬럼도 같은 흐름으로 처리합니다. - 키 그룹을 병합하고 순서를 기록합니다. Merger는 모든 입력 rowset의 키 컬럼을 힙 정렬합니다. 각 행이 힙에서 나올 때마다 RowSourcesBuffer에 항목을 하나 기록해 행의 출처를 저장합니다. 이 단계의 출력은 정렬된 키 컬럼과 전체 행의 순서를 담은 RowSources 테이프입니다.
- 각 값 그룹에서 테이프를 재생합니다. 각 값 그룹에 대해 BE는 동일한 입력 rowset을 열되, 해당 그룹의 컬럼만 읽습니다. 힙 대신 RowSources 테이프를 사용해 다음 입력을 선택합니다. 비교 연산이 필요 없고, 그룹에 속하지 않는 컬럼을 메모리에 유지할 필요도 없습니다.
- 그룹을 하나의 rowset으로 결합합니다. 출력 writer는 각 그룹을 단일 세그먼트 파일로 조립합니다. 결과는 delete-bitmap 및 inverted-index 업데이트를 포함해 행 단위 컴팩션의 결과와 바이트 단위까지 일치합니다.
- 테이프가 커지면 스필합니다. RowSourcesBuffer의 상한은
vertical_compaction_max_row_source_memory_mb(1 GB)로 정해집니다. 병합으로 생성되는 행 수가 버퍼 상한을 초과하면 버퍼는 tablet 디렉터리에 스필되고, 3단계에서 스트리밍 방식으로 처리됩니다.
한 가지 절충점이 있습니다. 수직 컴팩션은 각 입력 rowset을 전체 과정에서 한 번만 읽는 대신 그룹마다 한 번씩 읽습니다. 디스크 성능이 병목인 클러스터에서는 IO 비용이 대략 (num_groups - 1)만큼 늘어납니다. 대개 메모리 절감 효과가 더 크기 때문에 기본값으로 사용됩니다. 컬럼 수가 적은 테이블(컬럼 5개 이하)은 어차피 스키마에서 정확히 하나의 그룹만 만들어지므로 알고리즘이 다시 행 단위 경로로 동작합니다.
빠른 시작
수직 컴팩션은 기본적으로 활성화되어 있습니다. 아래 예제는 와이드 테이블의 컬럼을 얼마나 작은 그룹으로 나눌지 제어하는 테이블별 재정의 설정을 보여 줍니다:
CREATE TABLE user_profile (
  user_id BIGINT,
  name VARCHAR(64), age INT, country VARCHAR(32), city VARCHAR(64),
  attr_01 STRING, attr_02 STRING, attr_03 STRING, attr_04 STRING,
  attr_05 STRING, attr_06 STRING, attr_07 STRING, attr_08 STRING
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "vertical_compaction_num_columns_per_group" = "3"
);

SHOW CREATE TABLE user_profile;
예상 결과
+--------------+--------------------------------------------------+
| Table        | Create Table                                     |
+--------------+--------------------------------------------------+
| user_profile | ... "vertical_compaction_num_columns_per_group" |
|              |     = "3" ...                                    |
+--------------+--------------------------------------------------+
그룹 크기를 3으로 설정하면 IO가 조금 늘어나는 대신 메모리 사용량을 더 엄격하게 제한할 수 있습니다. 큰 STRING 또는 JSONB 컬럼이 많은 테이블에 적합한 설정입니다. SHOW CREATE TABLE로 설정이 적용되었는지 확인합니다. 변경 사항을 기본값으로 되돌리려면 ALTER TABLE로 해당 속성을 제거합니다.
Apache Doris 수직 컴팩션은 언제 사용해야 하나요?
와이드 스키마, 행 단위 컴팩션에서 OOM이 발생하는 tablet, 희소한 VARIANT 하위 컬럼이 있는 테이블에 Apache Doris 수직 컴팩션을 사용합니다. 컬럼 수가 적은 테이블이나 추가 읽기 비용이 메모리 절감 효과보다 큰 디스크 병목 클러스터에서는 튜닝을 생략합니다.
적합한 경우
- 와이드 스키마: 컬럼이 수십 개 이상이며, 특히 대부분의 컬럼이 가변 길이 자료형(
STRING,JSONB,ARRAY,MAP)인 경우입니다. 스키마가 클수록 효과도 커집니다. - 행 단위 알고리즘으로 컴팩션을 수행할 때 OOM이 발생하는 tablet. 스레드 풀을 제한하는 대신 그룹 크기를 5에서 2 또는 3으로 줄입니다.
- 희소한
VARIANT하위 컬럼이 있는 테이블. 같은 코드 경로가enable_vertical_compact_variant_subcolumns에도 사용되며, 병합 시 존재하지 않는 하위 컬럼을 구체화하지 않도록 합니다. - 와이드 테이블에서 base compaction이 느린 경우. 그룹별 작업 집합이 작아 병합 작업을 CPU 캐시 안에서 처리할 수 있습니다.
적합하지 않은 경우
- 컬럼 수가 적은 테이블(컬럼 한 개에서 다섯 개). 스키마에서 단일 컬럼 그룹이 생성되므로, 이점 없이 행 출처를 관리하는 부가 작업만 생깁니다. 문제는 없지만 실익도 없습니다.
- sequence-map 컬럼이 있는 tablet. 현재 구현에서는 이 경우 수직 컴팩션을 건너뜁니다(
_tablet->tablet_schema()->has_seq_map()에 대해서는compaction.cpp참조). 병합은 자동으로 행 단위 경로로 전환됩니다. - 컴팩션 IO가 이미 대부분의 부하를 차지하는 디스크 병목 클러스터. 그룹별 추가 읽기가 병목을 심화할 수 있습니다. 그룹 크기를 늘리거나(
vertical_compaction_num_columns_per_group값을 높임), 먼저 IO 성능 한계를 해결합니다. - 지나치게 잦은 데이터 적재를 해결하기 위한 수단으로 수직 컴팩션을 사용하는 경우. 컴팩션 중의 메모리 압박은 근본 원인이라기보다 작업이 쌓인 결과인 경우가 많습니다. 데이터 적재 측의 조정 방법은 데이터 컴팩션과 Group Commit을 참조하세요.
성능 / 수치
- 메모리: 와이드 테이블에서 행 단위 컴팩션의 약 1/10 수준입니다. 출처: Doris 컴팩션 튜닝 문서.
- 처리량: 동일한 와이드 테이블 벤치마크에서 전체 처리 속도가 약 15% 더 빠릅니다. 출처: 위와 동일합니다.
- 도입 버전: Doris 1.2.2. 현재 릴리스의 기본값은
true입니다.
추가 자료
- 데이터 컴팩션: cumulative, base, time-series 정책이 수직 컴팩션을 기반으로 어떻게 동작하는지 설명합니다.
- 컴팩션 튜닝: 수직, 세그먼트, 단일 복제본, 시계열: 각 컴팩션 유형에 대해 운영자가 조정할 수 있는 설정을 설명합니다.
- 컴팩션 원리, 유형 및 스케줄링: 다음에 컴팩션할 tablet을 선택하는 점수 산정 및 스케줄링 로직을 설명합니다.
- BE 설정 참조: 모든
vertical_compaction_*플래그와 각각의 기본값 및 단위를 설명합니다. - 3분 만에 이해하는 데이터 컴팩션(블로그): 다이어그램으로 수직 컴팩션을 소개한 원문입니다.
- Unique Key: 수직 컴팩션에서 정합성을 맞춰야 하는 rowset별 delete bitmap을 생성하는 테이블 모델입니다.